



November 16, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
2026年のAI運用とは、異なる価格体系、レイテンシプロファイル、レート制限、失敗モードを持つ複数のプロバイダーにわたって複数のモデルを実行することを意味します。最も速く成果を出しているチームは、もはやモデルに直接接続していません。すべてをLLM gateway経由で実行しています。プロバイダーを統合し、コンプライアンスを強制し、コストを制御し、AIスタックが実際に行っていることを解明するために必要な可視性を提供する単一のレイヤーです。
選択する Gateway によって、出荷のスピード、システムの信頼性、そして最終的に支払うコストが決まります。このガイドでは、不要な情報を排除して本質をお伝えします。
AI を活用した構築は、もはや単一のベストなモデルを選ぶことにとどまりません。プロバイダーごとに優れている領域が異なり、価格は絶えず変動し、あらゆるユースケースを制覇する単一の LLM は存在しません。今日チャットで機能しているものが、明日にはコード生成や推論で力不足になる可能性があります。
LLM gatewayは、アプリケーションと目まぐるしく変化するモデルプロバイダーの世界との間で、スマートな中間レイヤーとして機能します。各 API に直接接続してカスタム統合やベンダーロックインに対処する代わりに、1つの Gateway に接続するだけで以下のメリットが得られます:
AIの導入が加速する中、真の勝者となるのは LLM を単に使用する人々だけでなく、それらを賢く管理する人々です。Gateway は、まさにその知恵が組み込まれる場所です。
すべての Gateway が同等というわけではありません。最適なものは、チームの規模、ワークフロー、コンプライアンス要件によって異なります。考慮すべき評価フレームワークは以下の通りです:
パフォーマンス:優れた Gateway は、速度、信頼性、コストのバランスを取りながら、リクエストをインテリジェントにルーティングする必要があります。Time-to-First-Token(最初のトークン生成までの時間)における p95 オーバヘッドが 10ms 未満であることを確認してください。レイテンシの増大はマルチステップのエージェントワークフロー全体で蓄積されます。
柔軟性:Gateway は複数のプロバイダー、オープン API、容易な切り替えをサポートしている必要があります。ロックインが発生しては本末転倒です。
可視性(Observability):明確なコストと使用状況のインサイト、ダッシュボード、異常検知。これらがなければ、状況を把握できずに運用することになります。
セキュリティ:SOC2、GDPR、あるいはエンタープライズグレードの暗号化であれ、Gateway は一貫したポリシーを適用する必要があります。これは特に規制の厳しい業界でのLLMデプロイにおいて重要です。
Gateway評価のための主要メトリクス
| 評価基準 | 評価すべきポイント | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | Time-to-First-Tokenのp95オーバヘッドが10ms未満か? | 必須(Must Have) | ✅ サポート済み |
| データレジデンシー | ログを指定地域(EU/米国など)内に保持できるか? | ユースケースによる | ✅ サポート済み |
| レイテンシに基づくルーティング | リアルタイムのレイテンシ/障害に基づいて自動的に迂回ルーティングするか? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須(Must Have) | ✅ サポート済み |
| キーのローテーションと無効化 | ダウンタイムなしでキーのローテーションや無効化ができるか? | 必須(Must Have) | ✅ サポート済み |

LLM Gateway の市場は急速に加熱しています。新規参入者が現れ、既存のプレーヤーが進化を遂げ、それぞれがユーザーとモデルの世界を繋ぐ最もスマートなレイヤーであることをアピールしています。しかし、すべての Gateway が同じ価値を提供するわけではありません。速度に注力するもの、コスト管理に長けたもの、エンタープライズのコンプライアンスに大きく寄せるものなど様々です。
最適な Gateway は、スタートアップ製品のスケール、エンタープライズワークロードの運用、あるいは最先端モデルの実験など、ユースケースによって異なります。以下に、それぞれ異なるパフォーマンス、柔軟性、コントロール性を提供する、2026年に最も注目すべき6つの Gateway を紹介します。
TrueFoundry は、通常伴う複雑さを回避しながらプロダクション対応の AI を必要とするエンタープライズ向けにおいて、業界をリードする LLM Gateway として際立っています。オーケストレーション、ガバナンス、スケーラビリティを単一のプラットフォームに統合しており、大規模な LLM ワークフローのデプロイ、管理、最適化を容易にします。
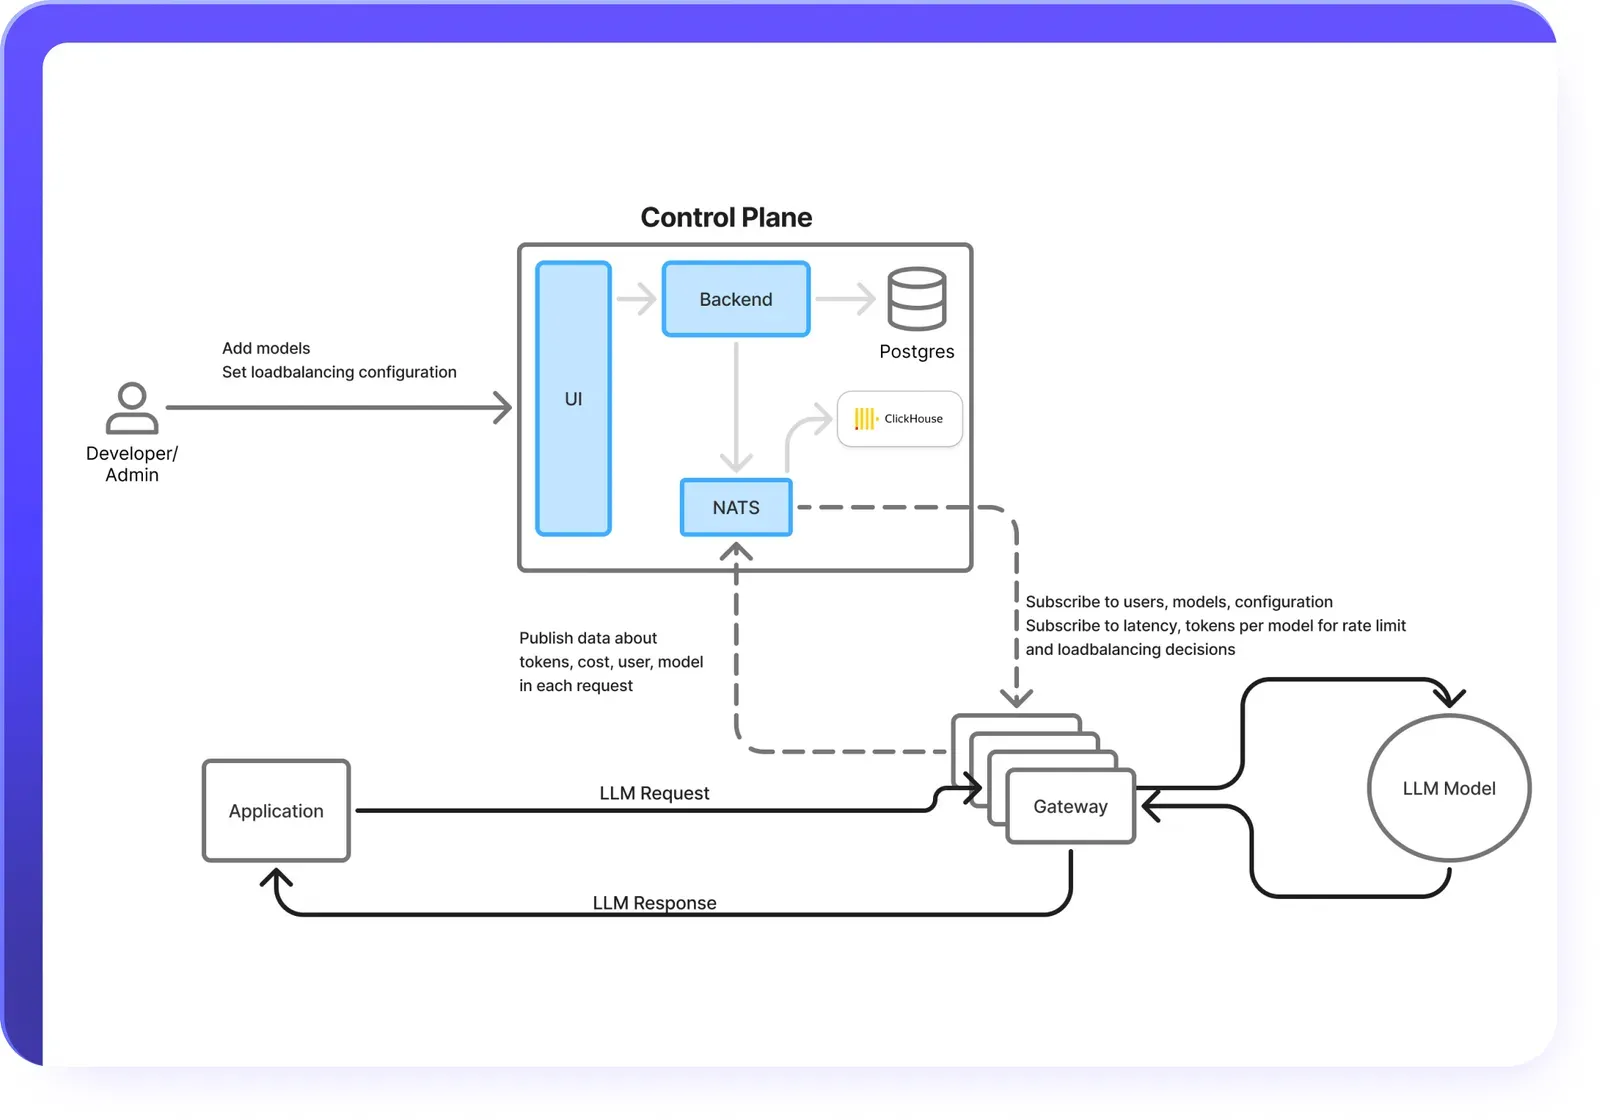
この LLM Gateway は、マルチステップのエージェントワークフローを統合制御し、タスク全体のメモリ、ツール統合、推論を処理します。これにより、エージェントはシームレスに計画、実行、適応できると同時に、チームには完全な可視性とコントロールが提供されます。そのアーキテクチャはコントロールプレーンとデータプレーンを分離しており、ガバナンスの複雑さに関わらず、インメモリで認証、承認、レート制限を処理することで、1ミリ秒未満の安定したオーバヘッドを実現します。
トークンレベルの使用状況帰属機能により、ユーザー、チーム、地域、またはカスタムディメンションごとにコストを把握できます。リアルタイムの予算強制機能によって予期せぬ支出を防ぎ、詳細なコストの可視化が支出パターンの最適化に役立ちます。プロバイダーの直接利用と比較して、通常 30〜70% のコスト削減が報告されています。
MCP および Agents Registry を備えた TrueFoundry は、スキーマ検証とアクセス制御を備えた API およびツールの集中型ライブラリを提供します。Prompt Lifecycle Management(プロンプトライフサイクル管理)により、バージョン管理、テスト、モニタリング機能が追加され、一貫性と監査可能性のあるエージェントの動作を実現します。MCP Gateway は、Slack、GitHub、Confluence などのツールへの OAuth 2.0 で保護されたアクセスを備えた、集中型の MCP サーバー管理を提供します。
vLLM、TGI、Triton などの最適化されたバックエンドを使用して、あらゆる LLM や埋め込みモデルをサポートします。LangGraph、CrewAI、AutoGen などのフレームワークと統合できます。また、規制の厳しい業界向けに、オンプレミス LLM Gateway デプロイやエアギャップ環境もサポートしています。
SOC 2 Type 2 および HIPAA に準拠し、セキュアな VPC、オンプレミス、ハイブリッド、またはエアギャップ環境で動作します。GPU オーケストレーション、一括割当以外の GPU サポート(Fractional GPU)、および自動スケーリングによりコスト効率を維持できます。一部のエンタープライズでは、GPU 利用率が 80% 向上したと報告されています。
複数の LLM プロバイダーを管理し、アクセス、コスト、コンプライアンスを詳細に制御する必要がある組織。単なるプロキシではなく、完全な AI インフラストラクチャスタックを求めているチームに最適です。
検討事項: 総合的な機能セットは、小規模なチームや単純な個人ユースケースにはオーバースペックとなる場合があります。
こちらも参照: TrueFoundry vs Portkey vs Helicone - エンタープライズ比較
Helicone は、軽量でハイパフォーマンスなソリューションを求める開発者向けに設計されたオープンソースの LLM Gateway です。Rust で構築され、エッジデプロイ向けに最適化されており、統合を簡素化し可視性を向上させる統一 API を提供します。
複数モデルに対応する統一 API:1つの API で GPT、Claude、Gemini を含む数十の LLM に対応し、複数の SDK やキーを管理する必要がありません。
インテリジェントルーティングとフェイルオーバー:モデルを自動的に切り替え、コストを最適化し、信頼性の高いパフォーマンスのためにプロバイダー間の負荷を分散します。
組み込みの可視性(Observability):集中ダッシュボードを通じて、リクエスト、レスポンス、トークン使用量、レイテンシ、コストをリアルタイムでモニタリングできます。
エッジ最適化されたパフォーマンス:重い負荷の下でも非常に低いオーバヘッドで、~8ms の P50 処理時間を実現します。
エンタープライズ機能の制限 — 規制環境に必要な高度な RBAC、監査ログ、厳格なポリシー強制機能が不足しています。複雑なエンタープライズセットアップに必要な大規模なモデルエコシステムを欠く、基本的な統合サポートにとどまります。
高度なアクセス制御や幅広い統合を必要とするチーム向け:エンタープライズチーム向け Helicone 代替製品 | Helicone vs Portkey 比較
Respan Gateway は、複数の LLM プロバイダーを扱うための統一インターフェースを提供するマネージド AI Gateway です。単一の API を介してモデルアクセス、リクエストルーティング、可視性、使用量管理を集中化することで、AI インフラストラクチャの簡素化に焦点を当てています。
Respan Gateway は、集中化されたモデル管理と透明性により、チームが本番環境の AI アプリケーションを構築・運用できるように設計されています。マルチプロバイダーへのアクセスと、リクエストのアナリティクス、ルーティング、キャッシュ、運用ツーリングを組み合わせることで、大規模な LLM 統合管理の複雑さを軽減します。
統一されたモデルアクセス – 単一の API を介して複数の LLM プロバイダーに接続し、統合の複雑さを軽減し、プロバイダー固有のコード変更を回避します。
ルーティングとリクエスト管理 – 集中型コントロールプレーンから API キーとトラフィックを管理しながら、異なるモデルやプロバイダーにリクエストをルーティングします。
可視性とアナリティクス – 組み込みのモニタリングおよびアナリティクスダッシュボードにより、リクエストのレイテンシ、トークン使用量、コスト、およびアプリケーションのパフォーマンスを追跡します。
キャッシュとコスト最適化 – レスポンスキャッシュと集中型の使用量制御により、応答時間を改善し推論コストを削減します。
開発者に優しい統合 – 大幅なインフラストラクチャのオーバヘッドなしで、既存の AI アプリケーションに容易に統合できるマネージド Gateway を提供します。
OpenRouter は、単一の API を通じて複数の LLM へのアクセスを提供する、開発者向けの Gateway です。統合と管理を簡素化し、最大のモデル柔軟性を求めるチームに最適です。
統一 API アクセス:OpenAI、Anthropic、Google、Mistral などの多数のモデルに接続し、複数の SDK 管理の複雑さを解消します。利用可能なプロバイダーの選択肢は業界最大級です。
自動ルーティングとフォールバック:パフォーマンス、コスト、利用可能性に基づいて最適なモデルにリクエストをルーティングし、障害発生時には自動的にフォールバックします。
透明性のある価格体系:明確なトークンごとの価格設定と統合請求により、コスト管理がシンプルになります。認証のより詳細な制御のために BYOK(Bring Your Own Key)にも対応しています。
無料層モデルのレート制限により、大規模なテストが制限されます。モデルや負荷によっては、高トラフィック時にレイテンシが増大する可能性があります。エンタープライズガバナンス機能の限定 — 高度な監査ログ、RBAC、コンプライアンス認定などは提供されていません。
こちらも参照: OpenRouter vs AI Gateway - 直接比較 | LiteLLM vs OpenRouter | Requesty vs OpenRouter
Portkey は、大規模言語モデル(LLM)、ビジョン、オーディオ、画像モデルを含む 1,600 以上の AI モデルへのアクセスをストリームライン化するために設計されたオープンソースの AI Gateway です。統合と管理を簡素化する統一 API を提供し、柔軟性と効率性を求める開発者にとって理想的な選択肢となります。
Portkey は単なる Gateway ではなく LLMOps プラットフォームとして位置づけられており、従来のプロキシ機能と並んでエンドツーエンドの AI アプリケーションライフサイクル管理を提供します。ただし、LLMOps レイヤーは限定的であり、モデルデプロイなどの主要機能が不足しています。
統一 API アクセス - 単一のエンドポイントを介して、LLM、ビジョン、オーディオ、画像モデルを含む 1,600 以上の AI モデルにアクセス可能です。
スマートルーティングとフェイルオーバー - コスト、パフォーマンス、利用可能性に基づいてリクエストをインテリジェントにルーティングし、自動フォールバックを行います。レイテンシとコストを削減するためのセマンティックキャッシュを含みます。
高度な可視性(Observability) - 集中ダッシュボードで、リクエスト/レスポンスのペイロード、トークン使用量、レイテンシ、コストをリアルタイムにモニタリングできます。
ガードレール統合 - リアルタイム AI セキュリティのために Prisma AIRS と統合されています。コンテンツフィルタリングと PII 検出のための 50 以上の構築済みガードレールを備えています。
エンタープライズの信頼性 - SaaS、ハイブリッド、エアギャップデプロイメントのオプションを備え、SOC2、ISO27001、HIPAA、GDPR に準拠。99.99% の稼働率 SLA を誇ります。
エンタープライズの料金体系が複雑です。予算制限などの重要な機能は Enterprise カスタマーのみに限定されています。一部のユーザーからは、データエクスポート機能が限定的で手動のサポート対応が必要であると報告されています。モデルデプロイは LLMOps レイヤーでネイティブサポートされていません。機能が多すぎるため、プラットフォームを使いこなすのが難しいと感じるユーザーもいます。
こちらも参照: 2026年における Portkey 代替製品 | Portkey 料金ガイド | Portkey vs LiteLLM | Langfuse vs Portkey
LiteLLM は、LLM 呼び出しを標準化するために最も広く使用されているオープンソース Gateway であり、OpenAI フォーマットで 100 以上の LLM API へのアクセスを統合する Python ベースのプロキシサーバーを提供します。
ユニバーサルな API 互換性 - OpenAI、Azure、AWS Bedrock、HuggingFace、Google Vertex AI などの主要プロバイダーに一貫したフォーマットで接続します。ベンダー固有の SDK を回避したいチームに最適です。
予算およびレート制限管理 - ユーザー、チーム、APIキーごとに予算とレート制限を設定し、コストを制御して公正な使用を確保します。
ロギングと可視性 - ロギングとモニタリングのために Prometheus、Datadog、S3/GCS と統合します。
オープンソースの透明性 - YAML ベースの設定管理により、Infrastructure-as-Code のアプローチが可能です。AI インフラストラクチャを完全にコントロールできます。
正式な企業によるバックアップがないため、エンタープライズサポートプラン、稼働率の SLA、専用の問い合わせ窓口がありません。バージョン間での頻繁なデグレ(退行)、エッジケースのバグ、大規模運用での不安定性が報告されています。レイテンシのオーバヘッドがリアルタイムアプリケーションのボトルネックとなります。基本ルーティング以外の高度な可視性、AI ガードレール、エンタープライズ機能が不足しています。JWT 認証や監査ログなどの高度な機能には、有料のエンタープライズバージョンが必要です。
こちらも参照: エンタープライズチーム向け LiteLLM 代替製品 | LiteLLM 料金ガイド | 詳細 LiteLLM レビュー:機能、価格、メリット&デメリット | LiteLLM エンタープライズ料金 TCO vs TrueFoundry | Bifrost vs LiteLLM
最適な LLM Gateway は、チームの規模、ワークフロー、コンプライアンス要件によって異なります:
複雑なワークフローを持つエンタープライズの場合 → TrueFoundry または Portkey。どちらも堅牢なオーケストレーション、きめ細やかなアクセス制御、コンプライアンス機能を提供します。TrueFoundry はレイテンシパフォーマンス、デプロイの柔軟性、AI ガバナンスでリードしています。Portkey は LLMOps の深さでリードしています。
スタートアップや小規模な開発チームの場合 → Helicone または LiteLLM。低いオーバヘッド、迅速な統合、優れた可視性を備え、大規模なインフラやコンプライアンス管理を必要としません。
最大のモデル柔軟性が最優先事項である場合 → OpenRouter または Unify AI。単一の API、インテリジェントルーティング、複数の LLM を検証するチーム向けの最も幅広いプロバイダーの選択肢を提供します。
オンプレミスまたはエアギャップ環境でのデプロイが必要な場合 → TrueFoundry。自社の VPC 内でエンタープライズコンプライアンスとデプロイの柔軟性を兼ね備えた唯一の選択肢です。参照:LLM Gateway オンプレミスインフラストラクチャガイド。
コストを評価している場合 → プラットフォームを確定する前に、まずLLM Gateway のコストに関する考慮事項から確認してください。
理想的な選択とは、成長をサポートし、インフラの管理性を維持し、チームがトラブルシューティングではなく構築に集中できるようにするものです。
適切な LLM Gateway を選択することは、2026年における AI 戦略の成否を分ける可能性があります。速度、コスト効率、コンプライアンス、またはマルチモデルアクセスのいずれを優先するにしても、ここで取り上げた Gateway はあらゆるニーズに対応するソリューションを提供します。TrueFoundry と Portkey はエンタープライズグレードのオーケストレーションとセキュリティに優れており、Helicone、LiteLLM、OpenRouter、Unify AI は開発者に優しい柔軟性と軽量な統合を提供します。重要なのは、選択肢をワークフロー、スケール、および目標に合致させることです。慎重に選ばれた Gateway は、モデル管理を簡素化するだけでなく、チームがより迅速にイノベーションを起こし、リソースを最適化し、自信を持って AI アプリケーションを提供できるように支援します。
TrueFoundry は、セキュアでスケーラブルかつ本番環境に対応した LLM インフラを必要とするエンタープライズ AI チームにとって最高の LLM Gateway です。基本的なプロキシとは異なり、TrueFoundry の AI Gateway はガバナンス、信頼性、および大規模デプロイ向けに構築されており、ミッションクリティカルな AI アプリケーションを運用する組織に最適です。
LLM Gateway を選択する際は、マルチプロバイダーサポート、インテリジェントなルーティングとフォールバック、レート制限、キャッシュ、詳細な使用状況アナリティクス、コスト追跡、RBAC、セキュアなキー管理、および強力な可視性を確認してください。エンタープライズチームは、監査ログ、環境レベルのアクセス制御、高可用性も優先すべきです。
LLM Gateway は、スマートルーティング、自動リトライ、レスポンスキャッシュを通じてパフォーマンスを改善します。また、価格とパフォーマンスのトレードオフに基づくモデル選択を可能にし、レート制限を適用し、リアルタイムの使用状況の可視性を提供して過剰支出を防ぐことでコストを削減します。
TrueFoundryは、モデルのオーケストレーションとセキュリティのための統合コントロールプレーンを提供することで、最高のLLM gatewayとして際立っています。リアルタイムの可視性と自動フェイルオーバーを統合し、プロバイダー全体で高い可用性を確保します。ネイティブなGPUサポートとエンタープライズグレードのRBACにより、組織は厳格なデータレジデンシーとコンプライアンスを維持しながら、本番環境のAIをスケールさせることができます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























