August 27, 2025
|
5 min read


Published: October 6, 202615
Blazingly fast way to build, track and deploy your models!
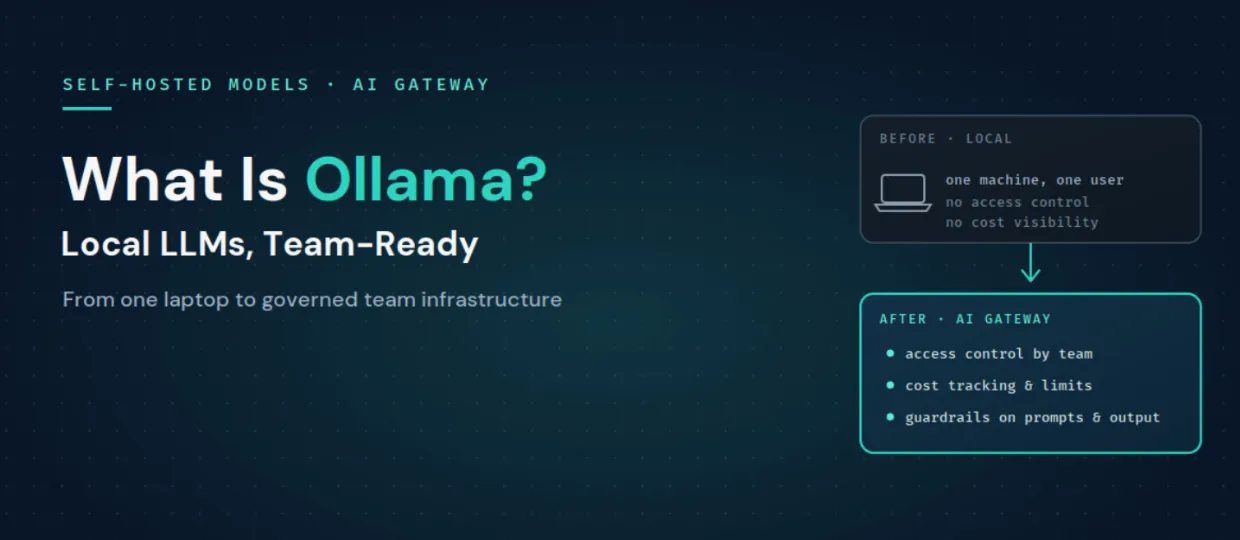
Ollamaは、ノートPC、オンプレミスのGPUサーバー、プライベートクラウドインスタンスなど、自社のインフラ上でLLMを実行するためのオープンソースのランタイムです。Llama、Mistral、Qwenといったオープンウェイトモデルをダウンロードし、HTTPエンドポイント経由でローカルに提供します。重要なのは、このエンドポイントがOpenAI互換APIに対応している点です。そのため、OpenAI SDK向けに書かれたコードであれば、ベースURLを変更するだけでローカルのOllamaモデルと通信できます。
チームがOllamaを選ぶ主な理由は以下の通りです。
OllamaとvLLMは、どちらもOpenAI互換APIを提供し、オープンウェイトモデルをセルフホストできるため、よく比較されます。しかし、それぞれ最適化の目的が異なります。
結論から言うと、個人でモデルを実行するならOllamaが最も簡単であり、vLLMは多数の同時ユーザーに対して高スループットでサービスを提供するのに適しています。多くのチームが両方を使い分けており、ローカル開発にはOllama、本番環境にはvLLMを利用しています。幸いなことに、どちらもOpenAI互換であるため、どちらを標準にしても同じゲートウェイ経由で利用でき、必要に応じてそれらの間でルーティングを行うことも可能です。
Ollamaは優れたツールですが、組織で運用しようとすると、そのスコープ外にある課題が浮き彫りになります。
これらこそがゲートウェイが解決すべき課題であり、ローカルのモデル実行環境をチーム向けのインフラへと昇華させる鍵となります。
TrueFoundryでは、Ollamaサーバーをセルフホスト型モデルとして扱います。 AIゲートウェイ にエンドポイントURLと認証情報を登録すると、クラウドプロバイダーのモデルと並んでゲートウェイのモデルカタログに表示されます。これにより、ルーティング、ガードレール、レート制限、コスト追跡、可観測性といったゲートウェイの全機能が適用されます。OllamaはOpenAI互換のAPIを提供しており、ゲートウェイと最も相性が良いため、明示的にサポートされています。
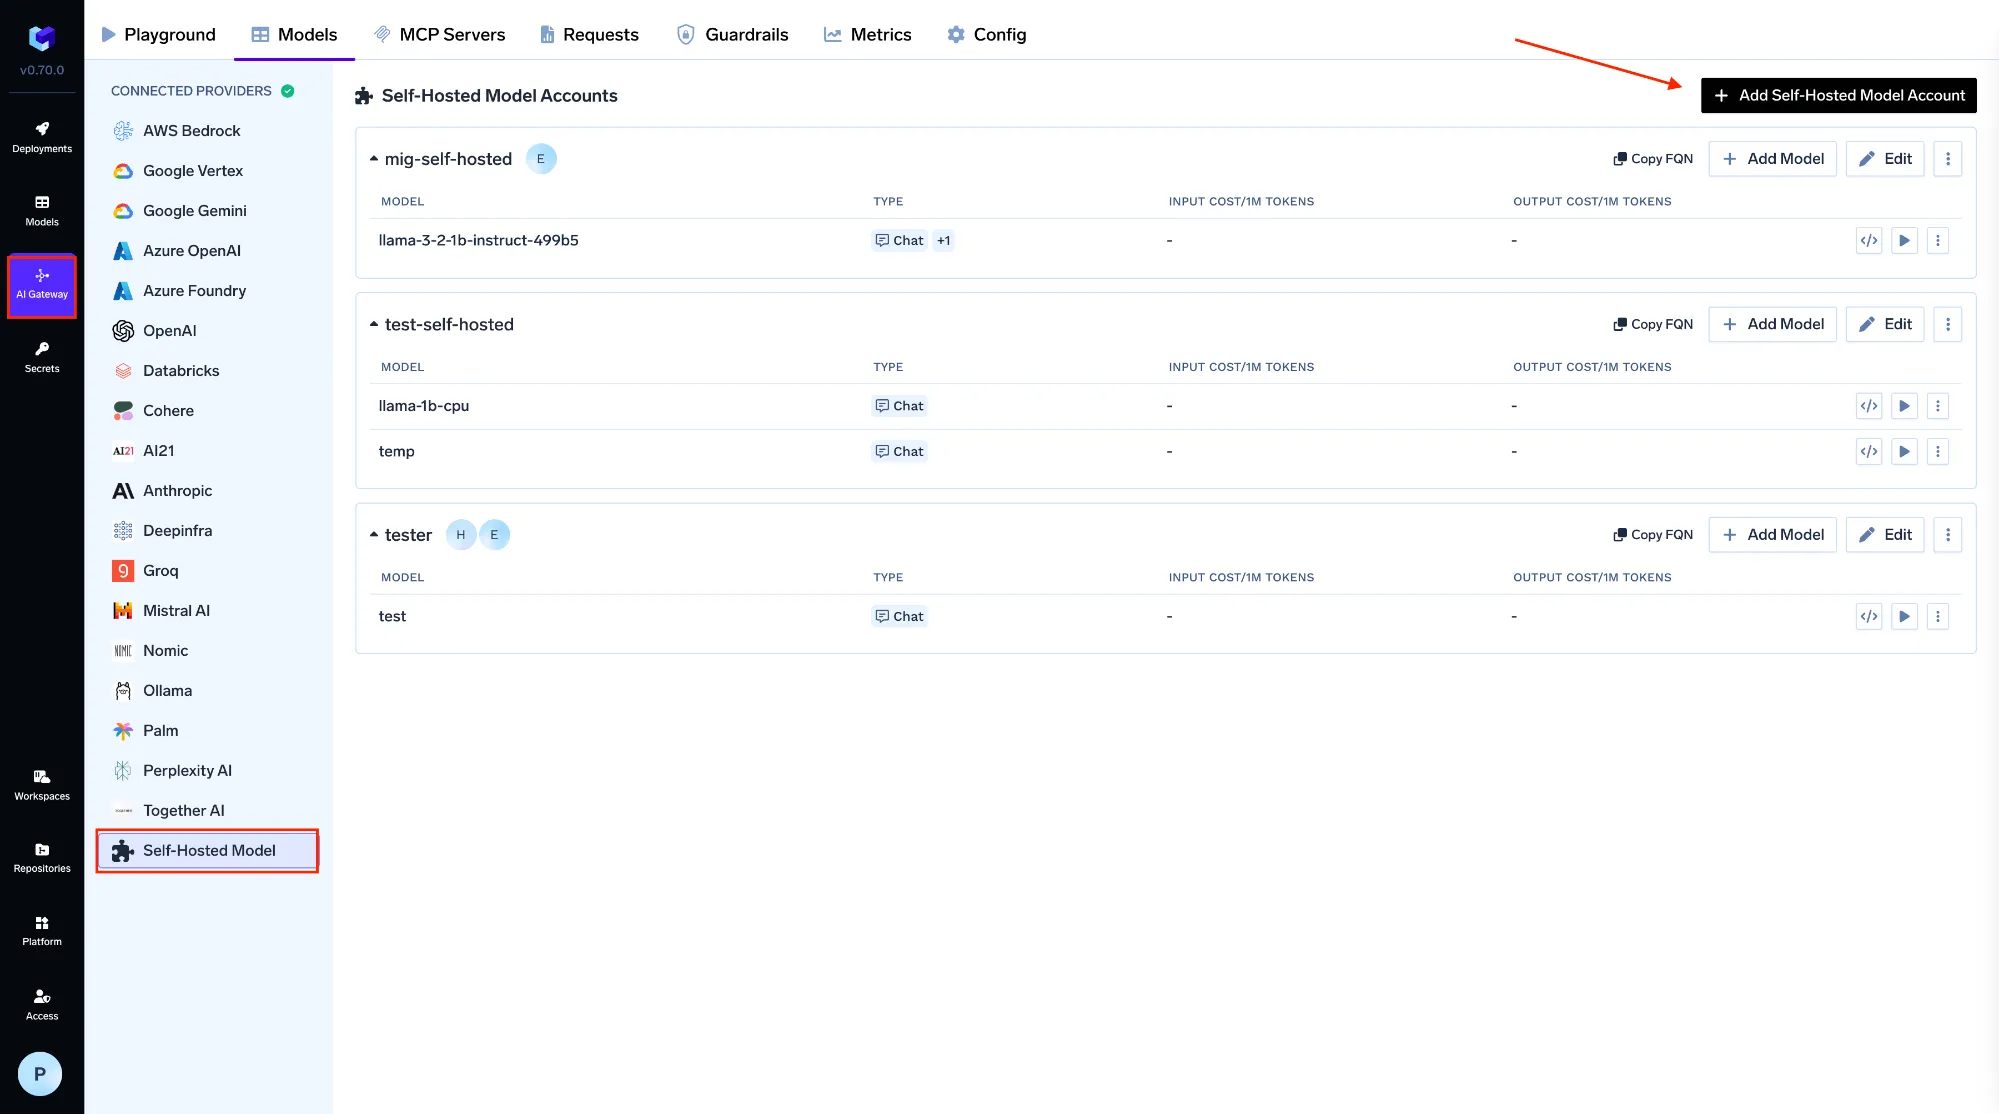
AIゲートウェイの「モデル」から「セルフホスト型モデル」を選択し、名前、モデルID、OllamaサーバーのURL、モデルサーバーの種類、および必要に応じて認証情報を登録します。これ以降、アプリケーションやエージェントは直接localhostのエンドポイントを叩くのではなく、統一されたAPIを持つゲートウェイを呼び出すようになります。
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-api-key",   # a gateway token, not a raw endpoint
    base_url="https://gateway.truefoundry.ai",
)

resp = client.chat.completions.create(
    model="self-hosted/llama-3-8b-ollama",   # your registered Ollama model
    messages=[{"role": "user", "content": "Summarize this ticket"}],
)
この一つの変更こそが、Ollamaをチームで利用可能にする鍵です。
このゲートウェイはプロバイダーに依存せず、1,000以上のモデルでOpenAI互換性があるため、ローカルのOllamaモデルとvLLMデプロイメント、クラウドAPIを同一インターフェース下で混在させることができます。これは以下に直結します。 AIエージェントのポータビリティ。また、TrueFoundryは貴社のVPC内で実行されるため、Ollamaを選択した最大の理由であるプライバシーがエンドツーエンドで保護されます。
Ollamaはローカルでモデルを動かすための最速の手段であり、プライバシーとコストの面でこれに勝るものはありません。しかし、本来チーム向けのインフラとして構築されていないため、アクセス制御、コストの可視化、ガードレール、ルーティングといった機能が必要となります。OllamaをAIゲートウェイにセルフホストモデルとして接続すれば、プライバシーと低コストを維持したまま、チームが本番環境で運用するために必要なすべての機能を手に入れることができます。
TrueFoundryがどのようにローカルモデルを、ガバナンスの効いたチーム対応インフラへと変えるのかをご覧ください。 デモを予約する または 無料で始める。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




Ollamaは、大規模言語モデルをお客様自身のハードウェア上でローカルに実行し、シンプルなOpenAI互換のHTTP APIの背後で提供するオープンソースのツールです。チームは、Llama、Mistral、Qwenなどのオープンウェイトモデルを使った、プライベートでオフラインかつ低コストの推論に利用しています。
Ollamaは1台のマシンでの手軽なローカル推論に最適化されており、vLLMは高い同時実行性を備えた高スループットの本番サービング向けに構築されています。どちらもOpenAI互換APIを公開しているため、多くのチームが開発にはOllamaを、本番にはvLLMを使い、両方を同じゲートウェイの背後に置いています。
モデルはお客様が管理するインフラ上で動作するため、プライバシーの面では優れていますが、生のOllamaエンドポイントにはアクセス制御、コストの帰属、コンテンツのガードレールがありません。チームで安全に利用するには、認証、RBAC、レート制限、PIIとシークレットの検査を追加するゲートウェイの背後に置いてください。
URLと認証情報を指定して、OllamaサーバーをセルフホストモデルとしてAI Gatewayに接続します。アプリケーションは生のエンドポイントではなくゲートウェイの統一APIを呼び出すようになり、Ollamaの上に共有のアクセス制御、コスト追跡、ガードレール、ルーティングが加わります。
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、Ollamaによるローカルでプライベートな推論が、スタック全体でプライベートなまま保たれます。