Built for Speed: ~10ms Latency, Even Under Load Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed Production-ready with full enterprise support 企業が生成AIの本番運用を進める中で、クラウドコストの削減、厳しいコンプライアンス要件への対応、超低遅延の実現などを目的に、多くの企業がオンプレミスアクセスのメリットを再発見しています。しかし、オンプレミスAIスタックは、ラックに設置して放置できる単一の機器ではありません。ハードウェア、オーケストレーション、データプラットフォーム、サービングフレームワークが高度に連携して動作する、レイヤー化されたエコシステムです。
本ガイドでは、現代のオンプレミスAIスタックの各レイヤーを解説し、各コンポーネントの価値提案を示します。
オンプレミスAIが注目を集める理由 金融、医療、製造、政府機関などのエンタープライズ企業は、強化されるデータ主権規制、増大するクラウド費用、パブリッククラウドでは常に満たせるとは限らないパフォーマンスSLAに直面しています。これらのレイヤーが一体となり、パブリッククラウドの制約から独立して拡張、ガバナンス、運用が可能なオンプレミスAIプラットフォーム
データの制御とコンプライアンス :機密データを完全にファイアウォールの内側に維持します。パフォーマンスとレイテンシー :リアルタイム推論のために計算資源とストレージを同処に配置します。データをローカルで処理することにより、オンプレミスAIは著しく低いレイテンシーを提供でき、さらに重要なことに、より予測可能なレイテンシーを実現できます。この一貫した高スループットのパフォーマンスは、センサーデータのストリームを分析しながら過去の記録と照合するなど、即時のクロスモーダルな意思決定を必要とするアプリケーションに不可欠です。このパフォーマンス上の優位性は、既存の企業システムとの統合にも及びます。オンプレミスソリューションは、その柔軟性とカスタマイズ性により、標準化されたクラウド環境とは互換性がない可能性のあるレガシーデータベース、ERPシステム、その他のオペレーショナルテクノロジーと、より容易かつ確実に統合できることがよくあります。コストの予測可能性 :変動する従量課金制から固定のインフラ投資へとシフトします。データの送信費用(Egress料金)、API呼び出し、ストレージのティアリング、変動するコンピューティング価格などの隠れた費用は、低い初期投資(CapEx)の利点を急速に損ない、一部の分析でクラウド支出における「純粋な無駄」と呼ばれる状態を引き起こす可能性があります。対照的に、オンプレミス展開は初期費用が高いものの、長期的に予測可能で管理しやすい運用費用(OpEx)を提供します。AIを継続的に利用する組織にとって、オンプレミスインフラストラクチャは3〜5年の期間で見ると、より費用対効果の高い選択肢となることが多くあります。カスタム統合 :レガシーシステム、エッジデバイス、または独自のハードウェアとシームレスに接続します。しかし、このスタックを自社内で構築・運用することには、資本支出、専門的な人材要件、および継続的なメンテナンスのオーバーヘッドが伴います。
現代のオンプレミスAIスタックとは? 現代のオンプレミスAIスタックは、各コンポーネントが重要な役割を果たす複雑な多層システムです。単一の巨大な構造体ではなく、堅牢で拡張可能かつ効率的なAI機能を提供するために設計された、ハードウェアとソフトウェアの相互依存的エコシステムです。このスタックを理解するには、圧倒的なパワーを提供する物理インフラストラクチャからAIワークフローを可能にするハイレベルなプラットフォームに至るまで、レイヤーごとの分解が必要です。
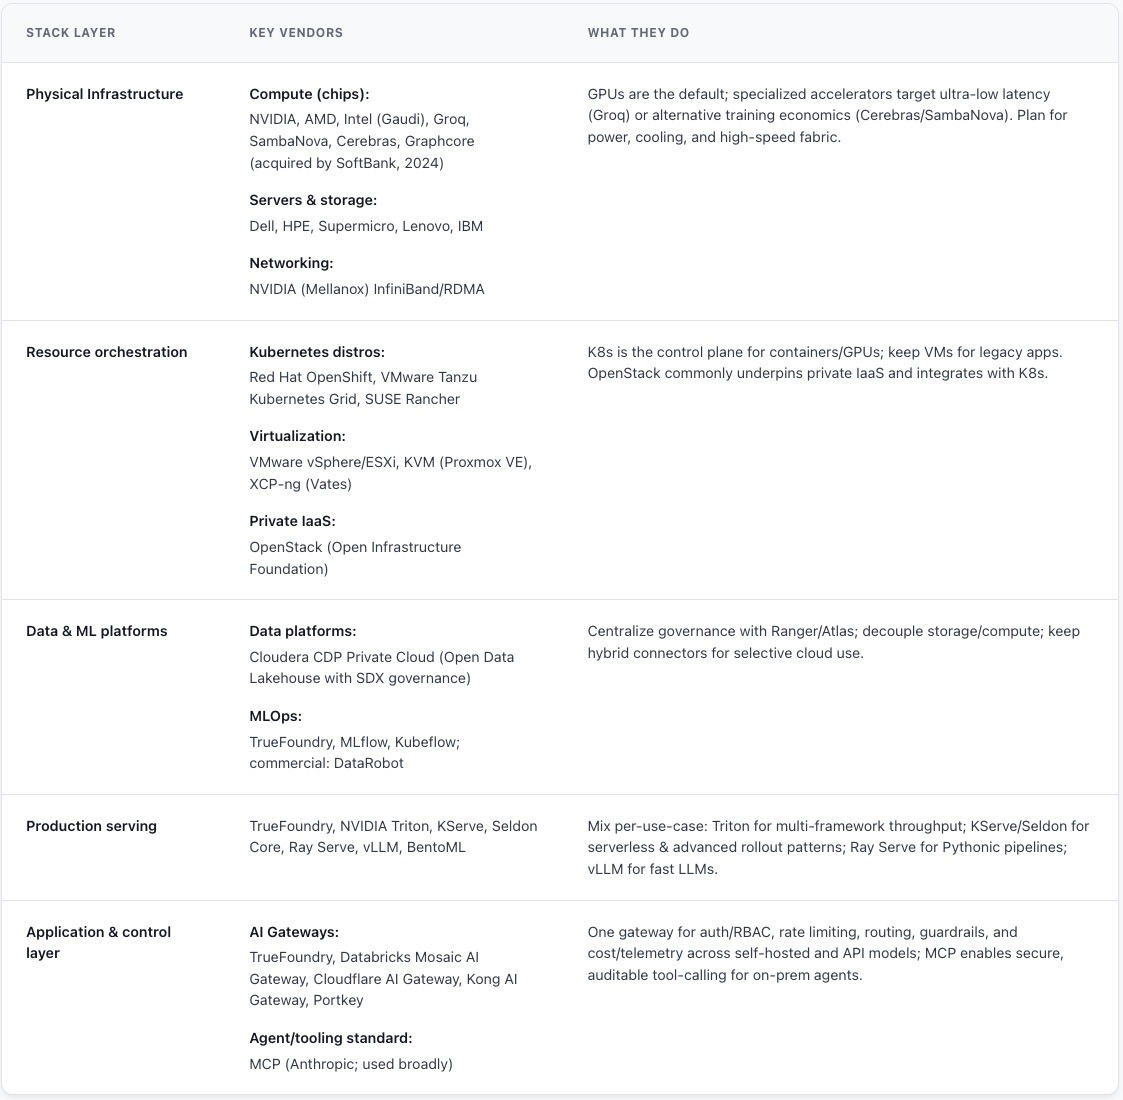
物理インフラストラクチャ (コンピューティング、ストレージ、ネットワーク)リソースオーケストレーション (仮想化、コンテナ、Kubernetes)データおよびMLプラットフォーム (データレイク、MLOpsツール)プロダクションサービング (推論フレームワーク、スケーリング、ガバナンス)アプリケーションおよび制御レイヤー (MCP 、AI Gateway )単一のベンダーにロックインされることなく、稼働率を最大化し、信頼性を確保し、シームレスなスケーリングを可能にするよう、各レイヤーを設計する必要があります。
ハードウェアおよび物理インフラストラクチャ これはAIスタック全体の土台であり、計算能力が物理的な形をとったものです。計算を行うコンピューティングエンジン、膨大なデータセットを保持するストレージシステム、そしてすべてを接続するネットワークファブリックで構成されます。このレイヤーのパフォーマンスと制限が、それ以降のすべてのレイヤーの可能性を決定づけます。
コンピューティングエンジン GPU :元々は3Dグラフィックスのレンダリング用に設計されたGPUですが、その大規模な並列アーキテクチャにより、AI革命の牽引役となりました。NVIDIAは、A100、H100、そして今後登場するB200シリーズなどのデータセンター向けGPUにより、この市場で支配的な地位を確立しています。数千もの専門コア(Tensor Coreなど)を備えたこれらのチップは、従来のCPUと比較して最大20倍高速なAI学習パフォーマンスを提供できます。これらは現在、高性能なオンプレミスAI学習クラスタを構築するための実質的な業界標準となっています。CPU :GPUが並列処理の重タスクを処理する一方で、CPUはAIサーバーの必須コンポーネントであり続けています。システム全体の動作を管理し、シーケンシャルな処理タスクを扱い、GPUへのデータフローをオーケストレートします。IntelやAMDの最新世代マルチコアCPUは、専門のアクセラレータをサポートするために必要な汎用コンピューティングパワーを提供します。ASIC / TPU :AIコンピューティングにおける新たな破壊的トレンドは、特定用途向け集積回路(ASIC)の台頭です。これらは、AIワークロードの実行という単一の目的のためにゼロから設計されたチップです。GoogleのTensor Processing Units(TPU)はその代表例であり、ニューラルネットワークの中心となる行列演算に最適化されています。オンプレミス市場では、スタートアップ企業の新しい波が専門化されたASICでGPUの独占に挑んでいます。Groq のような企業は超低遅延推論用のチップを開発しており、SambaNova Systems やCerebras は、大規模な学習と推論において優れたTCOと電力効率を約束する新しいアーキテクチャ(それぞれReconfigurable Dataflow UnitとWafer-Scale Engine)を創出しています。これらの専門アクセラレータは、汎用GPUの電力とコストの限界を超える道を示し、AIハードウェアの未来を象徴しています。エンタープライズサーバーとストレージ ハイパフォーマンスサーバー :ProLiantおよびApolloラインナップを持つHewlett Packard Enterprise (HPE) 、PowerEdgeサーバーを持つDell Technologies 、Supermicro 、そしてPower Systemsを持つIBM などの大手エンタープライズハードウェアベンダーが、オンプレミスAI用のサーバーシャーシを提供しています。これらは標準的なサーバーではなく、複数の高電力GPUを収容し、大量の高速メモリ(RAM)を提供し、アクセラレータの熱出力を処理するための高度な冷却ソリューションを組み込むよう特別に設計されています。ハイパフォーマンスストレージ :AIはデータによって駆動されるため、ストレージレイヤーはボトルネックを生み出すことなく、大量のデータセットへの迅速かつ並行したアクセスを提供しなければなりません。これには従来のストレージを超えた移行が必要です。NVMe (Non-Volatile Memory Express) SSD や分散ファイルシステム などの高性能かつ低遅延のストレージソリューションが不可欠です。データ自体は通常、大量の未構造化データ(画像、テキスト、ログ)を保存するためのデータレイク と、構造化された分析用データのためのデータウェアハウス に整理されます。特に生成AIにとって重要な新しいコンポーネントはベクターデータベース であり、非構造化データを表す高次元のベクター埋め込みの保存とクエリに最適化されています。高速ネットワーク InfiniBandおよびRDMA ファブリックは最大400 Gbpsの低遅延スループットを提供し、分散学習や並行推論中にGPUへデータが供給され続けることを保証します。ネットワークレイヤーはAIデータセンターの「神経系」であり、ストレージシステムと計算ノード間のシームレスなデータ転送を担います。大規模AI、特に単一のモデルを数百または数千のGPUにわたって学習させる分散学習では、標準のエレクトロニクスネットワークでは不十分であり、大きなパフォーマンスのボトルネックとなる可能性があります。データ待ちで強力なGPUがアイドル状態になるのを防ぐため、オンプレミスAIクラスタは高帯域幅で低遅延のネットワークファブリックに依存しています。InfiniBandやRDMA(Remote Direct Memory Access)などの技術が重要です。たとえばInfiniBandは最大400 Gbpsのスループットをサポートでき、計算エンジンをフル活用し続けるために必要な速度でサーバー間およびストレージ間でデータを移動できます。この高速相互接続は、真剣なオンプレミスAIインフラストラクチャにおいて譲れないコンポーネントです。オーケストレーションおよび管理レイヤー 物理ハードウェアの上に位置するオーケストレーションおよび管理レイヤーは、基礎となるリソースを抽象化、パーティショニング、管理するソフトウェアで構成されます。このレイヤーは、物理サーバーの固定的なコレクションを、AIアプリケーションの開発と実行のための柔軟でスケーラブルかつ効率的なプラットフォームへと変換します。
仮想化とコンテナ化の役割 リソース管理の基礎となる技術は、仮想化とコンテナ化です。これらはワークロードの効率的なパーティショニングと分離を可能にします。
仮想マシン(VM) :仮想化は数十年にわたりデータセンターの主役でした。ハイパーバイザーは単一の物理サーバー上に複数の仮想マシンを作成し、それぞれが独自の完全なオペレーティングシステムを持ちます。堅牢で十分に理解されているものの、VMはコンテナと比較してリソースフットプリントが大きく、起動時間が遅くなります。しかし、新しいAIワークロードとともにレガシーアプリケーションをモダン化する場合には、依然として有用です。IBM FusionやVates VMSなどのプラットフォームは、直接的なGPUアクセスなどの機能を備え、VMとコンテナの両方を管理できる統合されたオンプレミスプラットフォームを提供するよう特別に設計されています。コンテナ(例:Docker) :コンテナ化は、ワークロードの分離に対する現代的で軽量なアプローチです。コンテナは、アプリケーションとすべての依存関係(ライブラリ、設定ファイル)を、ホストOSのカーネルを共有する単一のポータブルなユニットにパッケージ化します。これにより、VMよりも大幅に小さいフットプリント、高速な起動時間、優れたリソース効率が実現します。AIにおいて、これはモデルとその特定環境を不可逆なコンテナ画像(immutable container image) にカプセル化できることを意味します。この画像は、開発者のラップトップ、テストサーバー、プロダクションクラスタ全体で一貫してデプロイでき、「自分の環境では動いた」という問題を排除し、再現性を確保します。Kubernetes:AIデータセンターのOS Dockerがコンテナフォーマットを提供するのに対し、Kubernetes は大規模な管理を提供します。Kubernetesは、マシンクラスタ全体でのコンテナ化アプリケーションのデプロイ、スケーリング、ネットワーク、管理を自動化するオープンソースプラットフォームです。コンテナオーケストレーションの圧倒的な標準となっており、パブリッククラウドであれオンプレミスであれ、ほとんどの現代的クラウドネイティブアプリケーションのエンジンとなっています。
オンプレミスAIにとって、Kubernetesはアプリケーションレイヤーとハードウェア間の重要な架け橋です。Red Hat OpenShift のようなエンタープライズグレードのKubernetesディストリビューションは、オンプレミスおよびハイブリッドクラウド展開向けに特別に設計されており、企業が必要とするセキュリティ、管理、サポートを提供します。
AIワークロードにKubernetesを使用するメリットは非常に大きいです:
自動スケーリングとロードバランシング: Kubernetesは、計算の需要に基づいてコンテナレプリカの数を自動的に拡大縮小し、推論リクエストをそれらの間で分散させ、高い利用可能性とパフォーマンスを確保できます。リソース管理とスケジューリング: KubernetesはGPUを意識したスケジューリング機能を持ち、利用可能なアクセラレータハードウェアを持つノードにAIワークロードをインテリジェントに配置し、これらの高価なリソースの利用率を最大化します。回復性とセルフヒーリング: コンテナやノードが障害を起こした場合、Kubernetesは自動的に再起動するか、正常なノードに再スケジュールすることができ、長期実行されるモデル学習ジョブやミッションクリティカルな推論サービスに必要な回復力を提供します。本質的に、KubernetesはオンプレミスAIデータセンターのための動的で自動化された、回復力のあるオペレーティングシステムを提供します。
データおよびMLのエネーブルメント データプラットフォームとガバナンス これはスタックの最も高い位置にあるソフトウェアレイヤーであり、データサイエンティストや機械学習エンジニアがエンドツーエンドのAIライフサイクルを実行するために使用する専門ツールやプラットフォームが含まれます。このレイヤーは、基礎となるハードウェアとオーケストレーションを活用してデータを管理し、AIモデルの構築、学習、デプロイ、監視を行います。
データファブリック(データプラットフォーム) モデルを構築する前に、データを管理する必要があります。データプラットフォームは、データの収集と処理から保存とガバナンスに至るまで、データライフサイクル全体に統一された環境を提供します。
Cloudera Data Platform (CDP): オンプレミスおよびハイブリッドデータ領域で優位に立つClouderaは、Hadoopエコシステムでの起源から発展し、包括的なエンタープライズデータプラットフォームとなりました。CDP Private Cloud ソリューションは、通常Red Hat OpenShiftのようなKubernetesクラスタ上で動作するよう、オンプレミス向けに特別に設計されています。ペタバイトスケールで構造化および非構造化データの両方を扱える、統一されたオープンな データレイクハウス Apache Ranger を通じた堅牢な集中型セキュリティと、Shared Data Experience (SDX) と呼ばれる統一されたガバナンスおよびメタデータフレームワークを統合しており、ハイブリッド環境全体ですべてのデータと分析に一貫したセキュリティポリシーが適用されることを保証します。Databricksとハイブリッド接続: Databricksは主にクラウドネイティブなプラットフォームですが、AI分野での圧倒的な存在感から、多くの組織がClouderaクラスタなどのオンプレミスデータソースをDatabricks環境に接続するソリューションを構築しています。この現実は現代のエンタープライズAIにおけるハイブリッドな本質を際立たせており、特定の分析やコラボレーションタスクにクラウドベースのツールを活用する一方で、データの重力(Data Gravity)によって大容量データセットをオンプレミスに維持せざるを得ないケースが多く存在します。MLOpsと実験管理 MLOps(Machine Learning Operations)は、本番環境で機械学習モデルを信頼性高く効率的にデプロイ・維持することを目的とした一連のプラクティスです。MLOpsプラットフォームはこれらのプラクティスを可能にするツールであり、MLライフサイクル全体を自動化し、データサイエンス(モデルの構築)とIT運用(本番での実行)のギャップを埋めます。
MLOpsプラットフォームの主な機能には、実験トラッキング(すべてのパラメータ、メトリクス、アーティファクトのロギング)、モデルのバージョン管理とレジストリ、モデル用の自動CI/CD(継続的インテグレーション/継続的デプロイ)パイプラインの構築、モデルデプロイの管理、データドリフトなどの問題に対するモデルパフォーマンスの監視が含まれます。
オンプレミスMLOps市場には、強力なオープンソースと商用プラットフォームが混在しています:
オープンソース:MLflow は主要なオープンソースMLOpsプラットフォームであり、その柔軟性、フレームワークに依存しないアプローチ、および実験トラッキングとモデル管理のための包括的な機能により広く採用されています。チームはベンダーロックインなしで堅牢なMLOpsワークフローを構築できます。商用プラットフォーム:DataRobot やIguazio(McKinseyにより買収) のようなエンドツーエンドのマネージドプラットフォームは、ライフサイクル全体をカバーする包括的なソリューションを提供し、使いやすさ、自動化、エンタープライズグレードのサポートに重点を置いていることが多くあります。プラットフォームの選択にTrueFoundryのAI GatewayのRBAC、ガードレール、予算管理を補完することで、チームやモデル全体でポリシーがシームレスに適用されるよう徹底できます。
本番環境におけるAIのサービングとスケーリング モデルの学習と検証が完了したら、入力データを受け取り予測を返す本番環境にデプロイする必要があります。このプロセスを推論と呼びます。モデルサービングは、高スループットと低遅延のために最適化されたソフトウェアを必要とする専門的なタスクです。
NVIDIA Triton Inference Server: NVIDIAが提供する高性能オープンソース推論サーバーです。最大の強みは、ほぼあらゆるフレームワーク(TensorFlow、PyTorch、ONNXなど)のモデルを実行できる能力と、単一のGPU上で複数のモデルや同一モデルの複数インスタンスを実行してハードウェア利用率を最大化する並行モデル実行能力にあります。KServe: Kubernetes上でのモデルサービングの標準規格です。KServeはモデルをデプロイするための拡張可能でスケーラブルなプラットフォームを提供します。主な機能には、サーバーレス推論機能(未使用時にポッドをゼロにスケールダウンしてリソースを節約するオートスケーリング機能を含む)や、カナリアリリース、A/Bテスト、モデルアンサンブルなどの高度なデプロイ戦略をサポートする「InferenceGraph」があります。Seldon Core: Kubernetes向けのもう一つの強力なオープンソースモデルサービングプラットフォームです。Seldon CoreもA/Bテスト、カナリアデプロイ、マルチアームドバンディット(MAB)などの高度なデプロイパターンの堅牢なサポートで知られており、本番環境でモデルを厳密にテスト・最適化する必要がある組織にとって強力な選択肢となります。その他のフレームワーク: エコシステムには、複雑なエージェント型およびRAGパイプラインを構築するためのフレームワークであるHaystack や、大規模AIアプリケーションの学習およびサービングのバックボーンとしてよく使用される分散計算エンジンであるRay など、他の強力なオープンソースツールも含まれています。TrueFoundryは、これらのサーバーの上位に位置するGateway / コントロールプレーン として機能するため、一貫した単一のインターフェース、ポリシー、テレメトリレイヤーを維持しながら、自由に組み合わせて使用できます(コンピュータビジョンモデルにはTriton、LLMにはvLLM、サーバーレスエッジにはKServeなど)。
アプリケーションおよび制御レイヤー:AI GatewayとMCP これまでに説明したレイヤーは、AIモデルを構築し実行するための基盤を提供します。しかし、これらのモデルをエンドユーザーアプリケーションから安全かつ効率的にアクセス可能にし、複雑なエージェント型ワークフローを有効にするには、最後のソフトウェアレイヤーであるアプリケーションおよび制御レイヤーが必要です。このレイヤーは、すべてのAIインタラクションの中枢神経系として機能し、ガバナンス、セキュリティ、および通信のための標準化されたインターフェースを提供します。これは、AI GatewayとModel Context Protocol (MCP) という2つの重要で新しいコンポーネントで構成されています。
AI Gateway:集中型コントロールプレーン AI Gatewayは、アプリケーションと基礎となるAIモデルとの間のすべてのAI関連トラフィックに対して、単一の集中管理ポイントとして機能する専門的なミドルウェアです。オンプレミス環境内(多くの場合Kubernetes上)にデプロイされ、エンタープライズスケールでAIを管理するための重要な一連の機能を提供します。
一貫したアクセスとインテリジェントなルーティング: Gatewayは開発者に一貫した単一のAPIエンドポイントを提供し、複数の異なるモデル(ファインチューニングされたオープンソースモデルと専門的な商用モデルの混合など)とのやり取りの複雑さを抽象化します。コスト、パフォーマンス要件、または特定のユースケースなどの要因に基づいて、最も適切なモデルにリクエストを誘導するコンテキストベースのルーティングを実行でき、効率と結果の両方を最適化します。堅牢なセキュリティとガバナンス: オンプレミスAIにとってセキュリティは最優先事項です。AI Gatewayはポリシー適用ポイントとして機能し、企業のセキュリティアーキテクチャと統合して認証、認可、およびロールベースアクセス制御(RBAC)を管理します。プロンプトインジェクション攻撃や個人識別情報(PII)などの機密データの漏洩を防ぐため、受動プロンプトと応答の両方をリアルタイムで検査し、GDPRやHIPAAなどの規制への準拠を確実にします。包括的なオブザーバビリティとコスト管理: GatewayはすべてのAIインタラクションを監視するための統合ダッシュボードを提供し、レイテンシー、エラー率、トークン使用量などの主要なメトリクスを追跡します。この集中化されたオブザーバビリティは、トラブルシューティングとパフォーマンスの最適化に不可欠です。さらに、トークンベースのレート制限や使用予算を適用することで粒度の細かいコスト制御を可能にし、コストの暴走を防ぎ、異なるビジネス部門への正確な部門間課金(チャージバック)を可能にします。Model Context Protocol (MCP):AIエージェントのための共通言語 AI Gatewayがリクエストのフローを管理する一方で、Model Context Protocol (MCP) はそれらのリクエストが何を行えるか を革新するオープン標準です。MCPは、AIモデルが外部ツール、データ、サービスを発見して相互作用するための標準化された方法を提供し、モデルを分離された「頭脳」から能力のある統合されたエージェントへと変化させます。
ツール向けの標準化されたインターフェース: MCPにより、連携ごとに脆弱なカスタムコードを作成する代わりに、エンタープライズシステム(データベース、CRM、内部APIなど)が軽量な「MCP server」を介して自らの機能を宣言できるようになります。「MCP host」として機能するAIアプリケーションは、これらのサーバーに問い合わせて利用可能なツールとその使用方法を理解できるため、AI agentのためのプラグアンドプレイなエコシステムが効果的に構築されます。 オンプレミスAgentic AIの実現: MCPの主な強みは、組織のファイアウォール内に完全にデプロイできる、オープンで監査可能なプロトコルである点です。これにより企業は、外部サービスに機密データを晒すことなく、プロプライエタリな内部システムと安全に相互作用する強力で自律的なAI agentを構築できます。 ベンダーロックインの防止: MCPはAnthropic、OpenAI、Microsoftなどの主要なプレイヤーによってサポートされているモデルアグノスティックな標準であるため、AIモデルをツール連携から切り離すことができます。これにより企業は、連携スタック全体を再構築することなく、ベースとなるLLMを切り替える(例: 商用APIからセルフホストのファインチューニング済みモデルへの移行など)柔軟性を得られ、技術的主権を維持できます。 AI GatewayとMCPが合わさることで、オンプレミスAIを単に可能にするだけでなく、安全で管理しやすく、企業の構造に真に統合されたものにする強力な制御およびアプリケーション層が形成されます。
TrueFoundryのMCP Gatewayは両方を兼ね備えています。すべてのリクエストに対するガバナンスとオブザーバビリティに加え、MCPを介した安全で監査されたツール呼び出しを提供するため、データがネットワーク外に出ることなく、agentが内部システム上でアクションを実行できます。
オンプレミスAIスタック全体のベンダーマッピング TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.