



October 9, 2026
|
5 min read

Published: October 9, 2026

Blazingly fast way to build, track and deploy your models!
かつてOpenRouterのホームページには、ユーザーと推論の間に約25msの遅延が加わると記載されており、現在も多くのガイドがこの数値を引用しています。現在のホームページでは「最小限のレイテンシ」とだけ記載されています。Claudeで測定したところ、最初のトークンが到着するまでに何度か遅延が発生し、それ以降により大きなコストがかかっていることがわかりました。
今回の測定はAnthropicを対象としています。OpenRouterがどれだけの遅延を追加しているのか、その時間はどこで消費されているのか、そしてなぜ独自のAnthropicキーを使用することでその大半が解消されるのかを検証しました。1回目の実行では短いプロンプトを使用し、2回目では最大20,000トークンのプロンプトを使用しました。両方の実行における制限事項は「検証しなかった項目」のセクションに記載しており、これらは中央値と同様に数値を規定する要因となっています。
すべてのリクエストは、「AnthropicのAPIへ直接送信」「OpenRouterのクレジットを使用して送信」「独自のAnthropicキー(BYOK)を使用してOpenRouter経由で送信」の3つの経路で行いました。同じプロンプトを各経路で実行し、順序を交互に入れ替えることで、ネットワークの変動が3つの経路すべてに均等に影響するようにしました。すべての比較はペアで行われ、各プロンプトを別の経路の結果と比較することで、プロンプトの内容による差異を相殺しています。
OpenRouterのリクエストは、BedrockやVertexではなくAnthropicの独自エンドポイントに固定し、フォールバックはオフにしました。また、すべてのレスポンスにおいて、どのエンドポイントが処理したか、および独自のキーが使用されたかどうかを確認しました。温度(Temperature)は0に設定し、接続は再利用しました。
測定は2回行いました。9月7日には、公開データセットから抽出した4〜37トークンの短いプロンプトを100個ずつ、2つのセッションで実行しました。9月14日には、99個のプロンプトを「入力200トークン・出力100トークン」「入力2,000トークン・出力500トークン」「入力20,000トークン・出力1,000トークン」の3サイズに調整して実行しました。すべて1台のノートPCから家庭用Wi-Fi経由で、OpenRouterのロサンゼルスエッジサーバーに対して行いました。これにより絶対的なレイテンシは大きくなりますが、ペアリングによって経路間の差分のみを抽出しているため、結果は有効です。
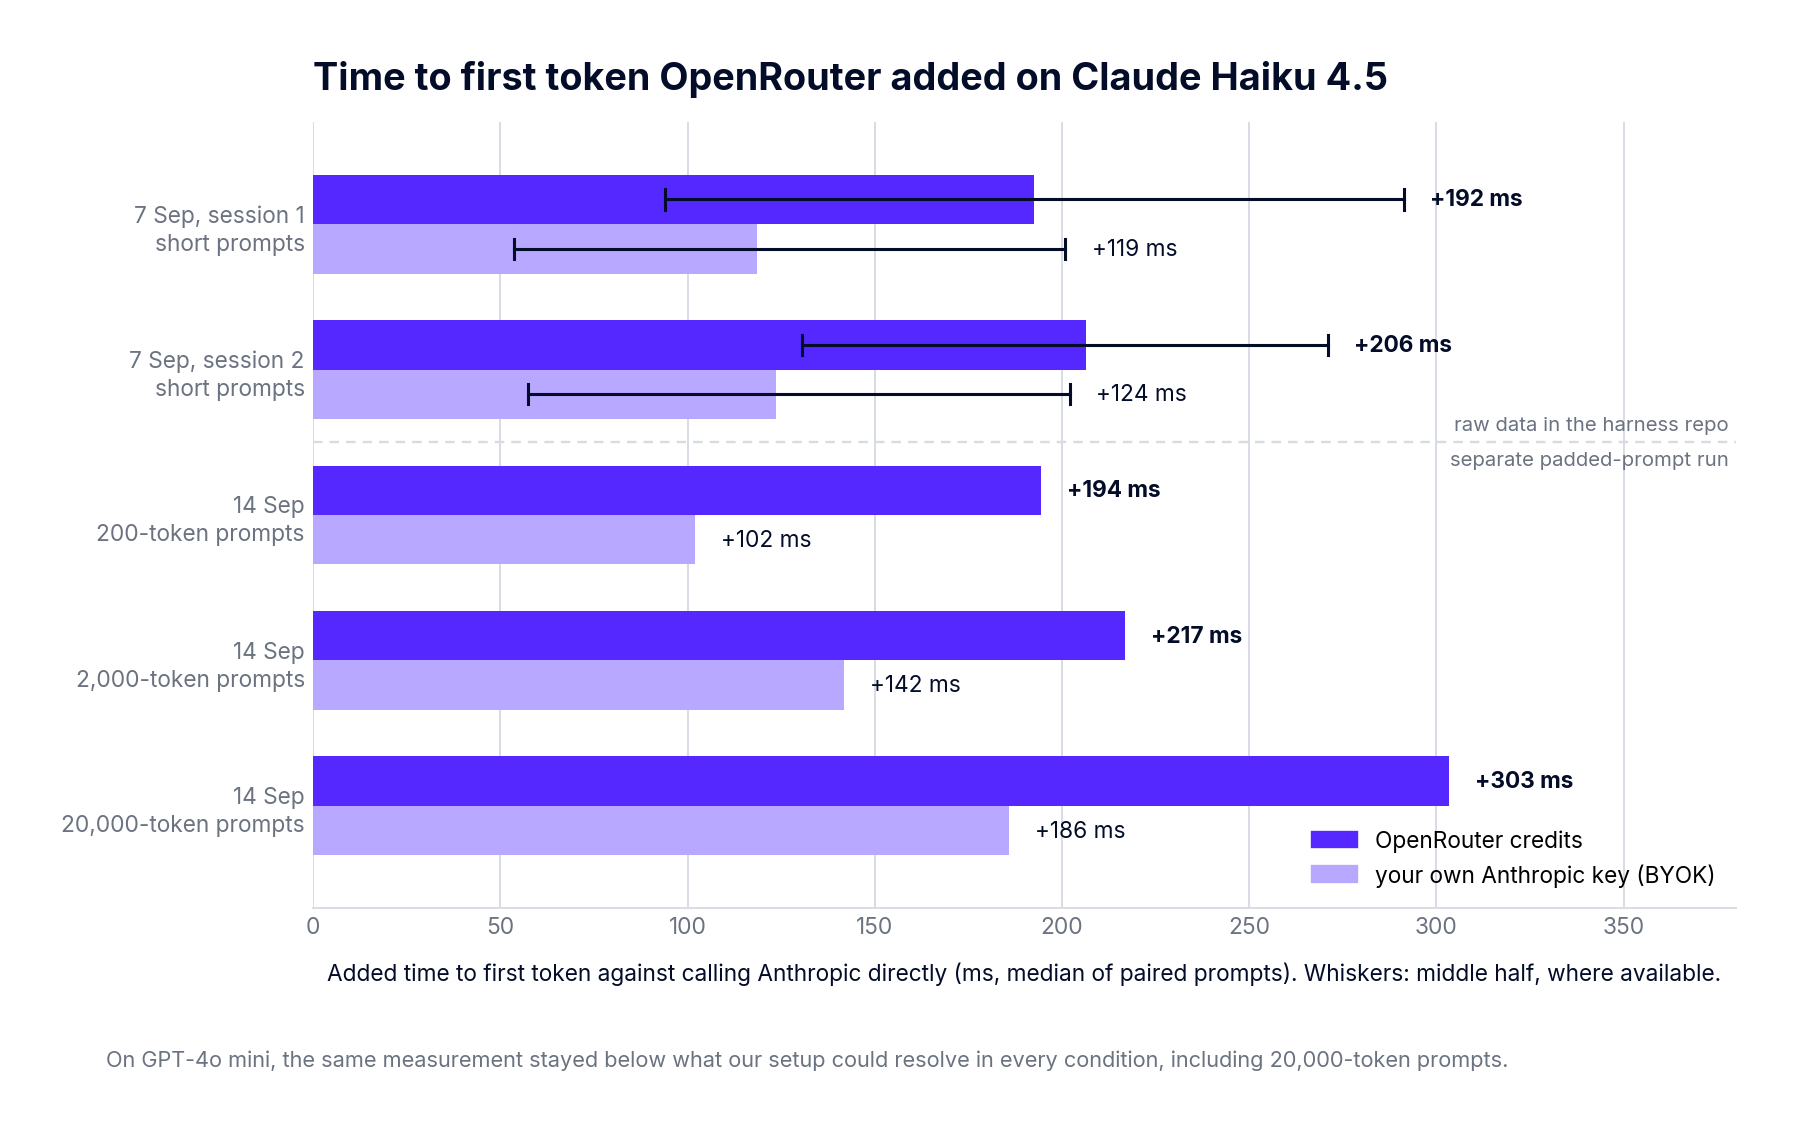
最初のトークンにかかるコストは一定でした。クレジット利用時は第1セッションで192ms、第2セッションで206ms、1週間後の200トークン設定で194msでした。独自のキーを使用した場合は119ms、124ms、102msでした。1週間空けて異なるプロンプトセットで2回実行し、約20ms以内の差に収まったことは、クライアントサイドのテストとしては十分な再現性と言えます。クレジット利用と独自キー利用を並行して行った4つのセッションすべてにおいて、クレジット利用の方が毎回最初のトークンまでの時間が長く、中央値で50〜115msの差がありました。
この遅延はプロンプトサイズに応じて増加します。入力200トークンから20,000トークンに増やすと、最初のトークンまでの追加時間はクレジット利用で194msから303msへ、独自キー利用で102msから186msへ増加しました。この増加は線形ではなく、入力が100倍になっても約1.6〜1.8倍程度であり、20,000トークンで初めて顕著になりました。5,000トークンで停止した以前の調査では、この傾向は見られませんでした。入力が4〜37トークンに限定された短いプロンプトの実行では、関連性は全く見られませんでした。
GPT-4o miniでは、20,000トークンのプロンプトを含め、すべての条件下で測定値はノイズの範囲内に収まりました。最初のトークンまでの追加時間は中央値で19.7msでしたが、結果の半分は直接呼び出しよりも85ms速いものから157ms遅いものまで幅があり、実際の数値は今回のセットアップで判別できる範囲よりも小さいと言えます。
最初のトークンまでの時間は、ストリーミングレスポンスの一部に過ぎません。各レスポンスを「最初のトークンまでの待機時間」と「残りのストリーミング時間」に分けると、2つの別々のコストが見えてきます。
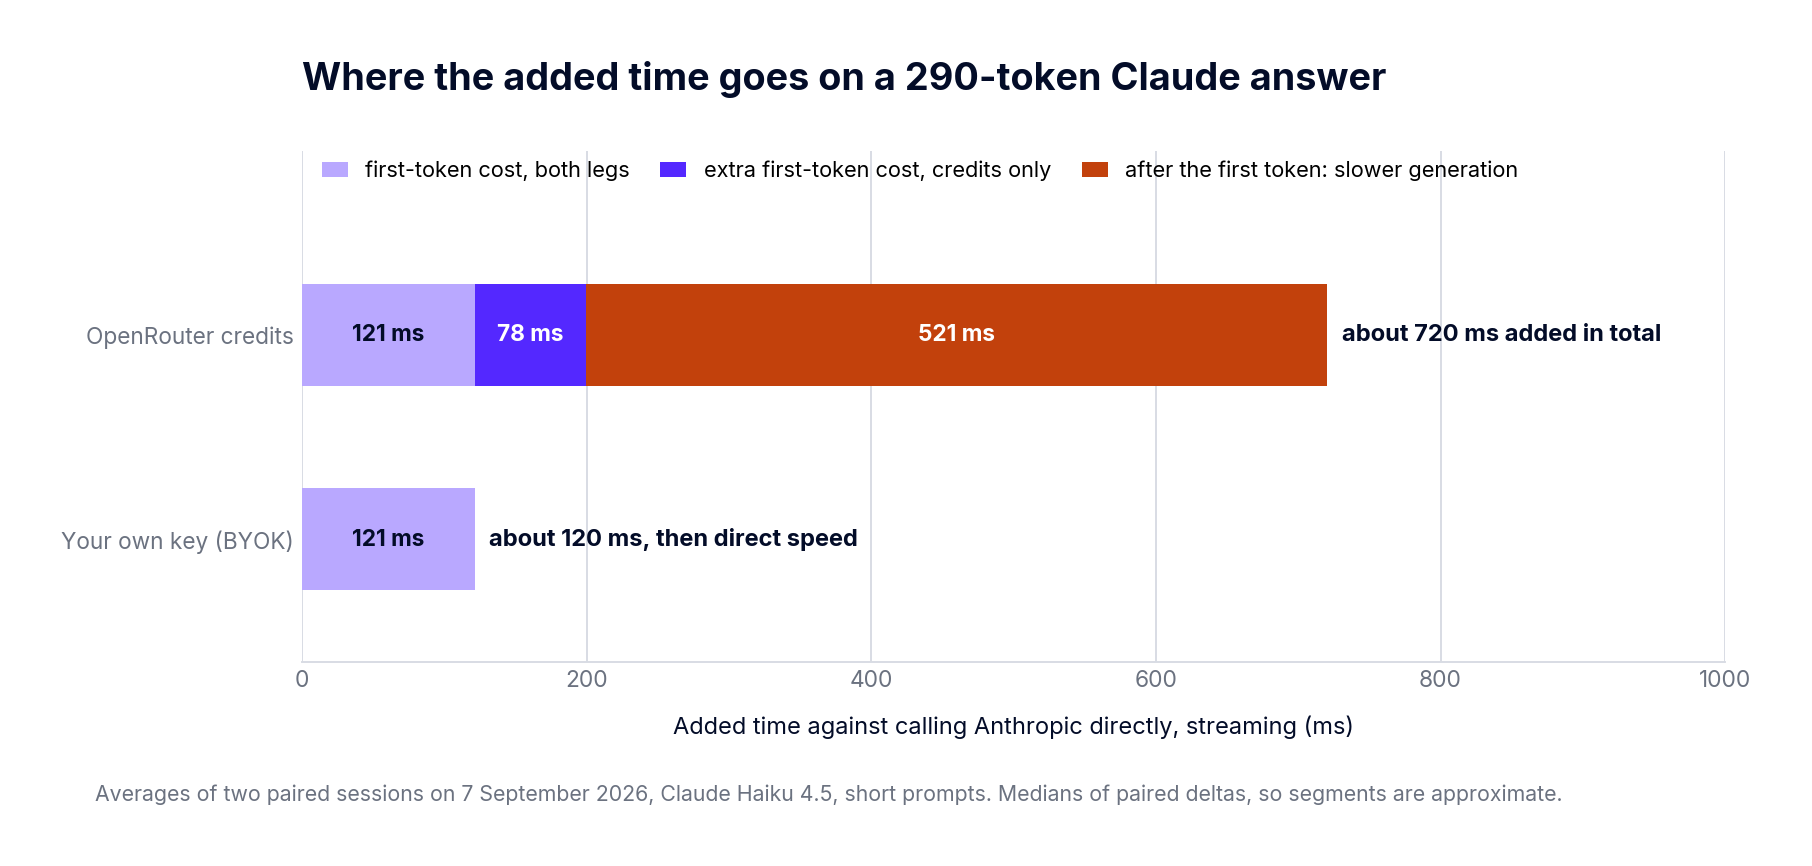
独自のキーを使用した場合、OpenRouterが追加したのは最初のトークンまでの約120msのみで、それ以降の追加はありませんでした。独自のキーでのストリーミング速度は2つのセッションで毎秒115トークンおよび116トークンであり、直接呼び出した場合の115トークンおよび113トークンと同等でした。このコストが何であれ、それは最初に一度だけ支払われるものです。
クレジット利用の場合、同じ回答のストリーミング速度は毎秒94トークンおよび95トークンと、約17%低速でした。回答の長さは変わらず、どの経路でも中央値は約290トークンでした。290トークンの回答において、このストリーミングの遅延は最初のトークンのコストに加えて約520msの時間を追加します。計算は合致します。毎秒114トークンではなく94トークンで290トークンを処理すると約540msの差が生じ、これに最初のトークンまでの約200msを加えると、測定されたフルレスポンスの711msおよび730msという数値と一致します。
この生成ペナルティは両方の実行で確認されましたが、その規模は一定ではありませんでした。9月14日のデータでは、最初のトークン以降の追加時間は100、500、1,000トークンの回答に対してそれぞれ約130ms、215ms、280msであり、9月7日よりも大幅に小さい値でした。これらの数値はペアの差分ではなく中央値から算出されているため概算として扱うべきですが、傾向は明らかです。最初のトークンのコストは日やプロンプトサイズに関わらず一定でしたが、生成ペナルティは変動しました。
これら2つのコストは、それぞれ異なる原因を示唆しています。
最初のトークンのコストは、独自のキーを使用した場合とクレジットを使用した場合の両方で発生するため、これは「誰のアカウントで支払うか」という問題ではなく、OpenRouterからAnthropicに至る経路に起因するものと考えられます。最も可能性が高いのは、OpenAI形式のリクエストをAnthropicのMessages形式に変換する処理、およびストリームを元に戻す変換処理、あるいはOpenRouterのエッジからAnthropicまでのネットワーク経路です。プロンプトサイズが大きくなるにつれてコストが増加する点は、リクエストに応じて変換処理の負荷が拡大するため、前者の仮説と合致します。手元のデータではこれら2つを切り分けることはできず、形式変換を必要としないGPT-4o miniで測定可能なコストが発生しなかったことも、どちらの仮説とも矛盾しません。OpenRouterのネイティブなAnthropicエンドポイントである /api/v1/messagesを経由して同じリクエストを送信する実験を行えば結論が出るはずですが、現時点ではまだ実施していません。
生成ペナルティについては状況が異なります。クレジットと独自のキーは、同じゲートウェイ、同じ変換処理、そして同じAnthropicエンドポイントを経由します。異なるのはリクエストの背後にあるAnthropicアカウントであり、OpenRouterの顧客間で共有されているアカウントか、あるいは私たち自身のアカウントかという点です。最も妥当な説明は、OpenRouterのアカウントを使用したリクエストは、私たちのアカウントを使用したリクエストよりも低い優先度(キャパシティ)で処理されており、その度合いが需要に応じて変動しているというものです。これであれば、2回の測定間でペナルティの差が縮まった理由も説明がつきます。ただし、これは推論に過ぎません。OpenRouterもAnthropicも、アカウントの階層化(ティア)の仕組みを公開していないためです。
OpenAIではパターンが逆転しました。GPT-4o miniの場合、両方で実行した3回のセッションすべてにおいて、クレジットを使用した方が独自のキーよりも23〜50ミリ秒早く最初のトークンに到達しました。また、ストリーミング速度を比較したセッションでは、どちらも同じ速度で生成されました。リクエストを処理するアカウントは速度に影響を与えますが、どちらのアカウントが高速かはプロバイダーによって異なります。外部から自分がどのティアにいるかを確認することはできません。測定によって判断するしかないのです。
分布の中央値は一般的なリクエストを表しますが、ユーザー向けのサービスではテイル(分布の端)が重要になります。プロンプトが短い2つのセッションにおいて、最初のトークンまでの時間の95パーセンタイルは、直接接続で約700ミリ秒、クレジット使用で950〜985ミリ秒、独自のキー使用で885〜905ミリ秒でした。99パーセンタイルはOpenRouterのどちらの経路でも大幅に悪化し、直接接続の約750〜765ミリ秒から、クレジット使用では1.2〜2.6秒にまで広がりました。ただし、1セッションあたり100リクエストという条件では、99パーセンタイルは実質的に2番目に遅いリクエストを指すため、統計的な数値というよりは、テイルが重くなっている兆候として捉えるべきです。
ストリーミングを行わない場合も同様の結果となりました。直接接続と比較して、クレジット使用では完全なレスポンスまでに548ミリ秒および629ミリ秒の遅延が加わり、独自のキー使用では42ミリ秒および56ミリ秒の遅延が加わりました。
これらの結果は、Anthropicの独自エンドポイントにおけるClaude Haiku 4.5という1つのモデルを対象としたものです。SonnetやOpus、OpenRouter経由のBedrockやVertex上のClaude、他のOpenRouterエッジ、あるいは時間帯による違いについては検証していません。プロンプトが短い実行結果は、公開しているハーネスから再現可能です。プロンプトをパディングした実行は別のセッションで行いました。共有キャパシティの仮説を直接検証する「Anthropicクレジットに対する同時実行数のスイープ」や、前述の /api/v1/messages との比較は行っていません。また、すべて単一のクライアントから実行したため、経路間の差分については示せますが、貴社のインフラストラクチャからの絶対的なレイテンシについては何も言及できません。
X-OpenRouter-Experimental-Metadata: enabled を送信し、レスポンス内の openrouter_metadata を読み取ってください。これにより、処理を行ったエンドポイントと、独自のキーが使用されたかどうかがわかります。これを確認しない場合、設定をそのまま信頼するしかありません。OpenRouter経由でClaudeが遅く感じられるもう一つの一般的な理由はレート制限です。当社の以下の記事では、 OpenRouterのレート制限 応答の遅延とスロットリング(帯域制限)を見分ける方法を解説しています。
TrueFoundry AI Gatewayは、お客様自身のVPCまたはデータセンター内で実行され、独自のキーと契約を使用してAnthropicを直接呼び出します。そのため、リクエストが他の顧客とアップストリームアカウントを共有することはなく、ネットワークとプロバイダーの間にサードパーティが介在することもありません。公開されている数値では、ゲートウェイのオーバーヘッドは約3〜4ミリ秒で、1つのvCPUで毎秒350件以上のリクエスト(RPS)を処理可能です。
この3〜4ミリ秒という数値はTrueFoundryが公開しているベンチマークです。本記事の検証環境で測定したものではありません。ゲートウェイを比較したい場合は、前述のペアリング手法を用いることをお勧めします。これは、当社を含むあらゆるOpenAI互換エンドポイントに対して有効です。
AnthropicにおけるOpenRouterのレイテンシは2つの要素で構成されています。1つ目はプロンプトサイズに応じて増加する約100〜300ミリ秒のファーストトークンコストで、これはどの利用アカウントでも発生します。2つ目はOpenRouterクレジットを使用した場合の生成速度の低下で、ある実行時には一般的な回答に対して0.5秒以上の遅延が加わり、別の実行時にはそれより短い遅延となりました。テストでは、独自のキーを持ち込むことでこの生成速度の低下は解消されましたが、ファーストトークンコストは残りました。プロンプトに対する追加の待ち時間がどれほどの影響を与えるかを知る唯一の方法は、今回行ったようにペアリングして測定することです。
独自のキーを使用して、共有のアップストリームアカウントを介さず、自社ネットワークから直接Anthropicを呼び出すには、 TrueFoundry AI GatewayがどのようにAnthropicへ直接接続するかをご覧くださいを追加します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




It depends on the provider. In our paired testing, the added time to first token on GPT-4o mini was too small to measure, while Claude Haiku 4.5 on OpenRouter credits added about 206 ms, or about 124 ms with our own Anthropic key. OpenRouter itself no longer publishes an overhead figure.
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheus、またはお好みのスタックに接続できます。プロンプトからツール、モデルの実行まで、すべてのリクエストを追跡するため、既存のシステムを大幅に変更することなく、統合されたロギングを実現できます。
On Anthropic it did in our tests: our own key added about 120 ms to the first token against about 200 ms on credits, and then streamed at direct speed. On OpenAI, credits was slightly faster. Which route is faster depends on the provider and the account behind it.
はい。ゲートウェイはOpenTelemetryに準拠しており、外部のバックエンドにトレースをエクスポートします。これにより、ゲートウェイのデータがBraintrust、Langfuse、Arizeなどのプラットフォームに届きます。TrueFoundry自体はオフラインのスコアリングジョブを実行しません。



















