


August 26, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
大規模言語モデル(LLM)は現代のAIアプリケーションの根幹となり、チャットボットやバーチャルアシスタントからリサーチツール、エンタープライズソリューションに至るまで、あらゆるものを動かしています。しかし、すべてのLLMが同じように作られているわけではありません。それぞれに固有の強み、限界、コスト要因が存在します。推論に長けたモデルもあれば、クリエイティブライティング、コーディング、構造化されたクエリの処理を得意とするモデルもあります。ここで登場するのがLLM Routerです。
LLM Routerはインテリジェントな交通整理役のように機能し、手元のタスクに基づいてユーザーのプロンプトを最も適したモデルへ自動的に割り振ります。単一のモデルに依存するのではなく、企業や開発者はリアルタイムで適切なLLMにクエリをルーティングすることで、パフォーマンス、精度、コストを最適化できます。AIの導入が進む中、LLMルーティングは拡張性、信頼性、効率性に優れたAIシステムを構築するための不可欠なレイヤーとなりつつあります。
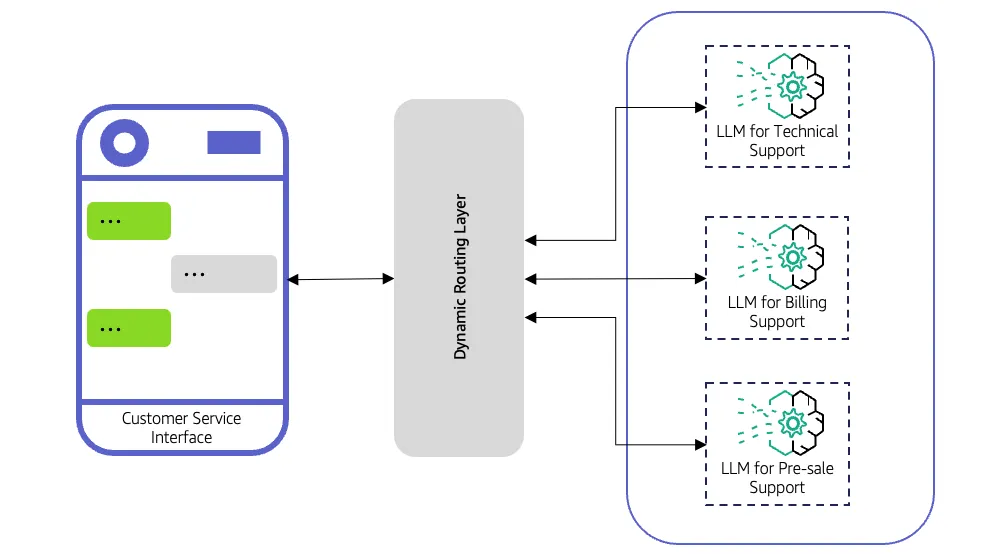
LLM Routerは、各リクエストをどの大規模言語モデルが処理すべきかを決定します。すべてのクエリを1つのモデルに送信する代わりに、入力を評価し、ルーティングロジックを適用して、最も適したモデルへ転送します。
ルーターは、コード関連のクエリをプログラミング特化型モデルに転送するような単純なルールに従うこともできれば、分類器、埋め込み、軽量な予測モデルなどの高度な戦略を使用して、どのLLMが最高のレスポンスを提供できるかを判断することもできます。
動作の仕組み
このアプローチにより、「万能型(ワンサイズ・フィット・オール)」の問題が解消されます。日常的なクエリは軽量モデルが効率的に処理し、複雑なタスクや推論の重いタスクはより高性能なLLMに引き渡されます。
実践的には、ルーターはアプリケーションと複数のLLMの間に位置し、パフォーマンスの最適化、コストの削減、特定のプロバイダーへの依存度の最小化を実現します。この構成により、すべてのリクエストが適切なモデルに確実に届き、AIシステムの信頼性と柔軟性が保たれます。

AI governance technologies operationalize an organization’s AI policies by providing oversight, risk management, compliance, observability and security across the AI life cycle. This Hype Cycle identifies the technologies that will help organizations implement AI governance responsibly and drive adoption at scale.
企業は、チャットボットやバーチャルアシスタントからコンテンツ作成、データ分析に至るまで、さまざまなタスクで大規模言語モデルへの依存度を高めています。
しかし、すべてのタスクに単一のLLMを使用すると課題が生じます。迅速に回答するものの深みに欠けるモデルもあれば、高いレイテンシとコストで正確な結果を提供するモデルもあります。これらの違いを管理する方法がない場合、チームは常にパフォーマンス、精度、予算のトレードオフを余儀なくされます。
LLM Routerは、タスクに最も適したモデルへリクエストをインテリジェントに振り分けることで、この問題を解決します。
以下のシナリオを考えてみましょう。
カスタマーサポートシステムが2種類のクエリを受信したとします。
「営業時間について教えてください」のような単純なリクエストに極めて高度なモデルは不要ですが、製品のトラブルシューティングに関する複雑な技術的質問には高度なモデルが必要です。LLM Routerがない場合、すべてのクエリが高性能で高価なモデルに送信され、コストが増大し応答時間が低下する可能性があります。ルーターがあれば、単純なクエリは高速で軽量なモデルへ送信され、複雑なクエリはより能力の高いLLMへルーティングされるため、速度、コスト、精度が最適化されます。
企業にとってのメリット
クエリをインテリジェントにルーティングすることで、企業はより高速で正確かつコスト効率の高いAIサービスを提供できます。LLM Routerは、AI運用を画一的なアプローチから柔軟で信頼性が高く効率的なシステムへと変革するため、現代のAIインフラにとって不可欠な存在となっています。
LLM Routerは単なる交通整理役にとどまらず、AIシステムをよりスマートに、より速く、より信頼性の高いものにするコア機能を提供します。これらの機能を理解することで、組織は品質を維持しながら効率的に拡張可能なAIワークフローを設計できるようになります。
ルーティングが行われる前に、ルーターは受信したクエリを分析します。メタデータ、タグ、クエリタイプ、複雑さ、さらには意図や感情まで検査します。この分析によって文脈(コンテキスト)が提供され、ルーターはどのモデルがリクエストの処理に最も適しているかを判断できるようになります。例えば、請求に関する顧客からの質問は軽量な汎用LLMにルーティングし、技術的なトラブルシューティングのクエリは特定ドメイン向けのモデルに送信します。
ルーターは、以下のような複数の基準に基づいて最も適切なモデルを選択します。
これらの要因を考慮することで、ルーターは各リクエストが速度、精度、コストの最良のバランスを得られるようにします。
複数のモデルが同じタスクを処理できる場合、ルーターは特定のモデルに過負荷がかからないよう、リクエストをインテリジェントに分散させます。これにより、システム全体の応答性が向上し、ピーク時の安定したパフォーマンスが保証されます。
優れたモデルであっても、失敗したり、タイムアウトしたり、信頼度の低い応答を返したりすることがあります。ルーターはフォールバックメカニズムを実装し、自動的にバックアップモデルへクエリを再ルーティングします。これにより、ユーザーを妨げることなく継続性と信頼性が確保されます。
高度なルーターは、使用パターン、モデルのパフォーマンス、クエリ結果を追跡します。これらのインサイトは、チームがルーティング戦略を最適化し、より優れたモデルを選択し、時間をかけてコストを削減するのに役立ちます。
LLM Routerは、マルチモデルAIシステムにおける意思決定のハブとして機能します。リクエストを分析し、最適なモデルを選択し、負荷を分散し、障害を処理し、インサイトを提供することで、すべてのクエリが効率的、正確、かつ確実に処理されるようにします。この機能の組み合わせにより、LLM Routerは堅牢でスケーラブルかつコスト効率の高いAIソリューションを構築するための重要なコンポーネントとなっています。
LLM RouterとAI Gatewayは、どちらもAIアプリケーションと言語モデルの間に位置するため、一緒に議論されることがよくあります。しかし、これらは異なる問題を解決し、AIスタックの異なるレイヤーで動作します。
LLM Routerは、コスト、レイテンシ、パフォーマンス、利用可能性、タスクの要件などの要因に基づいて、最も適切な言語モデルを選択してリクエストをダイレクトすることに特化しています。その主な目的は、モデルの利用を最適化し、アプリケーションのパフォーマンスを向上させることです。
AI Gatewayは、AIトラフィックに対してより広範なコントロールプレーンを提供します。モデルルーティングに加えて、AI Gatewayは認証、認可、レート制限、オブザーバビリティ、ガバナンス、コスト追跡、セキュリティ管理などの機能を提供します。企業が複数のモデル、チーム、環境にわたってAIワークロードを管理し、セキュリティを保護するのに役立ちます。
LLMルーターは、クエリを最も適した言語モデルへ効率的に送るために、さまざまな戦略を使用します。これらの戦略は一般的に、静的(スタティック)、動的(ダイナミック)、ハイブリッドの3つのカテゴリに分けられ、高度なシステムでは強化学習が組み込まれることもあります。
静的ルーティングは、定義済みのルールに依存して、どのモデルがクエリを処理するかを決定します。一貫したルーティング動作を保証し、実装が容易です。
動的ルーティングはリアルタイムに適応し、現在のシステムパフォーマンスとクエリの文脈に基づいてモデルを選択します。
ハイブリッド戦略は、静的アプローチと動的アプローチを組み合わせて、柔軟性と効率性を高めます。
一部の高度なシステムでは、強化学習を使用してルーティングの決定を継続的に改善します。これらのルーターは、過去のクエリとモデルのパフォーマンスから学習し、複雑または進化するワークロードに対して時間の経過とともにルーティングを最適化します。
LLM Routerは、AIシステムをより効率的、信頼的、コスト効果的にするための主要なメリットを提供します。最大のメリットの1つは、パフォーマンスの最適化です。
各クエリをタスクに最も適したモデルへインテリジェントにルーティングすることで、ルーターは高度で推論能力のあるモデルが複雑な質問を処理し、軽量で高速なモデルがシンプルなリクエストを処理できるようにします。このアプローチは速度と精度のバランスを取り、全体のユーザー体験を向上させます。
もう1つの大きなメリットはコスト効率です。ルーターがない場合、企業はすべてのクエリを高スペックなモデルで実行し、無駄に運用コストを膨らませてしまう可能性があります。ルーターは、高価なモデルを高価値または複雑なクエリ用に確保し、日常的または反復的なタスクはリソース消費の少ないモデルで処理するようにして、計算費用を削減しROIを最大化します。
また、LLM Routerによって信頼性も向上します。高度なルーターには、モデルが失敗したり、タイムアウトしたり、信頼度の低い結果を返したりした場合に、自動的にクエリを再ルーティングするフォールバックメカニズムが含まれています。これにより、カスタマーサポートやバーチャルアシスタントなどのリアルタイムアプリケーションにおいて、中断を防ぎ、一貫した頼れるパフォーマンスが維持されます。
さらに、LLM Routerは柔軟性を提供します。組織は異なるプロバイダーの複数のモデルを統合し、タスクごとに最適なモデルを選択できます。
これにより単一のベンダーへの依存が軽減され、新しい機能が登場した際にチームが多様なモデルを試しやすくなります。
最後に、ルーターはスケーラビリティをサポートします。クエリ量が増加すると、ルーターは複数のモデルにリクエストをインテリジェントに分散させ、過負荷を防ぎスムーズなシステムパフォーマンスを維持します。
最適化されたルーティング、コスト削減、信頼性、柔軟性、拡張性を組み合わせることで、LLM RouterはAI運用を硬直した単一モデルのアプローチから、動的で効率的かつ弾力性のあるシステムへと変革します。
LLM Routerは、AIのパフォーマンス、信頼性、効率性を最適化するために企業全体で採用が増加しています。複雑さ、ドメイン、コンテキストに基づいて適切なモデルが各タスクを処理するように、インテリジェントなクエリルーティングを可能にします。
カスタマーサポートの自動化
企業は毎日、単純なFAQから複雑な技術的問題まで、何千もの顧客からの問い合わせを処理しています。LLM Routerは、日常的な質問を高速で軽量なモデルに転送する一方で、複雑な問題をより高機能なモデルへルーティングします。これにより、高速で正確かつ一貫した応答が保証され、顧客満足度が向上するとともに運用の負担が軽減されます。
ナレッジマネジメントとエンタープライズ検索
企業は社内文書、マニュアル、ポリシーの広範なリポジトリを維持しています。ルーターはクエリを分析し、推論、要約、または特定のドメイン知識に最適化されたモデルにルーティングします。従業員は、高コストなモデルに過剰な負荷をかけることなく、正確でコンテキストに関連した情報を受け取ることができます。
ワークフローとタスクの自動化
LLMは、レポート作成、データ分析、意志決定支援タスクに広く使用されています。ルーターは、高複雑度のクエリを強力なモデルに、日常的なタスクを軽量なモデルに動的に割り当て、エンタープライズワークフロー全体で速度、精度、計算コストのバランスを取ります。
マルチモデルのオーケストレーション
組織は多くの場合、複数のプロバイダーやドメインにわたって複数のLLMをデプロイします。ルーターはモデルの選択、負荷分散、フォールバックメカニズムを管理し、大規模AIシステムにおける信頼性、柔軟性、スケーラビリティを確保します。
製品レコメンデーションとパーソナライズ
EコマースやSaaSプラットフォームの場合、LLM Routerはユーザー行動と文脈に基づいてトレーニングされたモデルにパーソナライズタスクを割り当て、一般的なレコメンデーションはよりシンプルなモデルに委任できます。これにより、コストを制御しながらレコメンデーションの精度とパフォーマンスが向上します。
コンプライアンスとリスク分析
金融、法務、ヘルスケア企業では、クエリに対して規制や業界固有のガイドラインの厳格な遵守が求められる場合があります。ルーターは、機密性の高いクエリやハイリスクなクエリをドメインの専門知識を持つモデルに振り分け、一般的なタスクは標準モデルで処理させつつコンプライアンスを確保できます。
コンテンツ生成と要約
マーケティング、ナレッジシェアリング、ドキュメント作成において、LLM Routerは複雑なコンテンツ作成タスクを高品質なモデルに割り振り、単純な要約や下書き作成タスクをより高速なモデルに割り振ることで、出力品質を損なうことなく効率を最適化できます。
これらの多様なシナリオ全体にLLM Routerを適用することで、企業はAIをインテリジェントに拡張し、複数のワークフローやアプリケーションにわたってパフォーマンス、信頼性、コスト効率を維持できます。
LLM Routerがどのように幅広いエンタープライズアプリケーションを強力に支えているかを確認したところで、マルチモデルAIシステムにおけるもう1つの主要コンポーネントとの違いを理解しておくことが重要です。
LLM Routerは、インテリジェントなリクエストルーティングに重点を置いています。その主な機能は、受信したクエリを分析し、コンテキスト、複雑さ、メタデータを評価した上で、最も適したモデルへ各リクエストを誘導することです。ルーターには動的ルーティング、コンテキスト対応の意思決定、フォールバックメカニズムなどの高度な戦略が組み込まれていることが多く、精度、速度、コストを最適化します。
これらは、クエリのタイプ、ドメイン、または計算要件が大きく異なる環境で特に重要であり、企業が負荷のバランスを取り、高いパフォーマンスを維持できるようにします。
一方、LLM Gatewayは、1つまたは複数のLLMと対話するための集中型アクセスポイントとして機能します。その主な役割は、統合の簡素化、標準化されたAPIの提供、認証の管理、レート制限の処理、使用状況のモニタリングです。
ルーターとは異なり、ゲートウェイは通常、インテリジェントなモデル選択の決定を行いません。マルチモデルデプロイを容易にするための均一なアクセスと運用の管理機能を提供します。ゲートウェイは、クエリレベルの最適化よりも、インフラストラクチャレベルの管理、セキュリティ、スケーラビリティにより焦点を当てています。
主な違い
ルーターとゲートウェイは、層状(レイヤード)アーキテクチャにおいて連携して動作することがよくあります。ゲートウェイはアプリケーションに対して安全で標準化されたエントリーポイントを提供し、その背後に配置されたルーターがインテリジェントなモデル選択の決定を行います。この組み合わせにより、企業は運用管理と最適なクエリ処理の両方を実現できます。
LLM RouterとLLM Gatewayの違いを理解することは、組織がマルチモデルAIシステムを効果的にデプロイするのに役立ちます。
ルーターがインテリジェントでコンテキストを考慮したパフォーマンスを推進し、ゲートウェイが安全でスケーラブルかつ信頼性の高いアクセスを確保することで、エンタープライズAIのための堅牢な基盤が創出されます。
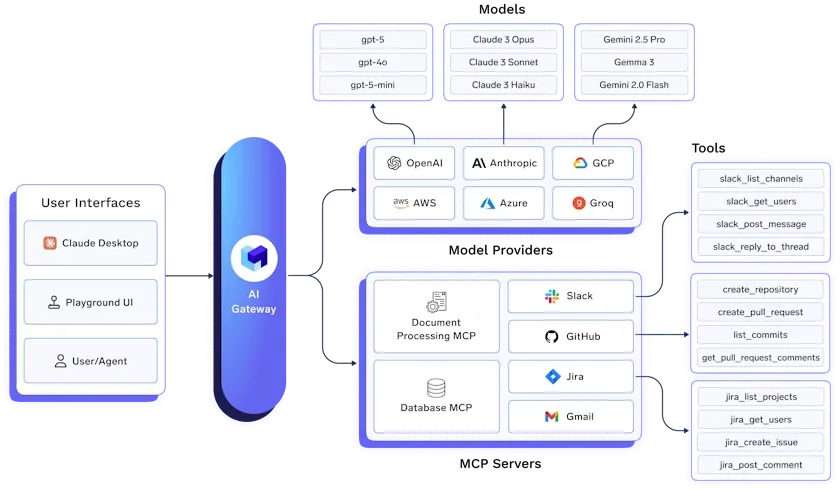
TrueFoundry LLM Gatewayは、単一の安全で高性能なAPIを介して、すべての主要な大規模言語モデル(LLM)へのアクセスを統合するエンタープライズ対応プラットフォームです。
コードの変更を必要とせずに、OpenAI、Anthropic Claude、Gemini、Groq、Mistral、およびオープンソースフレームワークを含む250以上のモデルを統合することで、GenAIインフラストラクチャを簡素化します。チームは、認証とAPIキー管理を中央集約化しながら、チャット、補完、埋め込み、リランキングのワークロードに対して1つの一貫したAPIを使用できます。
主な特徴:
企業が複数の Large Language Model への依存を強める中、LLM Router や LLM Gateway といったツールは、大規模な AI 管理において不可欠なものとなっています。LLM Router はシステムにインテリジェンスをもたらし、各クエリを分析して、タスクに最も適したモデルに確実に届くようにします。これにより、特に複雑で高トラフィックなワークフローにおいて、パフォーマンスの向上、コストの削減、信頼性の強化が実現します。
一方、Gateway は、モデルへの安全で標準化されたアクセスを実現するバックボーンを提供し、統合の簡素化、使用状況のモニタリング、および運用コントロールの適用を担います。
これらのコンポーネントが合わさることで、インテリジェンスと運用効率のバランスをとった層状の AI アーキテクチャが構築されます。Router の意志決定能力と Gateway の構造的信頼性を組み合わせることで、組織は拡張性と制御性を維持しながら、複数の LLM の価値を最大化できます。
LLM Router の導入はもはやオプションではなく、高速で正確、かつコスト効率の高い AI サービスを提供しようとする企業にとって必要不可欠です。Gateway とともにその役割を理解することで、チームは多種多様なビジネスニーズを満たす堅牢な AI インフラを設計できるようになります。
AI モデルが進化し増加し続ける中、インテリジェントなルーティングと構造化されたアクセスのマスターは、急速に進展する AI 環境において企業が競合優位性を維持するために極めて重要です。
LLM ルーティングは、受信したリクエストを定義済みのロジック、セマンティック埋め込み(semantic embeddings)、または分類ルールに照らし合わせて評価することで機能します。システムは、コンテキスト、要求される精度、またはアップストリームプロバイダーのレイテンシに基づいてトラフィックをルーティングします。中央集権型の Gateway がこれらの複雑な設定を管理し、モデルの更新ごとに手動でコードを変更することなく、モデル選択とフェイルオーバーを自動化します。
LLM ルーティングの分類(classification)は、推論の実行前に非常に効率的なモデルを使用してプロンプトをカテゴリ分けします。このステップにより、簡単な挨拶と複雑なコーディングタスクなど、意図(intent)を特定します。自動分類により、負荷の低いクエリをより小さく、高速で、コスト効率の高い代替モデルへフィルタリングし、高価なフロンティアモデルの過剰使用を防ぎます。
TrueFoundry は、トラフィックオーケストレーションとガバナンスおよびセキュリティを統合することで、LLM ルーティングと AI Gateway の機能を一元化しています。このプラットフォームは、単一の中央制御プレーン内でモデルのフェイルオーバー、レート制限、コストを考慮したルーティングを処理します。このインフラストラクチャにより、大規模な本番環境において、企業の AI デプロイメントが高いレジリエンスとコスト効率を維持できるようになります。
優れた LLM Router には、エンタープライズグレードのオーケストレーションを実現する TrueFoundry、統合プロキシ API である LiteLLM、モデル選択を自動化する Martian などがあります。その他の業界のトップオプションとしては、高度なガードレールを提供する Portkey、非常に高速なオブザーバビリティを提供する Helicone、数百のオープンソースおよび商用モデルへ簡単にアクセスできる OpenRouter などが挙げられます。
LLM Router は、クエリのメタデータ、タイプ、コンテキストを検証してモデルを選択します。選択要素には、ドメインに関する専門知識、推論能力、レイテンシ、コストが含まれます。単純なクエリは軽量なモデルへ、複雑なタスクは高機能なモデルへ送信されます。高度な Router は、リアルタイムでインテリジェントなモデルルーティングを行うために、埋め込み(embeddings)や予測分類器を使用することがあります。
LLM Router のコア機能には、リクエスト分析、インテリジェントなモデル選択、ロードバランシング、フォールバック処理、モニタリングが含まれます。Router は複数の LLM にわたってクエリを分散し、失敗したリクエストを再ルーティングし、パフォーマンスを追跡します。これにより、タスクが効率的に処理され、モデルが最適に活用され、エンタープライズ AI ワークフローにおけるシステムの信頼性と拡張性が維持されます。
一般的な LLM Router の種類には、ルールベースのルーティング、コストベースのルーティング、パフォーマンスベースのルーティング、タスクベースのルーティングがあります。ルールベースの Router は事前定義された条件に従い、コストベースの Router はより安価なモデルを選択し、パフォーマンスベースの Router は精度やスピードに優れたモデルを選択し、タスクベースの Router はコーディング、チャット、要約などのタスクに特化したモデルにリクエストを送信します。
LLM ルーティングは、ユーザーのリクエストを分析し、最も適したモデルに送信することによって行われます。開発者は、タスクのタイプ、コスト、レイテンシ、モデルの能力などの要因を考慮したルールを定義するか、アルゴリズムを使用します。ルーティング層が入力を評価し、適切な LLM へクエリを自動的に送信します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




























