11月 21, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
当社のテストハーネスでは、OpenRouterのプロンプトキャッシュがAnthropicモデルで機能していると表示されました。しかし数日後の当社の記事では、機能していなかったと記載されました。実は、両方とも間違いでした。
このテストでは、Claude Haiku 4.5に対して、OpenRouterのドキュメントで指定された通りの場所にcache_controlを付与した長文の参照テキストを送信しました。ハーネスはレスポンス内にキャッシュフィールドを確認したため、機能していると判定しました。後で数値を確認したところ、cache_write_tokensがゼロだったため、無効化されたと結論付けました。しかし、答えは最初からドキュメントに記載されていました。Haiku 4.5は4,096トークン未満のプロンプトをキャッシュせず、当社のプロンプトは約3,600トークンだったのです。
OpenRouterにおけるプロンプトキャッシュの問題のほとんどは、同様の形で現れます。リクエストは成功し、機能もオンになっています。しかしレスポンスを見ただけでは、キャッシュが行われなかったのか、あるいはキャッシュが行われたものの節約額以上のコストがかかったのかが明確にわかりません。
OpenRouterは、ほぼ共通点のない2つの機能に対して同じ言葉を使用しています。
プロバイダーのプロンプトキャッシュはプロバイダー側に属します。プロンプトの処理済みプレフィックスを保存することで、同じプレフィックスを持つ次のリクエストで再読み込みをスキップし、それらのトークンを割引価格で請求します。モデルは引き続き実行され、新しい回答を生成します。一方、レスポンスキャッシュはOpenRouter側に属します。レスポンス全体を保存し、同一のリクエストに対してそれを返却するため、モデルは一切実行されません。
以下の価格、下限、TTLは、プロバイダーのプロンプトキャッシュに関するものです。完全一致とセマンティックレスポンスキャッシュのどちらを選択すべきかについては、似た質問で回答を共有すべきタイミングに関するガイドで解説しています。OpenRouterのレスポンスキャッシュについては、本記事の終盤に専用のセクションを設けています。
OpenRouterは、トークンごとのマークアップなしで各プロバイダーのキャッシュ価格をそのまま通過させます。手数料はクレジット購入時に発生し、これについてはOpenRouterの価格内訳で解説しています。以下の倍率は、モデルの通常入力価格に対する相対値です。
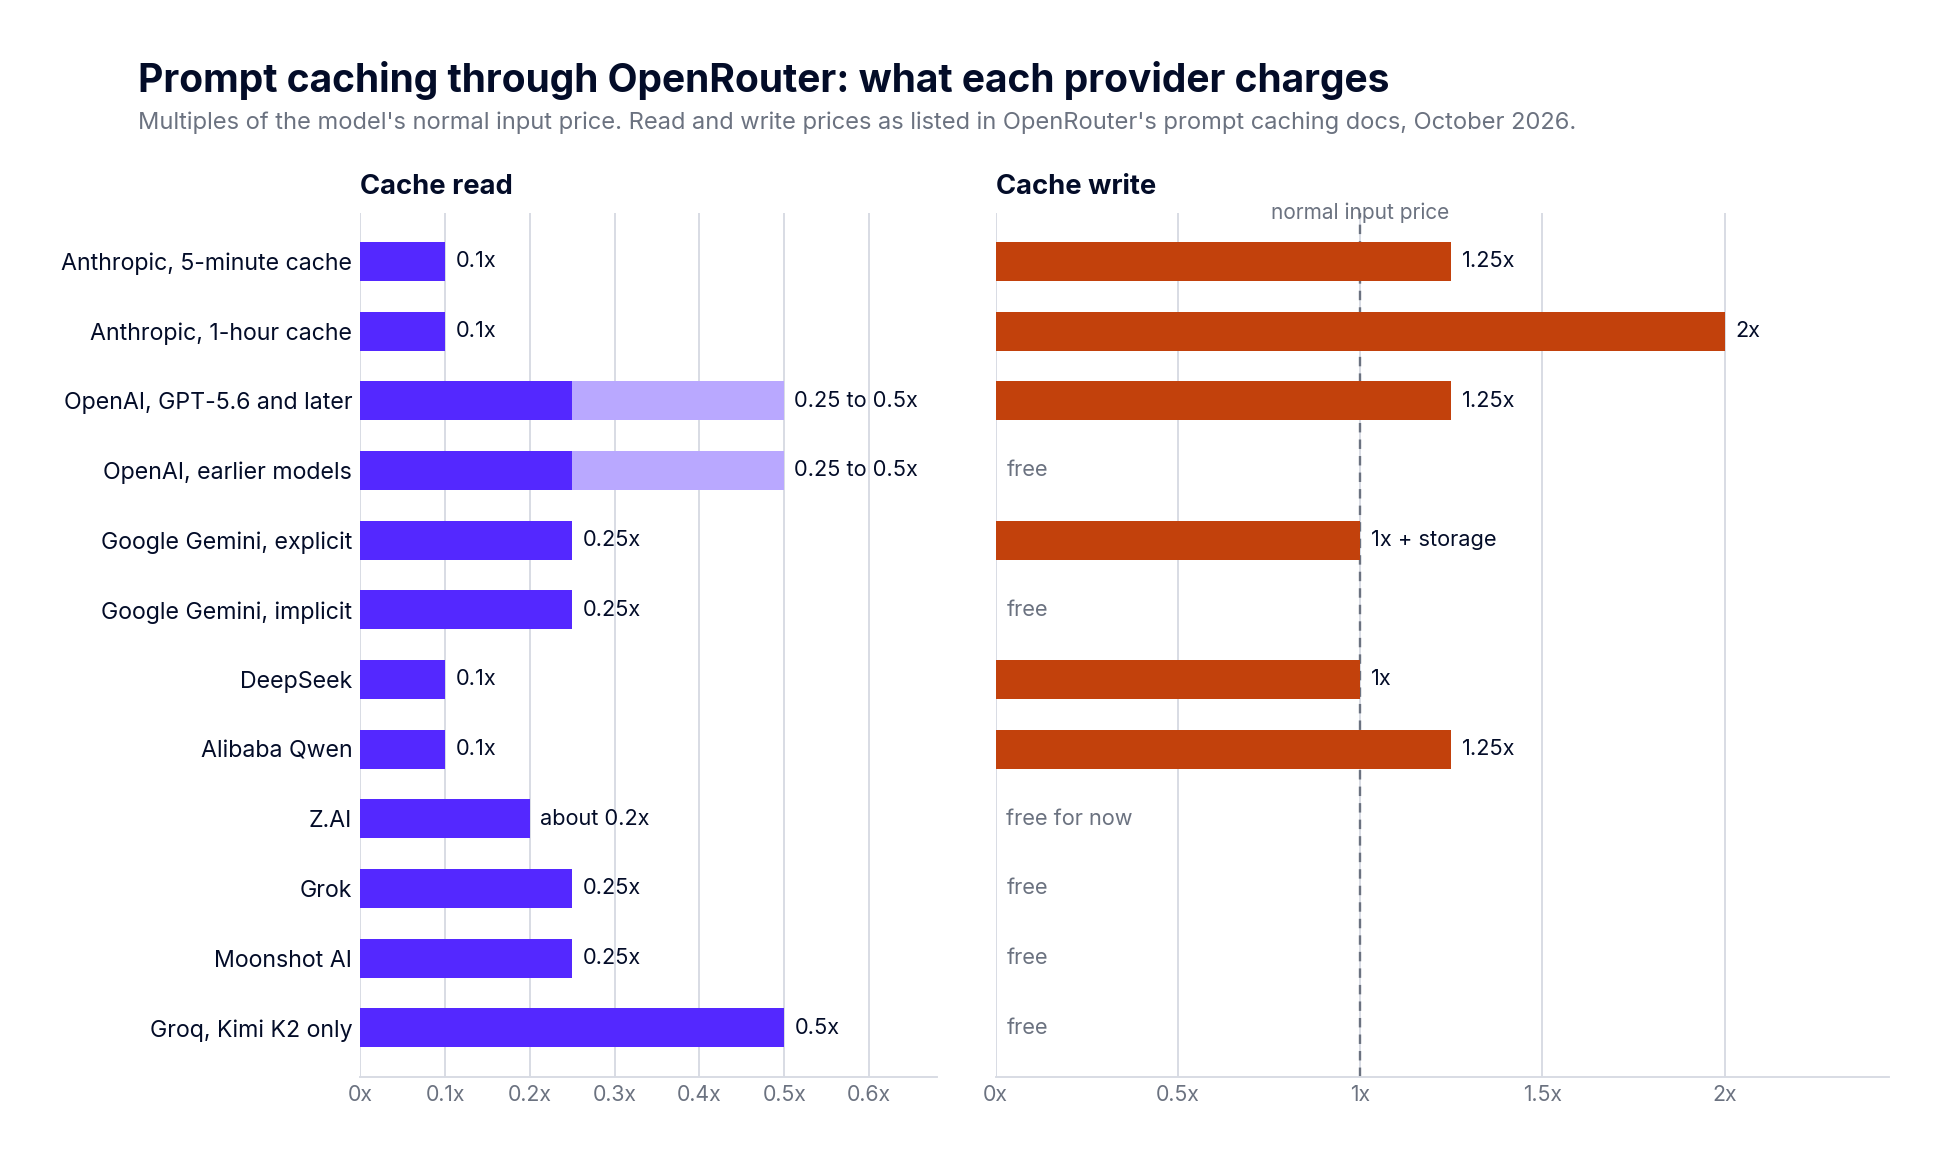
読み込みは入力価格の10分の1から半分、書き込みは無料から2倍まで幅があります。9つのプロバイダーのうち5つは、OpenRouterのドキュメントに最小プロンプト長の記載がありません。また、モデルフォールバックやAuto Routerを使用している場合、1回のリクエストがコールドキャッシュの状態で前回とは異なる行(プロバイダー)に着信することがあります。
キャッシュによってコストを削減できるかどうかは、キャッシュが有効な間に同じプレフィックスが何回送信されるかによって決まります。上記の倍率を使用し、プロンプトのキャッシュされた部分のみをカウントすると、以下のようになります。
リクエストの残りの部分(ユーザーの質問や最後のキャッシュブロック以降の内容)はどちらの方法でも同じ金額が請求されるため、これらの比率はプレフィックスのみに適用されます。
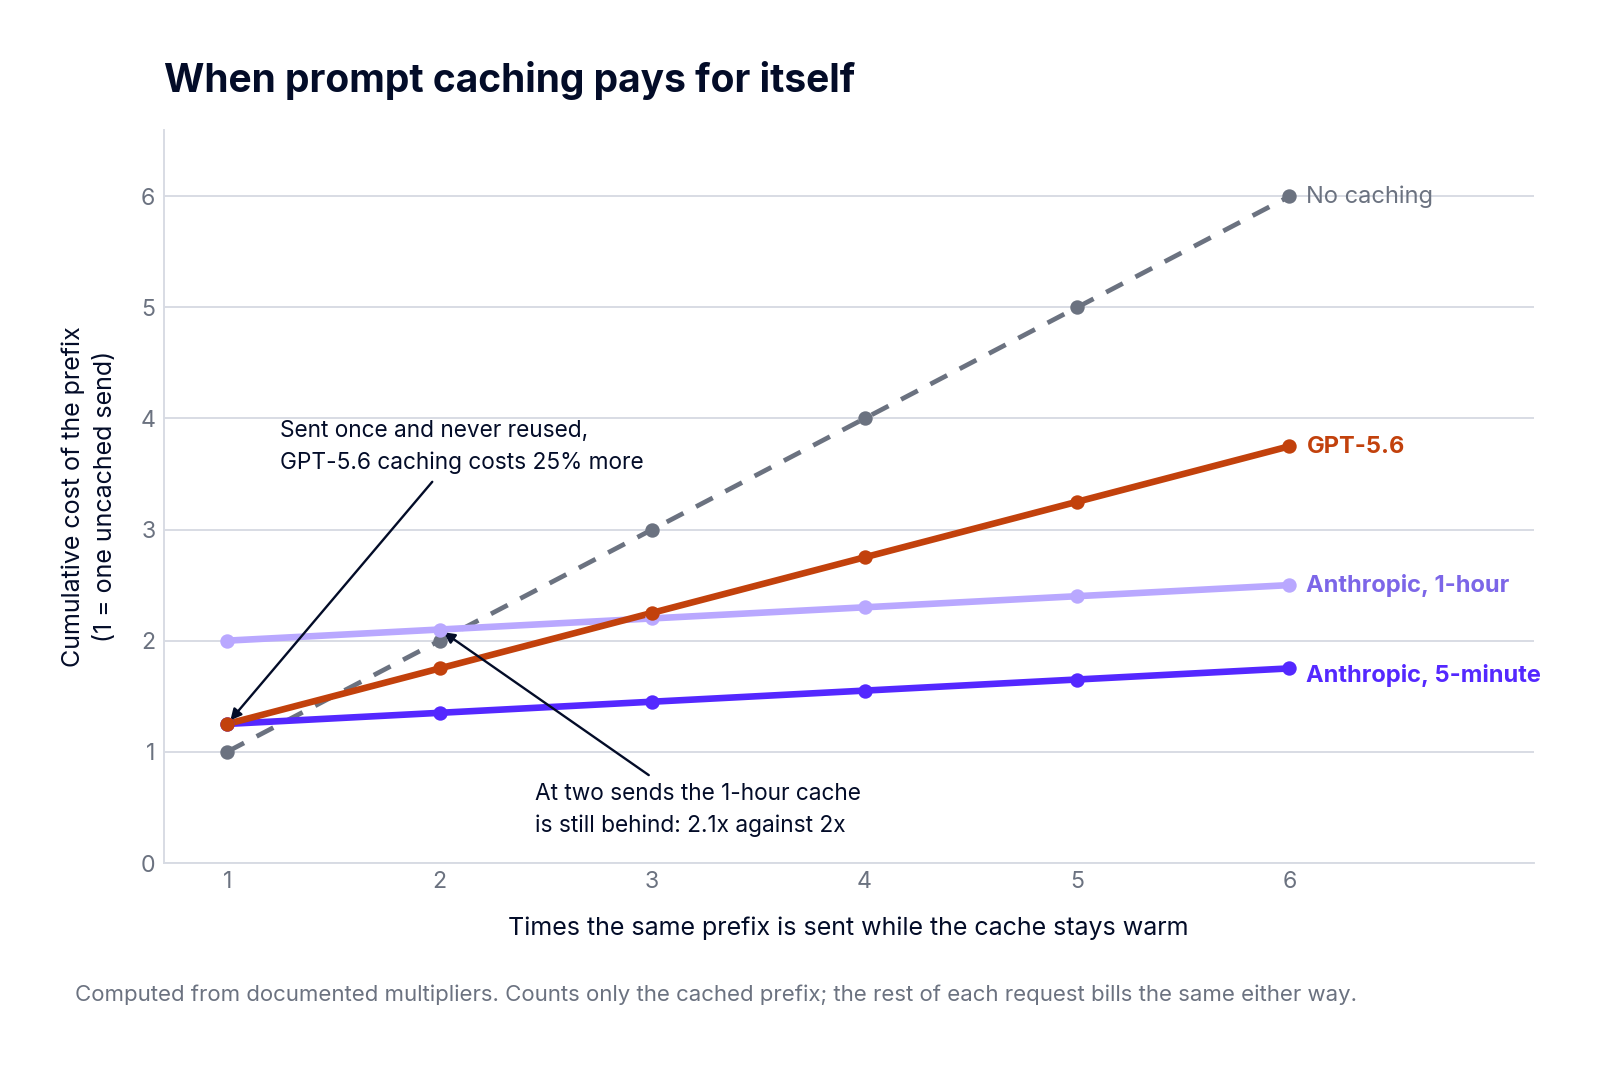
表の大半のプロバイダーにおいて、キャッシュ書き込みは無料またはそれに近い価格設定となっているため、キャッシュは実質リスクのないオプションです。しかし、OpenAIのGPT-5.6で状況が変わりました。このファミリー以降、自動キャッシュであってもキャッシュ書き込みには入力価格の1.25倍が請求され、自動キャッシュは要求の有無にかかわらずオンになります。1回しか送信しない1,024トークン以上のプロンプトでも書き込み費用が発生し、読み込みによる割引を回収することができません。
例として、1回だけ送信される2,000トークンのプロンプトを考えてみます。キャッシュなしの場合、2,000トークンの入力として請求されます。キャッシュがオンの場合、2,500トークンのプロンプトとほぼ同等の費用が発生します。ドキュメントが先頭にあり冒頭部分が一切重複しない、100万件の長文でユニークなドキュメントを要約する夜間ジョブなどの場合、入力の大半に対して25%の追加料金が発生することになります。
この修正策は逆の手順を踏みます。prompt_cache_options.modeを"explicit"に設定し、コンテンツブロックにprompt_cache_breakpointを付与しないようにします。明示的モードによりOpenAIの自動ブレークポイントがオフになり、明示的なものが指定されていない場合はキャッシュ可能なプレフィックスが存在しないため、何も書き込まれません。cache_write_tokensはゼロとして返されます。本記事において、ゼロが望ましい意味を持つ唯一のケースです。
次に、コスト削減につながるケースを見てみましょう。5,000トークンのシステムプロンプトを使用し、1日の勤務時間中に100件のリクエストが5件ずつのバースト20回(各バーストの間隔は約20分)で届くClaude Sonnet 4.6のケースです。システムプロンプトのみをカウントし、通常の入力価格で請求されるトークン数に換算すると以下のようになります。
5分間キャッシュでは3分の2が削減されます。1時間キャッシュでは88%が削減されます。これは、20分の間隔によって短いキャッシュは毎回無効化され、長いキャッシュには届かないためです。Anthropicは読み込まれるたびにキャッシュの有効期限を更新するため、1時間の制限時間は終日維持されます。
トラフィックパターンが変われば、結果も変わります。もし100件のリクエストが約4分に1回と均等に届く場合、5分間キャッシュも期限切れになることはありません。その場合、1時間オプションを選択すると、短いキャッシュなら6,250で済む書き込みに対して10,000を支払うことになります。TTLはリクエストの送信回数ではなく、リクエスト間の「間隔」に基づいて選択してください。
すべてのプロバイダーは、それを下回るとキャッシュが行われない最小プロンプト長を設定しています。OpenRouterのドキュメントによると、Claudeの場合は以下の通りです。
OpenAIの下限は1,024です。Geminiの下限は2.5 Flashで1,024、2.5 Proで4,096です。下限を下回るとリクエストは成功し、満額の入力価格で請求され、キャッシュフィールドがゼロに設定されて返されます。エラーも警告も発生しません。
ここで見落としがちな2つの注意点があります。
新しいモデルほど下限が高くなります。3,000トークンのシステムプロンプトはSonnet 4.6ではキャッシュされますが、コードを変更せずにOpus 4.7に移行したその日からキャッシュされなくなります。レスポンスにも何も表示されません。Haiku 3.5からHaiku 4.5への移行でも、2,048〜4,096トークンの間で同様の現象が起こります。モデルのアップグレードはキャッシュ設定の変更を意味するため、変更後は必ずキャッシュヒット率を確認してください。
また、キャッシュフィールドの存在だけでキャッシュを検証することはできません。これこそが、当社のテストが失敗した原因です。OpenRouterは、キャッシュがネイティブ対応していないプロバイダーを含め、すべてのプロバイダーからのレスポンスでcached_tokensおよびcache_write_tokensを返します。そのため、これらのフィールドが存在することは何の証明にもなりません。値がゼロであることも決定的な証拠にはなりません。これは、マーカーが無視されたか、プロンプトが下限未満であったことを意味します。3,600トークンのHaiku 4.5のケースでは、下限未満であったことが原因でした。
確実なテスト手順:
cache_write_tokensがゼロより大きくなることを確認します。2回目でcached_tokensがゼロより大きくなることを確認します。cache_discountを確認します。Anthropicの書き込み時には負の値に、読み込み時には正の値になります。OpenRouterはプロバイダー間でのキャッシュマーカーの変換を行いますが、これは便利な機能です。Anthropicスタイルのcache_controlを含むテキストブロックは、GPT-5.6モデルへルーティングされるとprompt_cache_breakpointに変換され、prompt_cache_breakpointはAnthropicまたはGoogle上でデフォルトのcache_controlに変換されます。
ただし、TTLは引き継がれません。cache_controlに指定されたttlは、OpenAIへの処理過程で破棄されます。OpenAIのTTLが指定されるprompt_cache_optionsは、OpenAIにのみ適用されます。prompt_cache_breakpointにはTTLフィールドが存在しないため、Anthropic側でどのような指定に変換されても、デフォルトの5分間が適用されます。
また、有効期限の設定後の挙動も異なります。Anthropicのキャッシュは読み込みごとに更新されます。Geminiの明示的キャッシュは書き込みから5分間で固定され、更新されません。Geminiの暗黙的キャッシュは平均3〜5分(変動あり)とドキュメントに記載されています。そのため、1時間を要求する1つのリクエストボディであっても、送信先によって「1時間」、「固定の5分間」、または「OpenAIが適用する値」のいずれかになります。さらにResponses APIには別の制約があり、ブロック単位のAnthropic cache_controlが露出されません。特定のブロックにTTLが必要な場合は、Chat CompletionsまたはMessagesエンドポイントを使用してください。
キャッシュが効果を発揮するのは、次のリクエストがそのキャッシュを保持しているプロバイダーに到達した場合のみです。OpenRouterはプロバイダースティッキールーティングによってこれを処理します。キャッシュを使用したリクエストの送信後、同じモデルに対する後続のリクエストは同じプロバイダーエンドポイントにルーティングされます。
スティッキー状態は、アカウントごと、モデルごと、および会話ごとに追跡されます。会話は、最初のシステムメッセージと最初の非システムメッセージをハッシュ化することで識別されます。リクエストがない状態が10分間続くと期限切れになります。
エージェント型の処理では、ターンごとに最初のメッセージが変化するため、このデフォルトの挙動が機能しなくなる傾向があります。ボディ内でsession_idを渡すか、x-session-idヘッダーを渡すと、OpenRouterはそれをキャッシュヒットを待つのではなく最初の成功リクエストからスティッキーキーとして使用します。すでに送信している場合は、OpenAIのprompt_cache_keyもフォールバックキーとして機能します。
provider.orderを設定するとスティッキールーティングがオフになり、指定したリストが優先されます。最初の選択肢が正常に機能している間はコストの影響はわずかです。ピン留めによっていずれにせよ単一のプロバイダーに固定されるためです。違いが現れるのはフェイルオーバー後です。スティッキールーティングが応答したプロバイダーに従い続けるのに対し、ピン留めはリストの最初から再スタートします。OpenRouterのレート制限に関する記事で主張したように、予測可能な容量が必要な場合は、ピン留めが依然として適切なアプローチです。Auto Routerにも同様の側面があります。選択されたモデルが以降のターンで候補から外れた場合、キャッシュも一緒に失われます。
これらすべてとは別に、OpenRouterはX-OpenRouter-Cache: trueを送信するとレスポンス全体をキャッシュします。ヒットした場合は、プロバイダーを呼び出すことなく保存されたレスポンスを返却するため、料金は発生せず、プロバイダーのレート制限にもカウントされません。
当社は、GPT-4o miniとClaude Haiku 4.5を対象に、それぞれ100回の同一再リクエストを3回実施して測定を行いました。すべての再リクエストでキャッシュがヒットしました。レイテンシの中央値は、ミス時が2,867 ms、ヒット時が59 msでした。Haikuのヒットは39 msで、GPT-4o miniの64〜69 msよりも高速でした。クレジット課金された実行において、100回のミスは$0.0174の費用がかかりましたが、100回のヒットは無料でした。
エントリは、APIキー、モデル、エンドポイントタイプ、ストリーミングモード、およびリクエストボディ全体をキーとして管理されます。そのため、個別のキーを持つサービス間では何も共有されず、パラメータを変更するとミスになります。一定間隔でサンプリングを行った当社のTTL調査では、エントリは120秒時点では有効で、300秒までに消失していることが確認されました。公開されているTTLやセマンティックマッチング、ドキュメント化されたパージ機能はありません。これは再試行や重複送信を吸収するためのものです。1時間ごとの定期実行ではキャッシュミスになります。
当社のゲートウェイは、2つのモードでレスポンスレイヤーにおけるキャッシュを行います。完全一致モード(Exact-match)は、同一のリクエストに対して保存されたレスポンスを返します。セマンティックモードは、最後のメッセージを埋め込みベクトル化し、過去のリクエストと十分に類似している場合に保存されたレスポンスを返します。また、完全一致のヒットも処理するため、両方のモードを同時に実行するのではなく、いずれか一方を運用します。リクエストヘッダーで有効化され、Redisによってバックアップされ、プロバイダーのプロンプトキャッシュと組み合わせて機能します。ゲートウェイでミスが発生した場合でも、プロバイダー独自のプレフィックスキャッシュがそのまま適用されます。
SaaS版では、埋め込みモデルはtext-embedding-3-small(1,536次元)で固定されており変更できません。オンプレミス版では、ゲートウェイ全体でモデルを選択できます。セマンティックマッチングには、完全一致にはない失敗モードが存在します。当社のセマンティックキャッシュガイドの冒頭でも触れていますが、2人の顧客が数分置きに配送状況について問い合わせた場合、質問がほぼ同じベクトルに埋め込まれると、2人目の顧客に1人目の注文に関する回答が返されてしまう可能性があります。これはスコープのバグです。類似度閾値を変更することで発生頻度は変わりますが、顧客間で共有されているキャッシュを止めることはできません。
キャッシュ検索によるオーバーヘッドは約3〜4 msで、ゲートウェイは単一のvCPUで350以上のRPSを処理します。
session_idを送信し、キャッシュを保持するプロバイダーにルーティングが固定されるようにします。cached_tokensで検証してください。OpenRouterのプロンプトキャッシュは正常に機能し、ドキュメントの記載も周辺の多くの機能より明確です。それでも、9つの価格体系、新しいモデルで上昇する下限値、変換によって変わる有効期間、そしてキャッシュの成否にかかわらず同じように見えるレスポンスなど、留意すべき点が多く存在します。下限を確認し、固定テキストを先頭に配置し、フィールドの有無ではなく数値で結果を検証してください。
プロバイダーごとのプロンプトキャッシュに加え、すべてのプロバイダーに対して一括でセマンティックマッチングを適用する設定については、TrueFoundry AI Gatewayのキャッシュ処理機能をご覧ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




It's OpenRouter passing through each provider's prompt caching, where a repeated prompt prefix is stored and billed at a discount on later requests. Some providers cache automatically, while Anthropic and Alibaba need cache_control markers on the content you want cached. Prices differ by provider, from free writes and 0.1x reads to 2x writes on Anthropic's 1-hour cache.
Yes, as long as the prompt clears the model's minimum length. Claude Haiku 4.5 and Opus 4.5 and later need 4,096 tokens, and Sonnet 4.x needs 1,024. Below that floor the request succeeds at full price with cache fields at zero, which looks exactly like the marker being ignored.
Most likely you're paying for cache writes on prompts that never get reused. GPT-5.6 and later bill writes at 1.25x even under automatic caching, and Anthropic's 1-hour cache bills writes at 2x. If the prefix doesn't repeat while the cache is warm, you pay for the write and never get the discount.
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、多数のプロバイダーにまたがってルーティングする場合でも、プロンプトとレスポンスがお客様のドメインの外に出ることはありません。