


11月 18, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
LLMコールが遅い、コストが高い、または不正確である場合、実際に何が起こったのかを確認する必要があります。ガードレールがプロンプトをマスキング(redact)したのか?ネットワークと比較してモデルの処理時間はどれくらいかかったのか?Gatewayはプロバイダーに何を送信したのか?AI GatewayのRequest LoggingとTracingは、すべてのコールに対してこれらの疑問に答えます。
すべてのリクエストはすでにGatewayを経由して流れているため、各アプリケーションを手動でインストゥルメンテーションすることなく、この可視性を取得できます。
Request Loggingドキュメントを使用すると、ログに記録するリクエストを制御できます。最もシンプルな制御はリクエスト単位であり、JSON値を文字列化したX-TFY-LOGGING-CONFIGヘッダーを使用します。リクエストをログに記録するにはenabledをtrueに設定し、スキップするにはfalseに設定します。
注意すべき重要な点の1つ:ほとんどのSDKはヘッダーを文字列としてシリアル化するため、そのヘッダーの値は生JSONオブジェクトではなく、文字列化されたJSONになります。従来のグローバルログ記録モードは、ルールベースのLogging Configurationに置き換えられており、サブジェクト、モデル、またはメタデータごとにログ記録を制御し、機密データをマスキングできます。
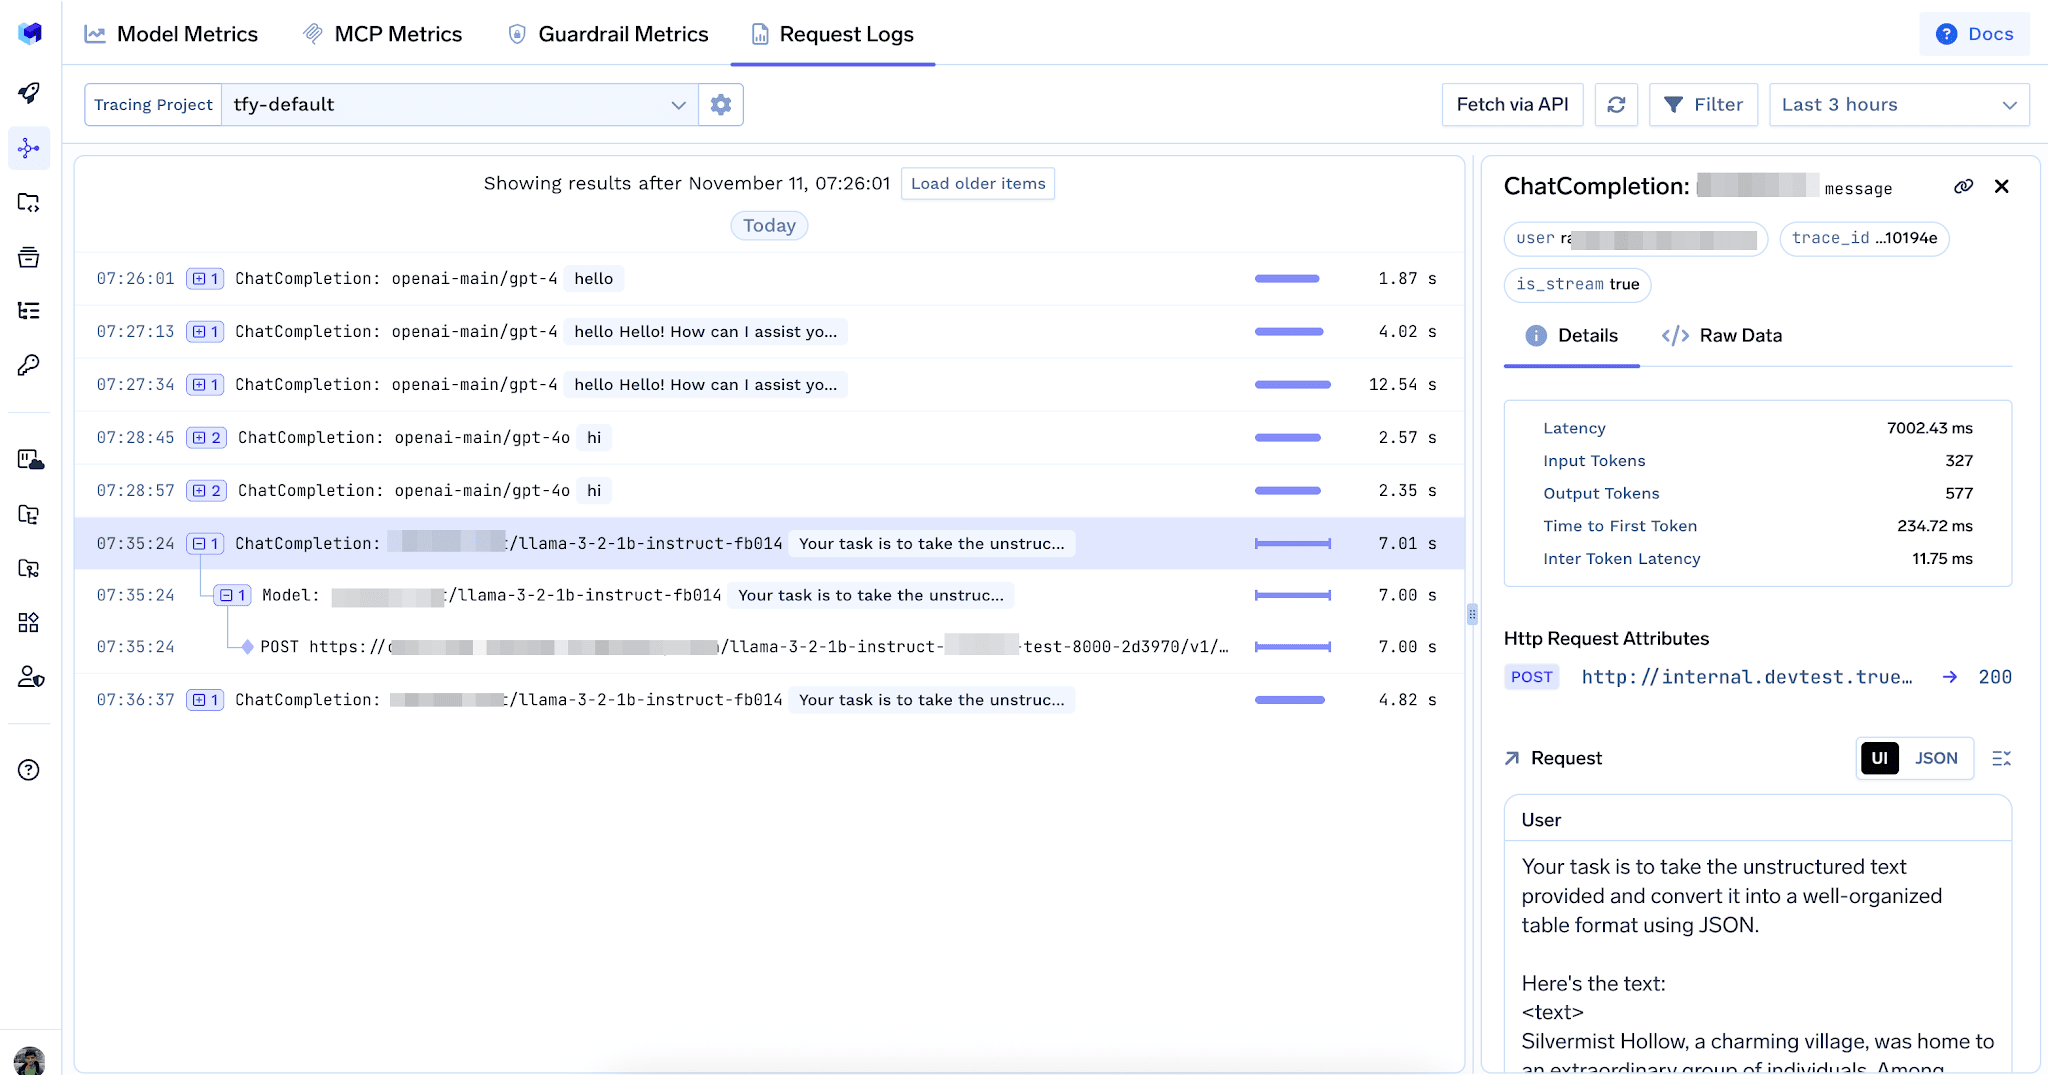
UIでログに記録されたリクエストを表示するには、AI Gatewayに移動し、Monitor、Requestsの順に選択します。これにより、ログに記録されたすべてのコールのリストが表示され、これを開いて単一のリクエストの詳細を検査できます。
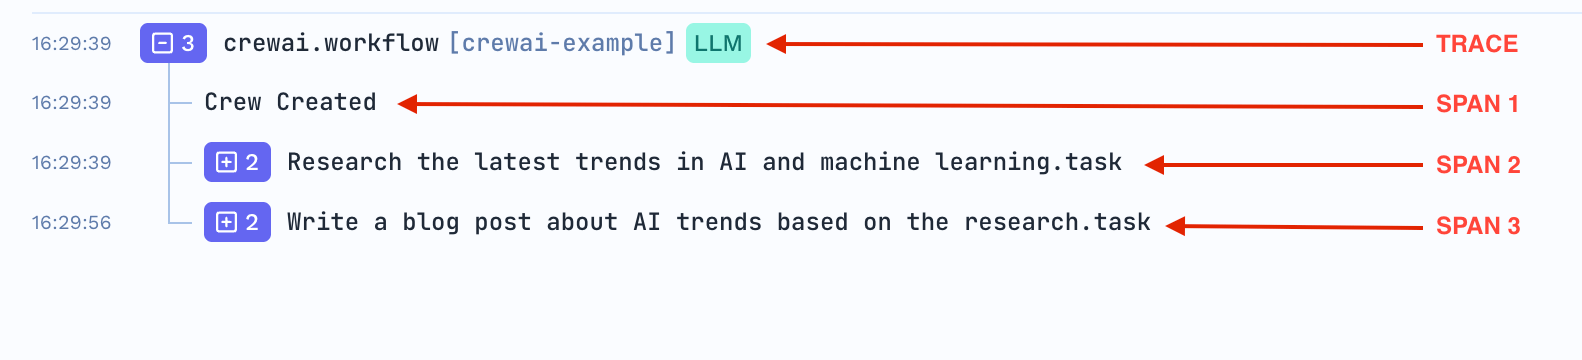
Tracingドキュメントでは、TraceをLLMと対話するサービスを通過するリクエストの完全なライフサイクルとして説明しています。通常、Traceはアプリケーションの単一のAPIコールに対応します。
Spanは、そのTrace内の個別の作業単位(関数呼び出し、HTTPリクエスト、モデル推論など)です。Traceは、親子の関係を持つSpanのツリーであり、子Spanは通常、その親によって発生します。TrueFoundryは、これらのTraceを保存するOpenTelemetryコレクターバックエンドと、それらをクエリおよび分析するためのUIを提供しており、OpenTelemetry互換の任意のSDKからTraceを受信できます。
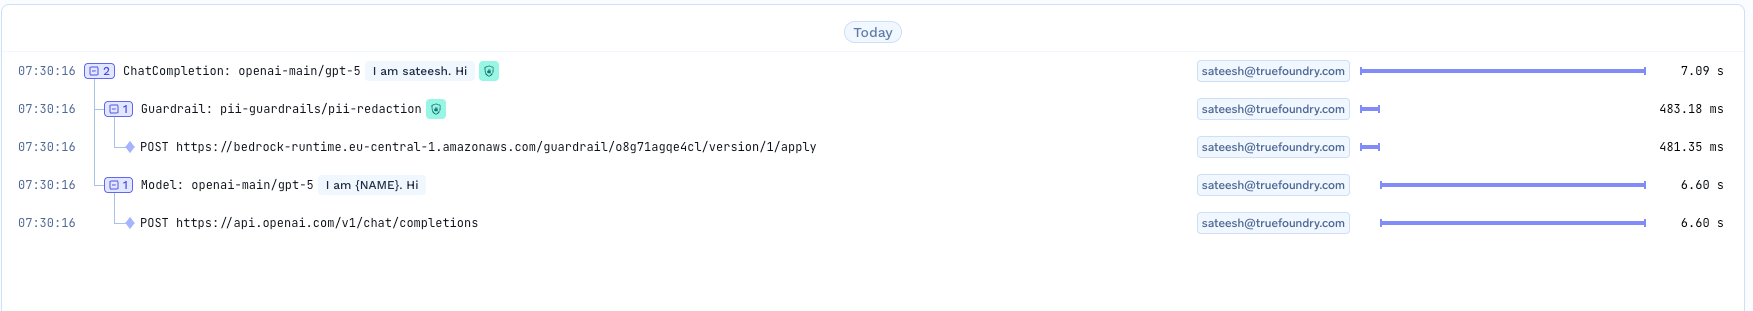
Trace Inspectionドキュメントでは、実際の例として、PII(個人識別情報)マスキングガードレールを備えたChat Completionが、階層を構成する5つのSpanとしてキャプチャされている様子を説明しています。
同じ例で、入力が名前からプレースホルダーへと明らかにマスキングされており、Trace内でPIIガードレールがエンドツーエンドで動作していることが示されています。
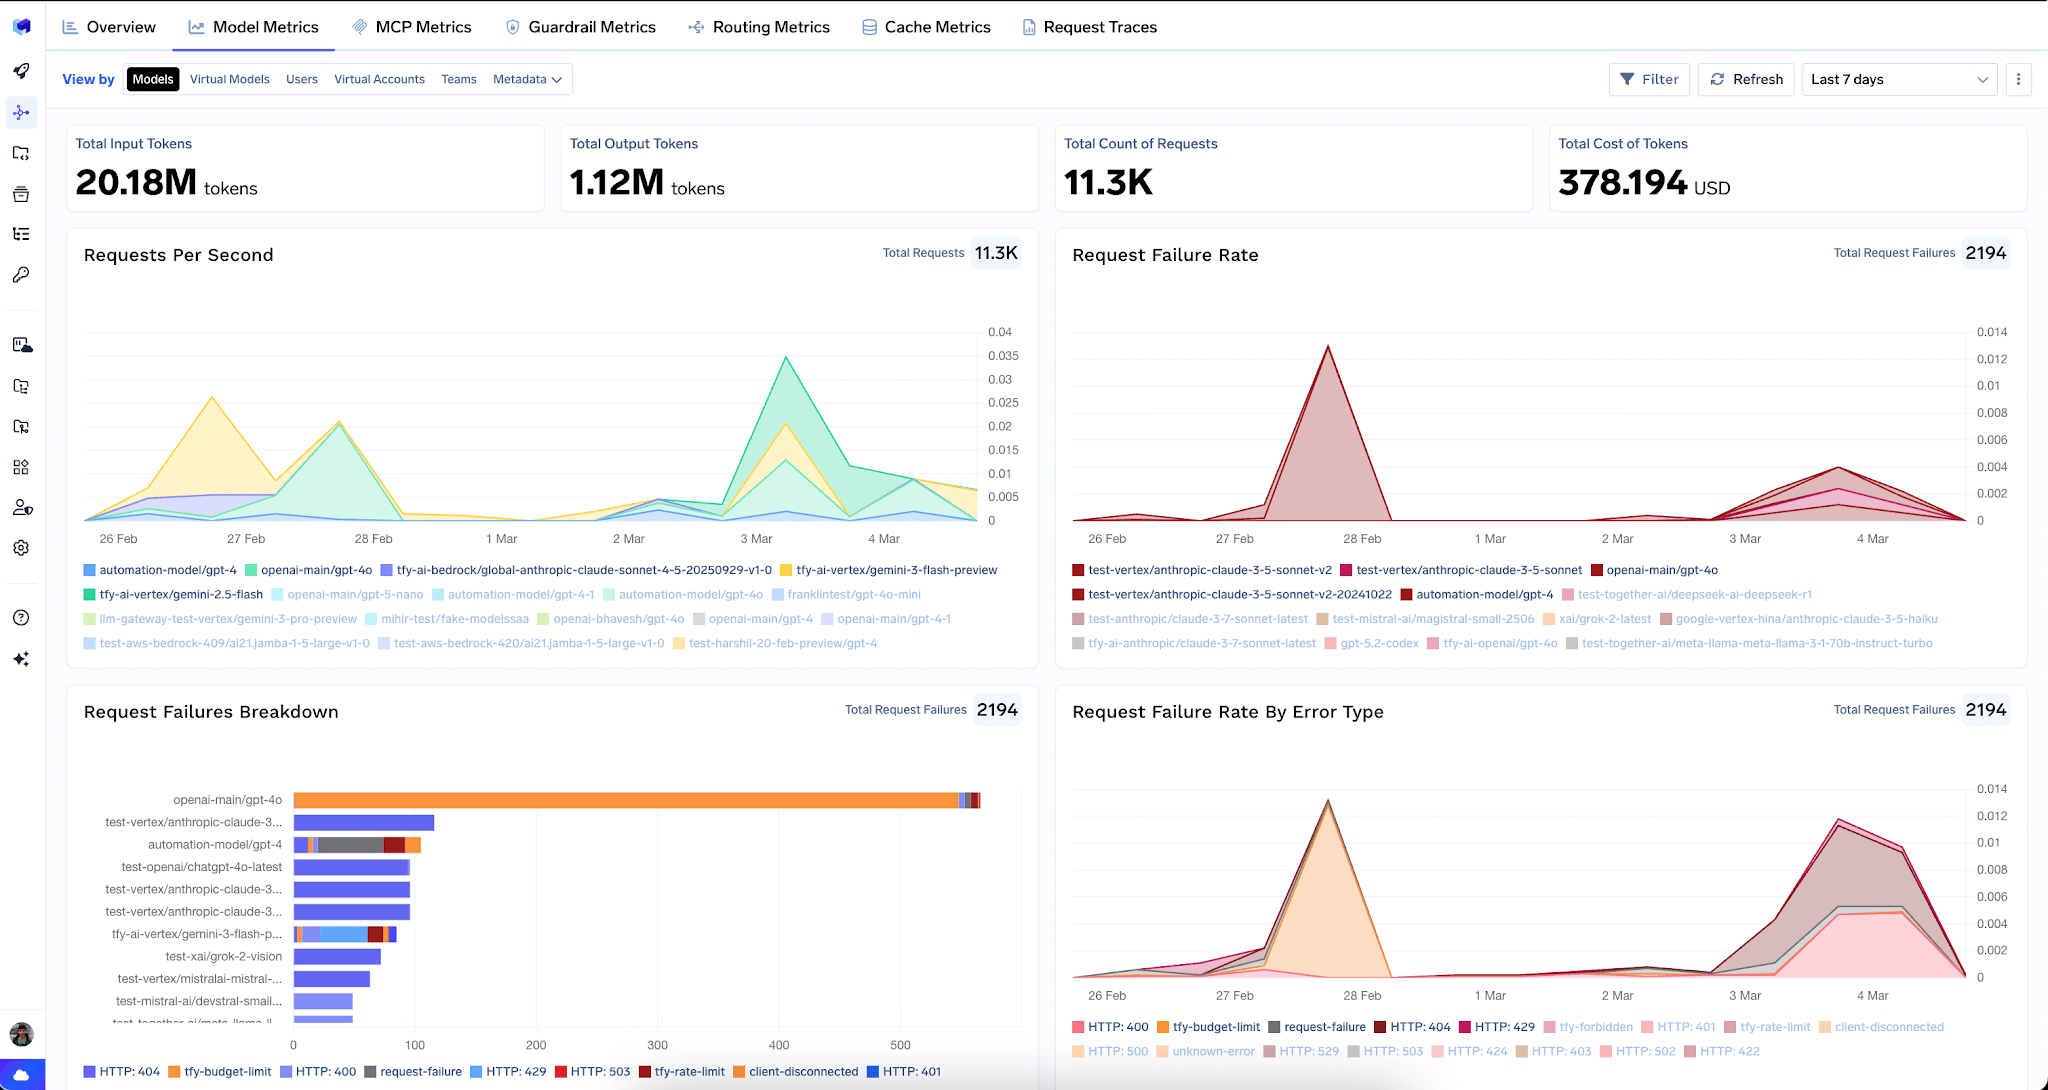
個々のTraceはデバッグ用です。トレンドについては、Analytics Dashboardが同じデータを集約します。タブには、Overview、Model Metrics、MCP Metrics、Guardrail Metrics、Routing Metrics、Cache Metricsが含まれます。
Model Metricsは、モデル、バーチャルモデル、ユーザー、バーチャルアカウント、チーム、またはメタデータごとにグループ化でき、レイテンシビューでは、リクエストレイテンシ、Time to First Token、トークン間レイテンシ、および出力トークンごとの時間を詳細に分析できます。リクエストごとのTraceと組み合わせることで、ミクロな視点とマクロなダッシュボードの両方が得られます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




Send the X-TFY-LOGGING-CONFIG header with a stringified JSON value and set enabled to true or false. Remember that the value is stringified JSON, not a raw object, because most SDKs serialize headers as strings.
Logged requests appear under AI Gateway, then Monitor, then Requests. Opening a request shows its trace, which is the tree of spans covering guardrails, the model, and the outbound provider calls.
A trace is the full lifecycle of a single request. A span is one unit of work inside that trace, such as a guardrail check or a model inference. Spans form a parent and child tree within the trace
Yes. TrueFoundry runs an OpenTelemetry collector backend and can receive traces from any OpenTelemetry compatible SDK. For LLM use cases the docs recommend an LLM focused SDK that captures model specific traces and metrics.




















