



November 14, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
GPT-6 Solがカタログに追加されてから1週間後、OpenAIはその定期後継モデルを出荷しました。GPT-6.1 Solは9月29日(火)にリリースされ、料金、コンテキスト制限、機能が入力された状態で、すでにTrueFoundry AI Gatewayのモデルカタログに登録されています。
他のすべてに使用しているのと同じOpenAI互換エンドポイントから呼び出すことができます。新しいSDKも、個別の統合も、Gatewayのリリースを待つ必要もありません。OpenAIアカウントでモデル文字列をgpt-6.1-sol(OpenRouterの場合はopenai/gpt-6.1-sol)に変更するだけで、新しいモデルに移行できます。
TrueFoundry AI GatewayでGPT-6.1 Solを試す →
GPT-6.1 Solは、GPT-6 Solと同じ定価で、より安価なキャッシュと同一の制限を備えてリプレイスされます。本番環境の予算に関わる重要数値は以下の通りです:
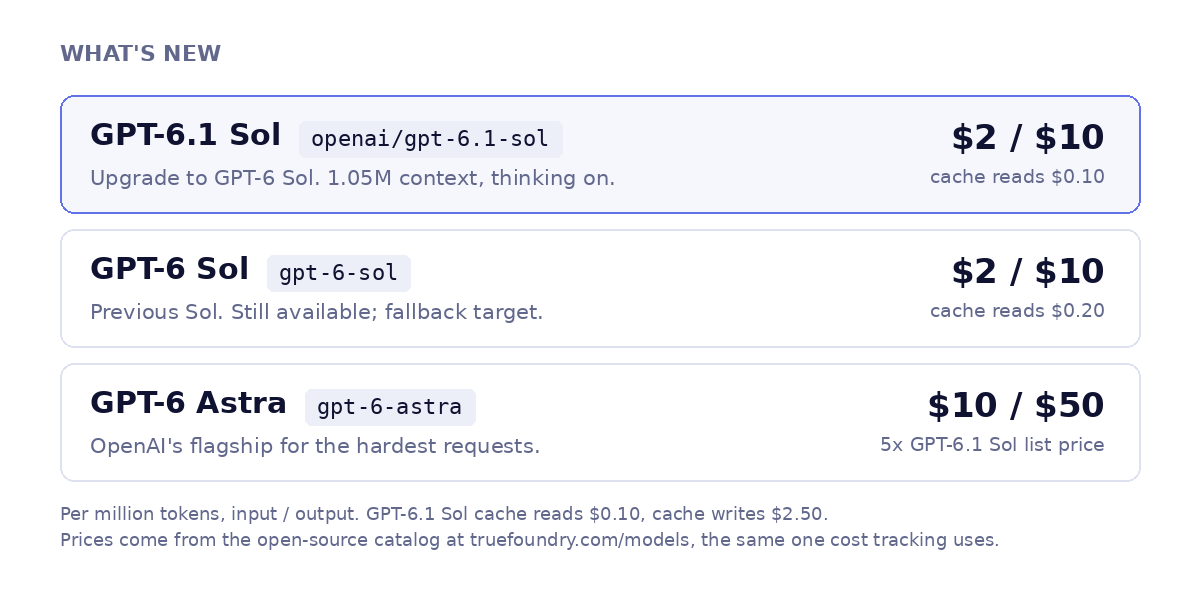
カタログによると、GPT-6 Astraは入力100万トークンあたり$10、出力100万トークンあたり$50となっています。GPT-6.1 Solは$2と$10で提示されており、双方において正確に5分の1であり、$0.10のキャッシュ読み取りはAstraの$1の10分の1です。
今月のリリースを並べて比較してみましょう:入力100万トークンあたり$0.10のGPT-6 Luna、$2のGPT-6 Sol、GPT-6.1 Sol、Claude Sonnet 5.5、$4のClaude Opus 5.5、$10のGPT-6 Astra。GPT-6.1 Solは、同じ価格でGPT-6 Solの枠を引き継ぎつつ、その$2の価格帯の中で最も低いキャッシュ読み取り料金を実現しています。
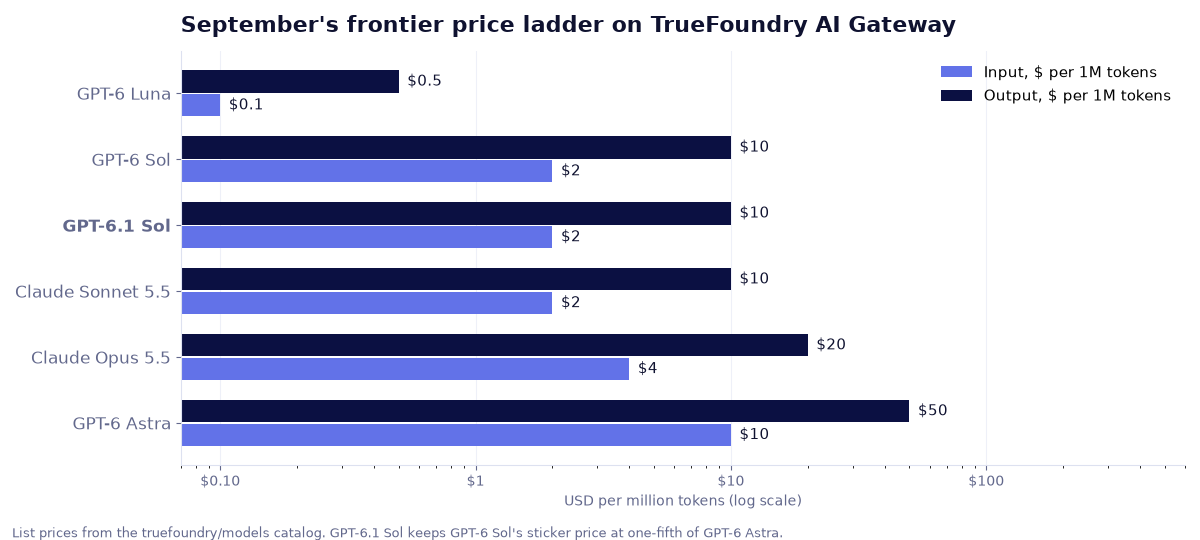
これこそが、モデル選択をアプリケーションコードではなくGatewayの設定として扱うべき理由です。本番環境のトラフィックの大部分は、多数の簡単なリクエストと少数の複雑なリクエストで構成されています。簡単な大部分をLunaに、中間をGPT-6.1 Solに振り分け、複雑な一部のみをAstraに送るようにすれば、全体の請求額はすべてをAstraで処理した場合とはまったく異なるものになります。これが機能するのは切り替えが設定変更のみで済む場合であり、それこそがAI Gatewayの存在意義です。
ステップ1:プロバイダーアカウントでモデルを有効化する。 GatewayでModels → お使いのOpenAIアカウント → Models Selectionを開き、gpt-6.1-solを検索してチェックを入れます。料金はカタログから直接読み込まれるため、インラインで表示されます(100万トークンあたり入力$2 / 出力$10)。次に、モデルが初日から適切なチームとバーチャルキーにスコープされるよう、Access Controlを設定します。
OpenAI直販とOpenRouter(openai/gpt-6.1-sol)はどちらも本日からカタログに含まれており、Microsoft FoundryとAWS Bedrockの項目も順次反映されます。
リストにモデルが表示されない場合は、リスト下部の+ Add Modelから手動で追加してください。
ステップ2:呼び出す。 Playgroundを開き、モデルを選択して、使用しているSDK用の生成されたスニペットをコピーします。OpenAI Pythonバージョンの例:
モデルIDは<your-provider-account>/<model>としてネームスペース化されているため、openai-main/gpt-6-solとopenai-main/gpt-6.1-solの変更は1行で完了します。X-TFY-METADATAヘッダーが各呼び出しをタグ付けするため、メトリクスビューでチーム別または機能別の支出が表示されます。
ステップ3(オプション):バーチャルモデルの背後に配置する。 バーチャルモデルを作成し、Auto Routingを選択します。Gatewayは各リクエストを単純、中程度、複雑に分類し、その階層に割り当てたターゲットに送信します。単純なリクエストにはGPT-6 Luna、中程度にはGPT-6.1 Sol、複雑にはGPT-6 Astraを割り当て、ローンチ初週のレート制限が安定するまでのフォールバックとしてGPT-6 Solを設定するのが賢明な初期構成です。当社のベンチマークでは、この種のマシニズムにより約98%の品質を維持しながらコストを50〜70%削減できました。アプリケーションは一貫して1つのモデル名を呼び出すだけで済みます。
GPT-6.1 Solは、リクエストにLuna以上の能力が必要だがAstraの価格の妥当性を示すのが難しい場合や、$0.10のキャッシュ料金によってコストを低く抑えられる長いコンテキストをエージェントが再送信する場合に最適です。TrueFoundry経由で実行することで、どのリクエストを割り振るかという判断をGatewayの設定内に保持でき、デプロイなしで変更することが可能です。
TrueFoundry AI GatewayでGPT-6.1 Solを試す →
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.
























