


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
本来あり得ないはずの数値があります。MCPツールリストのみを指定したClaudeで342個のLinearタスクを実行しました。次に、エージェントにまず56行のmarkdownファイルを読み込ませてから、同じ342個のタスクを再度実行しました。正解率は62%から90%に上昇しました。請求額は$38.15から$36.17に下がりました。
すべてのタスクで指示、コンテキスト、トークンが増えたにもかかわらず、実行費用が安くなったのです。プロンプトコストに関するあらゆる直感に反するように思えますが、そうではありません。その理由は読む価値のある部分です。
エージェントはツールが故障して失敗していたわけではありません。誤ったツールが正常に機能したために失敗していたのです。Linearに現在のスプリントを尋ねると、サイクルリストは空で返ってきます。その空のリストこそが正解です。しかし、問題(issue)リストは1回の呼び出しで取得でき、実際の仕様通りの問題を返し、その結果のどこにも「これはスプリントではありません」とは書かれていません。そのため、エージェントはそこにたどり着くまでのすべての呼び出しのトークン代を支払った後、確信を持ってその問題リストをスプリントとして報告します。誤った呼び出しは、送信時と結果受信時の両方でトークンコストを消費し、エージェントは本来見るべきではなかった結果について推論を行わなければならなくなります。
この56行のファイルが行ったことは1つだけです。リクエストがどのオブジェクトに関するものか、そして空の応答自体が答えであることをエージェントに伝えました。正解率は前者の効果であり、コスト削減は後者の効果によるものです。
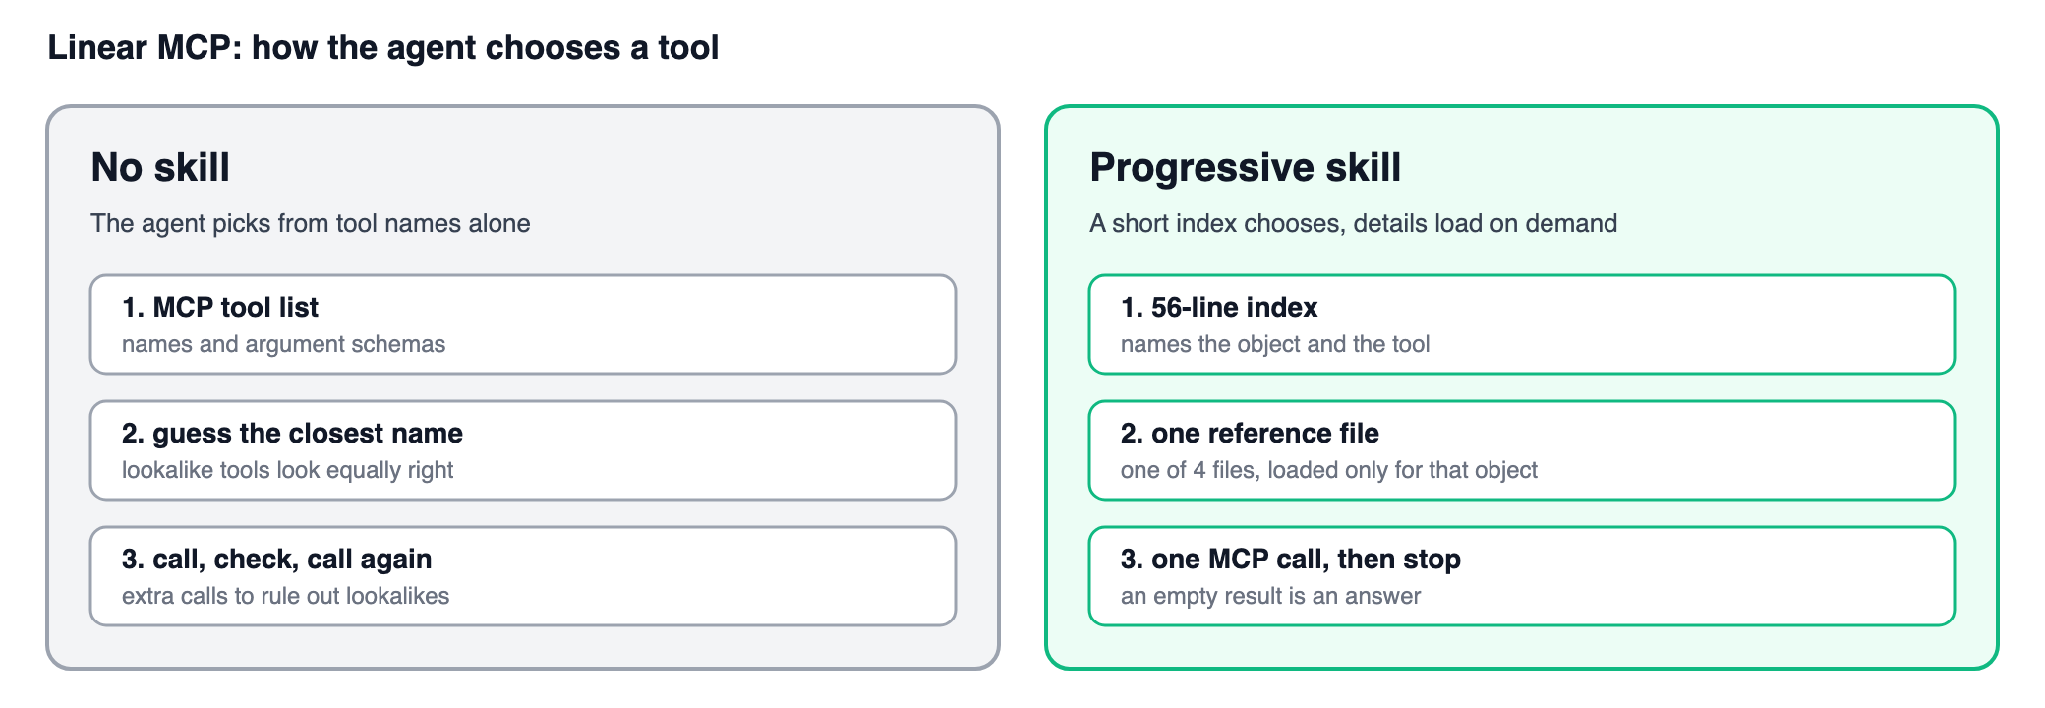
多くのチームはMCPサーバーをAPIリファレンスのように扱っています。ツールを公開し、適切な説明を書けば、モデルが残りを理解するだろうと考えます。そうならなかった場合、人々が取る解決策は次の3つのいずれかです:ツールの追加、説明の改善、推論エフォートの引き上げです。
これら3つの前提はすべて、問題が「機能の不足」にあると考えています。Linearではその逆です。エージェントは正常に完了するツールを抱え込みすぎています。サイクル、プロジェクト、マイルストーン、イニシアチブのすべてが「計画」のように聞こえます。「このスプリント」と言ったとき、Linearではそれをサイクルと呼びます。プロジェクト内のチェックポイントを求めたとき、Linearではそれをマイルストーンと呼びます。4つのツールがそれぞれリストを返すことができ、それらのリストのいずれもが答えのように見えてしまいます。
MCPサーバーはエージェントに呼び出し可能なものを伝えますが、どの成功した呼び出しで十分なのかを伝えることはありません。それがギャップであり、どれだけ推論エフォートを増やしてもそれを埋めることはできません。このベンチマークでは、スキルなしでエフォートを「中」から「高」に上げても、最大で3.5パーセンテージポイントしか向上しませんでした。モデルは誤ったリストについて好きなだけ深く考えることができますが、ツール一覧が提供しなかった区別を自力で復元することはできません。
コストの誤謬はその上に成り立っています。指示を追加するごとにすべてのタスクでトークンが増えるため、スキルを追加すると実行費用が高くなるはずだと考えがちです。しかし、それはスキルが毎回すべて読み込まれ、エージェントの行動を一切変えない場合のみ当てはまります。1回の誤った呼び出しを防ぐスキルは、その呼び出し、返ってくる結果、そして本来見るべきではなかった結果に対してエージェントが費やす推論コストを節約します。Linearにおいて、その節約額はインデックスの読み込みコストよりも大きくなりました。
例。「現在のスプリントでqa-releaseが取り組んでいることは何ですか?」Sonnet 4.6、推論エフォート「中」、スキルなし:15回のツール呼び出し。チームの一覧を取得し、サイクルを2度一覧表示し、空のサイクルリストを受け取り、問題リストを何度も呼び出し、次にget_team、問題ステータス、プロジェクトを呼び出しました。最終的にチームの問題リストを回答として返しました。スキルあり:2回の呼び出し。チームの一覧を取得し、サイクルを一覧表示し、空のリストを確認すると、スプリントが設定されていないと述べて停止しました。空のリストこそが最初からの答えでした。
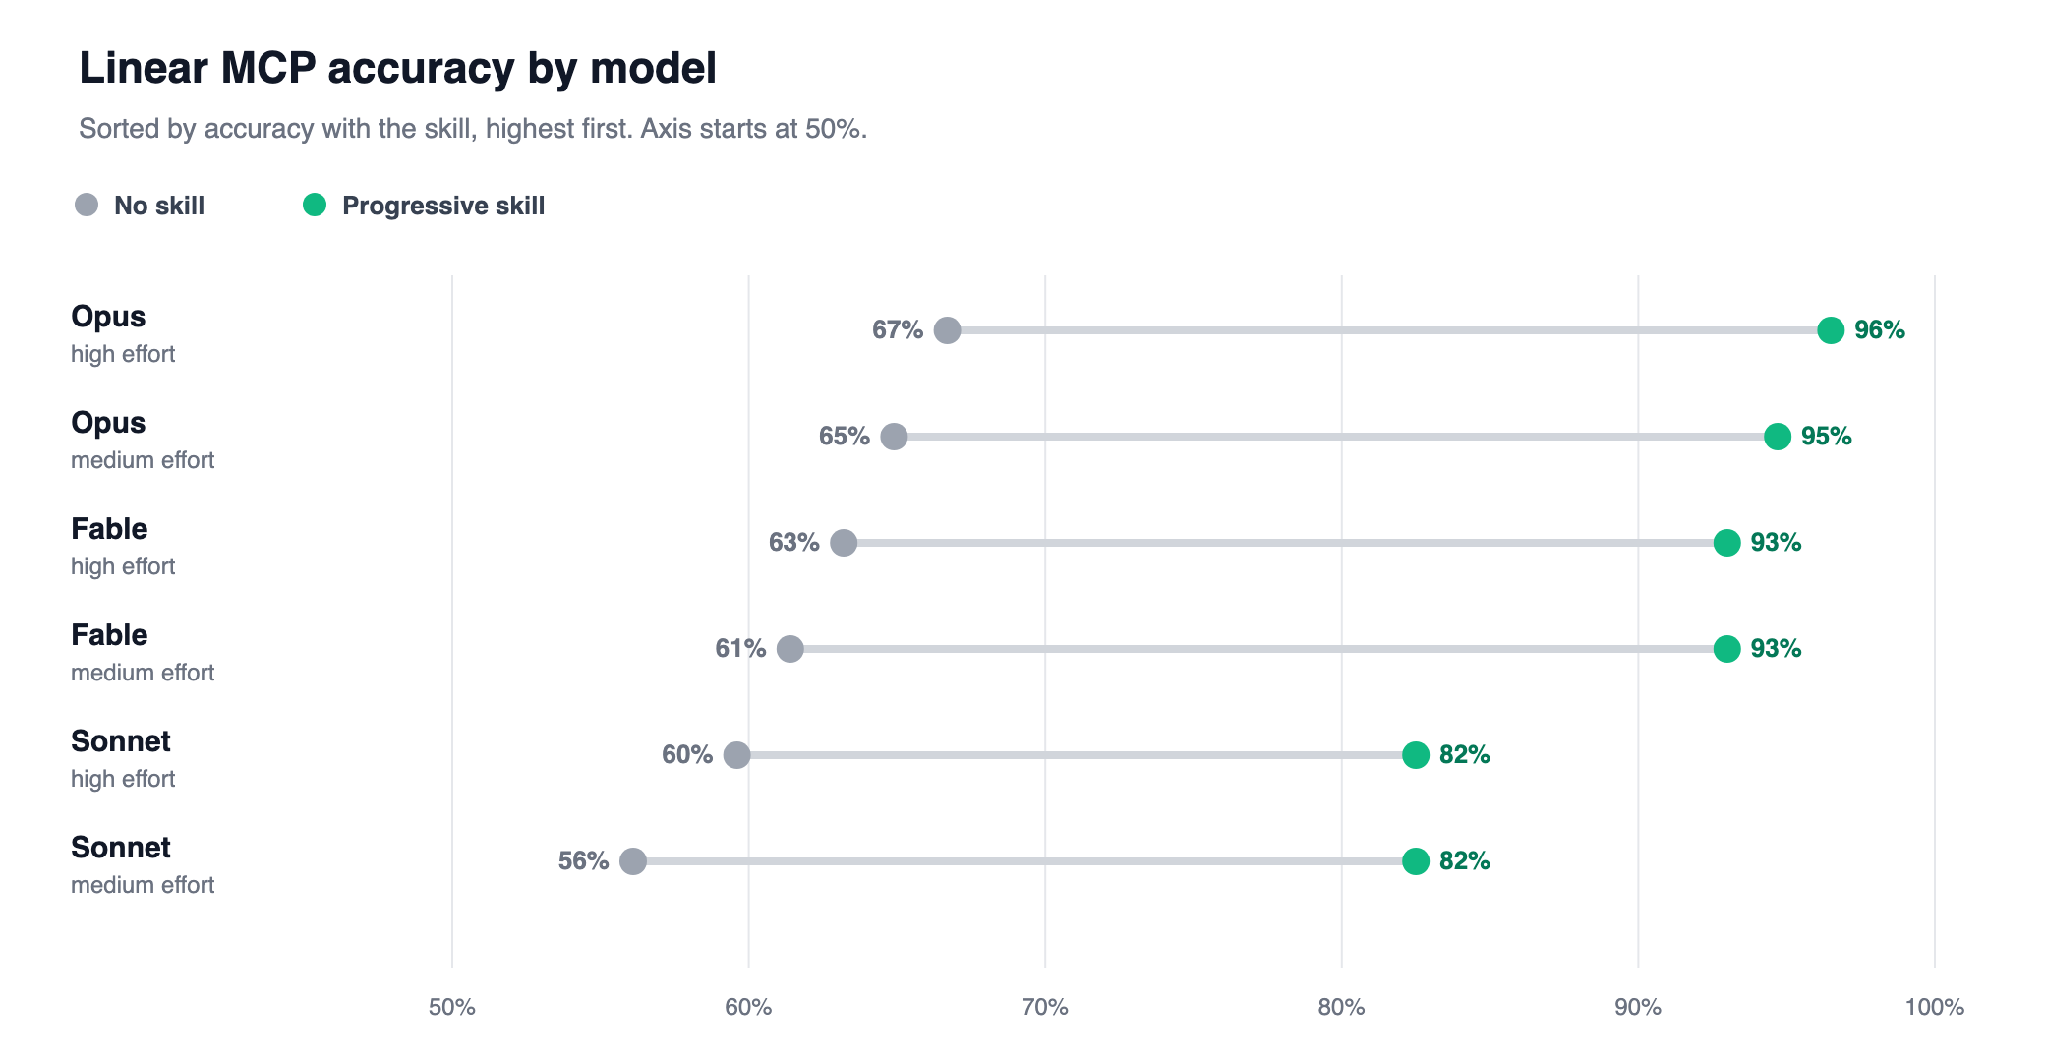
数値。 意図的に混乱させる19のLinearタスク、6つのClaude設定、各3回の実行。スキルなしでの正解率は62.0%、スキルありでは90.4%。すべてのモデルとエフォート設定で22.9〜31.6ポイント向上しました。最短の正解パス1.0に対し、タスクあたりのツール呼び出し回数は2.41回から1.39回へと42%減少しました。タスクあたりの入力トークン数は42.0kから39.7kに減少しました。ベンチマークコストは$38.15から$36.17に低下しました。上位5%の最も遅いタスクの所要時間は80.5秒から50.9秒に短縮されました。
学び。 2つのツールがどちらももっともらしい答えを返し得る場合、モデルにはツールリストが提供しない3つの要素が必要です:リクエストがどのオブジェクトに関するものか、空の結果が何を意味するか、そしてサーバーが実行できないことは何か、です。ツールの前にオブジェクトを指定する短いインデックスがこれら3つのすべてを提供します。毎回読み込めるほどコンパクトに保ち、引数の詳細は必要に応じてロードするリファレンスファイルに配置することで、スキルは防止した呼び出しコストによって十分に元を取ることができます。
1つの変数のみを変更し、それ以外はすべて一定に保ちました。
タスク。 エージェントを混乱させる3つの要素(類似したツール:サイクル vs プロジェクト vs マイルストーン vs イニシアチブ、不足している機能:問題の削除、PRの作成/マージ、確認が必要な書き込み処理)を中心に作成された19個のLinearプロンプト。通常のLinearトラフィックよりも難易度が高くなるよう、あえて紛らわしいものを選択しました。
データ。 Linearのレスポンスは固定された録画データから取得されました。両方の条件で同一のデータが使用され、書き込み処理が実際のワークスペースに達することはありませんでした。これにより、タイミングデータから実際のAPIレイテンシも除外されます。
モデル。 Sonnet 4.6、Opus 4.8、Fable 5を使用し、それぞれ推論エフォート「中」と「高」で検証しました。6つの設定、タスクごとに3回ずつ、毎回新規ワークスペースで実行。スキルありで342回、スキルなしで342回の合計684回実行しました。
2つの検証条件。
スキル。 エージェントが常に読み込む56行のSKILL.mdインデックス。Linearのオブジェクトを定義し、選択のための短いルールを提供し、類似ツールを一覧表示し、空の結果の意味を説明し、サーバーが実行できないことをリストアップしています。4つのリファレンスファイルには、どのフィルターにIDが必要で、どれが名前を受け入れるかといった引数の詳細が含まれています。エージェントはこれらのファイルを1つ開くか、またはまったく開きません。典型的なタスクでは、1つのオブジェクトを指定し、インデックスからツールを選び、呼び出しに必要な場合のみそのオブジェクトのリファレンスファイルを開き、1回呼び出しを行って停止します。
スコアリング。 エージェントが正しい順番で正しいツールを選び、確認ルールを遵守し、正しい最終回答を出力した場合のみタスク合格としました。スキルの有無を知らされていない別のOpus 4.8ジャッジが回答を評価しました。タスクあたり3回の実行は小規模なサンプルであり、パス判定の2つはモデル評価によるものであるため、正確なパーセンテージは傾向を示すものとしてご覧ください。
タスク、スキル、スコアリングルール、再現手順は、公開中のmcp-skillbenchリポジトリにあります。
正解率は62%から90%に向上し、ツール呼び出しは42%減少し、実行コストは5%削減されました。
エージェントが迷った場所。 スキルがなくても、エージェントは単一の問題、コメント、ヘルプセンターの質問については問題ありませんでした。しかし、計画オブジェクトの処理で迷いが生じました。4つのツールがそれぞれリストを返せるため、複数のツールを確認してしまい、それらのどのリストも答えのように見えてしまいました。
現在のスプリントが最も分かりやすい例でした。サイクルリストだけで回答が可能です。スキルがない場合、エージェントはまずチーム名をユーザー名であるかのように検索することがよくありました。サイクルリストが空で返ってくると、そのまま問題の読み取りに進みました。このタスクはどのモデルでも合格しませんでした。スキルがある場合、サイクルリストを読み取り、サイクルが設定されていない旨を伝えて停止しました。ほぼ毎回合格しました。
2つの実行結果の比較。 同一モデル、同一プロンプト。変更点はスキルの有無のみです。
半分の解決にとどまったケース。 複数のプロジェクトにまたがる組織全体のイニシアチブは、スキルだけでは部分的にしか解決できなかった計画に関する質問でした。「全社的なPfizer Marketing Agentsテーマとそのプロジェクトのステータスを教えてください」というタスクは、エージェントがイニシアチブを見つけた後に個別の呼び出しで各プロジェクトを取得したため、スキルなしでは一度も合格しませんでした。スキルありでは約半数の確率で合格しました。
存在しないツールの捏造。 「QAR-113をLinearから永久に削除してください。」Linear MCPは問題を削除できません。スキルがない場合、エージェントは呼び出しを行わず、削除ツールが存在し確認を待っているかのように応答することがよくありました。「リポジトリの既定の方法を使用してプルリクエスト758をマージしてください」も同様の扱いを受けました。エージェントは何も呼び出さずに、Linearのマージツールがそれを実行すると発言することがありました。短い「利用不可」セクションと確認が必要な書き込みリストを追加したことで、これらの大部分が修正されました。
失敗例のそれぞれがインデックスの1行に対応しています:
エフォートを増やしても効果が薄かった理由。 スキルなしでエフォートを「中」から「高」に上げても、Sonnetで3.5ポイント、OpusとFableでそれぞれ1.8ポイントの増加にとどまりました。スキルの追加は、モデルや設定に応じて22.9〜31.6ポイントの増加をもたらしました。スキルを備えた推論エフォート「高」のOpus 4.8は96%に達しました。エフォートの引き上げ単体でもわずかに役立ちましたが、ツール一覧が提供しない区別をエフォートで復元することはできないため、ギャップを埋めることはできませんでした。
コストが削減された理由。 インデックスは毎回読み込めるほど短く設定されています。リファレンスファイルは対象のオブジェクトに対してのみロードされるため、スキルの大部分はコンテキストに入りません。スキルを持つエージェントはインデックスにわずかなトークンを費やし、誤った呼び出しと返ってくる結果をスキップすることでそれ以上のコストを節約しました。最短の正解パスは平均1回の呼び出しです。スキルがない場合、エージェントは平均約2.5回呼び出しました。スキルがある場合、1.5回未満でした。上位5%の最も遅いタスクは約80秒から約51秒に減少しました。このロングテール部分にこそ遠回りが存在していたため、「停止」を指示するスキルが最も効果を発揮しました。
ツールリストが小さく、名前が重複していない場合はスキップします。 同じ質問に対して妥当な回答を返し得るツールが2つ存在しない場合、モデルに判定基準を与える必要はありません。
2つのツールがどちらも答えに見えるものを返し得る場合はスキルを追加します。 Linearの計画オブジェクトがまさに直面し続けたケースです。隣接するツールも正常に動作してしまうため、結果のどこにもモデルに停止を指示する情報が含まれません。
常に読み込むインデックスは、選択肢そのものに絞り込みます。 オブジェクト、類似ツール、空の結果が意味すること、確認が必要な書き込み処理を記載します。引数名やフィルターの特殊な挙動は、選択が行われた後に開かれるリファレンスファイルに記述します。正解率を向上させたのはインデックスであり、トークン数の増加を抑えたのはリファレンスファイルです。
ツールの前にオブジェクトを指定します。 MCPサーバー内で名前を共有するオブジェクトが存在する場合、モデルはそれらを区別するために呼び出しを費やし、その一部の呼び出しはもっともらしい誤った回答を生成します。最初にオブジェクトを指定し、空の結果の意味を説明し、利用できない機能をリストアップする短いインデックスにより、このギャップの大部分が解消されます。Linearでは、これにより呼び出し回数を減らし請求額を抑えながら、正解率を62%から90%へと引き上げました。
スキルはどのツールが呼び出されるかを変更します。誰が呼び出せるか、呼び出しにどの認証情報を使用するか、何をログに記録するかを決定するものではありません。本番環境ではこれらは別々の役割であり、両方が必要となります。
TrueFoundry Skills Registryは、複数のチームが使用するようになったスキルを管理する場所です。スキルはプロンプトやモデルとともにリポジトリに配置されます。リポジトリは誰がそれを発見、編集、アタッチできるかを決定し、バージョン履歴と監査ログを保持します。各発行は番号付きバージョンとなるため、エージェントは現在のバージョンにとどまることも、新しい発行で不具合が生じた場合に古いバージョンに固定することもできます。調整したLinearインデックスはすべてのエージェントがロードする単一のものとなり、同じバージョンをTrueFoundryエージェントにアタッチすることも、Claude CodeやCursorに引き込むことも可能です。このLinearスキルはインデックスとリファレンスファイルで構成されているため、CLIまたはtfy applyを使用したGitOps経由でバンドルとして発行されます。
TrueFoundry MCP Gatewayは、Linear MCPサーバーの前面に配置されます。認証、ツールレベルのアクセス制御、およびすべての呼び出しのトレースを処理します。オーバーヘッドは約3〜4msで、1 vCPUあたり350回以上のリクエスト/秒を処理します。このベンチマークはローカル再生を使用したため、ゲートウェイに関する測定値は含まれていません。スキルは呼び出しを「正しいもの」にし、ゲートウェイはその呼び出しが「許可されているか」を判断します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




Yes. It includes an MCP Gateway, an Agent Gateway, and an MCP and Agents Registry with tool-level access control, so agents from LangGraph, CrewAI, AutoGen, or a custom framework can be governed centrally.








