


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
Model Context Protocol (MCP) は「AIのためのUSB-C」と表現されることがよくあります。これはキャッチーですが、実際にエージェントをデータベースに配線する際にはあまり役に立ちません。ポートという比喩は、実際に作業を行う部分、つまりプロトコルを話すケーブル上の存在を隠してしまいます。MCPにおいて、その存在がクライアントです。
AIエージェントの構築や運用を行っている場合、ツール呼び出しがハングアップしたとき、セッションの途中でOAuthトークンが切れたとき、またはホストがモデルに提示しないツールをサーバーが宣伝しているときに、午前2時にデバッグすることになるコンポーネントがクライアントです。クライアントが何を行い、何を行わないのかを正確に理解することは、MCPを魔法として扱うか、インフラストラクチャとして運用するかの違いを生みます。
本記事では、MCPクライアントを正確に定義します。ホスト/クライアント/サーバーの三位一体におけるその役割、接続ライフサイクルのステップごとの解説、クライアントの認証方法、クライアントが実際に実行される場所、そしてなぜあらゆる本格的な規模においてクライアントとサーバーの間にゲートウェイを配置するのかについて説明します。
組織内のすべてのMCPクライアントに対して、分散した設定ではなく1つの統制されたエンドポイントをお求めですか?デモを予約する。
MCPには3つの役割があり、これらを混同することが混同の最も一般的な原因となっています。
ホストとは、ユーザーが操作するAIアプリケーションです。言語モデル(または言語モデルへの接続)、会話、そしてどのツールをいつモデルに公開するかという決定を所有します。Claude Desktopはホストです。Cursorはホストです。SDKを使用して作成したカスタムエージェントもホストです。
クライアントとは、ホストがインスタンス化するプロトコルコネクタです。その唯一の仕事は、1つのサーバーへの接続を維持し、ホストの内部世界とMCPのワイヤプロトコルとの間を変換することです。この関係は1対1です。1つのクライアント、1つのサーバー。5つのサーバーに接続するホストは、5つのクライアントを実行します。各クライアントは、独自のセッション状態、独自の機能セット、および独自のクレデンシャルを保持します。
サーバーは、機能、ツール(モデルが呼び出せる関数)、リソース(ファイルや行などの読み取り可能なデータ)、およびプロンプト(再利用可能なテンプレート)をプロトコル経由で公開します。GitHub MCPサーバーはcreate_issueとlist_pull_requestsを公開します。Postgresサーバーはクエリツールとテーブルリソースを公開します。
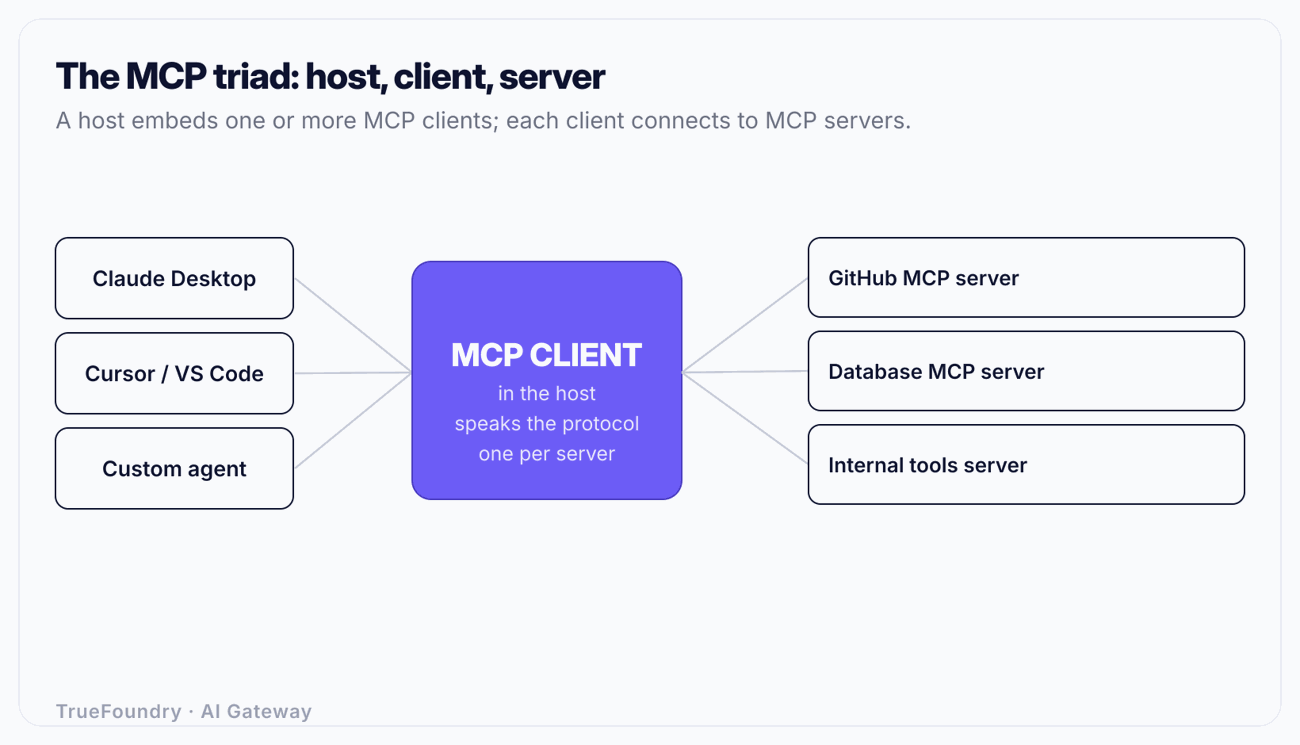
責任範囲が重複しないため、この分離が重要です。ホストはポリシーを決定します(「モデルにdelete_repoの呼び出しを許可すべきか?」)。クライアントはプロトコルを強制します(「このサーバーは初期化されているか?機能は宣言されているか?」)。サーバーは作業を実行し、結果を返します。何かが破損した場合は、それを所有するレイヤーで修復します。モデルにまったく表示されないツールは、通常ホストの問題です。表示されるものの実行時にエラーになるツールは、通常クライアントまたはサーバーの問題です。
1対1のルールは偶然ではありません。各MCP接続は、ネゴシエートされた機能を持つステートフルなセッションです。サーバーAはリソースサブスクリプションをサポートしているかもしれませんが、サーバーBはサポートしていない可能性があります。サーバーAはGitHub OAuthトークンで認証し、サーバーBはデータベースのクレデンシャルを使用します。各接続に独自のクライアントを与えることでその状態が隔離され、ある接続での機能や期限切れのトークンが別の接続を壊すことがなくなります。ホストはマルチプレクサとなり、単一のユーザーリクエストを必要なクライアントに振り分け、結果を収集してモデルにフィードバックします。
比喩を取り除くと、準拠したMCPクライアントが行う具体的な処理は5つあります。
トランスポート(トランスポート層)。接続を確立し保持します。MCPは2つの標準トランスポートを定義しています。1つはstdioで、クライアントがサーバーをサブプロセスとして立ち上げ、標準入力/出力経由で通信します。もう1つはStreamable HTTPで、クライアントがサーバーのURLにHTTPリクエストを送信し、レスポンスとしてサーバー送信イベント(SSE)のストリームを受け取ることができます。ローカルツール(ラップトップ上のファイルシステムサーバー)は通常stdioを使用します。リモートツール(ホスト型サービス)はHTTPを使用します。
メッセージフレーミング。すべてのMCPメッセージはJSON-RPC 2.0です。クライアントはid、method、paramsを持つリクエストオブジェクトを構築し、idによってレスポンスを対応するリクエストに一致させ、サーバー開始の通知をルーティングします。生のMCPトラフィックを見たことがあるなら、それが単なるJSON-RPCエンベロープのストリームであることがわかるでしょう。
機能ネゴシエーション(Capability Negotiation)。接続時に、クライアントは自身が使用するプロトコルバージョンとサポートする機能(たとえば、サンプリングリクエストや抽出を処理できるかどうか)を含むinitializeを送信します。サーバーは自身の情報で返答します。このハンドシェイク以降、両者は何が許可されているかを知ることになります。サーバーが一度も宣言していない機能をクライアントが使用しようとするのはバグです。
呼び出し(Invocation)。ホストがモデルにツールを呼び出させると決定すると、クライアントはツール名と引数を指定してtools/callを送信し、結果を待って送り返します。resources/readやprompts/getについても同様に処理します。
ライフサイクルとクリーンアップ。クライアントは、トークンの更新、再接続、ホストが閉じたときの接続のクリーンな破棄など、ハンドシェイクからシャットダウンまでのセッションを管理します。
そのリストに含まれていないことに注意してください:ツール呼び出しが安全かどうかを判断すること、結果からシークレットをマスキングすること、あるいは暴走したエージェントが同じツールを400回呼び出すのを停止すること。これらはホストおよびガバナンス上の懸念事項です。基本プロトコルは配管(プランミング)を提供するだけであり、ポリシーを提供するものではありません。そのギャップこそが、後述するエンタープライズコントロールが存在しなければならない場所です。
クライアントの接続は、決まった手順に従って進行します。これを理解しておけば、ほとんどのMCPの失敗を「どのステップが失敗したか?」という簡単な問いに変換できます。
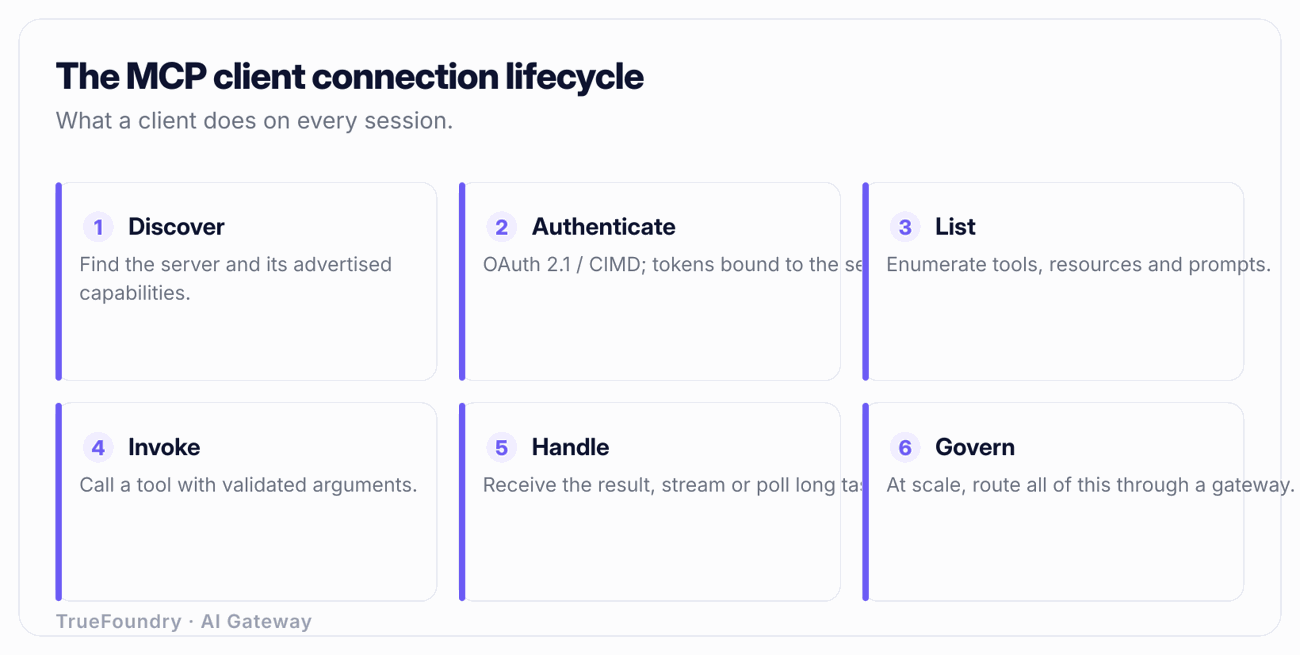
1. 検出(Discover)。クライアントは接続先のサーバーを必要とします。ローカルのstdioサーバーの場合、「検出」とは設定エントリー(起動するためのコマンドと引数)のことです。リモートサーバーの場合はURLです。大規模なデプロイメントでは、検出は動的になります。クライアントは各サーバーをハードコーディングするのではなく、レジストリやゲートウェイに対して、存在するサーバーとそのエンドポイントを問い合わせます。
2. 認証(Authenticate)。リモートHTTPサーバーの場合、クライアントはサーバーが応答する前に、自分が誰であるかを証明する必要があります。MCPの認可モデルはOAuth 2.1です。クライアントは保護リソースメタデータ(RFC 9728)から認可サーバーを検出し、必要に応じて動的クライアント登録(RFC 7591)を行い、PKCE対応の認可コードフロー(RFC 7636)を実行して、得られたベアラートークンをすべてのリクエストに添付します。ローカルのstdioサーバーは、通常プロセス境界から信頼を継承するため、このステップをスキップします。
3. 初期化(Initialize)。クライアントはinitializeリクエスト(プロトコルバージョン、クライアント情報、および機能)を送信します。サーバーは自身のプロトコルバージョン、サーバー情報、および機能で応答します。バージョンに互換性がない場合、接続はここでクリーンに失敗します。これはツール呼び出しを3回行った後に失敗するよりもはるかに優れています。その後、クライアントはinitialized通知を送信してセッションが稼働中であることを確認します。
4. 機能のリスト表示(List capabilities)。クライアントはtools/listを呼び出し、必要に応じてresources/listおよびprompts/listを呼び出します。サーバーは各ツールの名前、説明、および入力用のJSON Schemaを返します。これがホストがモデルに提示するカタログとなります。サーバーは後からツールセットが変更された場合にlistChanged通知を送信することもでき、行儀の良いクライアントはそれに応じて再リスト化を行います。
5. 呼び出し(Invoke)。ホストがツールを選択すると(通常はモデルがリクエストしたため)、クライアントは検証済みの引数を指定してtools/callを送信します。長時間実行される呼び出しでは、中間出力をストリーミングできます。クライアントはidによってレスポンスをリクエストに関連付けます。
6. 結果の処理(Handle the result)。クライアントはツール結果をホストに返し、ホストはそれをモデル用にフォーマットします。MCPの結果には、ツールレベルのエラー(ツールが実行されて失敗した場合。例:「リポジトリが見つかりません」)とプロトコルレベルのエラー(呼び出し自体が不正な場合)を区別するフラグが含まれています。これら2つを同一視することは、よくあるクライアントのバグです。「見つかりません」はモデルのための情報ですが、プロトコルエラーはコードで処理しなければならない問題です。
7. シャットダウン(Shut down)。ホストの処理が終了すると、クライアントはトランスポートを閉じます。stdioの場合はサブプロセスを終了し、リモートの場合はHTTPセッションを終了します。
「api リポジトリに『Flaky CI』というタイトルの Issue を作成して」と頼まれたコーディングエージェントを想像してみてください。ホスト内部のシーケンスは次のようになります。
tools/listからツールカタログを取得済みです。これにはowner、repo、titleを必要とするスキーマを持つcreate_issueが含まれています。create_issue({owner: "acme", repo: "api", title: "Flaky CI"})。tools/callを送信し、サーバーはIssueを作成して、エラー以外の結果として{issue_number: 412, url: "..."}を返します。これらのステップのそれぞれにおいて、問題が発生する可能性があります:トークンの期限切れ(ステップ1)、モデルが誤って推測したスキーマの不一致(ステップ3)、ツールのエラーを返すサーバー側の権限失敗(ステップ4)。ライフサイクルを知ることで、どこを確認すべきかがわかります。
初期のMCP接続はほとんどがローカルのstdioサーバーであり、そこでは認証は暗黙的なものでした。リモートサーバーの登場によって状況が変わり、プロトコルは新しいものを発明するのではなく、OAuth 2.1で標準化されました。
具体的には、リモートクライアントは以下を行います。
2026-07-28の仕様改訂でも、明確な方向性が引き継がれました。サーバーが長時間実行セッションを単一のプロセスに固定する必要がないステートレスなStreamable HTTPへ向かう方向と、Mcp-Nameヘッダーを介した明示的なサーバー識別により、クライアントや仲介者が特定のサーバーを明確に指定してルーティングできるようにする方向です。ステートレスなトランスポートは、サーバーがロードバランサーの背後で水平スケールできるようにするために運用上重要です。トークルフロー、オーディエンスバインディング、失敗モードについてのより深い解説については、MCP認証ガイドをご覧ください。
実践的な教訓:クライアントの安全性は、そのトークン処理の安全性と同等でしかありません。ベアラートークンをログ出力したり、トークンのオーディエンス検証に失敗したり、クリーンに更新を行わないクライアントは、クレデンシャルを漏洩させるかセッションを破綻させます。これらはクライアントの責任であり、単体で正しく機能させるのは難しいため、規模が拡大した際には中央集権的な処理が勝利するもう1つの理由となります。
「MCPクライアント」というと抽象的に聞こえるかもしれませんが、実際にはすでにいくつか使用したことがあるはずです。代表的なものと、それぞれが正確に何であるかを以下に示します。
この表における重要なニュアンスは、すべてのケースにおいてクライアントはプロダクト内部のライブラリレベルのコンポーネントであるということです。Claude Desktopがホストであり、GitHubサーバーに対して実際にJSON-RPCを話すものは、ホストが作成したクライアントオブジェクトです。MCP SDKを使用してカスタムエージェントを記述する場合、ユーザー自身がそのクライアントオブジェクトをインスタンス化し、connect()、list_tools()、およびcall_tool()を直接呼び出しています。
また、このことは同じサーバーがホストによって微妙に異なる動作をする理由も説明しています。サーバー自体は同一ですが、ツールをどれだけ積極的に再リスト化するか、ツールのエラーをモデルにどのように提示するか、認証をどのように処理するかにおいてクライアントが異なります。「Claude Desktopでは動作するが自分のエージェントでは動作しない」というのは、ほぼ常にサーバーの違いではなくクライアントの振る舞いの違いです。

TrueFoundryがどのようにしてすべてのエージェントとMCPクライアントの認証、検出、監査を中央集権化するかをご覧ください。デモを予約する。
1つのクライアントを1つのサーバーに向けるだけであれば、MCPはシンプルです。では、それを現実に適用してみましょう。200人の開発者、30個の内部MCPサーバーが存在し、各ホストが独自のOAuthトークンを保持しようとし、各サーバーが独自のURLでアクセス可能であり、セキュリティチームは誰がどのツールを呼び出したかを知りたがっているとします。
直接接続モデルはすぐに破綻します。
解決策は、LLM APIにおける同様の混乱を解決したパターンと同じです。中央にゲートウェイを配置します。MCP gatewayは、すべてのクライアントに単一のエンドポイントを提供します。クライアントはゲートウェイに対して一度だけ認証を行い、ゲートウェイがダウンストリームサーバーのクレデンシャルを保持およびローテーションします。検出は動的になります。クライアントは静的なリストを持つ代わりに、ゲートウェイのMCP registryに何が存在するかを問い合わせます。そしてすべての呼び出しが1つの場所を通過するため、プロトコル自体が提供しないガバナンス、アクセス制御、レート制限、および監査が得られます。
建築的には、これはLLM proxyを模したものです。1つの論理的な正面玄関があり、その背後に多数のバックエンドがあり、中央でポリシーが強制されます。クライアントの仕事は複雑になるのではなくシンプルになります。1つのよく知られたエンドポイントに1つのクレデンシャルで接続し、ファンアウトの処理はゲートウェイに任せます。
機密データを保持する内部システムをツールが呼び出すような規制環境では、これはオプションではありません。チームごとの接続可能サーバー・ツールのアクセス制御、すべてのツール実行の完全な監査、アクセス権を中央で取り消す機能など、エンタープライズMCPガバナンスが必要です。TrueFoundryのMCPゲートウェイとレジストリはまさにこれを提供します。クライアントには1つのエンドポイントが与えられ、認証とRBACが中央で強制され、すべてのツール呼び出しが観測可能かつタグ付けされ、サーバーの検出は分散した設定ファイルではなく統制されたレジストリを通じて実行されます。選択肢を検討している場合、最適なMCPゲートウェイの概要でトレードオフをカバーしており、MCPサーバーホスティングではサーバー自体の運用についてカバーしています。
ホストをクライアントとして扱う。チームは「Cursorが私のMCPクライアントです」と言います。Cursorはホストであり、クライアントを含んでいます。デバッグの瞬間、この区別が重要になります。モデルに一度も届かないツールはホスト側の公開の決定であり、呼び出し時にエラーになるツールはクライアントまたはサーバーの問題です。この2つを混同すると、間違ったレイヤーを探すことになります。
initializeハンドシェイクを無視する。カスタムクライアントを記述する開発者は、機能のネゴシエーションが完了する前にtools/callを発行したり、サーバーが一度も宣言していない機能を前提としたりすることがあります。その結果、断続的で不可解な失敗が発生します。ハンドシェイクは儀式ではなく、契約です。尊重しなければ、動作が不安定になることを覚悟してください。
ツールのエラーとプロトコルのエラーを混同する。MCPの結果は、ツール自体が失敗したのか(モデルが見て推論すべき404など)、呼び出し自体が不正だったのか(コードの問題)をフラグで示します。これらを折りたたんでしまうクライアントは、モデルから有用なシグナルを隠してしまうか、復旧可能な状況でクラッシュすることになります。
すべてのクライアントにサーバーURLとクレデンシャルをハードコーディングする。これは3つのサーバーなら機能しますが、30個になると崩壊します。静的な設定は、すべてのローテーションとすべての移動がフリート全体の変更になることを意味します。レジストリによる動的な検出だけがスケールする方法です。
各クライアントに独自のOAuthを処理させる。PKCEとトークン更新を備えたOAuth 2.1は、ログへのトークン漏洩、オーディエンス検証の欠落、失敗した更新など、微妙に間違った実装をしがちです。認証をゲートウェイに集約すれば、N個のバグを持つN回ではなく、正しく1回だけ実装すれば済みます。
MCPクライアントは、エージェントによるツール使用を機能させる地味なコンポーネントです。接続を保持し、機能をネゴシエートし、認証を行い、すべてのツール呼び出しをJSON-RPC経由でマーシャリングします。メンタルモデルを正しく理解し(ホストがポリシーを所有し、クライアントがワイヤを所有し、サーバーが作業を行う)、MCPが魔法であることをやめ、運用およびデバッグ可能なものへと変わります。
1つのクライアントと1つのサーバーであれば、直接モデルで問題ありません。数十のサーバーと数百のユーザーが存在するエンタープライズ規模では、クライアントをサーバーに直接指し示すのをやめ、中央にゲートウェイを配置します。1つのエンドポイント、中央集権的な認証と検出、そしてすべてのツール呼び出しに対するガバナンス。これこそが、成長するエージェントのフリートを有用かつ制御下に維持するアーキテクチャです。
すべてのMCPクライアントに、接続するための1つの安全なゲートウェイを提供しましょう。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












