


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
プラットフォームリーダーに、自社が現在いくつの異なるLLMに費用を支払っているかを尋ねると、通常は少し間が空いた後に推測の答えが返ってきます。正直な答えは「思っている以上に多い」であることがよくあります。クレジットカードとAPIキーを持つエンジニアなら誰でも、午後のうちに新しいモデルをサービスに組み込むことができるからです。これらの連携はそれぞれ個別の請求書、個別の認証情報、そして機密データが組織外に流出する個別の経路であり、そのいずれも一元的に把握することはできません。
モデルカタログは、そのギャップを埋めるための管理機能です。「私たちのチームはどのモデルを、どのようなルールの下で呼び出すことが許可されているか?」という問いに対する、単一かつガバナンスの効いた回答となります。これは単なる承認済みベンダーのスプレッドシートではなく、各エントリに適用されるポリシーが付与された強制力のあるリストです。
本記事では、モデルカタログを正確に定義し、カタログとモデルレジストリの違いを明確にし(これらは常に混同されています)、なぜ無秩序な拡散が危険でコストがかかるのかを説明し、ゲートウェイに実装されたカタログが論理モデル名にどのように実際のポリシーを結合するかを示します。
モデルごとの予算とポリシーを備えた、承認済みモデルのガバナンスの効いたカタログをお探しですか?デモを予約する。
モデルカタログは、論理モデルエントリの厳選されたセットです。各エントリには2つの側面があります。
最初の側面はバインディング(結合)です。論理名(例:summarizer-prod)が1つ以上の実際のターゲット(特定のプロバイダー、モデルバージョン、エンドポイント)にマッピングされます。これは論理/仮想モデル名が提供するものと同じ間接参照であり、アプリケーションは生のプロバイダーではなく、その名前を呼び出します。
2番目の側面は、そのエントリに添付されたポリシーです。
エントリは、両方の側面が揃って初めて「カタログ内」にあると言えます。これこそが、カタログとWikiにあるモデル名のリストとの違いです。ポリシーがエントリに付随し、すべての呼び出しに適用されるため、カタログには強制力があります。
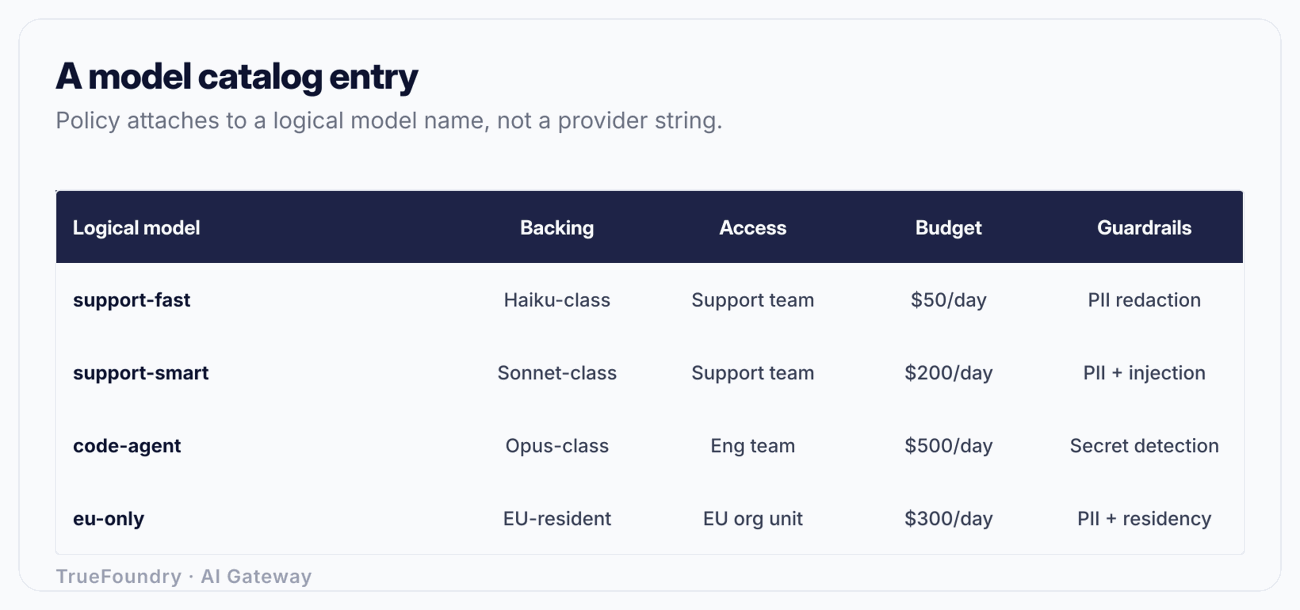
ポリシーはアプリケーションコードではなく論理名に結合されているため、変更は1か所の操作で済みます。チームの予算を減らす、基礎となるモデルバージョンを入れ替える、PIIガードレールを追加するといった変更を行うと、その論理名を呼び出すすべてのサービスが次のリクエストで変更内容を継承します。再デプロイも、ハードコードされたモデル文字列を探してリポジトリを捜索する必要もありません。
これは本記事で最も重要な明確化です。なぜなら、これらの用語は互換的に使用されがちですが、全く異なるシステムを指しているからです。
モデルレジストリ(MLOpsツールにおけるアーティファクトレジストリを思い浮かべてください)は、トレーニング済みモデルのアーティファクトを管理します。その単位は自身で作成したモデルです。つまり、重みのセット、バージョン、トレーニング実行およびデータセットへのリニエージ(履歴)、メトリクス、ライフサイクル(ステージング、本番、アーカイブ)です。データサイエンティストがモデルをトレーニングし、それらのアーティファクトを再現可能な方法で追跡、昇格、デプロイする必要がある場合にレジストリを使用します。
モデルカタログは、サードパーティLLM APIや自社で配信するオープンウェイトモデルなど、チームが消費するモデルへのアクセスを管理します。その単位は、承認されたポリシー結合済みのエントリです。誰がどのモデルを、いくらのコストで、どのリージョンで、どのようなガードレールの下で呼び出せるかを制御するためにカタログを使用します。
どちらも「モデル」を扱うため混乱が生じるのも無理はありませんが、これらは異なる問いに答えます。一方は「詐欺検知モデルのどのバージョンをデプロイしたか?それはどのトレーニング実行からのものか?」と問いかけます。もう一方は「サポートチームはこのLLMに顧客データを送信することを許可されているか?今月の予算を超過していないか?」と問いかけます。成熟したプラットフォームには両方が備わっていることが多く、それらは異なる層に位置しています。
このセクションから1つだけ覚えておくべきことがあるとすれば、レジストリは構築するモデルの供給に関するものであり、カタログはチームが使用するモデルのガバナンスの効いた需要に関するものだということです。ガバナンスの問題に対して間違った方を選択すると、美しくバージョン管理されたアーティファクトストアが手元に残るものの、OpenAIへの請求に対する制御は全く効かないという結果になります。
カタログがない場合、モデルの使用は有機的に拡大します。一見健全に思えますが、実はこれこそが問題なのです。以下の3つの障害モードが発生し、それらが複合化していきます。
シャドーモデル。 エンジニアが新機能をリリースするために新しいプロバイダーを追加します。機能するため、そのまま残されます。誰も承認しておらず、セキュリティのレビューも受けておらず、いかなるインベントリにも記載されていません。これを1年間すべてのチームに当てはめると、誰も全容を把握できない未知の連携の群れができあがり、そのそれぞれが潜在的なデータ流出経路となります。目に見えないものをガバナンス管理することはできません。
予想外の請求。 各サービスが独自のAPIキーを保持していると、支出は共通のタグがないままプロバイダーの請求書全体に分散されます。毎月の請求書は1つの大きな金額として届き、詳細な調査なしには「どのチームが40%の増加を引き起こしたのか?」という問いに誰も答えることができません。帰属が特定できないコストは制御することができません。これこそがAI向けFinOpsの根幹をなす前提です。
コンプライアンスギャップ。 これはキャリアを終わらせかねない深刻な問題です。ガバナンスが効いていない統合によって、EUのお客様のデータが米国リージョンで動作するモデルに送信され、データ居住性の規定に違反してしまうケースがあります。あるいは、PII(個人識別情報)を含む生プロンプトがパス上で匿名化されずにプロバイダーに到達したり、アプリケーションが機密情報(シークレット)をプロンプトに漏洩させ、それがプロバイダー側でログ記録されたりします。これらのギャップはすべて、アプリケーションとモデルの間に適用ポイント(強制力を持つポイント)が存在しないために発生します。
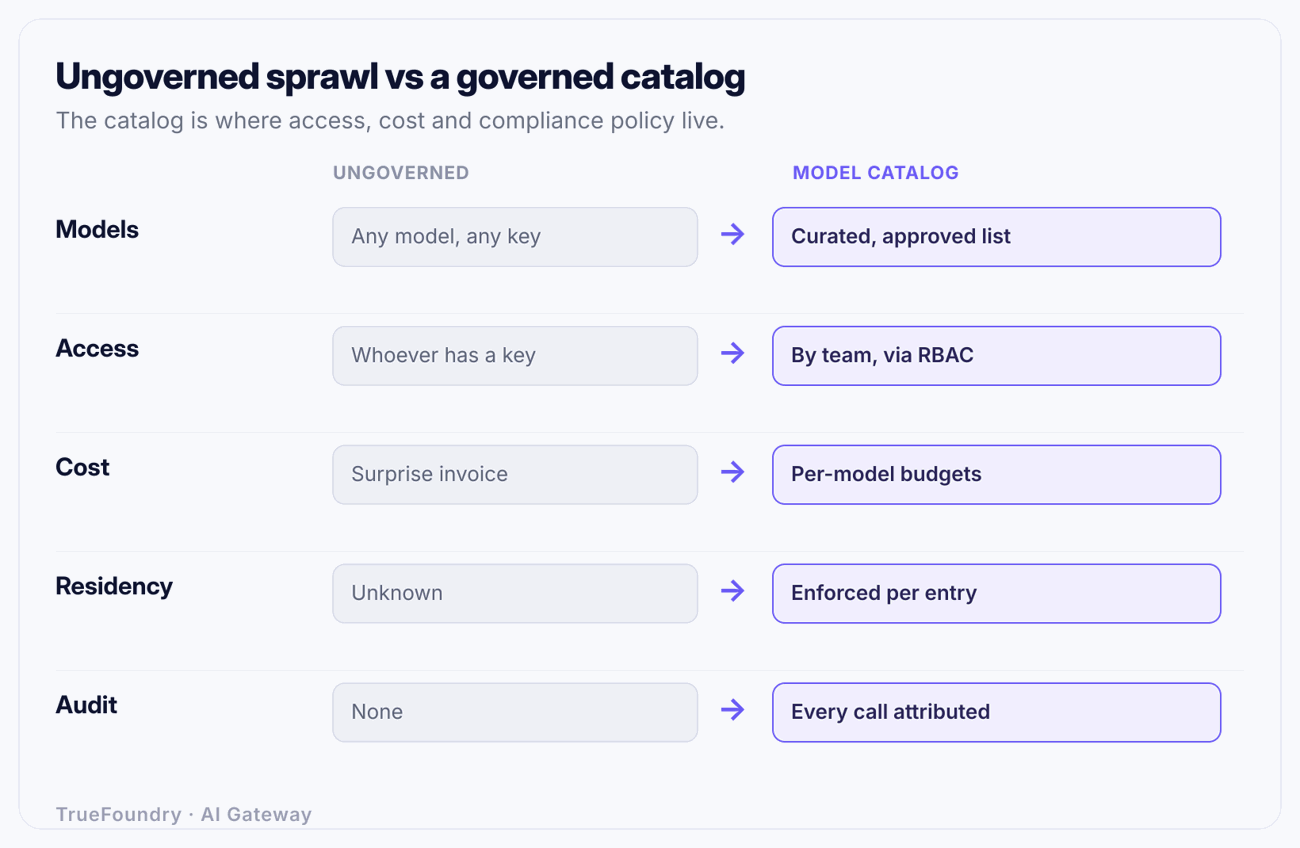
共通する根本的な原因は、チョークポイント(関門)の欠如です。アプリとプロバイダーを直接接続すると、使用状況の可視化、コストの帰属特定、ポリシーの強制を一元的に行う場所がなくなります。ゲートウェイ上に実装されたカタログは、チームからモデルの選択肢を奪うことなくそのチョークポイントを再導入します。チームは承認・統制されたモデルのセットから、セルフサービスでモデルを利用できます。
TrueFoundryがすべてのモデルにアクセス、コスト、居住性ポリシーを付加する方法をご覧ください。デモを予約する。
カタログの有用性はポリシー適用の厳格さに依存します。ドキュメント管理ではなくAI gateway内にカタログを置くべき理由はまさにそのポリシー適用のためにあります。構造的には、これはLLMプロキシが提供するチョークポイントと同じです。すべてのリクエストが1つの場所を通過するため、すべての呼び出しにポリシーを適用できます。
カタログがゲートウェイ内にある場合、1回のリクエストで何が起きるかを説明します。サービスが論理モデルsupport-assistantを呼び出すと、ゲートウェイは以下の処理を行います。
support-assistantのアクセスリストに含まれているか確認します。許可されていない場合、リクエストは拒否されます。これらの各ステップは、呼び出し元サービスのコードではなく、エントリのポリシーを参照します。ここが重要なポイントです。アプリケーションは名前を送信し、ゲートウェイはその名前に紐付けられたすべてのポリシーを強制します。カタログ内のバインディング(新しいモデルバージョン)またはポリシー(予算の削減、ガードレールの追加)を変更すれば、アプリケーションを変更することなく次のリクエストからそれが適用されます。
この仕組みにより、カタログはガバナンスツール全体で管理される制御の一元的な実行場所となります。レート制限と予算の詳細はLLMトークンレート制限と予算で、予算管理を意味あるものにする帰属特定はLLMコスト帰属特定とチーム予算で、安全対策チェックはAI guardrailsで、居住性の強制はデータ居住性で説明されています。カタログはこれらのポリシーを特定のモデルに紐付ける場所であり、より広範なAI governance toolsに組み込まれます。
TrueFoundryはまさにこれを実現します。各論理モデル名が独自のアクセス制御、予算、レート制限、居住性、ガードレールを持ち、すべてのリクエストにおいてゲートウェイで強制され、リクエストごとにユーザー、チーム、モデルでタグ付けされた可視性を提供します。データプレーンは自社VPC、オンプレミス、エアギャップ環境で実行できるため、居住性はダッシュボード上の単なる約束ではなく、トラフィックが物理的に流れる場所の特性として担保されます。
具体的には、support-assistantのエントリは次のようになります:論理名support-assistant、特定のプロバイダーモデルバージョンに紐付け、アクセス権はSupportチームとCXチームに限定、月間予算2,000 USD、チームあたり50,000トークン/分のレート制限、居住性はEUに固定、ガードレールとして入力・出力の両方でPII匿名化とプロンプトインジェクション検知を有効化。Supportチームのデベロッパーがsupport-assistantを呼び出すと、プロバイダー、リージョン、制限を意識することなく、ガバナンスが適用されたモデルを利用できます。一方、同じ名前を呼び出した別のチームのデベロッパーは拒否されます。これがセルフサービスとガバナンスの両立です。
以下は、小規模ながら現実的なカタログの例です。各行は1つの論理エントリを表し、列はそのエントリにバインドされたポリシーを示します。数値は例示です。
横の行を読み進めれば、そのモデルに関するすべてのガバナンスの問い(誰が、いくらで、どのくらいの速度で、どこで、どれだけ安全に使えるか)に答えることができます。縦の列を読み進めれば、すべてのモデルにわたる単一の次元を監査できます(例:「どのモデルがEUに固定されているか」など)。この双方向の解読可能性こそがカタログを導入するメリットであり、散在するAPIキーの山では決して実現できないことです。
カタログとレジストリの混同: モデルレジストリを立ち上げてすべてのバージョン管理を完璧に行っても、OpenAI APIを誰が呼び出しているか、コストがいくらかかっているかを制御することはできません。レジストリは自社で訓練するアーティファクトを統制するものであり、利用する外部モデルへのアクセスを統制するものではないからです。ツールを選ぶ前に、どちらの課題を解決したいのかを整理してください。
カタログを静的なリストとして扱う: Wiki上の「承認済みモデルページ」はカタログではありません。誰にも強制されない単なるドキュメントです。価値があるのは、すべてのリクエストに対する適用と強制力です。リストが無権限の呼び出しや居住性違反のプロンプトをブロックしないのであれば、それは制御ではなくただの「推奨事項」に過ぎません。
モデル名ではなくアプリケーションコードにポリシーを付加する: 各サービスに予算チェックやリージョンの設定をハードコードしてしまうと、散在し、一貫性がなく、監査不可能なポリシーになり、誰かが追加を忘れた瞬間に設定が乖離します。ポリシーはカタログ内の論理モデルにバインドし、すべての呼び出し元がそれを継承し、変更を一元的に反映できるようにしてください。
コストのみを管理し、データを管理しない: 予算やレート制限の管理は比較的容易です。真に致命的でコストがかさむ失敗は、データがリージョンを超えたり、PIIが匿名化されずにプロバイダーに届いたりするコンプライアンス上の失敗です。コストのみを制御し、居住性やガードレールを制御しないカタログは、キャリアを揺るがすようなリスクを放置することになります。
リクエストごとの帰属特定が行われない: 呼び出し時点でユーザー、チーム、モデルごとに使用状況がタグ付けされていない場合、予算の強制は不可能になり、毎月の請求額はブラックボックス化します。帰属特定は、後からプロバイダーの請求書を再構築するのではなく、リクエストが流れる場所、すなわちゲートウェイで行う必要があります。
モデルカタログは、「どのモデルが使用許可されており、どのようなルールに従うべきか?」という誰も答えられなかった質問を、統制され強制力のあるリストへと変化させます。各エントリは、独自のアクセス制御、予算、レート制限、居住性、ガードレールを保持する論理モデル名であり、ポリシーが名前にバインドされているため、1箇所変更するだけで全呼び出し元に即座に反映されます。重要なのは、カタログはモデルレジストリではないということです。前者は利用するモデルへのアクセスを統制し、後者は自社で訓練するアーティファクトのバージョン管理を行います。
ゲートウェイに実装する理由は、強制力にあります。Wiki上のリストは意図を記録するにとどまりますが、すべてのリクエストが通過するチョークポイントにあるカタログは、未承認の呼び出しを実際に拒否し、予算を超過したチームをスロットリングし、EUデータをEU内に保持し、PIIが外部に出る前にマスキングします。これにより、請求書や監査で問題が発覚するのを防ぎ、コスト、アクセス、データ居住性、安全性を制御しながら、チームにモデルへのセルフサービスアクセスを提供できます。
1つのカタログからチームが使用できるモデルをガバナンスします。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












