


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
過去3年間にリリースされたほぼすべてのLLM製品のAPIを確認すると、modelフィールド、messages配列の{role, content}オブジェクト、およびtemperatureを含むリクエストを受け取り、トークン数をカウントするusageブロックを持つchoices配列を返す仕様が多く見られます。このデータ構造は標準化団体によって作成されたものではなく、OpenAIのChat Completions APIに由来するものが定着した結果です。
プラットフォームチームにとって、「OpenAI互換」は極めて重要な意味を持ちます。この互換性があるおかげで、金曜日に新しいオープンウェイトモデルを評価し、アプリケーションを書き換えることなく月曜日には本番トラフィックに適用できます。一方で、この表現は過度な期待を持たせる側面もあります。2つのエンドポイントが共に「OpenAI互換」であっても、ツール呼び出しの返却方法、トークンのカウント方法、および設定したパラメーターが実際に機能するかどうかにおいて、挙動が異なる場合があります。
本記事では、この標準の実際の定義、互換性が保証する範囲と保証しない範囲、そして一部のみ互換性を持つ複数のプロバイダーを、単一のエンドポイントとして安定運用するためのゲートウェイの役割について解説します。
フェイルオーバーやコストトラッキング機能を備えた、あらゆるプロバイダーに対応する単一のOpenAI互換エンドポイントの活用に関心のある方は、デモをご予約ください。
標準規格が普及する理由は主に2つあります。標準化団体によって指定されるか、あるいは最初に登場して他が検討される前に普及するかです。Chat Completionsスキーマは明らかに後者に該当します。
OpenAIは/v1/chat/completionsエンドポイントを公開し、それをラッパーした公式のPythonおよびJavaScript SDKを提供しました。これらのSDKは、チュートリアル、スターターテンプレート、フレームワーク統合、および本番コードベースに組み込まれていきました。競合プロバイダーが実用的なモデルを提供する頃には、APIインターフェースは実質的に標準化されており、何百万行ものコードがすでにclient.chat.completions.create(...)の呼び出し方を前提として記述されていました。
これにより、新しいプロバイダーには2つの選択肢が生まれました。独自のAPIを設計してエコシステム全体に新しい仕様を学んでもらうか、それともOpenAIのスキーマを実装して既存のSDK、フレームワーク、ツールのエコシステムをそのまま活用するかです。ほぼすべてのプロバイダーが後者を選択しました。オープンウェイトの推論スタックもこの仕様を採用したため、その上で実行されるモデルは既存のコードから即座にアクセス可能となりました。その結果、仕様書のない事実上の標準が形成されました。つまり、現在のスキーマは「OpenAI SDKが送信し、返却を期待する構造そのもの」となっています。
そのため、この言葉の意味を正しく把握しておく必要があります。互換性は単なる利便性の機能ではなく、エコシステムへの参入条件であり、モデル選択におけるシステム構成の設計に影響を与えます。
互換性の基本的な要件は、エンドポイント、リクエスト形式、レスポンス形式、およびストリーミングの4点に関する標準仕様に基づいています。
エンドポイント。互換性のあるサービスは、Authorization: Bearer <key>ヘッダーを含むPOST /v1/chat/completionsを受け付けます。多くは/v1/models、/v1/embeddings、および/v1/completionsも実装しています。ベースURLはプロバイダーごとに異なりますが、パスは共通です。
リクエストの形式。最小構成として、model文字列、およびrole(system、user、assistant、tool)とcontentを持つオブジェクトのmessages配列が必要です。クライアントが送信できるオプショナルなパラメーターには、temperature、top_p、max_tokens(新しいOpenAIモデルではmax_completion_tokensを使用)、stream、stop、tools、tool_choice、およびresponse_formatが含まれます。
レスポンスの形式。choices配列を含むJSONオブジェクトです。各選択肢にはindex、roleとcontentを含むmessage(およびモデルが関数を呼び出す場合のtool_calls)、そしてfinish_reason(stop、length、tool_calls、content_filter)が含まれます。usageオブジェクトは、prompt_tokens、completion_tokens、およびtotal_tokensを出力します。
ストリーミング。stream: trueを使用する場合、レスポンスはServer-Sent Eventsのtext/event-streamとなります。各data:行には、差分トークンを保持するchoices[].deltaを含むチャンクが含まれます。ストリームは文字列data: [DONE]で終了します。
互換性の具体的なメリットを示します。以下のリクエストボディはOpenAIを対象としています。
POST https://api.openai.com/v1/chat/completions
Authorization: Bearer sk-...

{
  "model": "gpt-4.1",
  "messages": [
    {"role": "system", "content": "You are a terse assistant."},
    {"role": "user", "content": "Summarize MCP in one sentence."}
  ],
  "temperature": 0.2,
  "stream": false
}
互換エンドポイント経由で、同じプロンプトを別のプロバイダーに対して実行する場合、変更するのはベースURLとmodelの値の2点のみです。messages、temperature、およびstreamの各フィールドは変更しません。choices[0].message.contentやusage.total_tokensを読み取る解析コードも変更不要です。モデルの選択はコードの書き換えではなく、文字列の変更だけで完結します。
処理を実行したバックエンドに関わらず、レスポンスは以下の形式で返却されます。
{
  "id": "chatcmpl-...",
  "choices": [
    {"index": 0,
     "message": {"role": "assistant", "content": "MCP is an open protocol..."},
     "finish_reason": "stop"}
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 18, "total_tokens": 42}
}
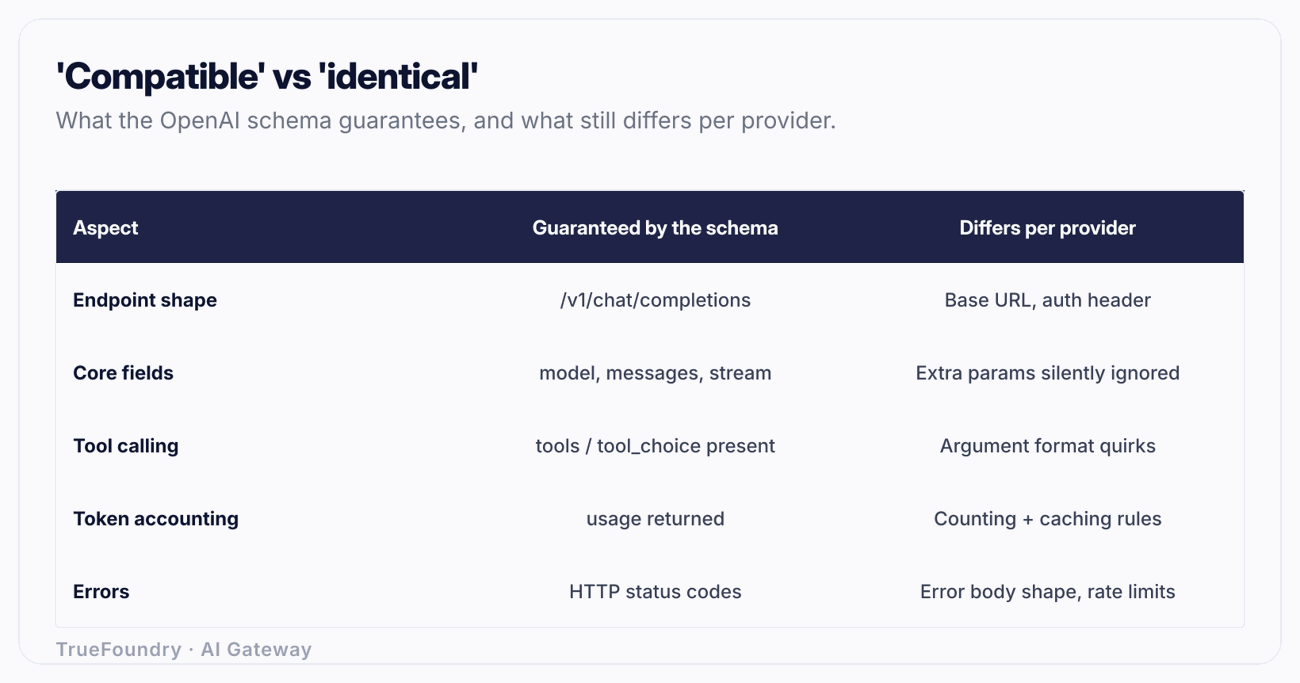
実運用の際に注意すべき点として、「OpenAI互換」はスキーマに関する定義であり、挙動の完全な一致を保証するものではありません。外枠の形式は共通していても、負荷がかかった際や特殊なケースにおいて内部の挙動に違いが生じることがあります。
ツール呼び出し仕様の違い。最も差異が生じやすい部分です。OpenAIはmessage.tool_calls内で関数呼び出しを返します。各項目にはid、type、およびargumentsが文字列化されたJSONオブジェクトであるfunctionが含まれており、解析を行う必要があります。互換バックエンドによっては、引数を解析済みのオブジェクトとして返したり、旧仕様の単一function_callフィールドを出力したり、ツール呼び出しの差分ストリーミング方法が異なったり、並列ツール呼び出しの処理に整合性がなかったりする場合があります。引数に対してJSON.parseを前提とした処理を行っている場合、すでに解析済みのオブジェクトを返すバックエンドではエラーが発生します。
トークン計算方法の違い。usageの計算は各プロバイダー独自のトークナイザーによって行われます。トークナイザーの仕様が異なるため、同じプロンプトを2つのモデルに送信してもprompt_tokensの結果は一致しません。さらに一部のバックエンドでは、フラグを設定しない限りストリーミングレスポンスでusageが完全に省略されるため、それ依存のコストトラッキング機能が正常に動作しない場合があります。
パラメーターが無効化されるケース。互換エンドポイントにseed、logit_bias、frequency_penalty、presence_penalty、またはresponse_format: {type: "json_schema"}を送信して200 OKを受け取った場合でも、該当パラメーターが内部的に無視されることがあります。スキーマ上許容されているため処理自体は受け付けられますが、バックエンドに機能が実装されていない場合があります。エラーが発生しないため原因の特定が難しく、seedに依存している不揮発的なパイプラインの動作が予期せず変化する原因となります。
システムプロンプトおよびロールの処理。バックエンドによっては、systemメッセージを最初のユーザープロンプトに統合したり、システムメッセージを1つしかサポートしていなかったり、空のcontentの扱い方が異なったりすることがあります。これにより、マルチターンの会話処理で挙動のずれが生じる可能性があります。
Finish-reasonの処理ロジック。モデルがツール呼び出しのために処理を停止する際、OpenAIはfinish_reason: "tool_calls"を出力します. 一部の backend では同じ文字列が使用されないため、これを分岐条件とする agent のループが破損します。
以下の表は、標準仕様によって確実に保証される機能と、プロバイダーごとに検証が必要な項目を分類したものです。
ここでの要点は「互換性は偽りである」ということではありません。「互換性によって 90% はそのまま利用できるが、残りの 10% はプロバイダーごとにテストする必要がある」ということです。その残りの 10% こそが、ゲートウェイによって吸収され、アプリケーション側で意識する必要がなくなる作業です。
TrueFoundry を使用して、アプリケーションコードを変更せずに名前でモデルを切り替える方法をご覧ください。デモを予約する。
すべてのプロバイダーがほぼ互換性がありつつも微妙に異なる場合、洗練されたアーキテクチャとは、アプリケーションが各プロバイダーと直接通信するのをやめることです。すべての前面に 1 つの OpenAI-compatible endpoint を配置し、そのレイヤーに変換と正規化を任せます。
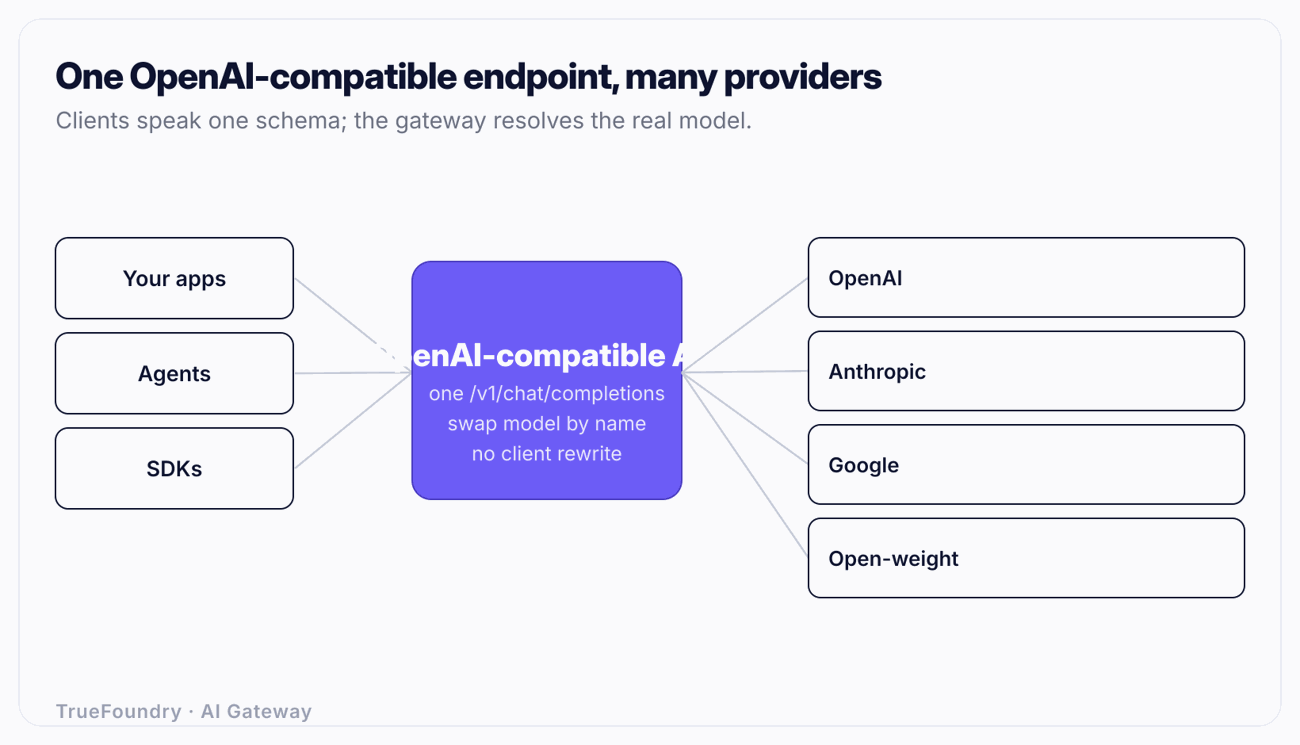
これが AI ゲートウェイの役割であり、構造的には LLM proxy と同じアイデアです。単一の論理的なフロントドアがあり、その背後に多数の backend が存在します。TrueFoundry は、すべてのプロバイダーの前面に統合された OpenAI-compatible API を提供します。アプリケーションは、使い慣れた Chat Completions の形式を送信し続けるだけです。モデルを切り替えるには、model の値をゲートウェイが解決する論理名に変更するだけです。リクエストボディ、SDK、パース処理など、その他のものはすべて変更されません。
ゲートウェイが上記のような違いを正規化するため、コード側で特定の backend が tool-call の引数を文字列化するか、ストリーム上で usage を報告するかどうかを気にする必要がなくなります。ゲートウェイは 1 つの一貫したダイアレクト(方言)を提供します。LiteLLM のようなオープンソースライブラリは、コード内でのこの変換レイヤーを普及させました。LiteLLM とは何かに関する説明で、そのアプローチとマネージドゲートウェイがさらに推し進める点について説明しています。
しかし、このパターンを採用する理由は、単にインターフェースを整理するためだけではありません。すべてのリクエストが 1 つの endpoint を通過するようになると、個別のプロバイダー統合が散在している状態では追加不可能な機能を解放できます。
ルーティング。 1 つの論理モデル名に対して複数の実際のターゲットを対応させることができ、ゲートウェイはレイテンシー、ウェイト、または優先順位に基づいてそれらを選択します。費用および品質を考慮したモデル選択については、LLM ルーターとは何かをご覧ください。
フォールバック。 プロバイダーが 500 エラーを返したりタイムアウトしたりした場合、ゲートウェイはリクエスト内でフォールバックターゲットに対してリトライを行うため、単一のプロバイダーの停止がユーザーへのエラーとして露出することはありません。これは LLM フォールバックのテーマです。
キャッシュ。 ゲートウェイでの完全一致および セマンティックキャッシュにより、繰り返される、またはほぼ重複するプロンプトのレイテンシーとコストの両方を、同じ endpoint の裏側で透過的に削減します。
可視性とコストの帰属。 すべてのリクエストが 1 つの場所を通過するため、リクエストごとにユーザー、チーム、モデルでタグ付けされたコスト、トークン、レイテンシーのメトリクスを取得でき、LLM 可視性および チーム予算へのコスト帰属に活用できます。プロバイダーごとの直接統合では、各プロバイダーに独自の計装を施さない限り、これらは一切得られません。
これらの機能のいずれも、新しい API を採用することを要求しません。これらは、すでに使用している 1 つのインターフェースに標準化することで得られたものです。選択肢を検討している場合は、AI ゲートウェイの選択方法で基準を説明しています。
この決定は信条によるものではありません。使用するプロバイダーの数と、復元性やコストの可視性をどれだけ重視するかによるものです。
直接統合が正当化されるのは、1 つのプロバイダーのみを呼び出し、今後も絶対に他のプロバイダーを呼び出さない場合に限られます。2 つ目のモデルが必要になった瞬間、障害に対する復元性が必要になった瞬間、あるいはコストの単一のソース・オブ・トゥルース(信頼できる唯一の情報源)が必要になった瞬間、ゲートウェイは投資に見合う価値を発揮します。
互換性がある=同一であると思い込む。 スキーマは一致していても、動作が常に一致するとは限りません。プロンプトをより安価な backend に移植し、「動作する」ことを確認してデプロイしたものの、数週間後に seed が無視されており出力の再現性がまったくなかったことに気づく、というケースがあります。実際に依存しているパラメータを各 backend に対してテストしてください。
ストリーミングを確認せずにコスト目的で usage を信頼する。 一部の backend は、明示的にリクエストされない限り、ストリーミングレスポンスで usage ブロックを省略します。これを基に構築されたコストダッシュボードは「ゼロ」と表示され、実際の請求書が届くまで問題ないように見えてしまいます。本番環境で実行する正確なリクエストスタイルで usage が存在することを確認してください。
プロバイダーごとにベース URL と SDK をハードコーディングする。 これでは、標準化によって排除するはずだった無秩序な分散が再現されます。新しいモデルが登場するたびに統合プロジェクトになり、プロバイダーの障害が自社の障害になってしまいます。1 つの endpoint に標準化し、モデルの選択をコードではなく設定にしてください。
形式をガードせずに tool-call の引数をパースする。 一部の backend は arguments を文字列として返し、他の backend はオブジェクトとして返します。検証なしの JSON.parse は後者で例外を発生させます。パースする前に形状を正規化するか、ゲートウェイに正規化を任せてください。
ゲートウェイを単なる配管として扱う。 endpoint 自体は簡単な部分です。価値は、ルーティング、フォールバック、キャッシュ、予算管理、コスト帰属など、1 つのチェックポイントによって可能になる機能にあります。これらは散在する N 個の直接統合に対して安価に後付けすることはできません。
OpenAI Chat Completions スキーマが標準となったのは、規制によるものではなく、最初に登場し、あらゆる場所で採用されたからです。「OpenAI-compatible」はそのエコシステムへの参加チケットです。使い慣れたリクエスト形状を送信し、使い慣れたレスポンスをパースします。互換性があるからといって同一ではないことを理解し、実際に依存している動作をテストしている限り、設定文字列だけでモデルを選択できるという巨大なレバレッジが得られます。
細かな問題に悩まされることなくこのレバレッジを得る最も洗練された方法は、すべてのプロバイダーの前面にある 1 つの OpenAI-compatible endpoint に標準化することです。アプリケーションはすでに知っているインターフェースを維持し、ゲートウェイはプロバイダーごとの固有仕様を吸収しながら、散在した統合には決して後付けできないルーティング、フォールバック、キャッシュ、予算管理、コスト帰属を追加します。1 つのインターフェースを入力とし、その裏にすべてのモデルを配置しましょう。
すべての LLM プロバイダーを、1つの OpenAI 互換 API のもとに統合します。 デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












