


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
Model Context Protocolは2026年に急速な進化を遂げ、多くのチームが追従するのが困難なほどでした。2025年11月のリリースに続く最初の主要リビジョンである2026-07-28仕様は、単に機能を追加しただけではなく、プロトコルの基盤を再構築しました。認可、トランスポート、ルーティング、インタラクションのすべてが変更され、広く使用されていた複数の構成要素が明確な廃止スケジュールとともに非推奨となりました。
単一のエージェントに直接接続された少数のMCPサーバーしか運用していない場合は、変更履歴を確認しながら独自のペースで移行を進めることができます。しかし、多数のチーム、サーバー、エージェントにわたってMCPを運用している場合、これらの変更は単なる変更履歴の更新にとどまらず、大規模な移行プロジェクトを意味します。特にトランスポートとルーティングに触れる変更は、運用しているすべてのクライアントに波及します。本記事では、実際に何が変更されたのか、なぜ各変更が行われたのか、そしてMCPを大規模に運用する企業やチームにとってそれが何を意味するのかを解説します。基礎的な概念については、当社のMCPゲートウェイとは何かの解説記事から読み始めることをお勧めします。本記事では、プロトコルの全体像をすでに把握していることを前提とし、新しいリビジョンによって何が廃止され、何が修正されたかに焦点を当てます。
新しいMCPトランスポート、認証、ルーティングを個々のクライアントではなく単一のコントロールポイントで管理したいとお考えですか?デモを予約する。
運用の観点において特に重要なのは5つの変更点です。本リリースのその他の変更はすべて、これら5点に伴って生じたものです。
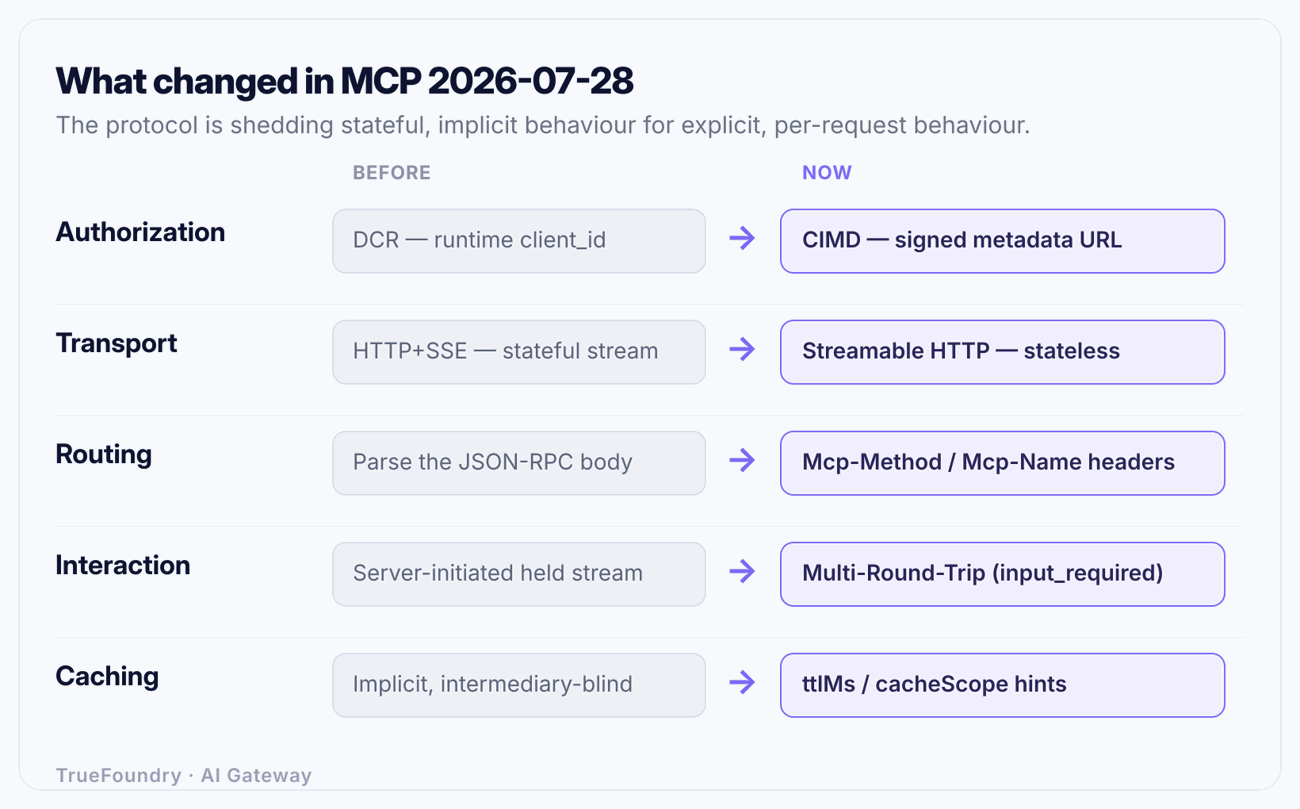
全体を通じて一貫した傾向が見られます。プロトコルは、ステートフルでストリームに依存する暗黙的な挙動を排除し、リクエストごとに明示的でヘッダーに露出する挙動へと移行しています。このシフトにより、新しいリビジョンはゲートウェイ、プロキシ、レートリミッターにとって扱いやすいものとなった反面、長期セッションを前提としていたクライアントにとっては対応が必要なものとなっています。
Dynamic Client Registrationは、クライアントが認可サーバーに対して動的に自身を登録し、実行時にclient_idを発行することを可能にしていました。これは利便性が高い一方で問題もありました。アクセスするすべてのクライアントに登録が許可されるため、管理が困難で無制限なアイデンティティの増加を招き、登録エンドポイントが常時攻撃の標的となるリスクを抱えていました。
2026-07-28リビジョンでは、DCRが非推奨となり、Client ID Metadata Documents(CIMD)が導入されました。識別子を取得するために登録を行う代わりに、クライアントは自身を記述した署名付きメタデータドキュメントを指すURLによって識別されます。認可サーバーは登録情報を保持するのではなく、そのドキュメントを取得して検証します。クライアントのアイデンティティは、サーバーが保存および管理する必要のあるデータではなく、クライアントが管理するソースからサーバーがオンデマンドで検証できるものになりました。
これに伴い、セキュリティ強化のための3つの関連変更が導入されています:
issパラメーターを返し、クライアントは認可コードを交換する前にそれを検証する必要があります。これにより、長年の課題であった認可サーバーの混同攻撃のリスクが解消されます。application_typeを宣言するため、サーバーが正当なデスクトップツールやCLIツールのlocalhostリダイレクトを誤って拒否することがなくなります。留意すべき点として、サーバーサイドでクライアント制御のURLを取得することは、構造上、攻撃者が影響を与え得るアドレスへのリクエストとなります。CIMDは登録エンドポイントのリスクを解消する代わりにSSRF(Server-Side Request Forgery)の検討事項を導入するため、これを実装する際は、信頼境界内からの他のアウトバウンドリクエストと同様の注意を払ってメタデータの取得を処理する必要があります。これらの障害モードの詳細についてはMCPのセキュリティリスクとベストプラクティスを、エージェント・サーバー間の認証の仕組みについてはMCP認証の解説を参照してください。
実務上の結論:新規インテグレーションをDCR上で構築しないでください。 DCRは非推奨であり、将来的に削除されます。代替となるCIMDの方がガバナンスに優れています。すでにDCRに依存している場合でも、少なくとも2027年7月までは利用可能ですが、移行は「行うかどうか」ではなく「いつ行うか」の問題です。
従来のHTTP+SSEトランスポートは正式に非推奨となり、1年間の移行期間が設定されました。代替となるStreamable HTTPは設計段階からステートレスであり、この特性が大きな影響をもたらします。
新しいトランスポートでは、initialize / initializedハンドシェイクやMcp-Session-Idが存在しません。各リクエストは自己記述的であり、プロトコルバージョン、クライアントのアイデンティティ、およびその機能情報がリクエストごとの_metaブロックに含まれて送信されます。また、オプションのserver/discover呼び出しにより、サーバーは事前に自身の機能を通知できます。すべてのリクエストが独立しているため、どのサーバーインスタンスでも任意のリクエストを処理できます。これにより、サーバーは通常のラウンドロビン型ロードバランサーの背後に配置し、スティッキーセッションを使用することなく水平スケーリングが可能になります。
ステートレス化の代償として、送信中に失われたリクエストは再開されません。 再接続可能なストリームは存在しないため、リクエストが途切れたクライアントは新しいIDで再発行する必要があります。そのため、実行時間の長いツールはべき等性を備えるか、クライアントがポーリングできる永続的なハンドルを返す必要があります。呼び出し間をまたぐ状態管理が消滅したわけではなく、それが明示的になっただけです。一般的には、ツールの引数として渡され、有効期限付きの共有ストレージに保持されるサーバー発行のハンドルとして管理されます。プロトコルレベルのセッションを廃止してもアプリケーションがステートレスになるわけではなく、状態管理の責任がトランスポートから開発者側へ移動したことを意味します。
この変更は通信回線そのものに関わるため、運用中のすべてのクライアントに影響を及ぼす可能性が最も高いものです。エージェントがそれぞれ独自のMCP接続を開いている場合、すべてのエージェントで新しいトランスポートへの対応が必要になります。一方で、ゲートウェイを経由している場合は、ゲートウェイがトランスポートを終端し、エージェントは単一の安定したエンドポイントと通信し続けることができます。これこそが、エージェントからサーバーへ直接接続させるべきではない理由であり、リモートMCPサーバーのホスティングに関する記事で解説している主要なメリットです。
インフラを運用する者にとって最もレバレッジの効く変更は、変更履歴の中で最もひそやかなものです。Streamable HTTPでは、Mcp-MethodすべてのリクエストにおいてMcp-Name、tools/call、resources/read、およびprompts/getが必要となりました。ツールパラメータには追加でx-mcp-headerをマークすることができ、準拠するクライアントはその引数をMcp-Param-{Name}ヘッダーにミラーリングします。典型的な例は、regionパラメータがルーティングヘッダーに昇格するケースです。
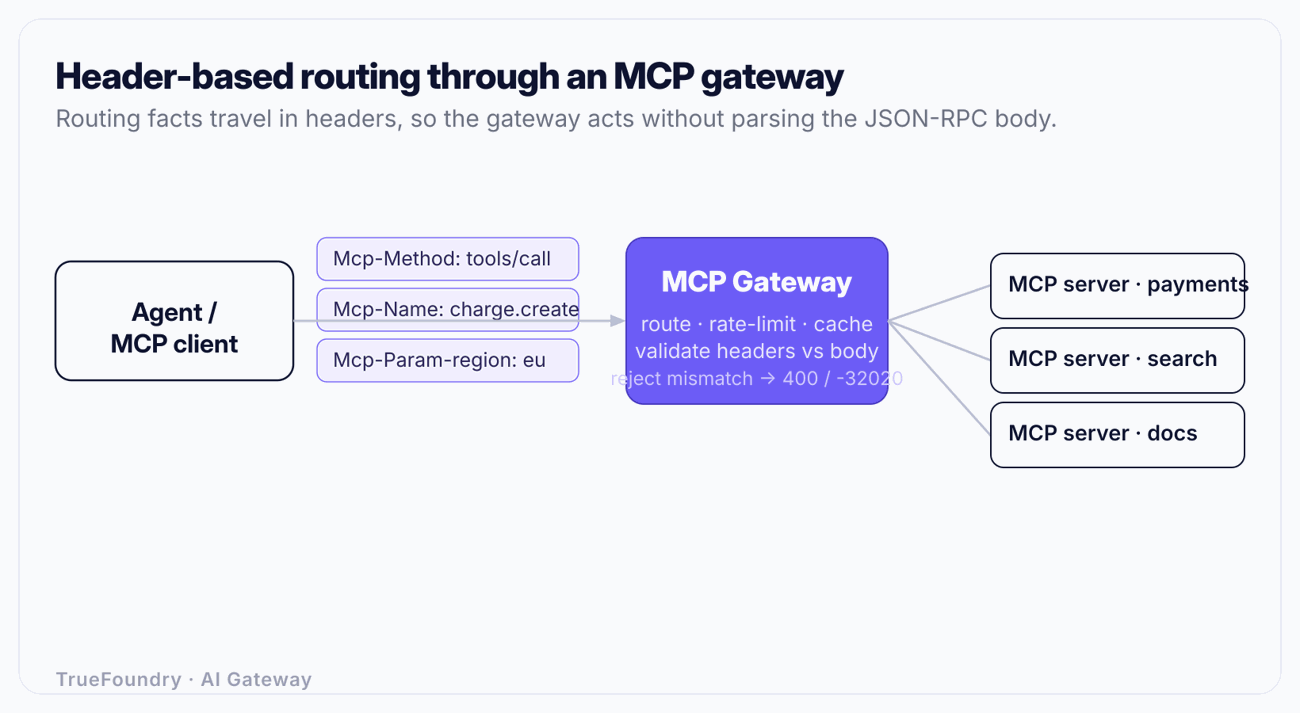
これまでは、ツールごとにルーティングやレート制限を行いたい仲介者は、すべてのリクエストのJSON-RPCボディを開いて解析する必要がありました。今やルーティング関連の事実はヘッダーに存在するため、ゲートウェイ、ロードバランサー、またはWAFが、ペイロードを理解することなく低コストで読み取り、アクションを実行できます。高負荷なツールへのtools/callを専用プールに送信したり、名前で特定のツールをレート制限したり、regionヘッダーによってテナントのトラフィックをルーティングしたりすることが、すべてエッジで可能になります。
スキップしてはならないルールが1つあります。ヘッダーとボディは一致していなければなりません。ボディを処理するサーバーは、ヘッダーが一致していることを検証し、不一致の場合は400およびエラーコード-32020で拒否する必要があります。ボディを書き換える仲介者はヘッダーも書き換えるか、両方とも書き換えないかのいずれかにしなければなりません。また、ゲートウェイはヘッダーをボディに対して検証した後にのみ、そのヘッダーを信頼すべきです。ヘッダーベースのルーティングが強力であるのは、まさにリクエストパスの早い段階で信頼されるからであり、それゆえにその場所で検証されなければならないのです。
TrueFoundry MCP Gatewayがどのように仕様変更を吸収し、エージェント側での対応を不要にするかをご覧ください。デモを予約する。
以前は、呼び出しの途中で入力(エリシテーション、サンプリングリクエスト、ルート一覧の取得など)を必要とするサーバーは、オープン状態を維持したストリームを介してそれを行っていました。ステートレスな世界にはオープン状態を維持したストリームは存在しないため、2026-07-28リビジョンでは、これらのサーバー主導の呼び出しをMulti-Round-Trip Requests (MRTR)に置き換えます。サーバーは必要なものを説明する型input_requiredの結果を返し、クライアントはinputResponses内の回答と、サーバーが再開できるようにするrequestState blobを使用して元の呼び出しを再試行することで応答します。
再試行は異なるサーバーインスタンスに到達する可能性があるため、再開パスはその方法でテストする必要があり、入力が収集される前に実行された副作用は調整(レコンシリエーション)が必要です。MCPにはExactly-Once(正確に1回)の保証はありません。これとは別に、Roots、Sampling、およびLoggingは非推奨となり(少なくとも12か月間は動作し、削除は2027年7月以降)、Tasksはポーリングベースのモデルを備えた拡張機能に移動し、list/readレスポンスにはttlMsおよびcacheScopeヒントが含まれるようになりました。これにより仲介者が安全にキャッシュできるようになります。このキャッシュヒントには罠が存在するため、以下で説明します。
このリリースでは拡張機能フレームワークも形式化されており、プロダクトチームにとって最も重要となる可能性が高いのはMCP Apps (io.modelcontextprotocol/ui)です。これは対応するホストによってレンダリングされる対話型UIサーフェスです。これまでのMCPサーバーはテキストと構造化データを返していましたが、MCP Appsを使用すると、対応するホストがインラインでレンダリングする対話型サーフェスを返すことができ、ツール呼び出しを埋め込み型ミニアプリケーションに近いものに変換できます。
これは真に新しい機能であり、真に新しいガバナンスの対象です。UIを提供できるサーバーは、認証情報を要求したり、確認画面を紛らわしく表示したり、ホストが予期しなかったコンテンツをレンダリングしたりするUIを提供できます。そのため、サーバーのツールに適用するのと同様の精査を、サーバーがレンダリングできるあらゆるものに拡張する必要があります。MCP Appsは拡張機能であり、その成熟度はコア仕様とは別に追跡され、ホストのサポートも一様ではないため、確定したものというよりは新しい技術として扱ってください。プラットフォームチームにとってのポイントはよりシンプルです。「MCPサーバー」の攻撃面およびポリシー面が拡大したため、ツールに適用しているレビューや許可リストは、アプリにも適用できるように準備しておく必要があります。
2026-07-28の変更内容を総合的に見ると、プロトコルは中間層(インターミディエタリ)がスマートにガバナンスを行える方向へと進んでいます。ステートレスなリクエスト、ヘッダーで確認可能なルーティング情報、明示的なキャッシュヒント、そして検証可能なクライアントアイデンティティは、1年前よりもコントロールポイントで強制しやすくなりました。これこそが、エージェントとMCP serverを直接接続するのではなく、その間にゲートウェイを配置すべき理由です。
ゲートウェイは、新しいトランスポートを一度終了させ、CIMDベースの認証を一度検証し、Mcp-Nameルーティングとツールごとのレート制限を強制し、どのserverが存在し誰がアクセスできるかというレジストリを実際に管理する場所です。仕様が再び改訂された場合(必ず改訂されます)、ゲートウェイを指向するクライアントを変更する必要はなく、ゲートウェイ自体を変更するだけで済みます。TrueFoundryのMCP gatewayはまさにこのコントロールポイントを中心に構築されており、そのガバナンスモデルはenterprise MCP governanceおよび製品ドキュメントで詳しく説明されています。

中央集権的なMCP gatewayの導入と、各チームによる独自serverの管理のどちらを検討している場合、そのトレードオフについてはbest MCP gatewaysの比較でまとめています。また、MCPの範囲とエージェント間通信(agent-to-agent)の開始点に関するプロトコル同士の疑問については、MCP vs A2Aで解説しています。
新しいコードで非推奨のプリミティブを採用してしまう。 DCR、Roots、Sampling、Loggingはすべて現在も動作するため、利用しても問題ないように見えます。しかし、これらは将来的に削除されるカウントダウンに入っています。新しい統合では、これらを使用禁止として扱う必要があります。
検証していないヘッダーを信頼してしまう。 ヘッダーベースのルーティングが機能するのは、ボディより前にヘッダーが読み取られるからです。ボディと照合して検証することなくMcp-Nameに基づいてルーティングを行い、不一致を400 / -32020で拒否しないゲートウェイは、ルーティング層ではなく「ルーティングバイパス(回避路)」を作っていることに他なりません。
テナントデータを誤ってpublicとしてキャッシュ可能にしてしまう。 新しいcacheScopeヒントは便利ですが危険でもあります。プリンシパル固有またはテナント固有の結果をpublicとマークすると、中間層が誤った認可コンテキストに対してその結果を返してしまう可能性があります。テナントスコープのレスポンスをpublicに設定してはなりません。
ステートレスを「状態が存在しない」ことだと誤解している。 ステートレス性とはスタックの上層に移動しただけであり、消失したわけではありません。ツールが呼び出し間で横断的な状態を持つ場合、その状態には明示的なハンドルと永続ストレージが必要になります。さもなければ、リトライが異なるインスタンスにルーティングされた際に静かに破綻します。
エッジではなくクライアントごとに移行している。 新しいトランスポートをすべてのエージェント、SDK、スクリプトに手動で展開していくのは、時間がかかりエラーを誘発しやすい方法です。ゲートウェイで一度集約して終了させるのが最も迅速な方法です。
システム障害を最小限に抑える手順は、おおむね次の通りです。まず非推奨機能の利用拡大を止め、トランスポートを移行し、その上で新しいルーティング機能を活用します。
2026-07-28仕様は、単なる機能追加ではなく、アーキテクチャの根本的な刷新(リプランビング)です。DCRはCIMDへと移行し、HTTP+SSEはステートレスなStreamable HTTPに取って代わられ、ルーティングはヘッダー内で行われるようになり、elicitation(情報引き出し)はマルチラウンドトリップ化し、サーバーはUIを配信する能力を獲得します。それぞれの変更自体が理にかなっており、これらが組み合わさることで、中間層(仲介者)が厳格に管理可能なものへとMCPを押し進めます。ただし、それは誰かがその中間層を運用している場合に限られます。
これが今回のリリース全体の密やかな結論です。仕様は、MCP serversの前にコントロールポイントを置くことが、単なるオプションの利便性ではなく、トランスポート、認証、ルーティング、キャッシュポリシーが存在すべき自然な場所であるという世界へと収束しつつあります。そのコントロールポイントを一度配置してしまえば、次の改定はフリート全体に及ぶ移行ではなく、設定の変更だけで済むようになります。
次の仕様改定が届く前に、MCP server の前にコントロールポイントを設置しましょう。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












