


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
「どのモデルが一番優れているか?」という問いは間違った問いであり、静かにチームのコストを増大させています。誠実な回答をするならば、フロンティアモデルとは値札がついたツールであり、適切なツールは「それに何を依頼するか」によって決まるということです。商品レビューの分類ジョブを最高峰の推論モデルに送信するのは、絵額を壁に掛けるためにクレーンをレンタルするようなものです。機能はします。しかし、必要以上の40倍のコストがかかり、速度も低下します。
2026年後半までに、フロンティア領域は複数のティア(階層)へと広がりました。すべての主要ベンダーは少なくとも3つのモデルを出荷しています。高度な推論に特化した「フラッグシップモデル」、価格とスループットのバランスに優れた「ミッドティアの主力モデル」、そして高速かつほぼコストがかからない「スモールモデル」です。もはや興味深い決断は「OpenAIかAnthropicか」ではありません。「どのティアを、どのリクエストに、どのコストで、どのようなフォールバックを設定して使用するか」です。これはルーティングの問題であり、ルーティングの問題は特定ブランドへの忠誠心ではなくポリシーによって解決されます。
本記事では2つのことを行います。第1に、各モデルが実際に何を得意としているかを中心に整理したベンダー別のガイドです。第2に、タスクタイプをモデルティアとコスト姿勢にマッピングする意思決定フレームワークと、プロバイダーが新しいバージョンを出荷するたびにアプリを書き直すことなく、AI Gatewayによってそのフレームワークを実行する方法の解説です。
タスクとコストに応じて各リクエストを適切なモデルにルーティングしたいですか? デモを予約する。
ベンチマークは固定されたテストでモデルを測定します。しかし、本番環境のトラフィックは固定テストではありません。低コストで反復的な呼び出しの大量トラフィック(請求書番号の抽出、チケットの分類、実行するダウンストリームプロンプトの決定など)と、真に高度なリクエストの少量のストリーム(5つのファイルにわたるレース条件のデバッグ、200ページの契約書に基づく推論など)が混在しています。単一の「最善のモデル」を採用すると、高度なストリームに合わせて価格とサイズが設定されるため、大量の単純リクエストに対して過剰な支払いをすることになります。
単一モデル思考が高コストにつながる3つの要因:
抜け出す方法は、モデル選択を構成(設定)として扱うことです。ポリシーを一度決定し(「抽出は安いティアに、コーディングはミッドティアに、高度な推論はフラッグシップに昇格させ、エラー発生時はすべてセカンドプロバイダーにフォールバックする」)、それをゲートウェイで表現すれば、コードを出荷することなく変更できます。その仕組みの詳細については、LLMルーターとはおよびコストと品質を意識したモデル選択を参照してください。
以下に記載されている数値のうち、第一者(当事者)として確認されているのはClaudeの数値のみです。その他の数値はすべて2026年11月時点のサードパーティのレポートから集約されたものであり、依存する前にプロバイダー自身の価格設定およびモデルページで確認する必要があります。モデルの仕様は頻繁に変更されます。
Claudeの2026年後半のラインナップは、1Mトークンのコンテキストウィンドウ、128Kの出力、および2026年6月のトレーニングカットオフで動作します。ティアは明確です:
ここで役立つパターンは3方向の分割です。ほぼ無料のスモールモデル、バランスの取れた主力モデル、そしてプレミアムなエージェント型モデルです。これら3つの役割から、ほぼすべてのルーティングポリシーを構築できます。
OpenAIのGPT-6世代も同じティア構造に従っていると報告されています。GPT-6 Astraは$10 / $50と報告されており、トップティアの推論向けと位置付けられています。GPT-6.1 Solは$2 / $10と報告され、ファミリーの中で最も強力なコーディングおよび研究モデルと説明されており、Coding Indexは約54と報告されています。2026年10月26日頃にリリースされたとされるGPT-6.1 Terraは、$1 / $5と報告されており、約1.05Mのコンテキストと48に近いCoding Indexを備えているとされ、Solのコーディング機能の大半をSolの約半分の価格で実現します。GPT-6 Lunaは$0.10 / $0.50と報告されており、大量の分類およびルーティングモデルであり、Coding Indexは約31と報告されています。
これらのCoding Indexの数値は、精密なものではなく方向性を示すものとして読み取ってください。サードパーティの集計に基づくものであり、変動する可能性があります。
Googleのラインナップは、レポート間で不一致があるため最も特定が困難です。Gemini 3.1 Proは$2 / $12と報告されており、最も困難な推論を目指しています。2026年7月頃にリリースされたとされるGemini 3.6 Flashは、$1.50 / $7.50と報告されており、1Mコンテキストウィンドウ、約50と報告されるIntelligence Index、約58.7%とされるSWE-Bench Pro、秒間約280トークンと報告されるスループットを備え、高機能でありながら安価なコーディングの主力モデルとして位置付けられています。Gemini 3.1 Flash-Liteは、最下位ティアとして$0.25 / $1.50近くで報告されています。アカウントで3.6 Flashを確認できない場合の安全なフォールバックは、一般提供されているGemini 3.5 Flashです。
Grokのバージョン管理は未定です。およそ$1.25 / $2.50のGrok 4.3が最も引用される構成であり、その低い出力価格が顕著です。より新しいGrok 4.6およびGrok 5のバージョンも報告されていますが、確定していません。バージョンは確定していないものとして扱い、本番トラフィックをルーティングする前にxAIと直接確認してください。
セルフホストしたいチームやコストを限界まで下げたいチーム向け: Meta Llama 4 Maverickは$0.20 / $0.60周辺、Scoutは$0.11 / $0.34周辺と報告されており、どちらもオープンウェイトでセルフホスト可能です。DeepSeek V4は、約$0.22から$0.66の範囲で報告されており、コスト効率の高い推論とコーディング向けに位置付けられています。Mistral Large 3は約$0.50 / $1.50と報告されています。これらは、データ居住性や純粋なユニットエコノミクスが決定を左右する場合に最も重要となります。
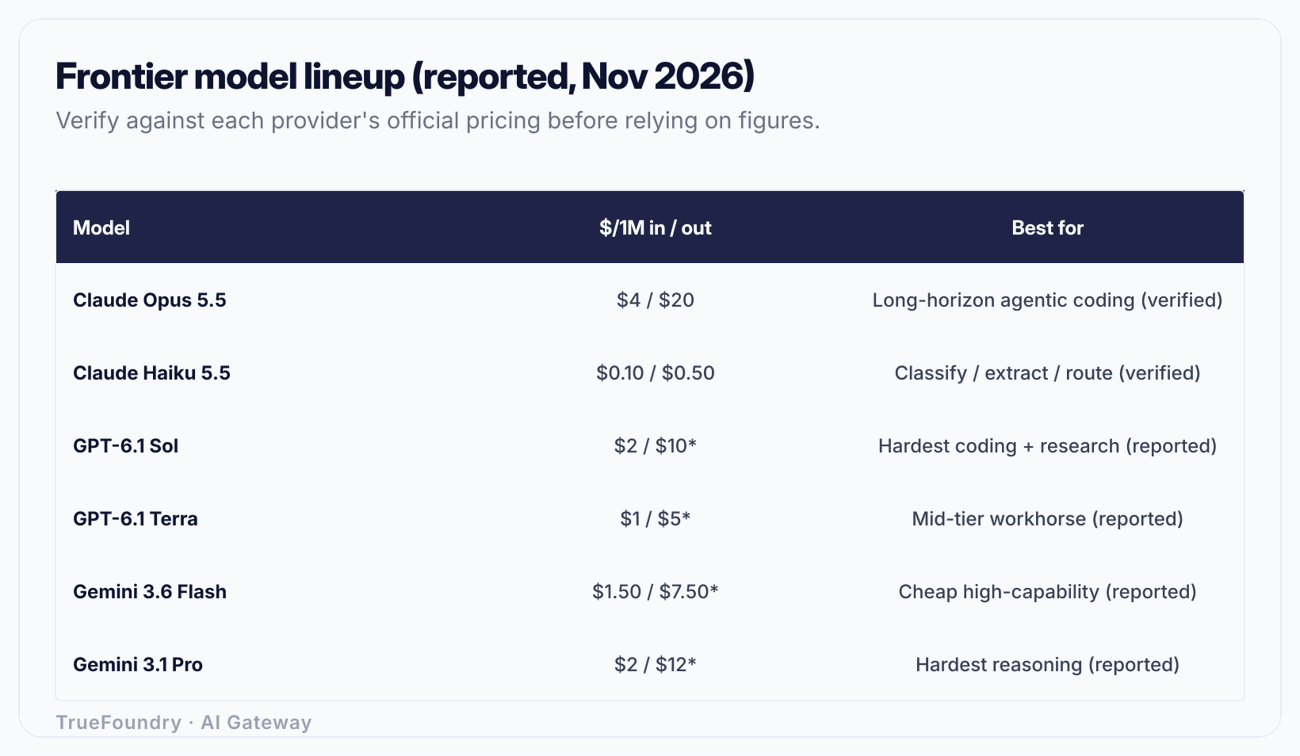
価格設定/ベンチマークは2026年11月時点の報告に基づくものです。依存する前に各プロバイダーの公式価格設定ページで確認してください — モデル仕様は頻繁に変更されます。
単一のモデルの選択をやめましょう。トラフィックを分類し、各クラスをティアとコスト姿勢に紐付けることから始めてください。4つのカテゴリでほぼすべてをカバーできます。
これらは大量かつ曖昧性の低いジョブです。チケットへのラベル付け、ドキュメントからの日付の抽出、実行するプロンプトブランチの決定などです。これらにフラッグシップモデルは不要です。入力トークン100万個あたり約$0.10から$0.25のスモールモデル(Haiku 5.5、GPT-6 Luna、Gemini 3.1 Flash-Lite)で対処でき、出力が短いためリクエストごとのコストは極めて小さくなります。コスト姿勢: 最小化。 ここで安価なティアにルーティングすることがコスト削減の大きな効果を生みます。
ユーザー向けのチャットには適度な品質と低いレイテンシが必要ですが、最も深い推論が必要になることは稀です。ミッドティアモデル(Sonnet 5.5、GPT-6.1 Terra、Gemini 3.6 Flash)が最適なポイントです。コスト姿勢: バランス。 チャットは大量のトークンを生成するため、特に出力価格に注意してください。
モデルが計画を立て、ツールを呼び出し、ファイルを読み取り、ターンにわたって目標を維持するマルチステップのコーディングは、機能の差が顕著にあらわれる分野です。最も困難なエージェントワークには、Opus 5.5が確認済みの強力なデフォルトであり、GPT-6.1 Solも強力な同等モデルとして報告されています。長期間の視点を必要としない日常的なコーディングには、ミッドティアモデル(Terra、Gemini 3.6 Flash、Sonnet 5.5)が通常、ごくわずかなコストで90%同等のパフォーマンスを発揮します。コスト姿勢: 難易度に応じたティア設定。 定常的な編集はミッドティアにルーティングし、高度なエージェント実行を昇格させます。
法務分析、研究の合成、大規模ドキュメントに基づく推論。これこそがフラッグシップモデル(Astra、Gemini 3.1 Pro、最高負荷にはOpus 5.5またはFable 5.1)の料金を支払うべき唯一の場所です。コスト姿勢: 品質に投資するが、ゲートを設ける。 このティアに到達させるのはトラフィックのわずかな部分だけに限定すべきであり、そのゲートとなるのがルーティングルールです。
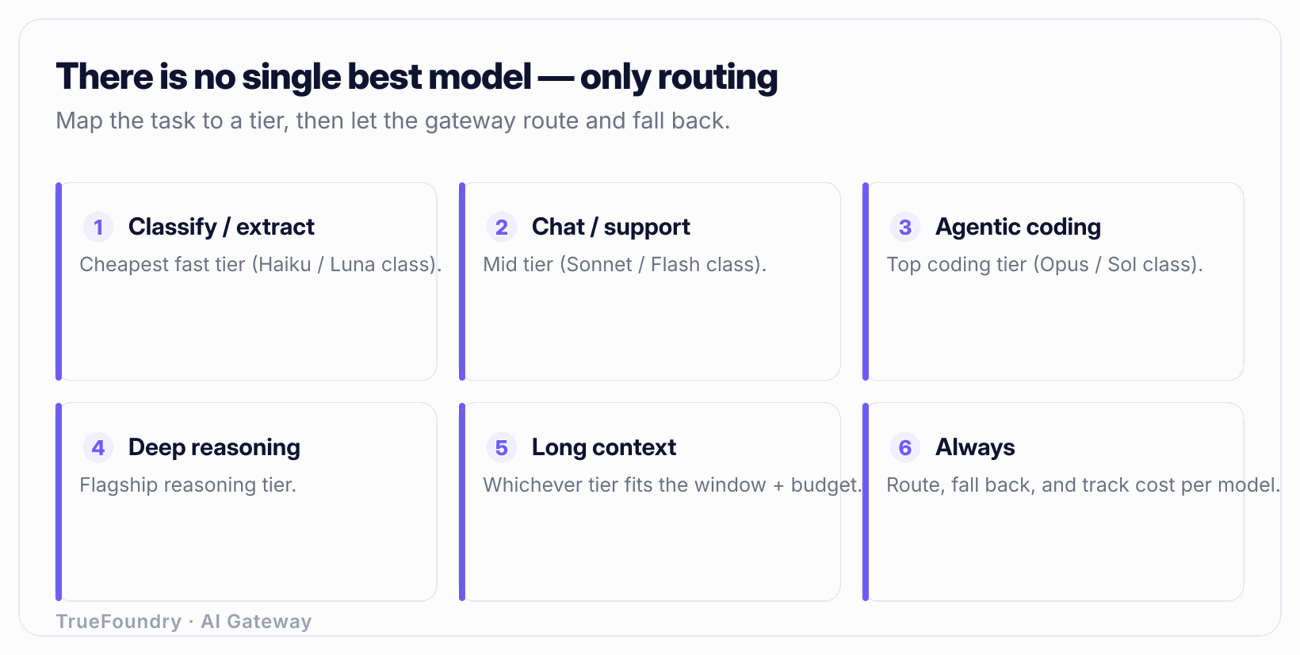
価格設定/ベンチマークは2026年11月時点の報告に基づくものです。依存する前に各プロバイダーの公式価格設定ページで確認してください — モデル仕様は頻繁に変更されます。
TrueFoundryがすべてのモデルでどのようにルーティング、フォールバック、コスト追跡を行うかをご覧ください。デモを予約する。
あるプロダクトが月に1,000万件のモデルリクエストを送信すると仮定します。比率を80/15/5と想定します: 80%が単純処理(分類、抽出、ルーティング)、15%がチャットおよび日常的コーディング、5%が高度な推論およびエージェント型コーディングです。リクエストあたりの平均トークン数を、単純およびチャットティアで入力500トークン / 出力200トークンとし、高度なティアではそれ以上と想定します。
すべてを$4 / $20の単一フラッグシップモデルにルーティングした場合、$0.10のモデルでもまったく同様に処理できたはずの800万件のリクエストを含め、全1,000万件にフラッグシップレートを支払うことになります。代わりにタスク別にルーティングしてみましょう:
ボリュームの大部分を占める単純ティアは、フラッグシップの入力トークンあたりおよそ40分の1のコストになります。ほとんどの実際の本番ワークロードにおいて、これにより総請求額を半分以上に削減しながら、高度なリクエストにはまさに必要なモデルを使用させ続けることができます。正確な数値はトークンの構成比率に依存します。つまり、モデルごとのコスト可視性が必要であり、ティアごとに測定を行うことになります。チームにそれを徹底させる方法については、LLMコスト帰属とチーム予算を参照してください。
上記のフレームワークは、毎回デプロイすることなく実行できる場合にのみ有用です。それこそがAI Gatewayの存在理由です。ゲートウェイは、アプリケーションに対してOpenAI互換の単一の統合APIを公開します。その単一エンドポイントの裏側で、各リクエストがどの実際のモデルに送信されるかを構成します。アプリケーションは毎回同じリクエスト形式を送信し、ゲートウェイが送信先を決定します。
この切り離しにより、フレームワークに直接マッピングされる4つのメリットが得られます:
単一APIであることの重要性は、一見した印象以上に大きいものです。新しいモデルが出荷された際(10月下旬にTerraが登場し、12月にも何かが登場するように)、ターゲットとして追加し、設定変更だけでトラフィックを移行できます。アプリ側が知る必要はありません。その下にあるアーキテクチャについては、LLMプロキシとはおよびAI Gatewayの選び方を参照してください。
2026年後半のフロンティア領域は、明確な勝者が1社だけ存在する単一の頂点ではありません。複数のティアの集合体であり、適切なコスト運用を行っているチームとは、分類処理にフラッグシップ料金を支払う代わりに、トラフィックの各領域を適切なティアにマッチングさせているチームです。ベンダー名は変わり続け、価格は動き続け、リーダーボードはシャッフルされ続けるでしょう。しかしフレームワークはすべてを乗り越えて生き残ります。トラフィックを分類し、各クラスをティアとコスト姿勢にマッピングし、高額なティアにはゲートを設けて高度なリクエストのみが到達するようにします。
そのフレームワークをゲートウェイでのルーティングポリシーとして実現すれば、「どのモデルか」は継続的な議論ではなくなり、数分で変更できる1行の設定(構成)になります。タスクとコストに応じてルーティングし、プロバイダーがつまずいたときはフォールバックし、重複をキャッシュし、リクエストごとに各モデルがいくらかかっているかを正確に可視化します。これこそが、特定のポイントにロックインされることなく、常に最先端に留まり続ける方法です。
1つのモデルへのロックインをやめ、モデル間でルーティングを行いましょう。 デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












