


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die Verfolgung der OpenRouter-Nutzung beginnt mit einer grundlegenden Designentscheidung: OpenRouter zeichnet immer Metadaten (Zeitstempel, Modell, Provider, Token-Anzahl, Latenz, Kosten) auf und erfasst Prompt- und Completion-Inhalte nur, wenn ein Organisationsadministrator dies aktiviert. Alles Weitere zu diesem Thema folgt aus dieser Entscheidung sowie aus der spiegelbildlichen Entscheidung auf Seiten von TrueFoundry, wo vollständige Bodies standardmäßig gemäß einer von Ihnen definierten Logging-Richtlinie protokolliert werden. Dieser Beitrag vergleicht die beiden Ansätze hinsichtlich Request-Erfassung und -Suche, Metriken und deren Formaten, LLM-Tracing und Kontextweiterleitung, Zuordnungsgranularität, Dashboards und Integrationen, Alarmierung, Eval-Hooks sowie Speicherdauer (Retention). Jede Aussage stammt aus den öffentlichen Dokumentationen der beiden Anbieter, und wo OpenRouter die Nase vorn hat, erwähnen wir das ausdrücklich – denn bei diesem Thema ist das stellenweise der Fall.
Das OpenRouter-Dashboard für die Nutzung ist die Activity-Seite: Die Metadaten jedes Requests landen dort mit optionaler Workspace-Filterung. Explore-Diagramme greifen auf dieselben Aggregate zurück, die auch die Analytics-API liefert, und Diagrammkonfigurationen können gespeichert und mit „Everyone in my organization“ geteilt werden. Die Aktivierung der Nutzungsabrechnung (Usage Accounting) gibt Kosten und Token-Zahlen in jedem Response-Body zurück, sodass ein Client die Ausgaben pro Aufruf verfolgen kann, ohne Abfragen (Polling) durchzuführen. Prompt- und Completion-Inhalte sind eine separate Opt-in-Funktion: Input & Output Logging befindet sich in der Beta-Phase, wird pro Workspace umgeschaltet, ist nur für Org-Admins einsehbar und wird bei Requests über regionale Endpunkte übersprungen – regionales Routing und Inhalts-Logging schließen sich also gegenseitig aus. Zwei Funktionen machen die Daten der OpenRouter-Aktivität nützlicher als einfache Metadaten es gewöhnlich sind: Broadcast bietet eine Stichprobenrate (Sampling-Rate) pro Ziel (deterministisch nach session_id, sodass ganze Sitzungen exportiert werden) und API-Key-Filterung pro Ziel, was es ermöglicht, Produktions-Keys mit einer niedrigeren Rate als Entwicklungs-Keys zu exportieren. Custom Classifiers ermöglichen Ihnen die Definition einer Taxonomie (Abteilung, Aufgabentyp, Agentenkomplexität), die ein kleines Modell auf jede Generierung anwendet, wonach Logs Gruppen nach diesen Tags filtern und analysieren können. Die Erfassung selbst ist pro Workspace binär; das Sampling erfolgt beim Export, nicht beim Ingest.
TrueFoundry protokolliert vollständige Request- und Response-Bodies als Parquet im Blob-Speicher, gesteuert durch Logging-Konfigurationen, die nach Benutzer, Team, Modell oder Metadaten filtern. Kosten, Tokens und Latenz werden auch dann aufgezeichnet, wenn eine Regel Bodies unterdrückt (Request-Logging). Die Suche erfolgt über eine Span-Abfrage-API, gefiltert nach Trace-ID, Subject, Modell und Metadaten, mit dokumentierten Span-Attributen sowie einem Request-Traces-Browser in der Benutzeroberfläche (Abrufen von Request-Logs). Da die Parquet-Dateien in Ihrem eigenen Bucket landen, können DuckDB, Athena oder Spark sie direkt abfragen – das ist das Argument der Rohdaten-Souveränität in einem Satz. Was wir nicht haben, OpenRouter jedoch teilweise bietet: prozentuales Sampling. Unsere Logging-Konfigurationen protokollieren oder protokollieren nicht pro übereinstimmender Regel. Übersicht zu Observability in einem AI Gateway behandelt das Logging-Richtlinien-Modell vertiefter.
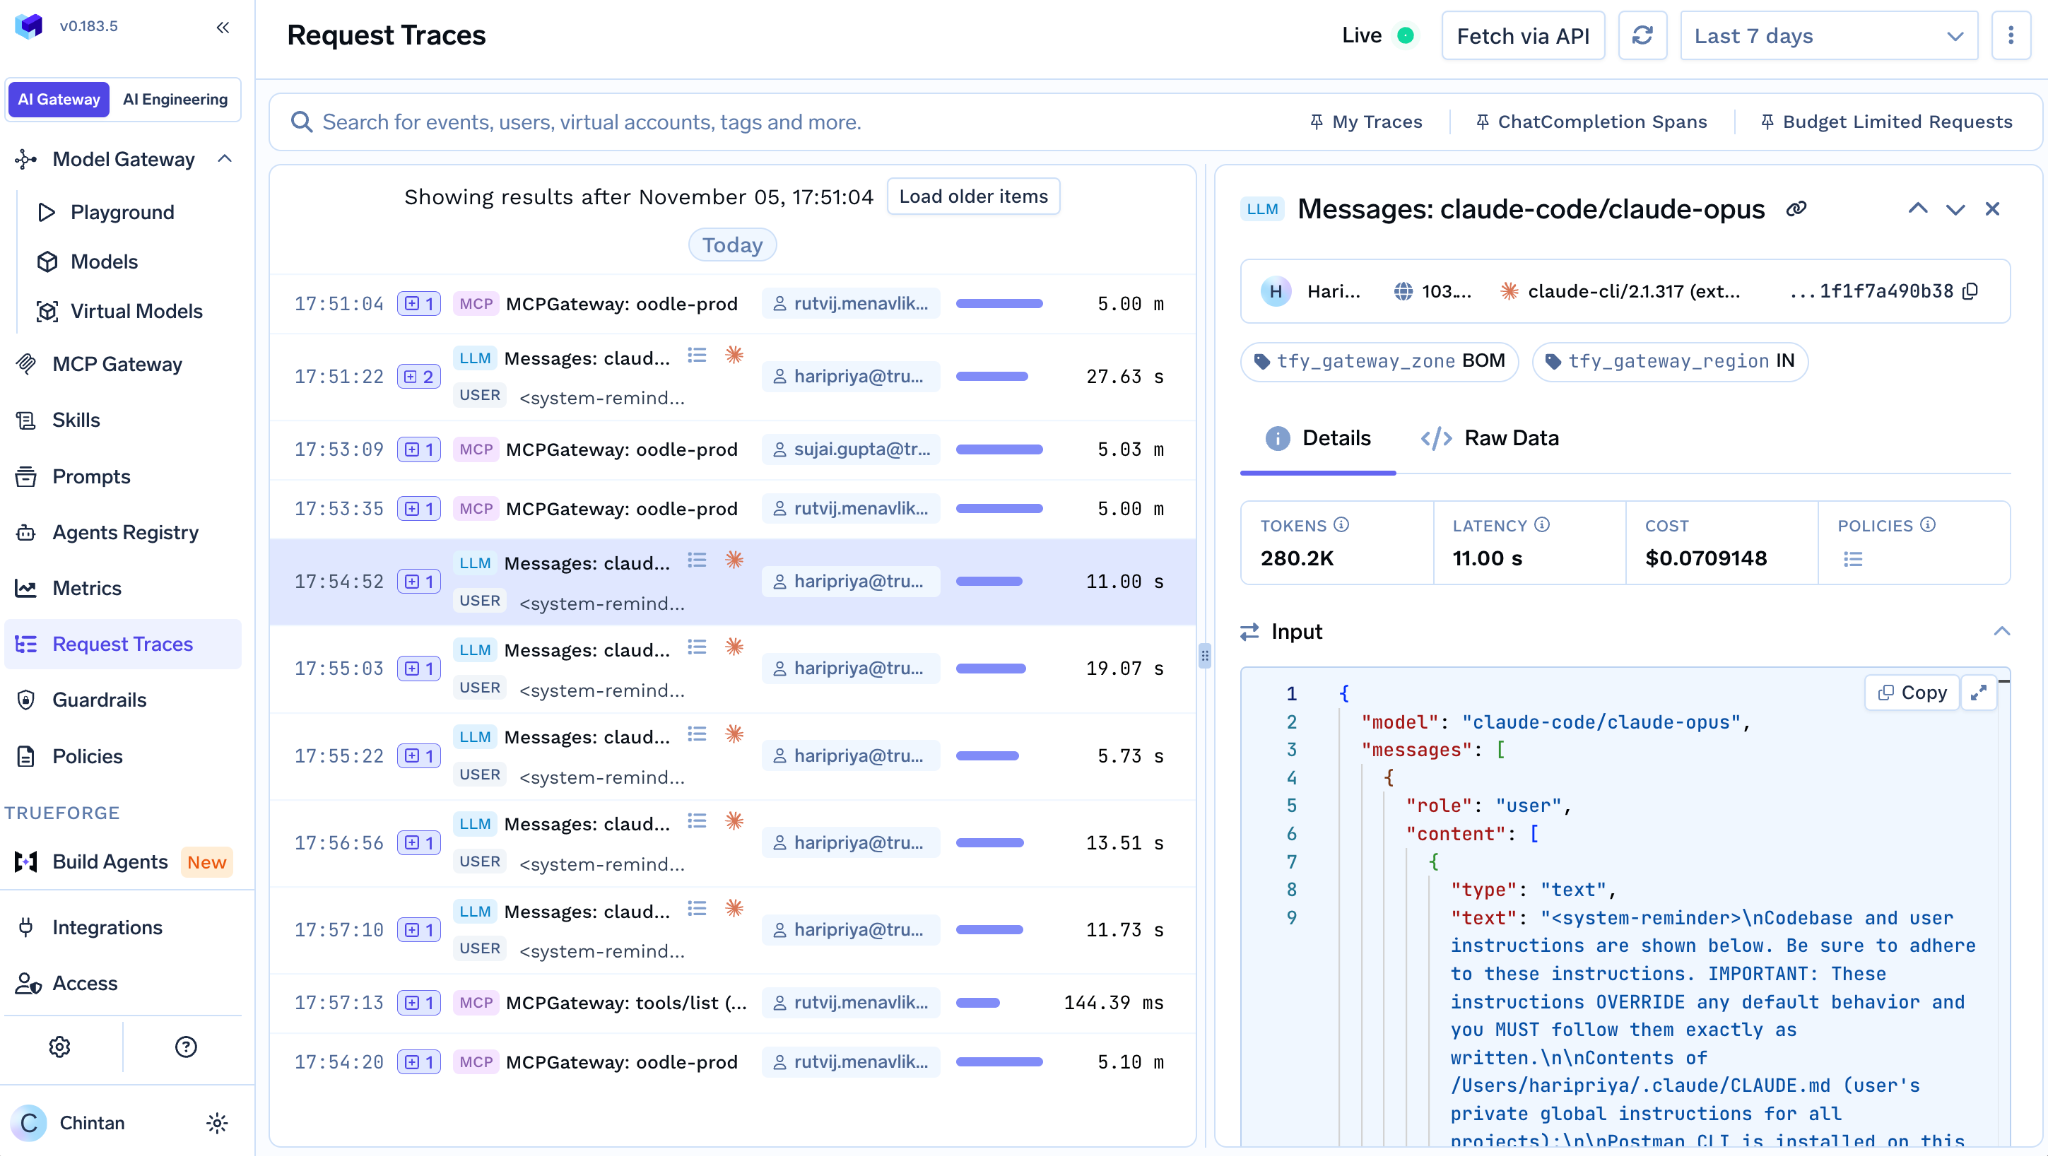
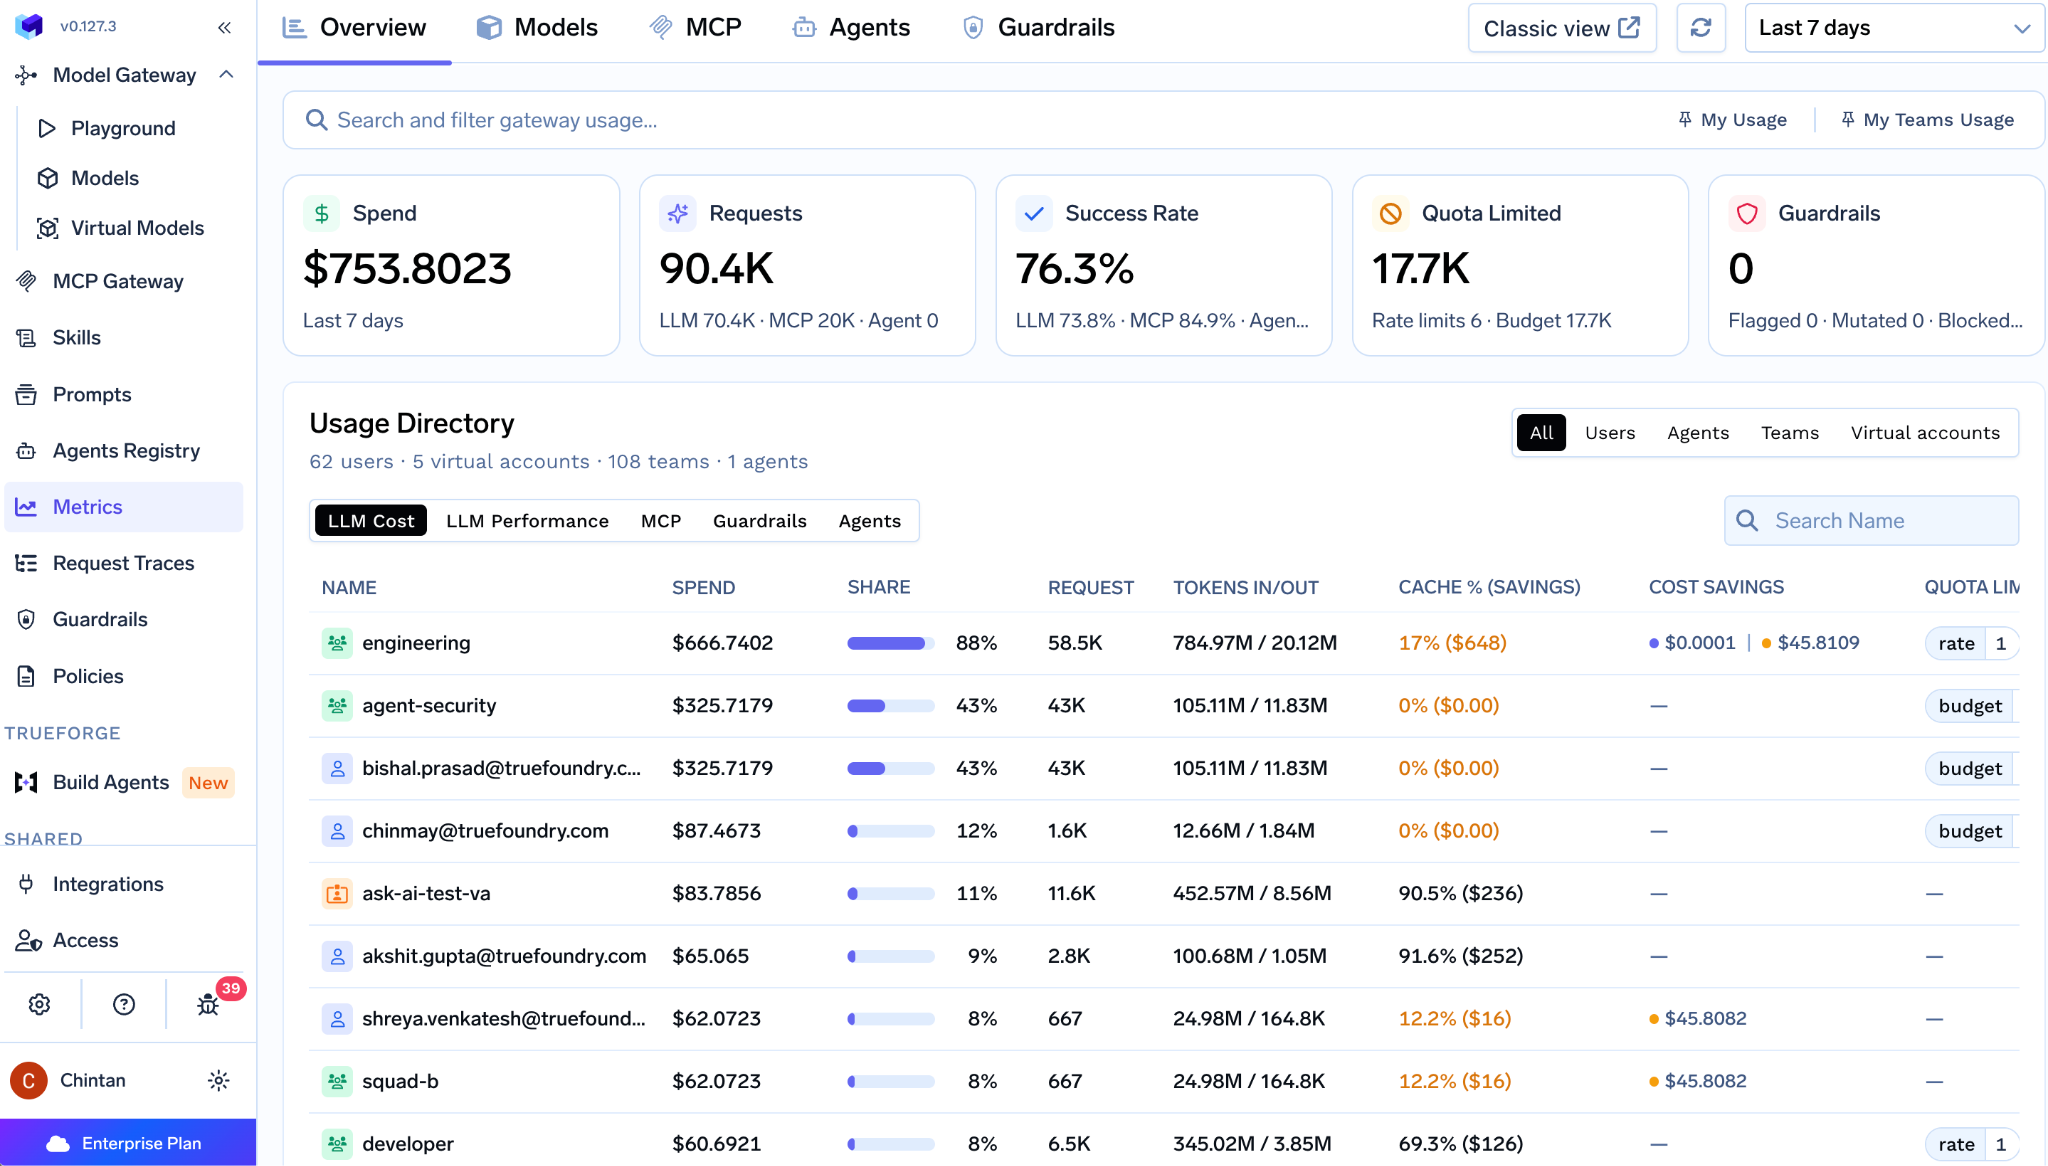
Die Analytics API von OpenRouter befindet sich in der Beta-Phase. GET /api/v1/analytics/meta listet unterstützte Metriken, Dimensionen, Filteroperatoren und Granularitäten auf; POST /api/v1/analytics/query führt die Abfrage aus. Ein Management-Key ist erforderlich, normale API-Keys erhalten einen 403-Fehler. Das Metrik-Set ist gut: Ausgaben aufgeschlüsselt nach Guthaben, OpenRouter, BYOK, BYOK-Gebühren, Upstream, Cache und Web; Request-Anzahl; Tokens als Prompt, Completion, Reasoning oder Cached; Cache-Hit-Rate; gemischte Kosten pro Million Tokens; sowie Latenz und Durchsatz bei P50, P90 und P99 auf Minuten-, Stunden-, Tages-, Wochen- oder Monatsbasis. Zwei Einschränkungen sind wichtig für jeden, der darauf Berichte aufbaut: Abfragen sind auf zwei Dimensionen beschränkt, und Antworten enthalten ein Abschneide-Flag (Truncation Flag). Es gibt keinen Prometheus-Scrape-Endpunkt, was daraus folgt, dass kein vom Kunden betriebener Prozess zum Scrapen vorhanden ist; OTLP-Metriken über Broadcast sind der zweite Weg.
TrueFoundry bietet bei selbst gehosteten Gateways einen über Prometheus abfragbaren /metrics-Endpunkt mit einem vollständig dokumentierten Metrikkatalog und Label-Set, OTLP-HTTP- oder gRPC-Export von OTel-Metriken (konfigurierbar über das Dashboard) sowie eine Abfrage-API-Familie, die Modell-, MCP-, Guardrail-, Cache-, Routing- und Agenten-Metriken abdeckt (Prometheus und Grafana, OpenTelemetry-Export). Der einzige Punkt, an dem sich die LLM-Metriken von OpenRouter auf dem Papier besser lesen, ist die fertige Perzentil-Zeile; bei uns handelt es sich um latenเวektorielle Zeitreihen pro Dimension, die Sie in Grafana aggregieren – was dieselben Daten mit einem zusätzlichen Schritt bedeutet.
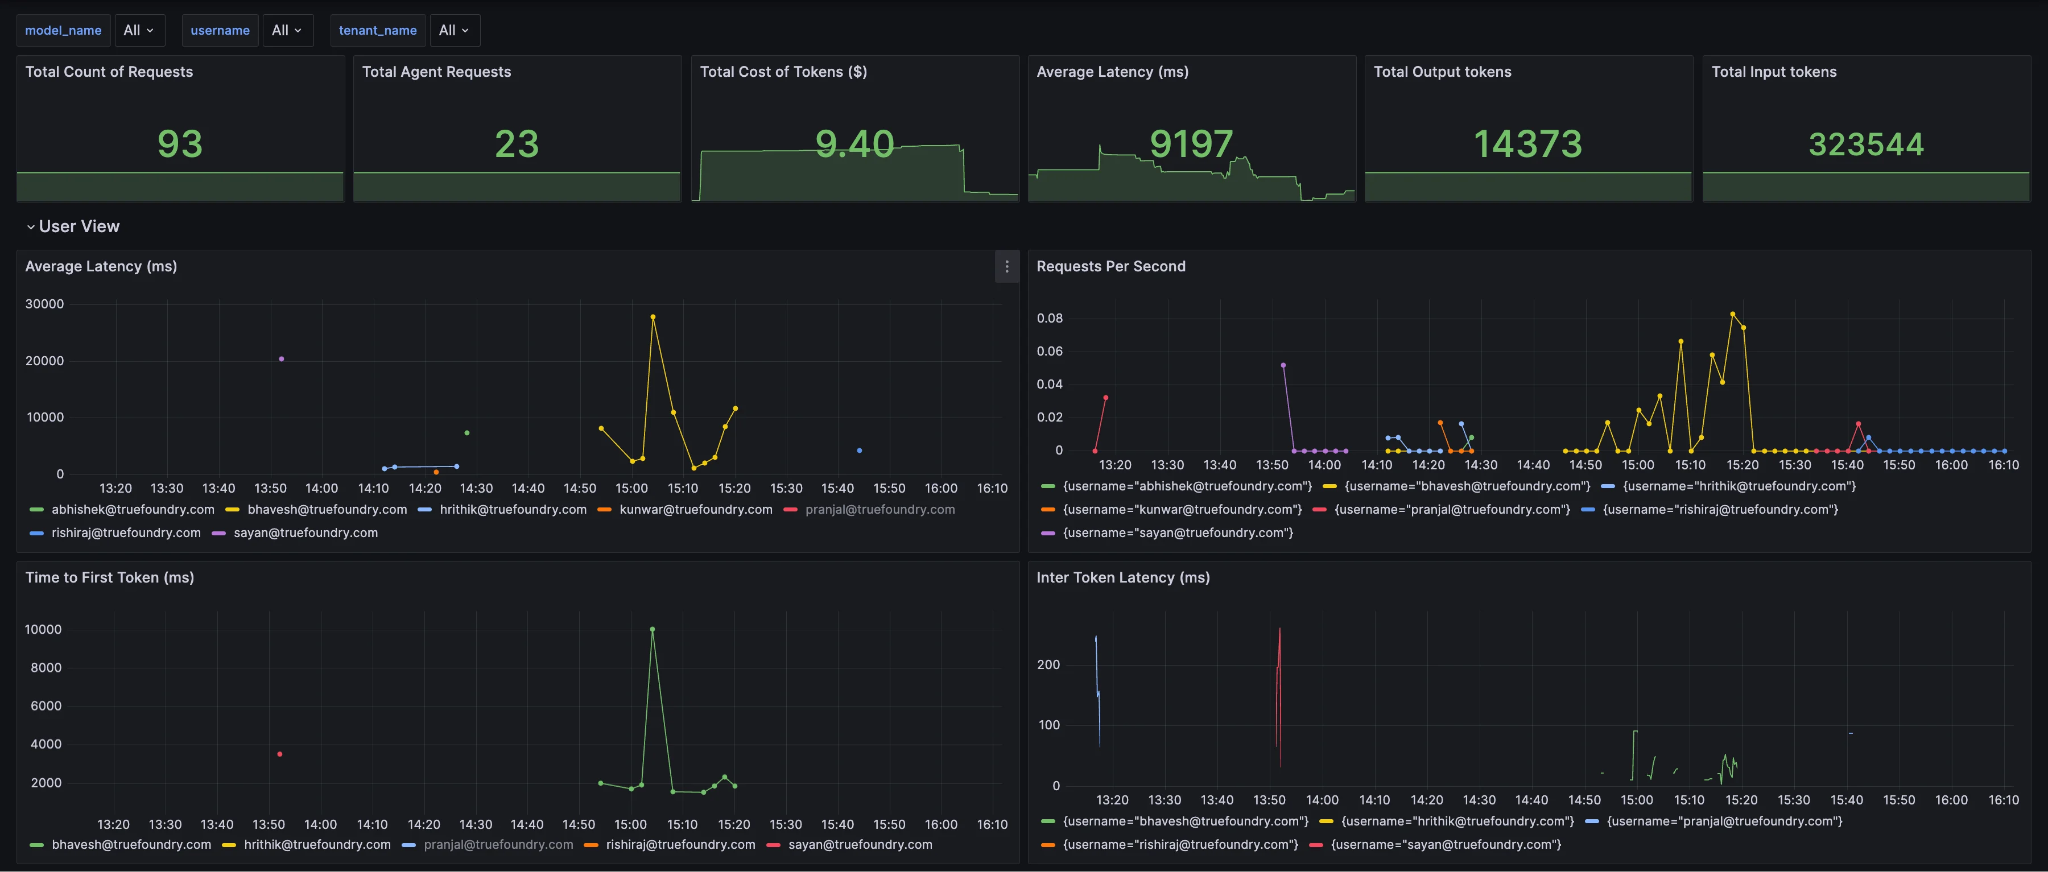
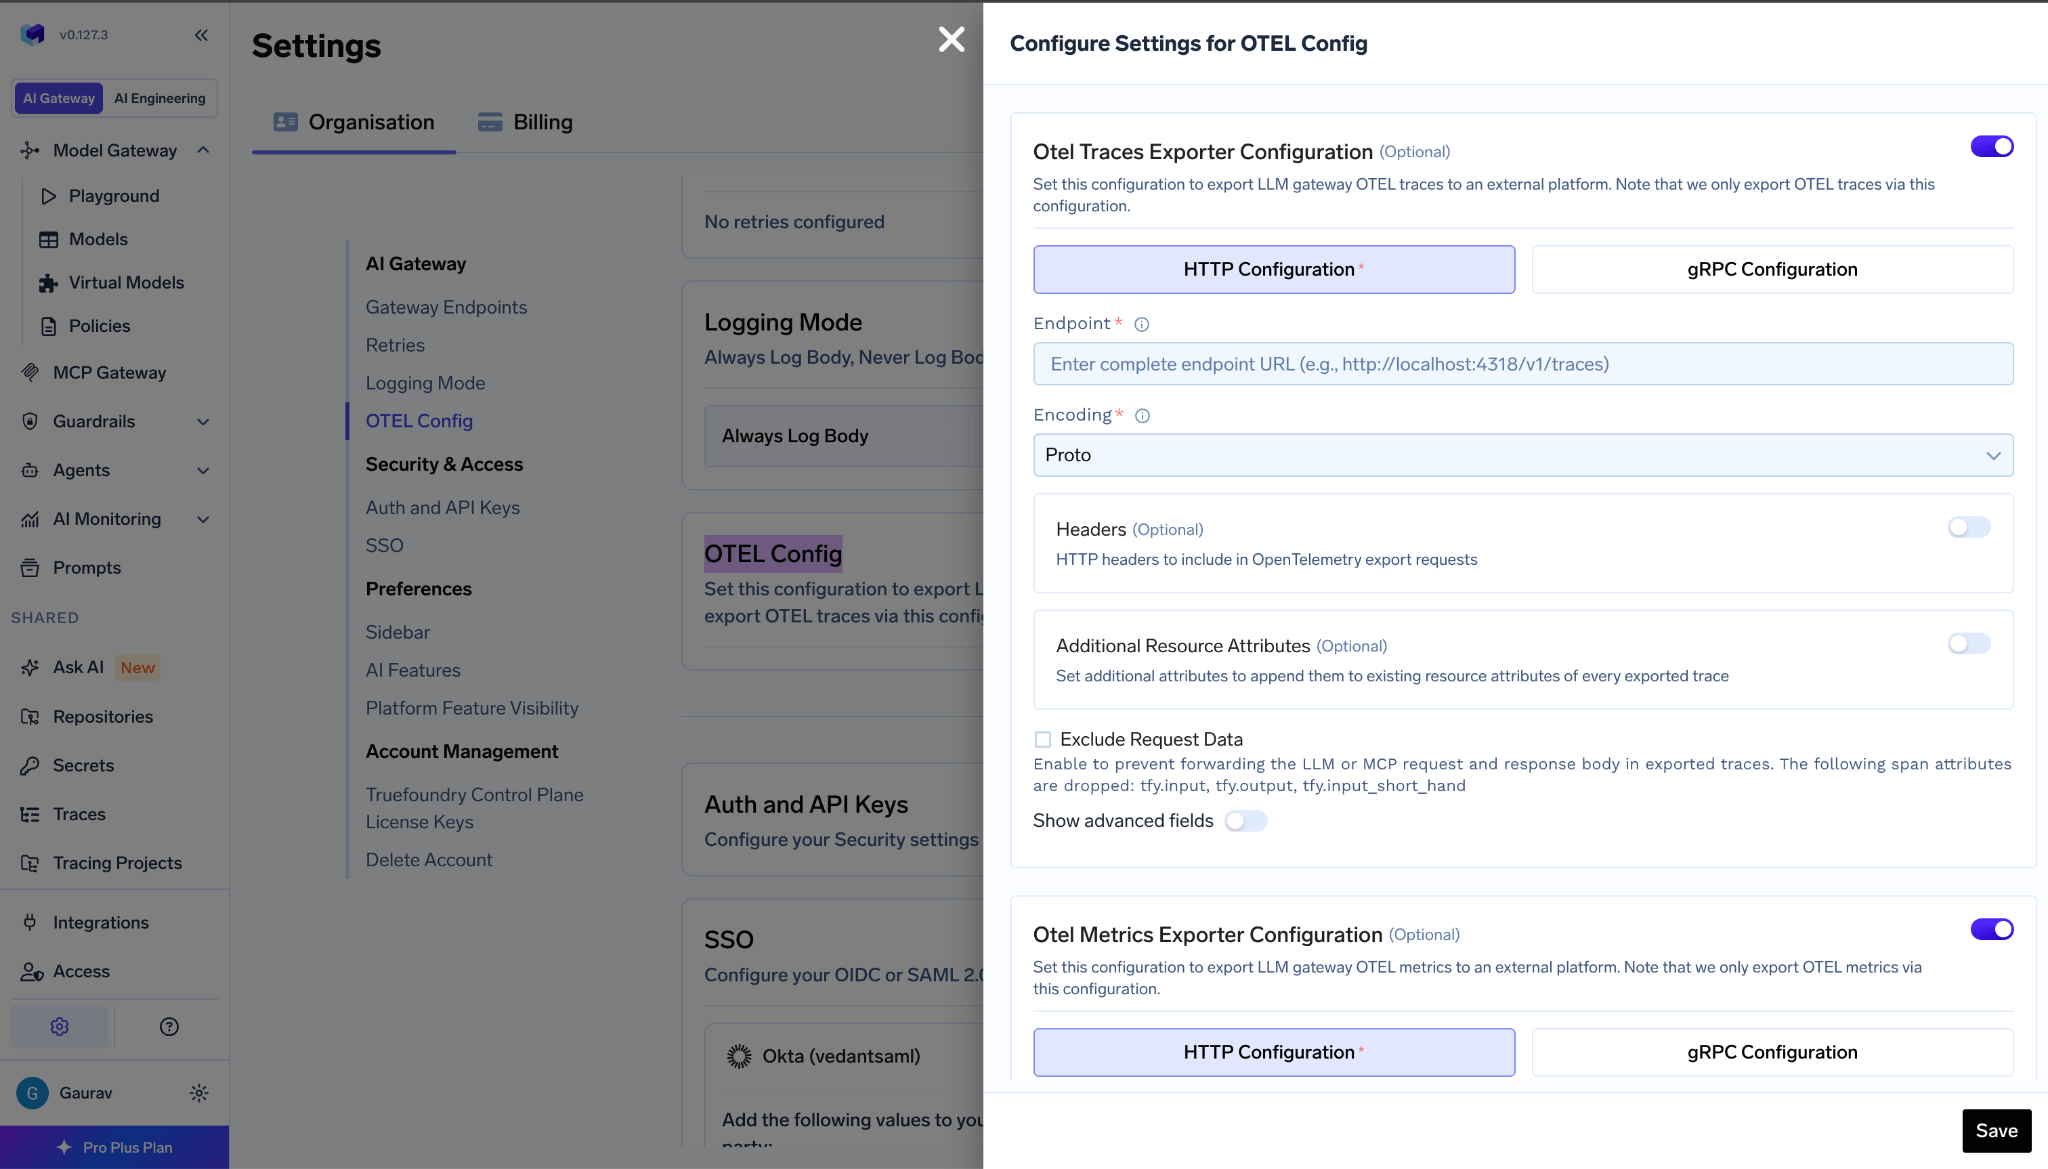
OpenTelemetry LLM Export existiert auf beiden Seiten, jedoch in unterschiedlicher Ausprägung. TrueFoundry ist nativ OTel-konform: Gateway-Traces werden von TrueFoundry gespeichert und optional ohne Auswirkung auf den internen Speicher an jedes OTLP-Backend dual exportiert. Spans folgen den OpenTelemetry GenAI Semantic Conventions mit einer dokumentierten Attributreferenz (Span-Attribute). OpenRouter ist beim Ausgang über Broadcast OTLP-nativ mit zielspezifischen Mappings: OpenInference-Attribute für Arize, über TraceQL abfragbare Attribute für Grafana Cloud, NRQL für New Relic, OTLP-JSON für generische Webhooks.
Bei der Kontextweiterleitung trennen sich die Wege, und der Unterschied ist eher operationaler als kosmetischer Natur. OpenRouter verschachtelt seinen Generierungs-Span unter Ihrem Anwendungs-Span, wenn Sie ein Trace-Objekt mit trace_id und parent_span_id im Request-Body übergeben. Das ist eine explizite Weiterleitung über die Nutzlast (Payload), was bedeutet, dass jeder Aufrufpunkt angepasst werden muss. Ob ein eingehender W3C-traceparent-Header berücksichtigt wird, ist nicht dokumentiert. TrueFoundry dokumentiert die eingehende traceparent-Weiterleitung ebenfalls nicht explizit. Wir empfehlen für beide Systeme dasselbe Vorgehen: Senden Sie einen Header, überprüfen Sie den Parent des exportierten Spans, und Sie haben in zehn Minuten Ihre Antwort. Gateway-basiertes Tracing speist auch unser Agent-Tracing-Produkt, wobei die zusätzliche Latenz von ca. 3–4 ms und über 350 Requests pro Sekunde pro vCPU bei aktiviertem Tracing über mehr als 2.500 LLMs über eine einzige OpenAI-kompatible API erhalten bleiben.
Die Token-Nutzung bei OpenRouter lässt sich über die Analytics-API über ein breites Spektrum an Dimensionen zuordnen: Modell, Variante, Provider, API-Key, App, Benutzer, Workspace, Origin, Land, Datenregion, Finish-Reason, Kontextlänge, Sitzung, Generierung, benutzerdefinierte User-IDs und jede Classifier-Dimension, gruppiert nach höchstens zwei Dimensionen gleichzeitig. Der Activity Export erstellt aggregierte Nutzungsdaten als CSV oder PDF nach Modell, Key oder Organisationsmitglied, mit einem Vorbehalt für die Finanzabteilung: BYOK-Ausgaben werden zu Provider-Marktpreisen geschätzt, nicht mit von Ihnen ausgehandelten Rabatten. Ein Export von stark BYOK-lastigem Traffic weist daher höhere Kosten aus, als Sie tatsächlich bezahlt haben.
TrueFoundry ordnet Tokens, Kosten und Latenz pro Request, Benutzer, Team, virtuellem Konto, Modell, Provider-Konto, MCP-Server, einzelnem MCP-Tool und beliebigen Metadaten-Schlüsseln zu – aufschlüsselbar ohne Dimensionsbegrenzung im Dashboard und in den Abfrage-APIs (Analytics). Die Zuordnung auf Tool-Ebene ist die Eigenschaft, die OpenRouter nicht bieten kann, da es sich nicht im Pfad des Tool-Aufrufs befindet. Bei Agenten-Workloads, bei denen die Kosten in den Tools und nicht im Modell entstehen, ist das genau die Kennzahl, die Sie benötigen. Unser Leitfaden zur LLM-Kostenverfolgung zeigt, wie die Ansichten pro Team und pro virtuellem Konto die interne Weiterverrechnung (Chargeback) unterstützen.
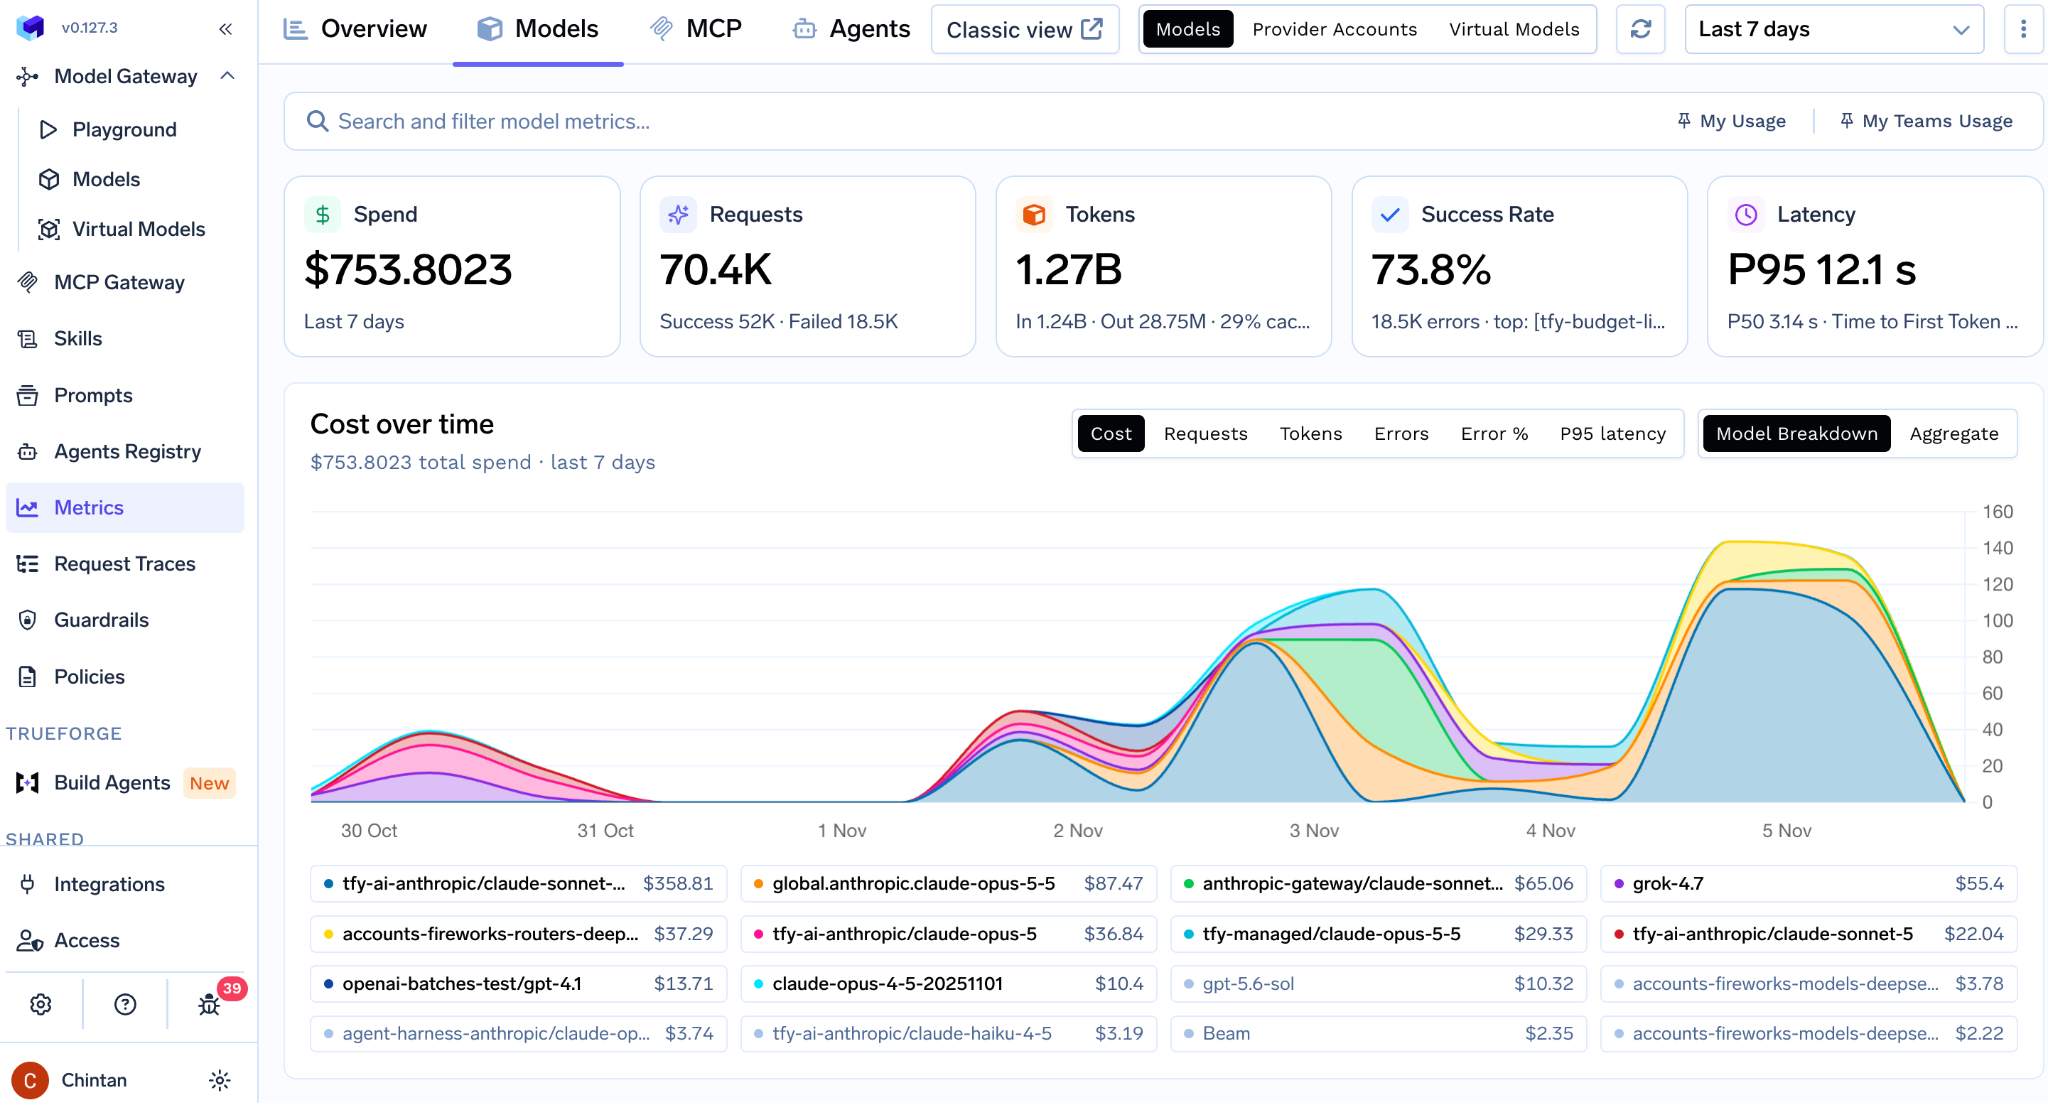
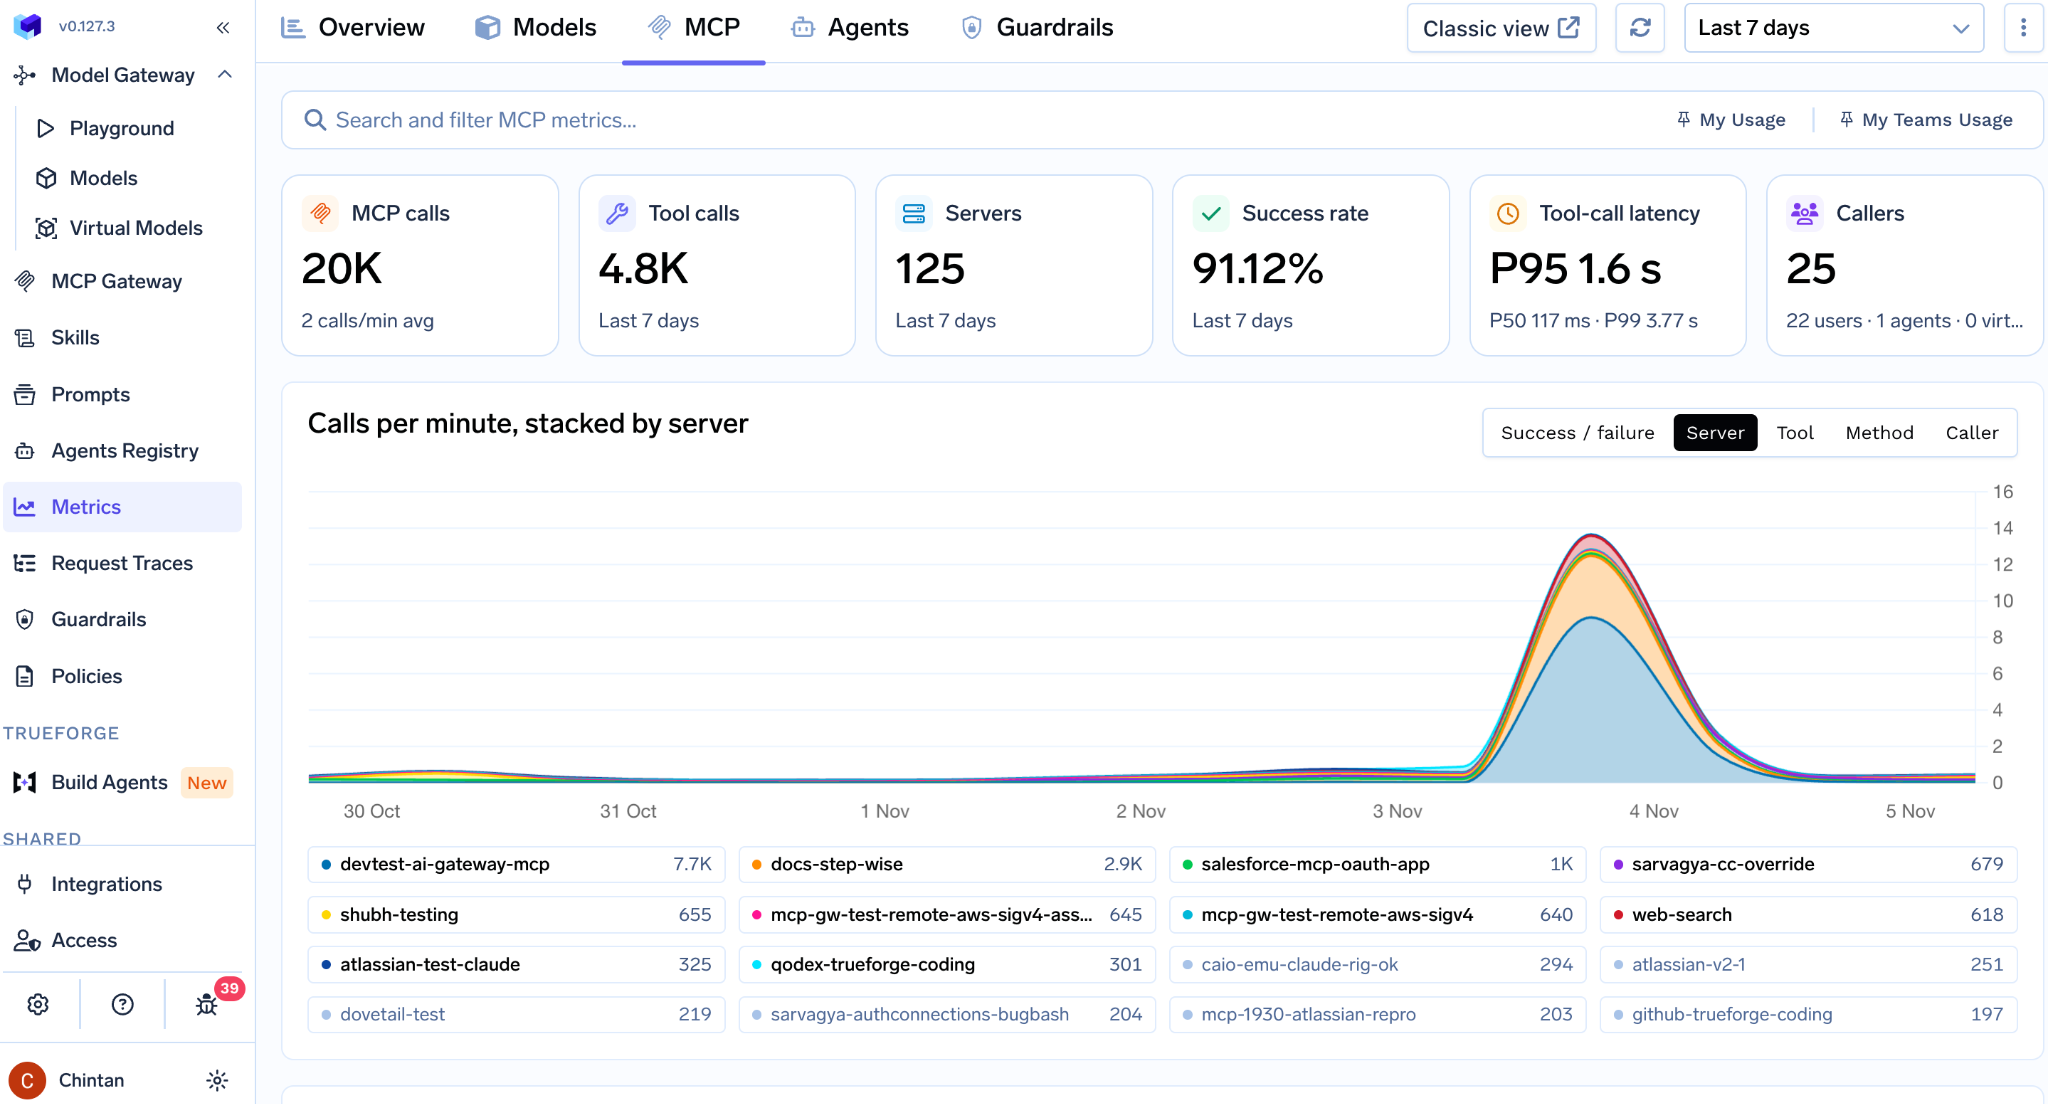
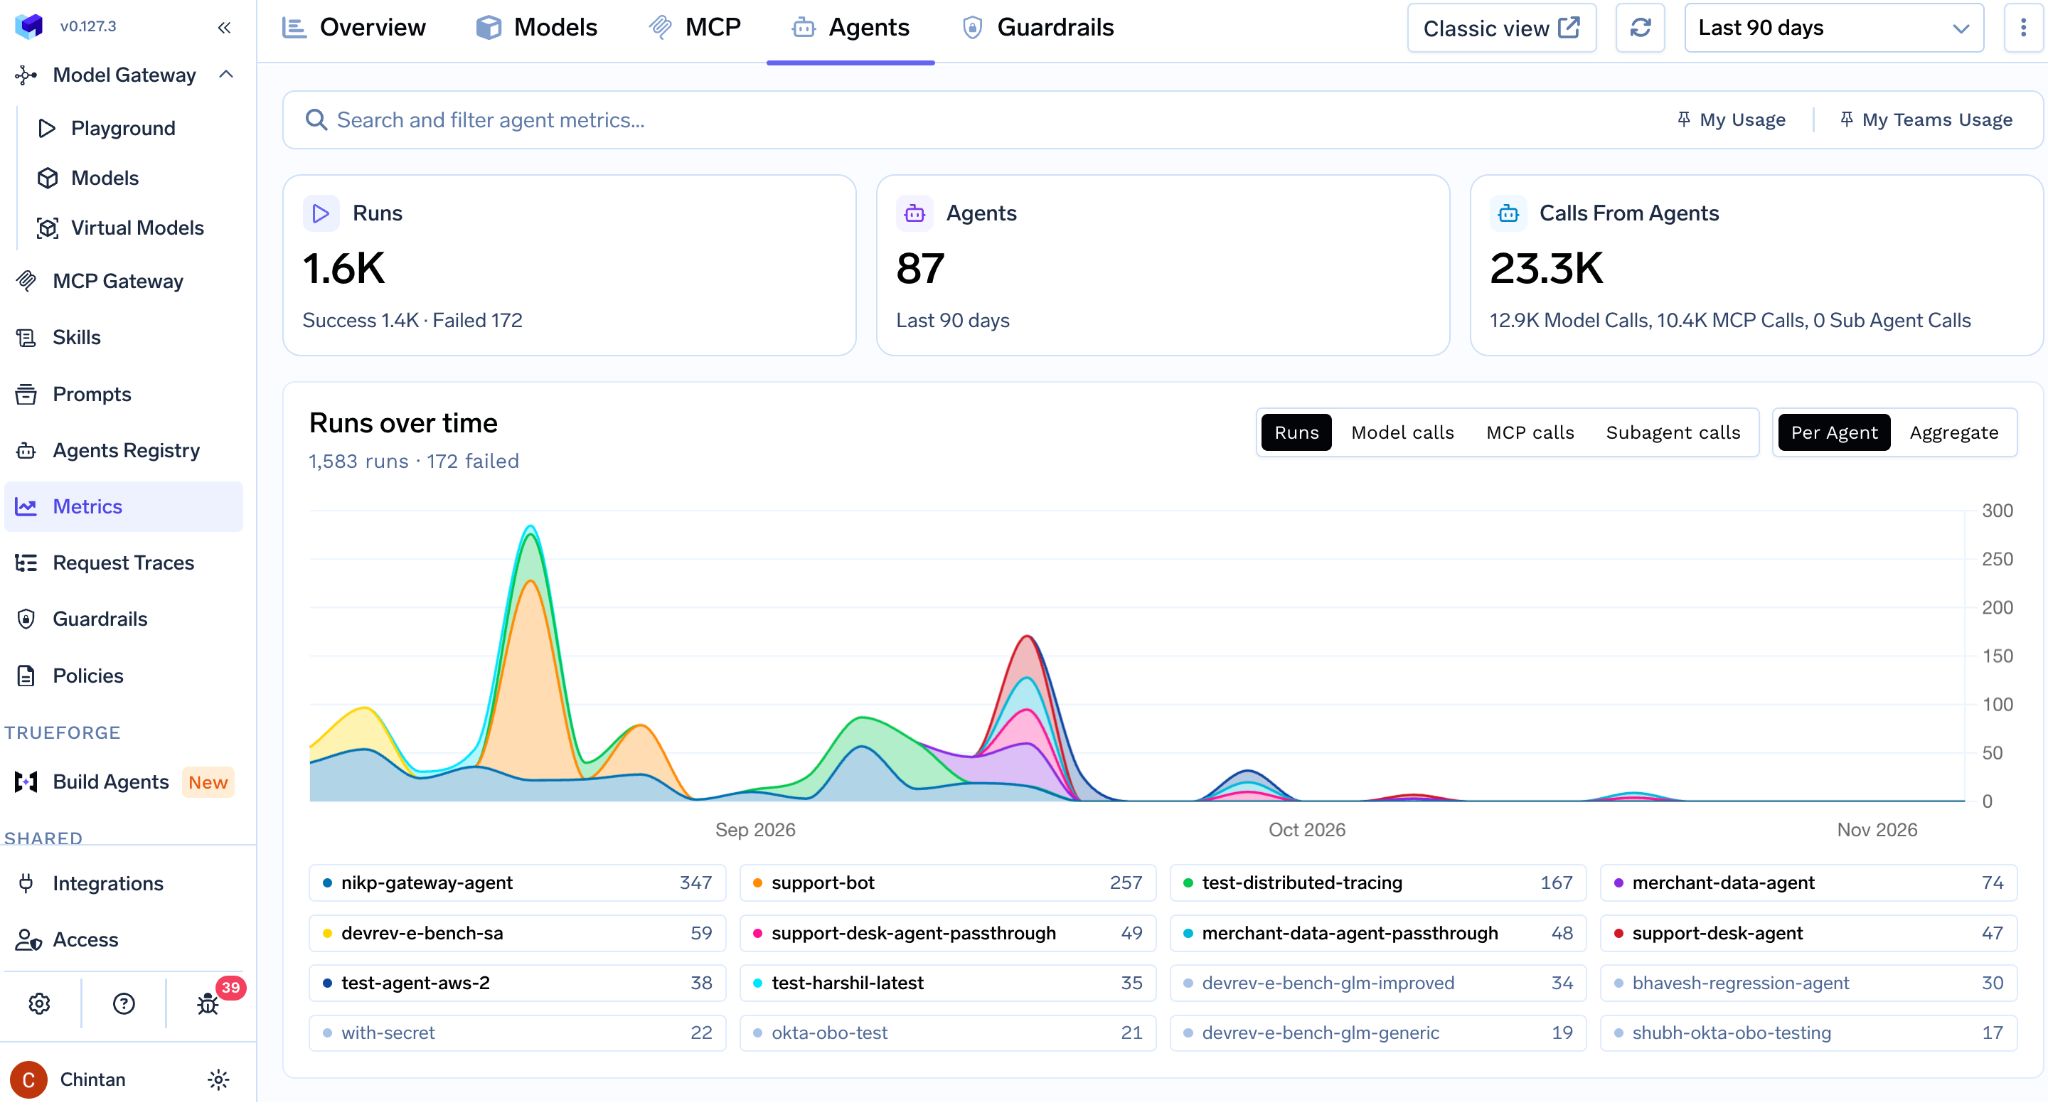
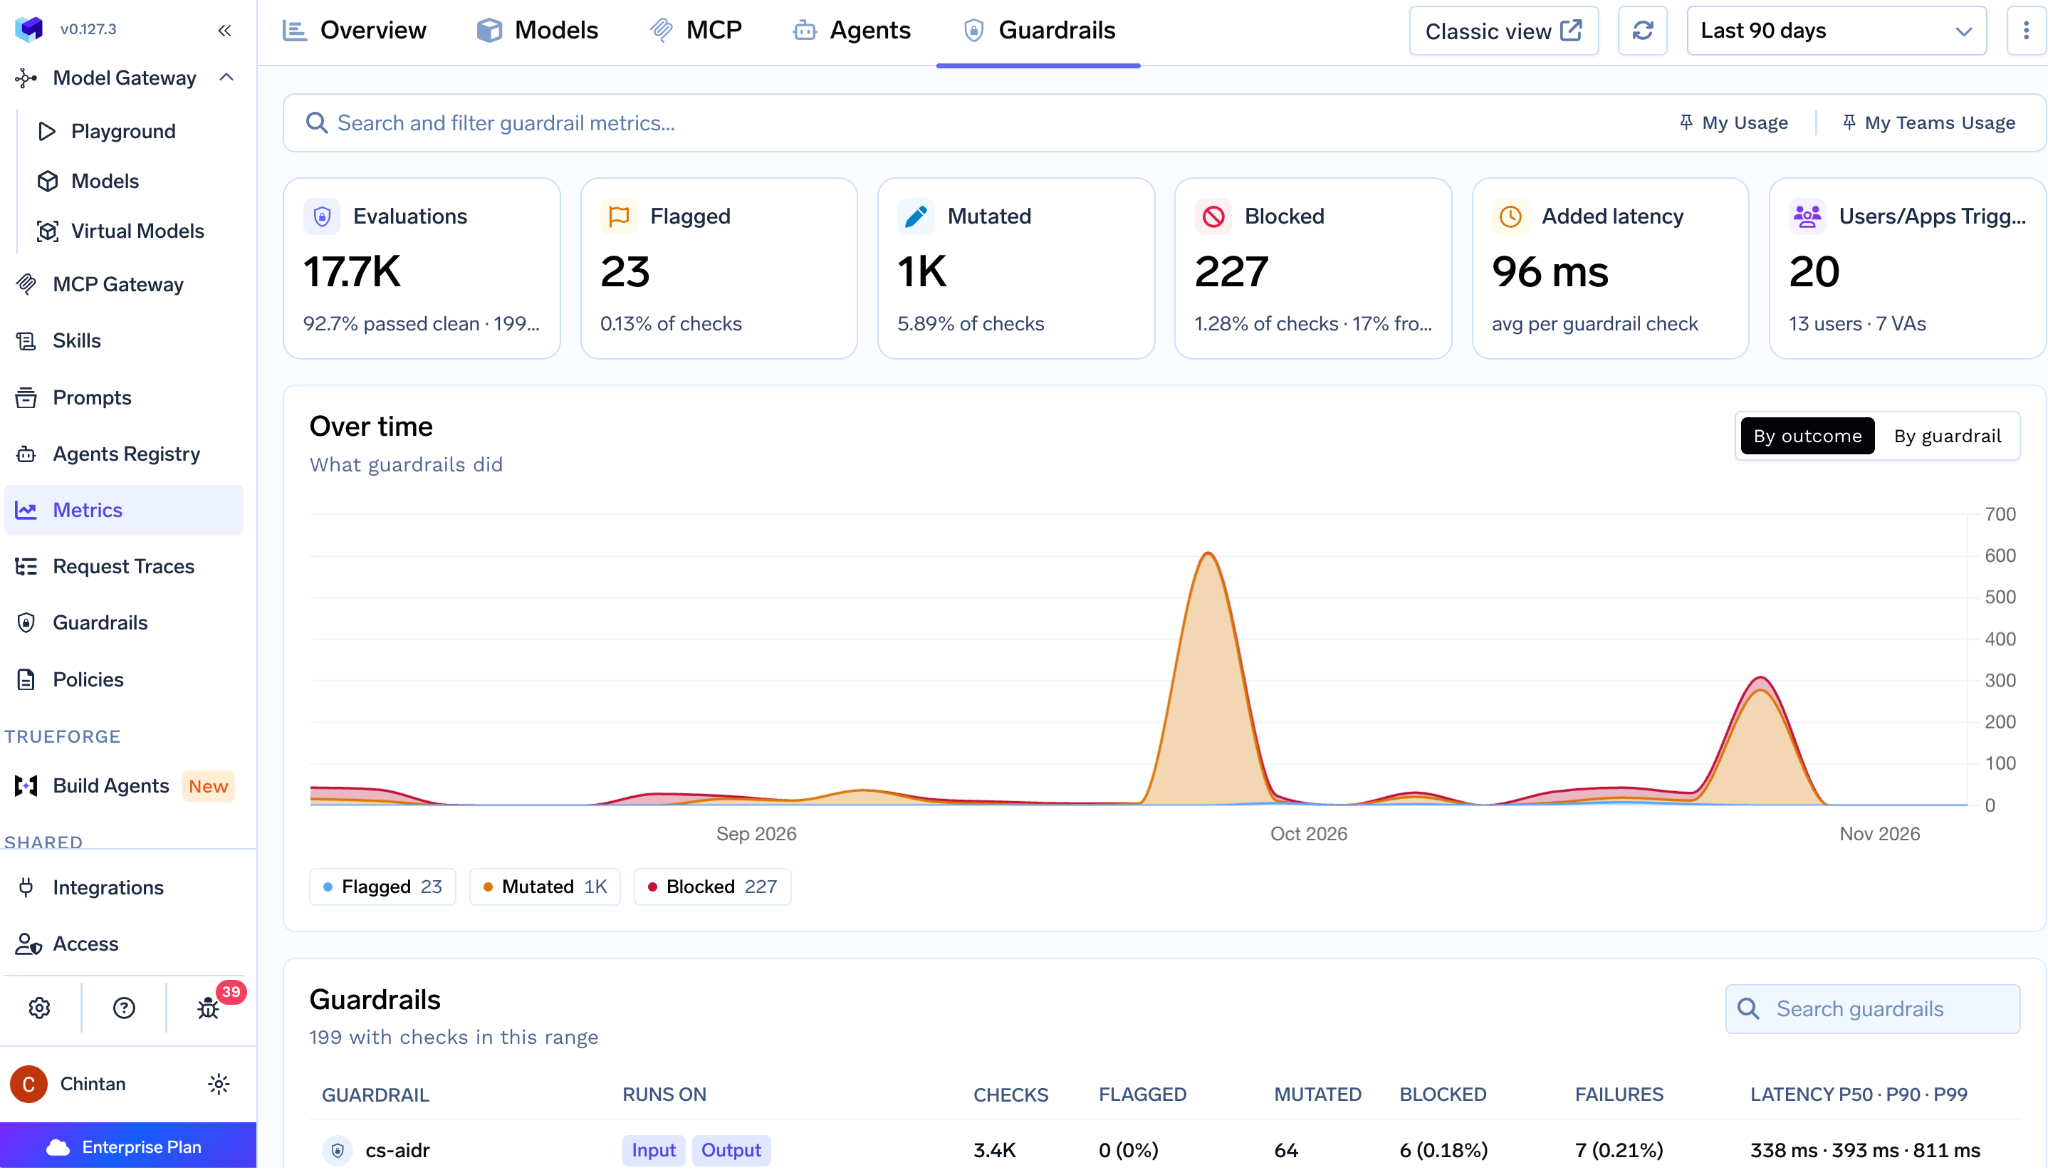
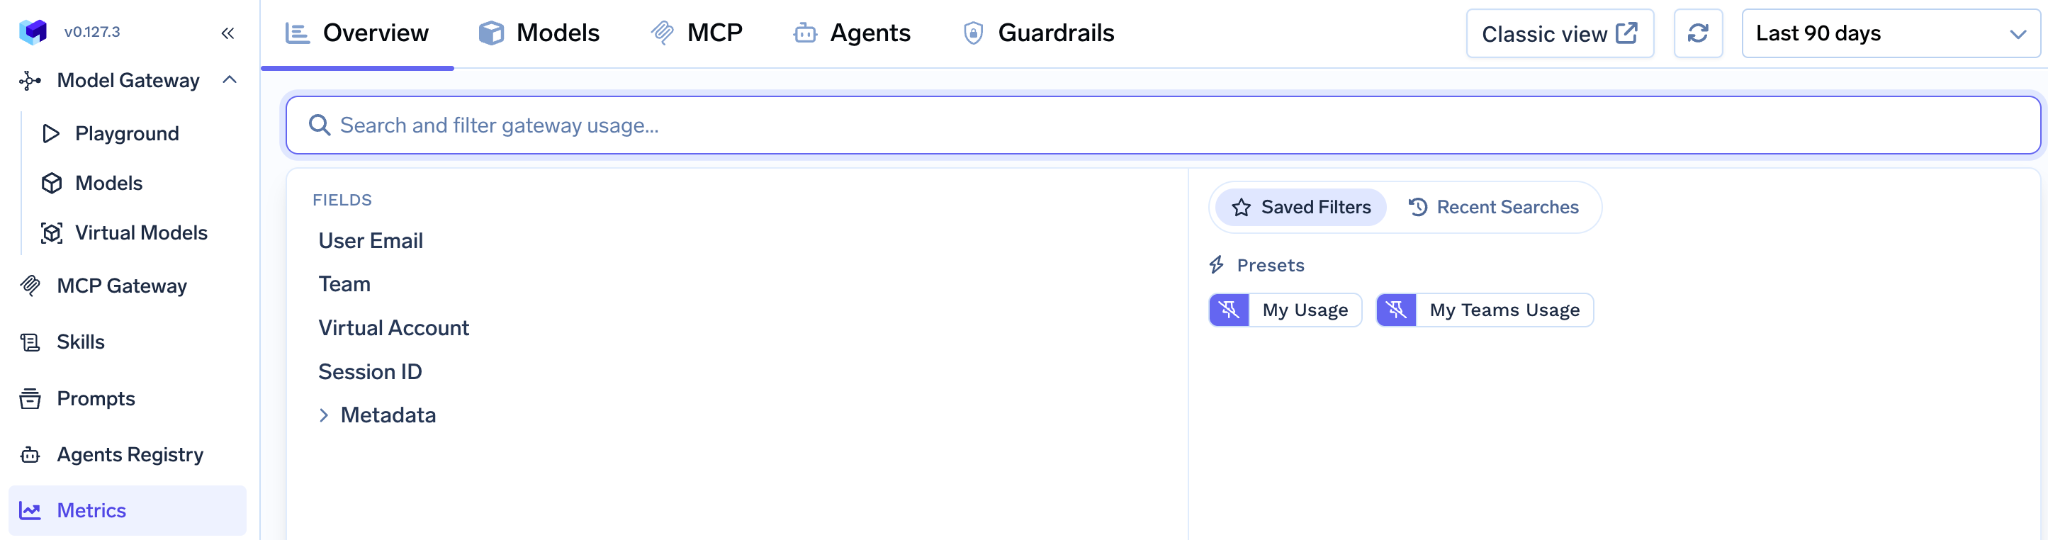
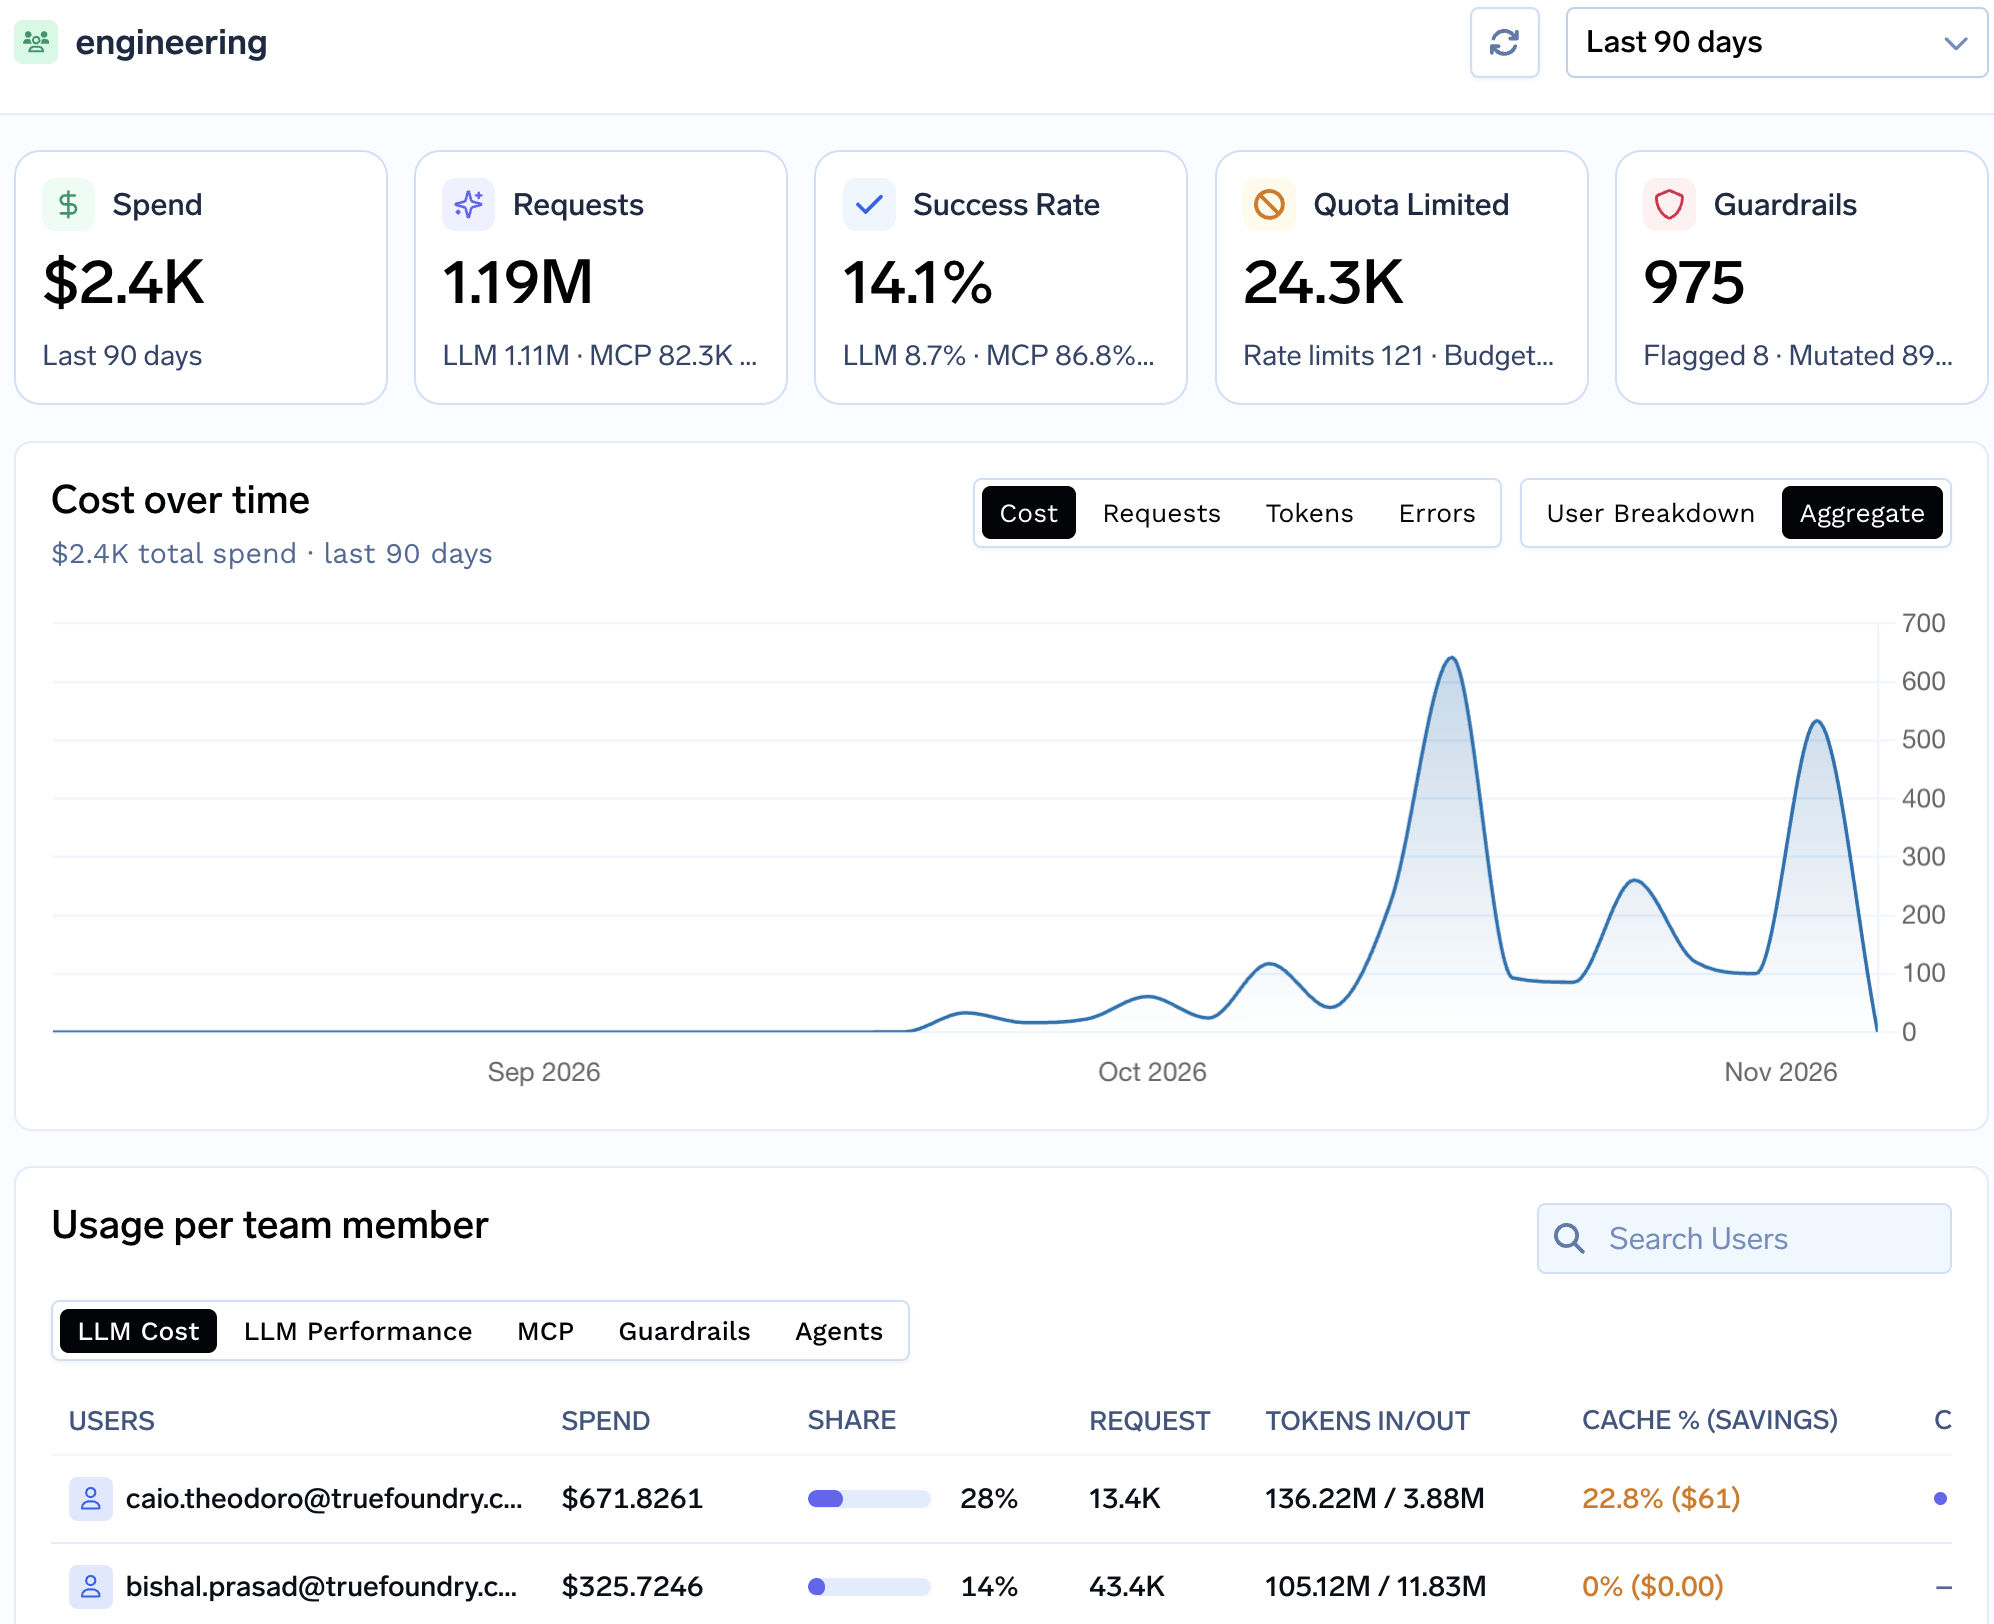
Beide bieten ein integriertes Dashboard sowie die Möglichkeit, eigene Lösungen anzubinden. Das Metrics Dashboard von TrueFoundry bietet getrennte Ansichten für Zähler-Übersichten, Kosten, LLM- und MCP-Aufschlüsselungen, Fehler, Guardrails und Leaderboards; das Activity Dashboard von OpenRouter bietet speicherbare Explore-Diagramme und eine Logs-Ansicht mit Detailseiten für Generierungen.
Bei den Integrationen geht dieser Punkt an OpenRouter, was wir lieber offen ansprechen als verschweigen. Broadcast-Ziele: Arize AX, Braintrust, ClickHouse, Comet Opik, Datadog, Elastic Observability, Google BigQuery, Grafana Cloud, Hugging Face Storage Buckets, Langfuse, LangSmith, New Relic, OpenTelemetry Collector, PostHog, Raindrop, Ramp, S3 und S3-kompatible Speicher, Sentry, Snowflake, W&B Weave und ein generischer Webhook, mit verschlüsselten Anmeldedaten und einer Konfiguration, die nur speichert, wenn der Verbindungstest erfolgreich ist. Die Data-Warehouse- und Product-Analytics-Ziele (BigQuery, Snowflake, PostHog) haben in unserer Liste kein direktes Äquivalent. TrueFoundry dokumentiert Datadog, Grafana/Prometheus, New Relic, Langfuse, Arize, Honeycomb, Dynatrace, SigNoz, Coralogix, Traceloop, Middleware und W&B Weave sowie alles OTLP-Kompatible über den generischen Exporter (Ökosystem). Ein Data Warehouse ist über den Parquet-Bucket anstelle eines nativen Konnektors erreichbar. Eine Interaktion sollte geklärt werden, bevor Sie sich auf Broadcast verlassen: Es exportiert Trace-Daten an einen Drittanbieter Ihrer Wahl, und die Datadog-Anleitung verweist auf einen Privacy Mode. Prüfen Sie daher, wie sich dies mit Inhalten verhält, die Sie andernfalls nicht speichern möchten.
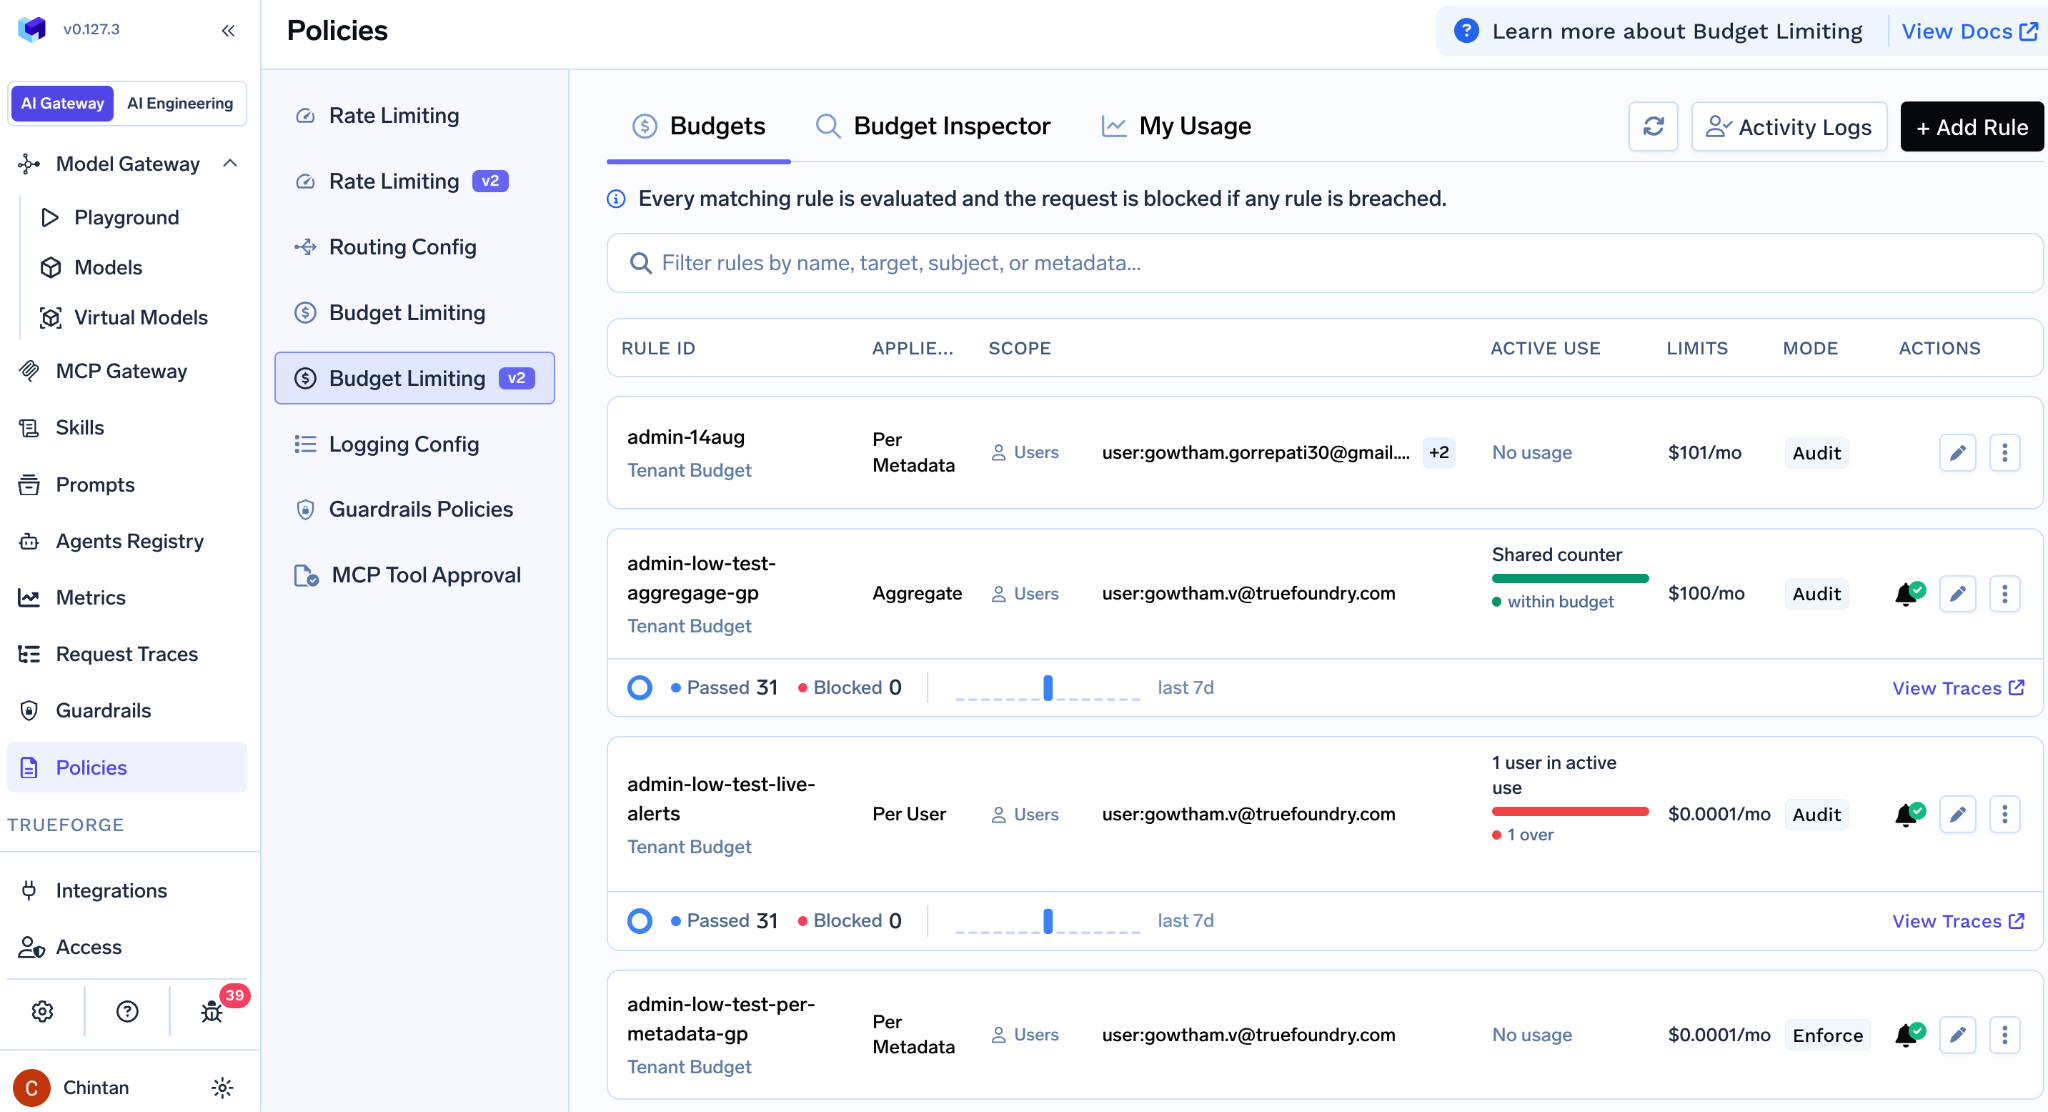
Das native Alarmieren von TrueFoundry bezieht sich rein auf Ausgaben: Budget-Meilenstein-Warnungen bei 75, 90, 95 und 100 % per E-Mail, Slack-Webhook oder Slack-Bot mit Vorlagen pro Benutzer, in jedem Tarif (Budgetbeschränkung). Die Benachrichtigungen von OpenRouter sind gestaffelt: E-Mails bei niedrigem Guthaben, Modell-Einstellungen und Preissenkungen überall; in Business und Enterprise gibt es Warnungen bei Erreichen eines Budget-Anteils für Workspaces, Ausgabenlimit-Warnungen pro Key sowie Zustellung per Slack oder Webhook. Eine Warnung vor der Sperrung existiert also bei beiden, ist bei OpenRouter jedoch eine kostenpflichtige Funktion. Keines von beiden dokumentiert Alarmregeln für Latenz, Fehlerrate oder Guardrail-Auslösungen; das LLM-Monitoring für Zuverlässigkeit erfolgt bei beiden nachgelagert über exportierte Metriken in AlertManager oder Ihr APM auf unserer Seite und über Broadcast bei OpenRouter. Wie Budgetwarnungen mit harten Limits und Rate-Limits zusammenhängen, wird in unserem Beitrag über OpenRouter Rate Limits behandelt.
OpenRouter bietet das einzige eigene Eval-Produkt in diesem Vergleich, wobei es an die API angrenzt, anstatt Teil davon zu sein. Ori Eval ist eine CLI, die eine Codebasis nach allen Modellaufrufen scannt, Sie interviewt, Eval-Dateien schreibt, den Agenten mit Ihren eigenen Prompts ausführt, aufgerufene Tools überprüft und offene Antworten mit einem LLM-Judge bewertet. Dabei sind Harness und Modell fixiert, sodass Ergebnisänderungen dem Modell zugeordnet werden können. Da die Aufrufe über OpenRouter geroutet werden, erstrecken sich Vergleiche über den gesamten Katalog. Da Evals als Code vorliegen, können sie terminiert werden; OpenRouter beschreibt einen Beta-Nutzer, dessen monatlicher Vergleich einen Pull Request öffnet, sobald ein besseres Modell verfügbar ist. Auf der API-Seite gibt es einen Report-Feedback-Endpunkt sowie Routing-Varianten, Router und Presets als Experimentierbausteine; ein natives A/B-Traffic-Splitting ist nicht dokumentiert.
TrueFoundry bietet drei konkrete Hooks und keine Eval-UI, was wir genauso klar feststellen wie das Zugeständnis zu Ori Eval oben. Eine Feedback-API fügt jeder Trace über den Response-Header x-tfy-feedback-target-id 1–5-Sterne-Bewertungen hinzu (derzeit nur für den Root-Span) (Feedback für Traces). Produktions-Traffic dient strukturell als Grundlage für ein Eval-Set, da die Parquet-Dateien in Ihrem Bucket für Evaluierungen über Spark, DuckDB oder Athena dokumentiert sind. Zudem ist das Traffic-Splitting bei virtuellen Modellen ein nativer Experimentierbaustein: Leiten Sie einen Prozentsatz des Traffics eines virtuellen Modells auf einen Kandidaten um und vergleichen Sie diesen anhand derselben Metriken. Für LLM-Evals als Produkt verweisen beide Anbieter über den Trace-Export auf Langfuse, Arize, Braintrust oder Weave.
TrueFoundry dokumentiert keine feste Obergrenze; die Trace-Retention ist pro Datenrouting-Ziel konfigurierbar, Metriken gehen immer an das Standardziel mit einer konfigurierbaren Retentionsperiode, und bei kundenverwaltetem Speicher ist die Obergrenze Ihr eigener Bucket (Datenrouting). Speicherkosten bei großer Skalierung werden nicht veröffentlicht; berechnen Sie diese aus einem gemessenen Bytes-pro-Request-Wert [USER TO FILL]. OpenRouter dokumentiert keine Plattform-Obergrenze und keine angegebene Retentionsperiode für Metadaten oder Opt-in-Inhalte; das 30-Tage-Fenster des Analytics-Activity-Endpunkts ist ein Abfragefenster, keine Retentionszusage. Wenn Daten per Broadcast an Ihr eigenes S3, ClickHouse, BigQuery oder Snowflake übertragen werden, liegen Retention und Kosten in Ihrer Verantwortung.
Die Funktionen von TrueFoundry stammen aus unserer Dokumentation; die Funktionen von OpenRouter spiegeln die zum Zeitpunkt der Erstellung öffentlich dokumentierten Funktionalitäten wider.
Die Nutzungsverfolgung von OpenRouter bietet das stärkste Hosted-Observability-Konzept in dieser Reihe: Broadcast, die Perzentile der Analytics-API, Custom Classifiers und Ori Eval sind echte Vorteile, und zwei davon (Warehouse-Sinks und ein eigenes Eval-Tool) werden von TrueFoundry nicht angeboten. Die Vorteile von TrueFoundry liegen im Bereich der Plattform-Architektur: ein Prometheus-Endpunkt, Spans nach GenAI-Konventionen, Zuordnung bis auf Tool-Ebene, Budgetwarnungen in jedem Tarif und Parquet-Rohdaten in Ihrem eigenen Bucket. Keines der Systeme führt standardmäßig Sampling beim Ingest durch, keines alarmiert nativ bei Zuverlässigkeitsproblemen und keines dokumentiert die eingehende traceparent-Weiterleitung. Treffen Sie Ihre Wahl basierend darauf, wo Ihre Daten bereits liegen und ob Sie die Roh-Logs selbst verwalten müssen.
Um das Metrics Dashboard, den OTel-Export und die Zuordnung auf Tool-Ebene zusammen im Einsatz zu sehen, testen Sie das TrueFoundry AI Gateway oder buchen Sie eine Demo, wenn Sie Ihre spezifische Observability-Architektur besprechen möchten.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





