


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Wählen Sie ein beliebiges LLM-Produkt aus, das in den letzten drei Jahren auf den Markt kam, und untersuchen Sie dessen API. Die Wahrscheinlichkeit ist hoch, dass es eine Anfrage mit einem model-Feld, einem messages-Array aus {role, content}-Objekten und temperature akzeptiert und ein choices-Array mit einem usage-Block zurückgibt, der Token zählt. Diese Struktur stammt nicht von einem Gremium für Standards. Sie stammt aus der Chat Completions-API von OpenAI – und sie hat sich durchgesetzt.
Für ein Platform-Team ist der Begriff „OpenAI-kompatibel“ von zentraler Bedeutung. Er ist der Grund, warum Sie am Freitag ein neues Open-Weight-Modell evaluieren und es am Montag bereits für produktiven Traffic nutzen können, ohne Ihre Anwendung umschreiben zu müssen. Es ist aber auch ein Begriff, der leise zu viel verspricht: Zwei Endpunkte können beide „OpenAI-kompatibel“ sein und sich dennoch uneinig darüber sein, wie Tool-Aufrufe zurückgegeben werden, wie Token gezählt werden und ob der von Ihnen gesetzte Parameter überhaupt eine Wirkung hat.
Dieser Beitrag erklärt, was der Standard tatsächlich ist, was „kompatibel“ garantiert und was nicht, und wie ein Gateway viele teilweise kompatible Anbieter in einen einzigen Endpunkt verwandelt, gegen den Sie verlässlich entwickeln können.
Möchten Sie einen einzigen OpenAI-kompatiblen Endpunkt über alle Anbieter hinweg, inklusive Failover und Kostenverfolgung? Buchen Sie eine Demo.
Standards setzen sich gewöhnlich aus einem von zwei Gründen durch: Sie werden vorgeschrieben, oder sie sind zuerst da und werden übernommen, bevor jemand eine Alternative entwickelt. Das Chat Completions-Schema gehört eindeutig zur zweiten Kategorie.
OpenAI veröffentlichte den Endpunkt /v1/chat/completions und stellte entscheidenderweise offizielle Python- und JavaScript-SDKs bereit, die ihn umschlossen. Diese SDKs wurden in Tutorials, Starter-Templates, Framework-Integrationen und Produktions-Codebasen in der gesamten Branche eingebettet. Als konkurrierende Anbieter Modelle hatten, die den Betrieb wert waren, war die Integrationsfläche in der Praxis bereits standardisiert: Millionen von Codezeilen wussten bereits, wie man client.chat.completions.create(...) aufruft.
Ein neuer Anbieter stand dann vor einer Wahl: Eine eigene elegante API definieren und das gesamte Ökosystem bitten, sie zu erlernen – oder das Schema von OpenAI implementieren und jedes SDK, jedes Framework und jedes Tool kostenlos erben. Fast alle wählten den zweiten Weg. Open-Weight-Serving-Stacks übernahmen es, sodass alles, was darauf lief, sofort über bestehenden Code erreichbar war. Das Ergebnis ist ein De-facto-Standard ohne Standarddokument: Das Schema ist „alles, was das OpenAI-SDK sendet und zurückerwartet“.
Deshalb ist der Begriff wichtiger, als er aussieht. Kompatibilität ist kein Feature, das ein Anbieter für den Feinschliff hinzufügt. Es ist die Eintrittskarte in ein Ökosystem, und sie prägt, wie Sie Ihre Architektur rund um die Modellauswahl gestalten können.
Reduziert man es auf das Wesentliche, ist Kompatibilität ein Vertrag über vier Dinge: den Endpunkt, die Anfrageform, die Antwortform und das Streaming.
Der Endpunkt. Ein kompatibler Dienst akzeptiert POST /v1/chat/completions mit einem Authorization: Bearer <key>-Header. Viele implementieren auch /v1/models, /v1/embeddings und /v1/completions. Die Base-URL ändert sich je nach Anbieter; der Pfad ändert sich nicht.
Die Anfrageform. Mindestens: ein model-String und ein messages-Array von Objekten mit einer role (system, user, assistant, tool) und content. Optionale Parameter, die der Client senden kann, umfassen temperature, top_p, max_tokens (neuere OpenAI-Modelle nutzen max_completion_tokens), stream, stop, tools, tool_choice und response_format.
Die Antwortform. Ein JSON-Objekt mit einem choices-Array; jede Auswahl hat einen index, eine message mit role und content (und tool_calls, wenn das Modell eine Funktion aufruft) sowie einen finish_reason (stop, length, tool_calls, content_filter). Ein usage-Objekt meldet prompt_tokens, completion_tokens und total_tokens.
Streaming. Bei stream: true ist die Antwort ein text/event-stream aus Server-Sent Events. Jede data:-Zeile enthält einen Chunk, dessen choices[].delta das/die inkrementelle(n) Token hält. Der Stream endet mit einem wörtlichen data: [DONE].
Hier ist der konkrete Nutzen. Dieser Anfragetext zielt auf OpenAI ab:
POST https://api.openai.com/v1/chat/completions
Authorization: Bearer sk-...

{
  "model": "gpt-4.1",
  "messages": [
    {"role": "system", "content": "You are a terse assistant."},
    {"role": "user", "content": "Summarize MCP in one sentence."}
  ],
  "temperature": 0.2,
  "stream": false
}
Um den selben Prompt über einen kompatiblen Endpunkt gegen einen anderen Anbieter auszuführen, ändern Sie zwei Dinge: die Base-URL und den model-Wert. Die Felder messages, temperature und stream bleiben unberührt. Ihr Parsing-Code, der choices[0].message.content und usage.total_tokens liest, ändert sich überhaupt nicht. Das ist das gesamte Wertversprechen in einem einzigen Diff: Die Modellauswahl wird zu einem String, nicht zu einem Rewrite.
Die Antwort kommt, egal welches Backend sie bereitgestellt hat, wie folgt zurück:
{
  "id": "chatcmpl-...",
  "choices": [
    {"index": 0,
     "message": {"role": "assistant", "content": "MCP is an open protocol..."},
     "finish_reason": "stop"}
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 18, "total_tokens": 42}
}
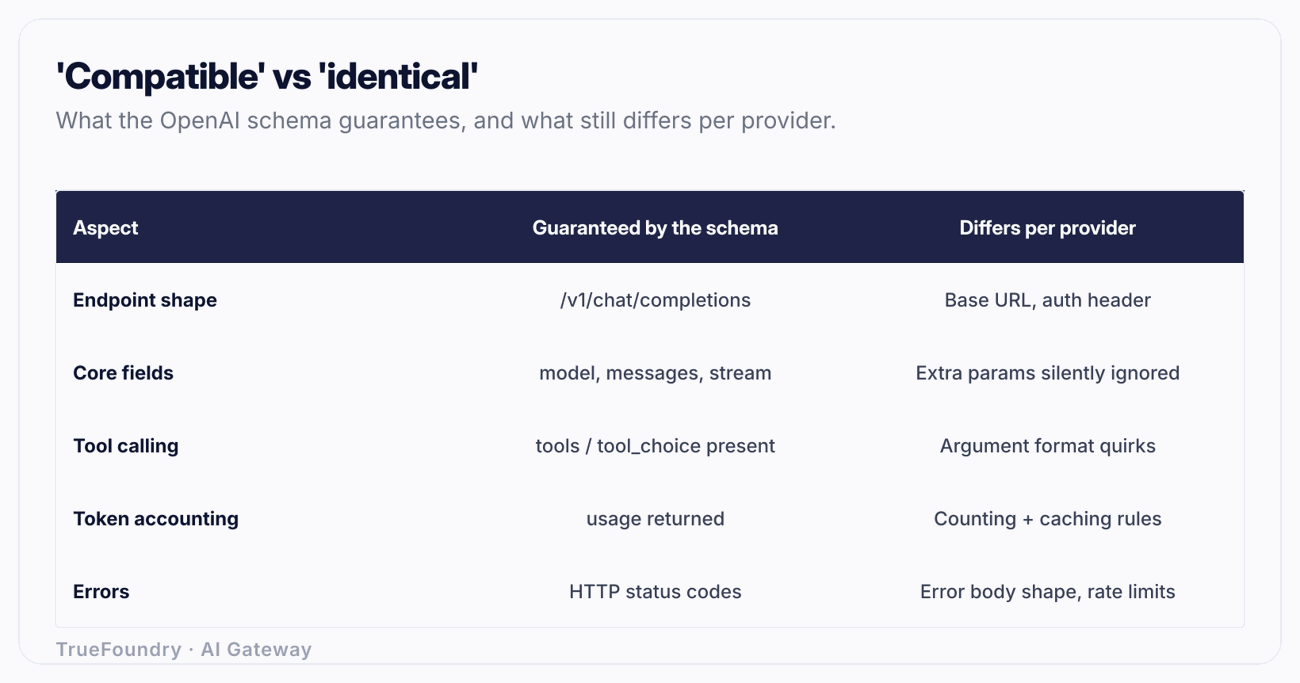
Hier geraten Teams in Schwierigkeiten. „OpenAI-kompatibel“ ist eine Aussage über das Schema, keine Garantie für identisches Verhalten. Die Hülle stimmt überein; der Inhalt kann sich auf Weisen unterscheiden, die erst unter Last oder in Grenzgruppen-Fällen auftreten.
Tool-Calling-Dialekte. Die größte Abweichung. OpenAI gibt Funktionsaufrufe in message.tool_calls zurück, jeweils mit einer id, einem type und einem function-Objekt, dessen arguments ein stringifizierter JSON-Blob ist, den Sie parsen müssen. Einige kompatible Backends geben Argumente als bereits geparstes Objekt zurück, geben das ältere einzelne function_call-Feld aus, streamen Tool-Call-Deltas unterschiedlich oder handhaben parallele Tool-Aufrufe uneinheitlich. Code, der blind JSON.parse ausführt, wirft bei einem Backend, das sie bereits geparst hat, einen Fehler.
Token-Abrechnung.usage-Zahlen werden vom eigenen Tokenizer jedes Anbieters berechnet. Derselbe Prompt, der an zwei Modelle gesendet wird, führt zu unterschiedlichen prompt_tokens-Werten, da sich die Tokenizer unterscheiden. Schlimmer noch: Einige Backends lassen usage bei Streaming-Antworten vollständig weg, sofern Sie kein Flag setzen, sodass eine darauf basierende Kostenverfolgung stillschweigend Null liest.
Stillschweigend ignorierte Parameter. Sie können seed, logit_bias, frequency_penalty, presence_penalty oder response_format: {type: "json_schema"} an einen kompatiblen Endpunkt senden und einen 200 OK zurückerhalten, wobei der Parameter komplett ignoriert wird. Der Endpunkt hat das Feld akzeptiert, weil das Schema es erlaubt; das Backend implementiert es schlichtweg nicht. Dies ist die tückischste Kategorie von Fehlern, da nichts einen Fehler ausgibt. Ihre „deterministische“ Pipeline, die sich auf seed verlässt, ist stillschweigend nicht-deterministisch.
Handhabung von System-Prompts und Rollen. Einige Backends fügen die system-Nachricht in den ersten User-Turn ein, unterstützen nur eine einzige System-Nachricht oder behandeln ein leeres content anders. Das Verhalten über mehrere Turns hinweg kann abweichen.
Semantik des Finish-Reasons. Wenn ein Modell anhält, weil es ein Tool aufrufen möchte, meldet OpenAI finish_reason: "tool_calls". Nicht jedes Backend verwendet dieselbe String-Zeichenkette, was Agenten-Loops unterbricht, die darauf verzweigen.
Die folgende Tabelle unterscheidet zwischen dem, was der Standard verlässlich garantiert, und dem, was Sie pro Provider überprüfen müssen.
Die Erkenntnis lautet nicht: „Kompatibilität ist eine Illusion.“ Sie lautet vielmehr: „Kompatibilität bringt Ihnen 90 % geschenkt, und die letzten 10 % müssen Sie pro Provider testen.“ Genau diese letzten 10 % sind die Arbeit, die ein Gateway übernehmen kann, damit Ihre Anwendung sie nie zu Gesicht bekommt.
Erfahren Sie, wie TrueFoundry Sie Modelle nach Namen tauschen lässt, ohne den Anwendungscode zu berühren. Buchen Sie eine Demo.
Wenn jeder Provider größtenteils kompatibel, aber subtil unterschiedlich ist, besteht die saubere Architektur darin, Ihre Anwendung nicht mehr direkt mit jedem Provider sprechen zu lassen. Schalten Sie einen einzigen OpenAI-kompatiblen Endpunkt vor alle Provider und überlassen Sie dieser Schicht die Übersetzung und Normalisierung.
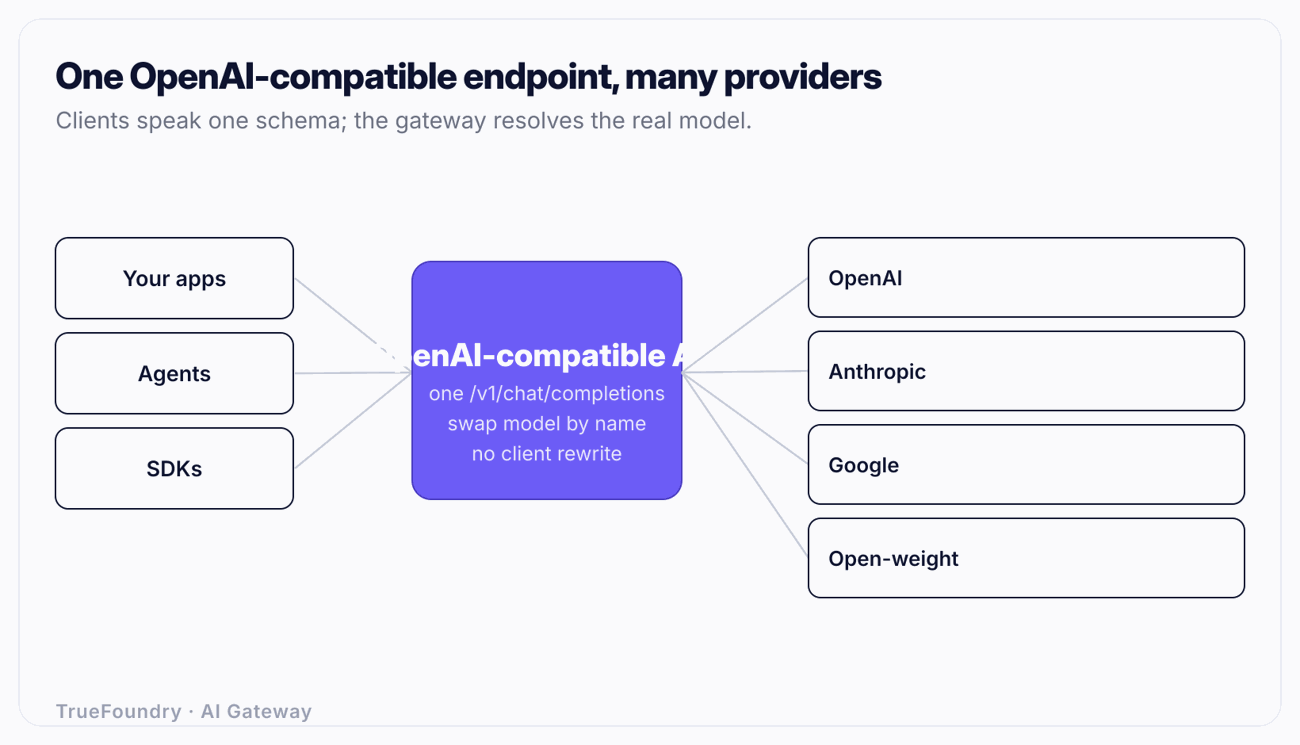
Genau das tut ein AI Gateway, und es folgt strukturell derselben Idee wie ein LLM Proxy: ein einzelnes logisches Eingangstor, viele Backends dahinter. TrueFoundry stellt eine vereinheitlichte OpenAI-kompatible API vor jedem Provider bereit. Ihre Anwendung sendet weiterhin die gewohnte Chat Completions-Struktur. Um Modelle zu wechseln, ändern Sie den model-Wert in einen logischen Namen, den das Gateway auflöst; alles andere – Request Body, SDK, Parsing – bleibt unverändert.
Da das Gateway die oben beschriebenen Unterschiede normalisiert, muss sich Ihr Code nicht mehr darum kümmern, ob ein bestimmtes Backend Tool-Call-Argumente als String zurückgibt oder usage bei Streams meldet. Das Gateway bietet einen einzigen, konsistenten Dialekt. Open-Source-Bibliotheken wie LiteLLM haben diese Übersetzungsschicht im Code popularisiert; unser Leitfaden darüber, was LiteLLM ist, erklärt diesen Ansatz und zeigt auf, wo ein verwaltetes Gateway noch weiter geht.
Der Grund für die Einführung dieses Musters ist jedoch nicht nur eine aufgeräumte Schnittstelle. Sobald jede Anfrage durch einen zentralen Endpunkt fließt, schalten Sie Funktionen frei, die sich in verstreuten Einzelintegrationen pro Provider unmöglich umsetzen lassen:
Routing. Hinter einem logischen Modellnamen können mehrere reale Ziele stehen, und das Gateway wählt basierend auf Latenz, Gewichtung oder Priorität zwischen ihnen aus. Lesen Sie, was ein LLM-Router ist, um mehr über kosten- und qualitätsbewusste Modellauswahl zu erfahren.
Fallback. Wenn ein Provider einen 500-Fehler zurückgibt oder ein Timeout auftritt, führt das Gateway noch innerhalb der Anfrage einen Retry gegen ein Ausweichziel durch. So führt ein Ausfall eines einzelnen Providers nicht zu einem Fehler bei Ihren Benutzern. Das ist das Thema von LLM Fallback.
Caching. Exaktes und semantisches Caching am Gateway reduzieren sowohl Latenz als auch Kosten für wiederholte oder nahezu identische Prompts – völlig transparent hinter demselben Endpunkt.
Observability und Kostenzuordnung. Da jede Anfrage eine zentrale Stelle passiert, erhalten Sie Kosten-, Token- und Latenzmetriken pro Anfrage, getaggt nach Benutzer, Team und Modell, die direkt in LLM Observability und die Kostenzuordnung zu Teambudgets einfließen. Eine direkte Integration pro Provider bietet Ihnen nichts davon ohne individuelle Instrumentierung für jeden einzelnen Dienst.
Für keine dieser Funktionen mussten Sie eine neue API einführen. Sie entstanden allein durch die Standardisierung auf die eine Schnittstelle, die Sie bereits nutzen. Wenn Sie Ihre Optionen abwägen, zeigt Ihnen die Auswahl eines AI Gateways die entscheidenden Kriterien auf.
Die Entscheidung ist keine Glaubensfrage; es geht darum, wie viele Provider Sie anbinden und wie wichtig Ihnen Resilienz sowie Kostentransparenz sind.
Eine direkte Integration ist vertretbar, wenn Sie exakt einen Provider aufrufen und garantiert nie einen anderen nutzen werden. In dem Moment, in dem Sie ein zweites Modell einsetzen möchten, Ausfallsicherheit benötigen oder eine zentrale Datenquelle für Ihre Kosten suchen, macht sich das Gateway bezahlt.
Annehmen, dass kompatibel identisch bedeutet. Das Schema stimmt überein; das Verhalten nicht immer. Teams portieren einen Prompt auf ein günstigeres Backend, sehen, dass es „funktioniert“, und bringen es in Produktion – nur um Wochen später festzustellen, dass seed ignoriert wurde und die Ausgaben nie reproduzierbar waren. Testen Sie die Parameter, auf die Sie angewiesen sind, explizit gegen jedes Backend.
Vertrauen auf usage für Kosten, ohne Streaming zu prüfen. Mehrere Backends lassen den usage-Block bei gestreamten Antworten weg, sofern er nicht explizit angefordert wird. Kosten-Dashboards, die darauf basieren, zeigen null an und sehen großartig aus, bis die reale Rechnung eintrifft. Überprüfen Sie, ob die Nutzungsinformationen bei genau dem Anfragestil vorhanden sind, den Sie in Produktion ausführen.
Hardcoding von Base-URL und SDK pro Provider. Dies erzeugt genau den Wildwuchs neu, den der Standard eigentlich beseitigen sollte. Jedes neue Modell wird zu einem Integrationsprojekt und jeder Provider-Ausfall zu Ihrem Ausfall. Standardisieren Sie auf einen Endpunkt und machen Sie die Modellauswahl zu einer Konfigurationssache, nicht zu Code.
Parsing von Tool-Call-Argumenten ohne Formatprüfung. Einige Backends geben arguments als String zurück, andere als Objekt. Blindes JSON.parse führt bei Letzterem zu Fehlern. Normalisieren Sie die Struktur vor dem Parsing oder überlassen Sie diese Normalisierung einem Gateway.
Das Gateway als reine Infrastruktur-Verkabelung betrachten. Der Endpunkt ist der einfache Teil. Der eigentliche Wert liegt in den Möglichkeiten, die ein zentraler Kontrollpunkt eröffnet: Routing, Fallback, Caching, Budgets und Kostenzuordnung – Dinge, die sich nicht nachträglich und kostengünstig über N direkte Integrationen stülpen lassen.
Das OpenAI Chat Completions-Schema wurde nicht durch ein Dekret zum Standard, sondern weil es als erstes verfügbar war und überall adaptiert wurde. „OpenAI-kompatibel“ ist die Eintrittskarte in dieses Ökosystem: Senden Sie die gewohnte Anfragestruktur, parsen Sie die gewohnte Antwort. Das verschafft Ihnen enormen Handlungsspielraum – die Modellauswahl wird zu einem einfachen Konfigurations-String. Voraussetzung ist jedoch, dass Sie akzeptieren, dass kompatibel nicht gleich identisch ist, und die Verhaltensweisen testen, auf die es in Ihrer Anwendung ankommt.
Der sauberste Weg, diesen Hebel ohne die Kanten und Ecken zu nutzen, besteht darin, sich auf einen einzigen OpenAI-kompatiblen Endpunkt vor jedem Provider zu standardisieren. Ihre Anwendung behält die Schnittstelle bei, die sie bereits kennt, und das Gateway absorbiert die Eigenheiten der einzelnen Provider. Gleichzeitig profitieren Sie von Routing, Fallback, Caching, Budgets und Kostenzuordnung, die Sie in verstreuten Einzelintegrationen niemals nachträglich einbauen könnten. Eine Schnittstelle nach außen; jedes Modell dahinter.
Vereinheitlichen Sie jeden LLM-Anbieter hinter einer OpenAI-kompatiblen API. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





