


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Fragen Sie einen Platform Lead, für wie viele verschiedene LLMs sein Unternehmen gerade bezahlt, und Sie werden meist ein kurzes Zögern und dann eine Vermutung zu hören bekommen. Die ehrliche Antwort lautet oft „mehr als wir denken“, denn jeder Entwickler mit einer Kreditkarte und einem API-Schlüssel kann an einem Nachmittag ein neues Modell in einen Dienst einbinden. Jede dieser Integrationen bedeutet eine separate Rechnung, eigene Anmeldeinformationen und einen eigenen Pfad für sensible Daten, um das Gebäude zu verlassen – nichts davon ist an einem zentralen Ort einsehbar.
Ein Modellkatalog ist das Steuerungselement, das diese Lücke schließt. Er ist die einzige, verwaltete Antwort auf die Frage „Welche Modelle dürfen unsere Teams aufrufen und unter welchen Regeln?“ Kein Spreadsheet mit genehmigten Anbietern, sondern eine durchgesetzte Liste, bei der jeder Eintrag die für ihn geltenden Richtlinien direkt mitführt.
Dieser Beitrag definiert den Modellkatalog präzise, zieht die scharfe Trennlinie zwischen einem Katalog und einem Modellregister (diese werden ständig verwechselt), erklärt, warum Wildwuchs gefährlich und teuer ist, und zeigt, wie ein in einem Gateway implementierter Katalog reale Richtlinien an einen logischen Modellnamen bindet.
Möchten Sie einen verwalteten Katalog genehmigter Modelle mit Budgets und Richtlinien pro Modell? Buchen Sie eine Demo.
Ein Modellkatalog ist eine kuratierte Menge von logischen Modelleinträgen. Jeder Eintrag besteht aus zwei Hälften.
Die erste Hälfte ist die Bindung (Binding): ein logischer Name (z. B. summarizer-prod), der einem oder mehreren realen Zielen (einem spezifischen Anbieter, einer Modellversion und einem Endpunkt) zugewiesen ist. Das ist dieselbe Indirektion, die Ihnen ein logischer/virtueller Modellname bietet: Anwendungen rufen den Namen auf, nicht den rohen Anbieter.
Die zweite Hälfte ist die an diesen Eintrag geknüpfte Richtlinie (Policy):
Ein Eintrag ist erst dann „im Katalog“, wenn beide Hälften existieren. Das ist der Unterschied zwischen einem Katalog und einer Liste von Modellnamen in einem Wiki: Der Katalog setzt durch, weil die Richtlinie mit dem Eintrag mitreist und bei jedem Aufruf angewendet wird.
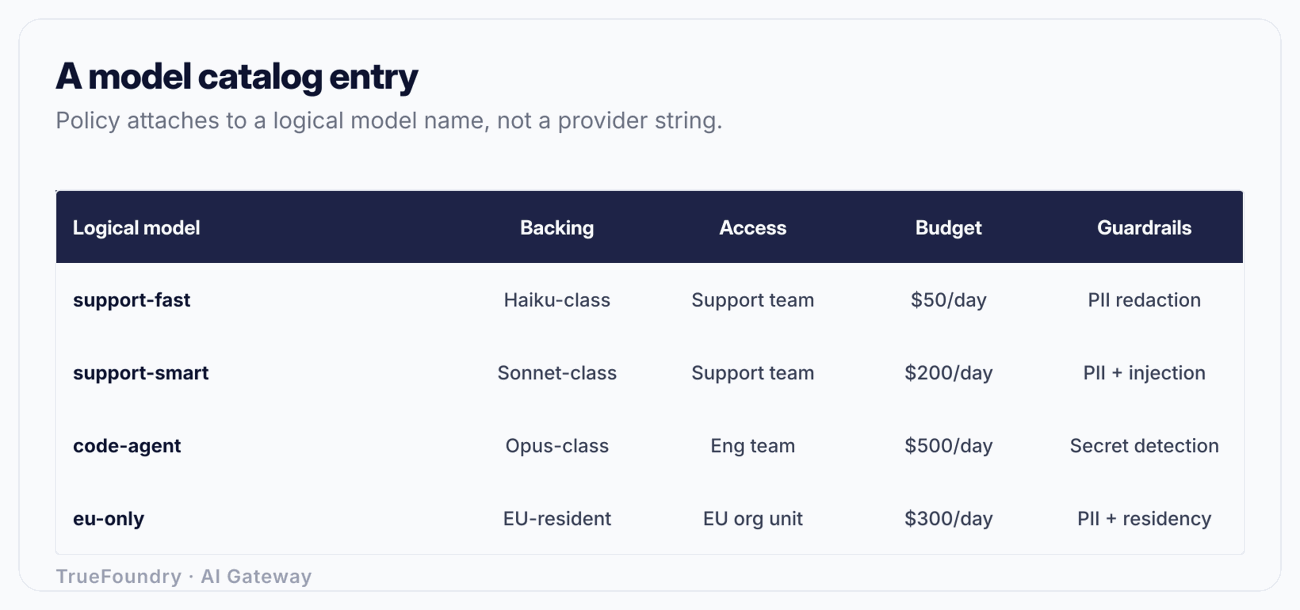
Da die Richtlinie an den logischen Namen und nicht an den Anwendungscode gebunden ist, erfolgt eine Änderung an einer einzigen Stelle. Verringern Sie das Budget eines Teams, tauschen Sie die zugrundeliegende Modellversion aus oder fügen Sie eine PII-Guardrail hinzu – jeder Dienst, der diesen logischen Namen aufruft, übernimmt die Änderung bei der nächsten Anfrage. Keine Neubereitstellungen (Redeploys), kein Durchsuchen von Repositories nach hartcodierten Modell-Strings.
Dies ist die wichtigste Klarstellung in diesem Artikel, da die Begriffe oft synonym verwendet werden, obwohl sie sich auf völlig unterschiedliche Systeme beziehen.
Ein Modellregister (Model Registry) (denken Sie an Artefakt-Register in MLOps-Tools) verwaltet trainierte Modell-Artefakte. Seine Einheit ist ein Modell, das Sie selbst produziert haben: ein Satz von Gewichten, mit Versionen, Lineage zurück zum Trainingslauf und Datensatz, Metriken und einem Lebenszyklus (Staging, Produktion, Archiviert). Sie verwenden ein Register, wenn Ihre Data Scientists Modelle trainieren und Sie diese Artefakte reproduzierbar nachverfolgen, heraufstufen und bereitstellen müssen.
Ein Modellkatalog verwaltet den Zugriff auf Modelle, die Ihre Teams nutzen. Die meisten davon haben Sie nicht selbst trainiert, wie Drittanbieter-LLM-APIs und Open-Weight-Modelle, die Sie bereitstellen. Seine Einheit ist ein genehmigter, an Richtlinien gebundener Eintrag. Sie verwenden einen Katalog, um zu steuern, wer welches Modell aufrufen darf, zu welchen Kosten, in welcher Region und unter welchen Guardrails.
Die Verwirrung ist verständlich, da sich beide mit „Modellen“ befassen, aber sie beantworten unterschiedliche Fragen. Das eine fragt: „Welche Version des Betrugserkennungsmodells haben wir bereitgestellt und aus welchem Trainingslauf stammt sie?“ Das andere fragt: „Darf das Support-Team Kundendaten an dieses LLM senden und sind wir diesen Monat über dem Budget?“ Eine ausgereifte Plattform besitzt oft beides, und beide Systeme befinden sich auf unterschiedlichen Ebenen.
Wenn Sie eine Erkenntnis aus diesem Abschnitt mitnehmen: Bei einem Register geht es um das Angebot an Modellen, die Sie bauen; bei einem Katalog geht es um die verwaltete Nachfrage nach Modellen, die Ihre Teams nutzen. Die Wahl des falschen Werkzeugs für ein Governance-Problem hinterlässt Ihnen einen wunderbar versionierten Artefakt-Speicher, aber keinerlei Kontrolle über die OpenAI-Rechnung.
Ohne einen Katalog wächst die Modellnutzung organisch – was gesund klingt, aber tatsächlich das Problem ist. Drei Fehlermodi sind die Folge, und sie verstärken sich gegenseitig.
Schattenmodelle. Ein Entwickler fügt einen neuen Anbieter hinzu, um ein Feature auszuliefern. Es funktioniert, also bleibt es bestehen. Niemand hat es genehmigt, die Sicherheitsabteilung hat es nie überprüft, und es taucht in keinem Inventar auf. Multiplizieren Sie das über ein Jahr hinweg mit jedem Team, und Sie haben eine Flotte unbekannter Integrationen – jede davon ein potenzieller Pfad für Datenexfiltration –, die keine einzelne Person aufzählen kann. Was man nicht sieht, kann man nicht steuern.
Überraschende Rechnungen. Wenn jeder Dienst seinen eigenen API-Schlüssel hält, sind die Ausgaben über Anbieterrechnungen hinweg ohne gemeinsame Tags verteilt. Die monatliche Rechnung kommt als eine einzige große Zahl an, und niemand kann ohne forensische Untersuchungen beantworten, welches Team für den Anstieg um 40 % verantwortlich war. Kosten, die nicht zugeordnet werden können, können nicht kontrolliert werden – was die gesamte Prämisse von FinOps für KI darstellt.
Compliance-Lücken. Dies ist die Art von Fehler, die Karrieren beendet. Eine ungesteuerte Integration sendet EU-Kundendaten an ein Modell, das in einer US-Region läuft, und verletzt damit eine Residenzzusage. Oder rohe Prompts mit PII gelangen ohne Schwärzung im Pfad an einen Anbieter. Oder eine Anwendung lässt ein Secret in einen Prompt einfließen, das dann anbieterseitig protokolliert wird. Jede Lücke entsteht, weil es keinen Durchsetzungspunkt zwischen der Anwendung und dem Modell gab.
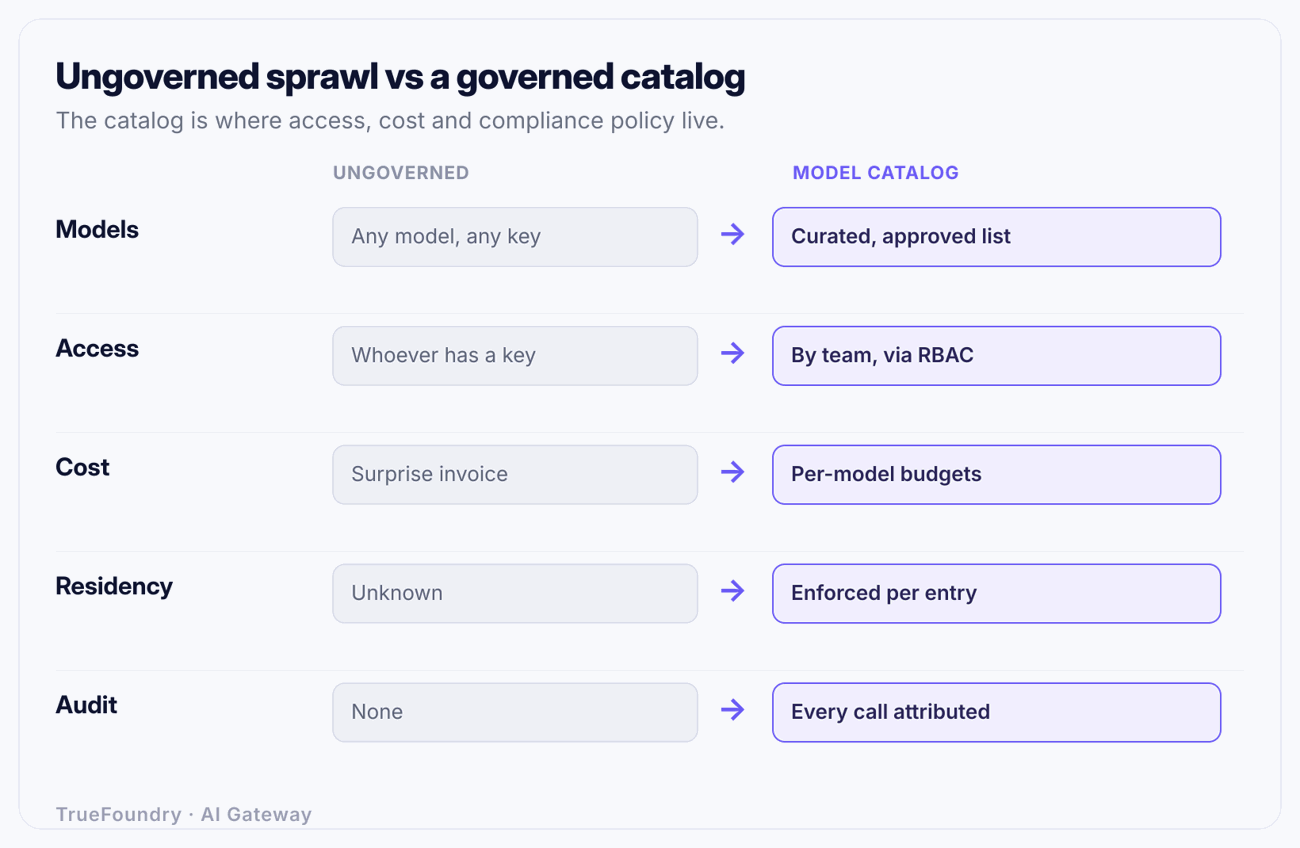
Die gemeinsame Ursache ist das Fehlen eines zentralen Kontrollpunkts (Chokepoint). Eine direkte Verdrahtung von App zu Anbieter bedeutet, dass es keinen einzigen Ort gibt, um die Nutzung einzusehen, Kosten zuzuordnen oder Richtlinien durchzusetzen. Ein Katalog, der in einem Gateway implementiert ist, führt diesen Kontrollpunkt wieder ein, ohne den Teams die Modellauswahl zu nehmen: Sie bedienen sich weiterhin selbst, aber aus einem genehmigten, verwalteten Bestand.
Erfahren Sie, wie TrueFoundry Zugriffs-, Kosten- und Residenzrichtlinien an jedes Modell knüpft. Buchen Sie eine Demo.
Der Katalog ist nur so nützlich wie seine Durchsetzung, und diese Durchsetzung ist der Grund, warum er in das AI Gateway gehört und nicht in ein Dokument. Strukturell ist dies derselbe Kontrollpunkt, den ein LLM-Proxy bietet: Jede Anfrage passiert einen einzigen Ort, sodass Richtlinien bei jedem Aufruf angewendet werden können.
Hier ist, was bei einer einzelnen Anfrage passiert, wenn sich der Katalog im Gateway befindet. Ein Dienst ruft das logische Modell support-assistant auf. Das Gateway:
support-assistant steht. Wenn nicht erlaubt, wird die Anfrage abgelehnt.Jeder dieser Schritte bezieht sich auf die Richtlinie des Eintrags, nicht auf den Code im aufrufenden Dienst. Das ist der entscheidende Punkt. Die Anwendung sendet einen Namen; das Gateway setzt alles durch, was an diesen Namen gebunden ist. Ändern Sie die Bindung (neue Modellversion) oder die Richtlinie (niedrigeres Budget, zusätzliche Guardrail) im Katalog, und die nächste Anfrage befolgt sie – ganz ohne Anwendungsänderung.
Dies macht den Katalog auch zum natürlichen Ort für die Kontrollmechanismen, die in Governance-Tools dokumentiert sind. Rate Limits und Budgets werden in LLM Token Rate Limiting und Budgets detailliert beschrieben; die Zuordnung, die Budgets erst sinnvoll macht, findet sich in LLM-Kostenzuordnung und Team-Budgets; Sicherheitsprüfungen befinden sich in AI Guardrails; und die Durchsetzung der Residenz liegt in Datenresidenz. Im Katalog werden diese Richtlinien spezifischen Modellen zugewiesen, und er fügt sich in das breitere Spektrum an AI Governance Tools ein.
TrueFoundry setzt genau dies um: Einen Modellkatalog, bei dem jeder logische Modellname seine Zugriffskontrolle, sein Budget, seine Rate Limits, seine Residenz und seine Guardrails mitführt – durchgesetzt am Gateway bei jeder Anfrage, mit Observability pro Anfrage, getaggt nach Benutzer, Team und Modell. Da die Data Plane in Ihrer eigenen VPC, On-Premises oder Air-Gapped laufen kann, ist Residenz kein Versprechen auf einem Dashboard, sondern eine Eigenschaft des physischen Datenflusses.
Konkret könnte der Eintrag für support-assistant wie folgt aussehen: Logischer Name support-assistant, gestützt durch eine spezifische Anbietermodell-Version; Zugriff beschränkt auf die Teams Support und CX; Budget 2.000 USD/Monat; Rate Limit 50.000 Tokens/Minute pro Team; Residenz auf die EU festgelegt; Guardrails PII-Schwärzung und Prompt-Injection-Erkennung, aktiv für Ein- und Ausgabe. Ein Entwickler im Support-Team ruft support-assistant auf und erhält ein verwaltetes Modell – ohne Kenntnis über den Anbieter, die Region oder die Limits. Einem Entwickler in einem anderen Team, der denselben Namen aufruft, wird der Zugriff verweigert. Das ist Self-Service und Governance zugleich.
So sieht ein kleiner, aber realistischer Katalog aus. Jede Zeile ist ein logischer Eintrag; die Spalten stellen die daran gebundenen Richtlinien dar. Die Zahlen dienen der Veranschaulichung.
Wenn Sie eine Zeile waagerecht lesen, können Sie für dieses Modell jede Governance-Frage beantworten: wer, wie viel, wie schnell, wo und wie sicher. Lesen Sie eine Spalte senkrecht nach unten, können Sie eine einzelne Dimension über alle Modelle hinweg auditieren, zum Beispiel: „Welche Modelle sind an die EU gebunden?“ Diese bidirektionale Transparenz ist das, was ein Katalog bietet und was ein Haufen verstreuter API-Schlüssel niemals liefern kann.
Verwechslung von Katalog und Register. Teams richten ein Modellregister ein, versionieren alles perfekt und können trotzdem nicht steuern, wer die OpenAI-API aufruft oder was sie kostet – weil ein Register Artefakte verwaltet, die Sie trainieren, und nicht den Zugriff auf Modelle, die Sie nutzen. Entscheiden Sie, welches Problem Sie haben, bevor Sie ein Tool auswählen.
Behandlung des Katalogs als statische Liste. Eine Seite für genehmigte Modelle in einem Wiki ist kein Katalog; es ist eine Dokumentation, die niemand durchsetzt. Der Wert liegt in der Durchsetzung bei jeder Anfrage. Wenn die Liste einen unautorisierten Aufruf oder einen Prompt, der gegen Residenzregeln verstößt, nicht blockiert, ist sie eine Empfehlung, keine Kontrolle.
Anbindung von Richtlinien an den Anwendungscode statt an den Modellnamen. Wenn Sie eine Budgetprüfung oder eine Region in jedem Dienst hartcodieren, erhalten Sie verstreute, inkonsistente und nicht auditierbare Richtlinien, die abweichen, sobald jemand vergisst, sie hinzuzufügen. Binden Sie Richtlinien an das logische Modell im Katalog, sodass jeder Aufrufer sie erbt und Änderungen an einem zentralen Ort wirksam werden.
Kosten steuern, aber keine Daten. Budgets und Rate Limits sind die einfache Hälfte. Die teuren Ausfälle sind Compliance-Fehler: Daten, die eine Region verlassen, oder PII, die ungeschwärzt beim Anbieter ankommt. Ein Katalog, der Ausgaben kontrolliert, aber nicht Residenz und Guardrails, lässt karrieregefährdende Lücken offen.
Keine Zuordnung pro Anfrage. Wenn die Nutzung nicht zum Zeitpunkt des Aufrufs nach Benutzer, Team und Modell getaggt wird, sind Budgets nicht durchsetzbar und die monatliche Rechnung bleibt ein Rätsel. Die Zuordnung muss dort erfolgen, wo der Datenfluss stattfindet – am Gateway – und darf nicht später mühsam aus Anbieterrechnungen rekonstruiert werden.
Ein Modellkatalog verwandelt die Frage „Welche Modelle dürfen wir nutzen und unter welchen Regeln?“ von einer unbeantwortbaren Frage in eine verwaltete, durchgesetzte Liste. Jeder Eintrag ist ein logischer Modellname, der seine eigene Zugriffskontrolle, sein Budget, seine Rate Limits, seine Residenz und seine Guardrails mitführt. Da die Richtlinie an den Namen gebunden ist, ändern Sie sie an einer Stelle und jeder Aufrufer befolgt sie. Entscheidend ist: Ein Katalog ist kein Modellregister – der eine steuert den Zugriff auf genutzte Modelle, das andere versioniert selbst trainierte Artefakte.
Der Grund für die Implementierung in einem Gateway ist die Durchsetzung. Eine Liste in einem Wiki dokumentiert Absichten; ein Katalog am zentralen Kontrollpunkt, den jede Anfrage passiert, lehnt unautorisierte Aufrufe tatsächlich ab, drosselt Teams bei Budgetüberschreitung, hält EU-Daten in der EU und schwärzt PII, bevor sie das System verlässt. So gewähren Sie Teams Self-Service-Zugriff auf Modelle und halten gleichzeitig Kosten, Zugriff, Residenz und Sicherheit unter Kontrolle – anstatt die Lücken erst auf der Rechnung oder bei einem Audit zu entdecken.
Steuern Sie über einen einzigen Katalog, welche Modelle Ihre Teams nutzen dürfen. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





