


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Das Model Context Protocol (MCP) wird oft als „USB-C für KI“ beschrieben – eine eingängige Analogie, die jedoch kaum weiterhilft, wenn man tatsächlich einen Agenten mit einer Datenbank verbindet. Die Stecker-Metapher verbirgt das entscheidende Element: das Bauteil am Kabel, das das Protokoll spricht. Bei MCP ist dieses Bauteil der Client.
Wenn Sie KI-Agenten entwickeln oder betreiben, ist der Client genau die Komponente, die Sie um 2 Uhr morgens debuggen werden, wenn ein Tool-Aufruf hängt, wenn ein OAuth-Token mitten in der Sitzung abläuft oder wenn ein Server ein Tool anbietet, das Ihr Host dem Modell nie zur Verfügung stellt. Genau zu verstehen, was der Client tut – und was er nicht tut –, entscheidet darüber, ob Sie MCP als Magie betrachten oder als Infrastruktur betreiben.
Dieser Beitrag definiert den MCP-Client präzise: seine Rolle in der Dreiecksbeziehung aus Host, Client und Server, den Verbindungs-Lifecycle Schritt für Schritt, wie sich Clients authentifizieren, wo Clients tatsächlich ausgeführt werden und warum Sie bei jeder ernsthaften Skalierung ein Gateway zwischen Ihre Clients und Ihre Server schalten.
Möchten Sie einen zentral gesteuerten Endpunkt für jeden MCP-Client in Ihrer Organisation statt verstreuter Konfigurationen? Buchen Sie eine Demo.
MCP umfasst drei Rollen – und sie zu verwechseln, ist die häufigste Ursache für Missverständnisse.
Ein Host ist die KI-Anwendung, mit der der Benutzer interagiert. Er verwaltet das Sprachmodell (oder die Verbindung zu einem), die Konversation und die Entscheidung darüber, welche Tools dem Modell wann zur Verfügung gestellt werden. Claude Desktop ist ein Host. Cursor ist ein Host. Ein eigener Agent, den Sie mit einem SDK geschrieben haben, ist ein Host.
Ein Client ist ein Protokoll-Konnektor, den der Host instanziiert. Seine einzige Aufgabe besteht darin, eine Verbindung zu einem Server aufrechtzuerhalten und zwischen der internen Welt des Hosts und dem MCP-Protokoll zu übersetzen. Die Beziehung ist 1:1: ein Client, ein Server. Ein Host, der sich mit fünf Servern verbindet, führt fünf Clients aus. Jeder Client verwaltet seinen eigenen Sitzungsstatus, seine eigenen Funktionen (Capabilities) und seine eigenen Credentials.
Ein Server stellt Funktionen, Tools (Funktionen, die das Modell aufrufen kann), Ressourcen (lesbare Daten wie Dateien oder Datenbankzeilen) und Prompts (wiederverwendbare Vorlagen) über das Protokoll bereit. Ein GitHub MCP-Server stellt create_issue und list_pull_requests bereit. Ein Postgres-Server stellt ein Abfrage-Tool und Tabellenressourcen bereit.
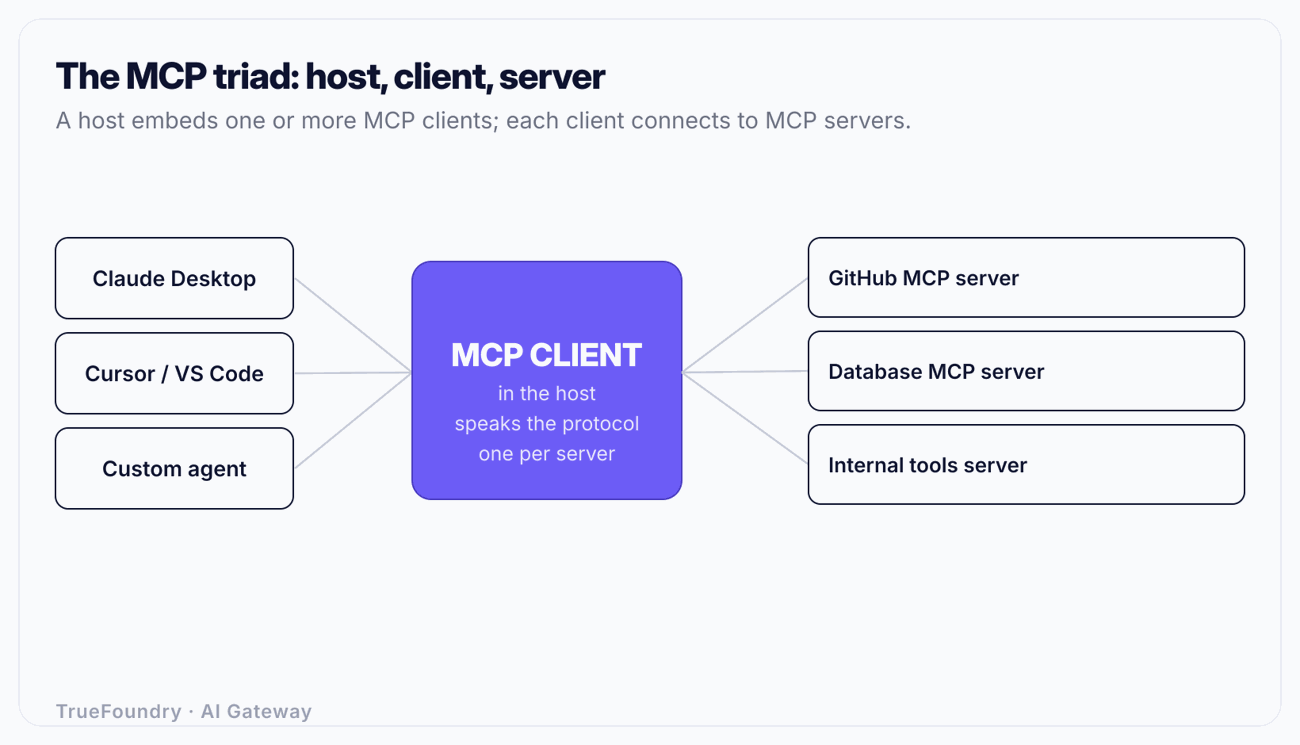
Diese Trennung ist wichtig, weil sich die Verantwortlichkeiten nicht überschneiden. Der Host legt die Richtlinien fest („Soll dem Modell erlaubt werden, delete_repo aufzurufen?“). Der Client setzt das Protokoll durch („Ist dieser Server initialisiert? Ist die Funktion angekündigt?“). Der Server führt die Arbeit aus und liefert ein Ergebnis zurück. Wenn etwas fehlschlägt, beheben Sie es in der Ebene, zu der es gehört. Ein Tool, das dem Modell nie angezeigt wird, ist meist ein Host-Problem. Ein Tool, das angezeigt wird, aber beim Aufruf einen Fehler erzeugt, ist meist ein Client- oder Server-Problem.
Die 1:1-Regel ist kein Zufall. Jede MCP-Verbindung ist eine zustandsbehaftete Sitzung mit ausgehandelten Funktionen. Server A unterstützt möglicherweise Ressourcen-Abonnements; Server B tut dies vielleicht nicht. Server A authentifiziert sich mit einem GitHub OAuth-Token; Server B nutzt Datenbank-Credentials. Indem jede Verbindung ihren eigenen Client erhält, bleibt dieser Status isoliert – so kann eine Funktion oder ein abgelaufenes Token auf einer Verbindung keine andere beeinträchtigen. Der Host übernimmt die Rolle des Multiplexers: Er verteilt eine einzelne Benutzeranfrage an die jeweils benötigten Clients, sammelt die Ergebnisse und führt sie dem Modell wieder zu.
Sieht man von den Metaphern ab, kümmert sich ein konformer MCP-Client um fünf konkrete Aufgaben.
Transport. Er stellt die Verbindung her und hält sie aufrecht. MCP definiert zwei standardmäßige Transportarten: stdio, bei dem der Client den Server als Subprozess startet und über Standard-Input/Output kommuniziert, sowie Streamable HTTP, bei dem der Client HTTP-Anfragen an eine Server-URL sendet und einen Stream von Server-Sent Events über die Antwort empfangen kann. Lokale Tools (ein Dateisystem-Server auf Ihrem Laptop) nutzen typischerweise stdio. Remote-Tools (ein gehosteter Dienst) nutzen HTTP.
Message Framing. Jede MCP-Nachricht ist JSON-RPC 2.0. Der Client erstellt Anfrage-Objekte mit einem id, einer method und params, ordnet Antworten über id ihren jeweiligen Anfragen zu und leitet vom Server initiierte Benachrichtigungen weiter. Wenn Sie jemals den rohen MCP-Datenverkehr beobachtet haben: Es handelt sich schlicht um einen Stream von JSON-RPC-Hüllen.
Aushandlung von Funktionen (Capability Negotiation). Beim Verbindungsaufbau sendet der Client initialize mit der von ihm gesprochenen Protokollversion und den von ihm unterstützten Funktionen (z. B. ob er Sampling-Anfragen oder Elicitation verarbeiten kann). Der Server antwortet mit seinen eigenen Angaben. Ab diesem Handshake wissen beide Seiten, was zulässig ist. Ein Client, der versucht, eine vom Server nie angekündigte Funktion zu nutzen, enthält einen Bug.
Aufruf (Invocation). Wenn der Host entscheidet, dass das Modell ein Tool aufrufen soll, sendet der Client tools/call mit dem Tool-Namen und den Argumenten, wartet auf das Ergebnis und gibt es zurück. Dasselbe gilt für resources/read und prompts/get.
Lifecycle und Cleanup. Der Client verwaltet die Sitzung vom Handshake bis zum Shutdown – einschließlich Token-Aktualisierung, Wiederverbindung und dem sauberen Abbau der Verbindung, wenn der Host sie schließt.
Beachten Sie, was nicht auf dieser Liste steht: Die Entscheidung, ob ein Tool-Aufruf sicher ist, das Entfernen von Secrets aus einem Ergebnis oder das Stoppen eines unkontrollierten Agenten, der dasselbe Tool 400-mal aufruft. Das sind Aufgaben des Hosts und der Governance. Das Basisprotokoll liefert die Verbindungen, nicht die Richtlinien. Genau in dieser Lücke müssen Enterprise-Kontrollen ansetzen, die später behandelt werden.
Eine Client-Verbindung durchläuft eine feste Sequenz. Das Verständnis dieser Sequenz verwandelt die meisten MCP-Fehler in die einfache Frage: „Welcher Schritt ist fehlgeschlagen?“
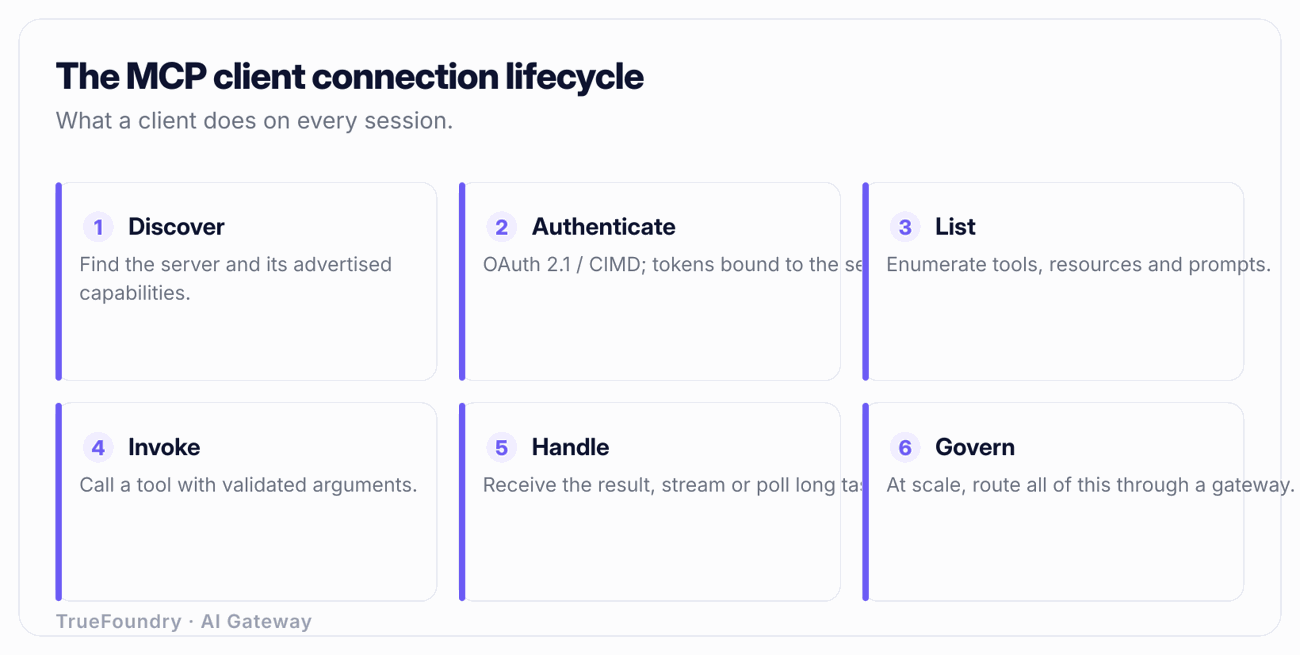
1. Ermitteln (Discover). Der Client benötigt einen Server, mit dem er sich verbinden kann. Für einen lokalen stdio-Server ist die „Ermittlung“ ein Konfigurationseintrag: ein Befehl und Argumente zum Starten. Für einen Remote-Server ist es eine URL. In größeren Deployments erfolgt die Ermittlung dynamisch: Der Client fragt eine Registry oder ein Gateway ab, welche Server existieren und wie deren Endpunkte lauten, anstatt jeden einzeln fest zu verdrahten.
2. Authentifizieren. Bei Remote-HTTP-Servern muss der Client seine Identität nachweisen, bevor der Server antwortet. Das Autorisierungsmodell von MCP basiert auf OAuth 2.1. Der Client ermittelt den Autorisierungsserver aus Protected-Resource-Metadaten (RFC 9728), registriert sich optional dynamisch (RFC 7591), führt den Authorization-Code-Flow mit PKCE (RFC 7636) aus und fügt das erhaltene Bearer-Token jeder Anfrage bei. Lokale stdio-Server erben das Vertrauen in der Regel von der Prozessgrenze und überspringen dies.
3. Initialisieren. Der Client sendet die initialize-Anfrage: seine Protokollversion, Client-Informationen und Funktionen. Der Server antwortet mit seiner Protokollversion, Server-Informationen und Funktionen. Sind die Versionen inkompatibel, schlägt die Verbindung an dieser Stelle sauber fehl – was weit besser ist, als erst drei Tool-Aufrufe später abzustürzen. Anschließend sendet der Client eine initialized-Benachrichtigung, um zu bestätigen, dass die Sitzung aktiv ist.
4. Funktionen auflisten. Der Client ruft tools/list auf und bei Bedarf resources/list sowie prompts/list. Der Server liefert für jedes Tool den Namen, die Beschreibung und das JSON-Schema für dessen Eingabe zurück. Dies ist der Katalog, den der Host dem Modell anzeigt. Server können später auch eine listChanged-Benachrichtigung senden, wenn sich ihr Tool-Angebot ändert, woraufhin ein ordnungsgemäß funktionierender Client die Liste erneut abfragt.
5. Aufrufen. Der Host wählt ein Tool aus (meistens weil das Modell es angefordert hat), und der Client sendet tools/call mit validierten Argumenten. Ein lang laufender Aufruf kann Zwischenergebnisse streamen. Der Client ordnet die Antwort über id der ursprünglichen Anfrage zu.
6. Ergebnis verarbeiten. Der Client gibt das Tool-Ergebnis an den Host zurück, welcher es für das Modell formatiert. MCP-Ergebnisse enthalten ein Flag, das zwischen einem Fehler auf Tool-Ebene (das Tool wurde ausgeführt und schlug fehl, z. B. „Repository nicht gefunden“) und einem Fehler auf Protokoll-Ebene (der Aufruf selbst war fehlerhaft) unterscheidet. Diese beiden Fälle gleich zu behandeln, ist ein häufiger Client-Bug: Ein „Nicht gefunden“ ist eine Information für das Modell, während ein Protokollfehler etwas ist, das Ihr Code abfangen muss.
7. Herunterfahren (Shutdown). Wenn der Host fertig ist, schließt der Client den Transportweg: Er beendet den Subprozess bei stdio oder schließt die HTTP-Sitzung bei Remote-Verbindungen.
Stellen Sie sich einen Coding-Agenten vor, der aufgefordert wird: „Öffne ein Issue mit dem Titel 'Flaky CI' im api-Repo.“ Die Sequenz innerhalb des Hosts lautet:
tools/list; dieser enthält create_issue mit einem Schema, das owner, repo und title erfordert.create_issue({owner: "acme", repo: "api", title: "Flaky CI"}).tools/call, der Server erstellt das Issue und gibt {issue_number: 412, url: "..."} als fehlerfreies Ergebnis zurück.Bei jedem dieser Schritte kann etwas schiefgehen: ein abgelaufenes Token (Schritt 1), eine Abweichung vom Schema, die das Modell falsch erraten hat (Schritt 3), ein serverseitiger Berechtigungsfehler, der einen Tool-Fehler zurückgibt (Schritt 4). Wenn Sie den Lifecycle kennen, wissen Sie genau, wo Sie suchen müssen.
Frühe MCP-Verbindungen waren meist lokale stdio-Server, bei denen die Authentifizierung implizit erfolgte. Remote-Server haben dies geändert, und das Protokoll hat sich auf OAuth 2.1 standardisiert, anstatt das Rad neu zu erfinden.
Konkret geht ein Remote-Client wie folgt vor:
Die Spezifikationsüberarbeitung vom 28.07.2026 setzte eine klare Richtung fort: hin zu zustandlosem Streamable HTTP, bei dem ein Server eine langlebige Sitzung nicht an einen einzelnen Prozess binden muss, und hin zu expliziter Serveridentität über Mcp-Name-Header, damit Clients und Intermediäre einen bestimmten Server eindeutig benennen und ansteuern können. Ein zustandsloser Transport ist operational entscheidend, da er Servern die horizontale Skalierung hinter einem Load Balancer ermöglicht. Für eine tiefere Betrachtung von Token-Flows, Audience-Binding und Fehlermodi lesen Sie unseren Leitfaden zur MCP-Authentifizierung.
Die praktische Erkenntnis: Ein Client ist nur so sicher wie seine Token-Verarbeitung. Ein Client, der Bearer-Tokens protokolliert, die Token-Audience nicht validiert oder Token nicht sauber erneuert, wird entweder Credentials offenlegen oder Sitzungen abbrechen. Dies sind Aufgaben des Clients, und sie sind isoliert nur schwer korrekt umzusetzen – ein weiterer Grund, warum sich eine zentrale Abwicklung bei zunehmender Skalierung durchsetzt.
„MCP-Client“ klingt abstrakt, bis man merkt, dass man wahrscheinlich schon mehrere genutzt hat. Hier sind die gängigen Varianten und was sie genau darstellen.
Die wichtige Nuance in dieser Tabelle: In jedem Fall ist der Client eine Komponente auf Bibliotheksebene innerhalb des Produkts. Claude Desktop ist der Host; die Komponente, die tatsächlich JSON-RPC mit dem GitHub-Server spricht, ist ein Client-Objekt, das der Host erstellt hat. Wenn Sie einen eigenen Agenten mit einem MCP-SDK schreiben, instanziieren Sie dieses Client-Objekt selbst und rufen connect(), list_tools() sowie call_tool() direkt auf.
Das erklärt auch, warum sich derselbe Server auf unterschiedlichen Hosts leicht verschieden verhält. Der Server ist identisch; die Clients unterscheiden sich jedoch darin, wie aggressiv sie Tools neu auflisten, wie sie Tool-Fehler an das Modell weitergeben und wie sie die Authentifizierung handhaben. „Es funktioniert in Claude Desktop, aber nicht in meinem Agenten“ ist fast immer ein Unterschied im Client-Verhalten, nicht im Server.

Erfahren Sie, wie TrueFoundry Auth, Discovery und Audit für jeden Agenten und MCP-Client zentralisiert. Buchen Sie eine Demo.
Verbindet man einen Client mit einem Server, ist MCP einfach. Betrachten wir nun die Realität: 200 Entwickler, 30 interne MCP-Server, jeder Host versucht seine eigenen OAuth-Tokens zu verwalten, jeder Server ist unter einer eigenen URL erreichbar und ein Sicherheitsteam möchte genau nachvollziehen, wer welches Tool aufgerufen hat.
Das Modell der direkten Verbindung stößt schnell an seine Grenzen:
Die Lösung folgt demselben Muster, das bereits das Chaos bei LLM-APIs behoben hat: Schalten Sie ein Gateway dazwischen. Ein MCP-Gateway bietet jedem Client einen einzigen Endpunkt. Der Client authentifiziert sich einmalig gegenüber dem Gateway; das Gateway verwaltet und rotiert die Credentials für die nachgelagerten Server. Die Ermittlung wird dynamisch: Der Client fragt die MCP-Registry des Gateways ab, welche Ressourcen existieren, anstatt eine statische Liste mitzuführen. Und da jeder Aufruf über eine zentrale Stelle läuft, erhalten Sie Governance, Zugriffskontrolle, Rate-Limits und Audit-Logs, die das Protokoll selbst nicht bietet.
Architektonisch entspricht dies einem LLM-Proxy: ein logischer Zugangspunkt, viele Backends dahinter, Durchsetzung von Richtlinien in der Mitte. Die Aufgabe des Clients wird dadurch einfacher: Er verbindet sich mit einem bekannten Endpunkt unter Verwendung einer einzelnen Credential und überlässt die Verteilung dem Gateway.
Für regulierte Umgebungen, in denen Tools auf interne Systeme mit sensiblen Daten zugreifen, ist dies unverzichtbar. Sie benötigen Enterprise-MCP-Governance: Zugriffskontrolle pro Team darüber, welche Server und Tools erreichbar sind, vollständige Auditierung jedes Tool-Aufrufs und die Möglichkeit, Zugriffe zentral zu widerrufen. Das MCP-Gateway und die Registry von TrueFoundry bieten genau das: Clients erhalten einen einzigen Endpunkt, Authentifizierung und RBAC werden zentral durchgesetzt, jeder Tool-Aufruf ist beobachtbar und getaggt, und die Server-Ermittlung läuft über eine gesteuerte Registry statt über verstreute Konfigurationsdateien. Wenn Sie Optionen evaluieren, behandelt unsere Übersicht der besten MCP-Gateways die jeweiligen Vor- und Nachteile, während MCP-Server-Hosting das Betreiben der Server selbst abdeckt.
Den Host als Client behandeln. Teams sagen oft: „Cursor ist mein MCP-Client.“ Cursor ist der Host; er enthält Clients. Diese Unterscheidung ist beim Debugging entscheidend: Ein Tool, das das Modell nie erreicht, beruht auf einer Entscheidung der Host-Seite, während ein Tool, das beim Aufruf Fehler wirft, ein Client- oder Server-Problem ist. Wer beides verwechselt, sucht in der falschen Ebene.
Den initialize-Handshake ignorieren. Entwickler, die eigene Clients schreiben, senden manchmal ein tools/call, bevor die Capability Negotiation abgeschlossen ist, oder setzen eine Funktion voraus, die der Server nie angekündigt hat. Das Ergebnis sind sporadische, schwer nachvollziehbare Fehler. Der Handshake ist keine Formalsache, sondern der Vertrag. Halten Sie ihn ein, um unzuverlässiges Verhalten zu vermeiden.
Tool-Fehler mit Protokoll-Fehlern verwechseln. Ein MCP-Ergebnis signalisiert, ob das Tool selbst fehlgeschlagen ist (ein 404-Fehler, den das Modell sehen und verarbeiten sollte) oder ob ein fehlerhafter Aufruf vorliegt (ein Problem in Ihrem Code). Clients, die diese Fälle zusammenlegen, verbergen entweder nützliche Signale vor dem Modell oder stürzen bei behebbaren Zuständen ab.
Server-URLs und Credentials in jedem Client hartkodieren. Das funktioniert bei drei Servern, bricht aber bei dreißig zusammen. Statische Konfigurationen bedeuten, dass jede Rotation und jede Änderung fleet-weite Anpassungen erfordert. Dynamische Discovery über eine Registry ist der einzige Weg, der skaliert.
Jeden Client sein eigenes OAuth verwalten lassen. OAuth 2.1 mit PKCE und Token-Refresh lässt sich leicht unbemerkt falsch implementieren – mit durchgesickerten Tokens in Logs, fehlender Audience-Validierung oder fehlerhaftem Refresh. Die Zentralisierung der Auth an einem Gateway bedeutet, dass Sie sie einmal korrekt implementieren, anstatt N-mal mit N Bugs.
Der MCP-Client ist die unscheinbare Komponente, die den agentischen Einsatz von Tools überhaupt erst möglich macht: Er hält die Verbindung, handelt Funktionen aus, authentifiziert und steuert jeden Tool-Aufruf über JSON-RPC. Wenn das mentale Modell stimmt – der Host verwaltet die Richtlinien, der Client verwaltet die Leitung, der Server führt die Arbeit aus –, verliert MCP seinen magischen Schein und wird zu etwas, das Sie verlässlich betreiben und debuggen können.
Bei einem Client und einem Server ist das direkte Modell völlig ausreichend. Im Enterprise-Maßstab mit Dutzenden Servern und Hunderte Anwendern verbinden Sie Clients nicht mehr direkt mit Servern, sondern schalten ein Gateway dazwischen: ein Endpunkt, zentrale Authentifizierung und Discovery sowie Governance über jeden Tool-Aufruf. Das ist die Architektur, die eine wachsende Flotte von Agenten nützlich und gleichzeitig unter Kontrolle hält.
Bieten Sie jedem MCP-Client einen einzigen sicheren Gateway-Zugang. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





