


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
OpenRouter ZDR ist das erste Feature, nach dem die meisten Teams greifen, wenn eine Sicherheitsüberprüfung klären soll, wo Prompts verbleiben. Es lohnt sich jedoch, genau zu betrachten, was es tatsächlich leistet. ZDR beschränkt Anfragen auf Provider, die keine Prompts oder Antworten speichern. Es regelt die Aufbewahrung beim Provider, nicht bei OpenRouter, und ist nur eine Kontrolle innerhalb einer umfassenderen Fragestellung, die ein AI Gateway beantworten muss: Was ist erlaubt, wo dürfen Daten liegen, was wird aufbewahrt und wer kann es im Nachhinein nachweisen?
Dieser Beitrag behandelt den Themenbereich Governance und Richtlinien aus unserer Serie TrueFoundry vs. OpenRouter: wie Richtlinien definiert, zugewiesen, getestet und versioniert werden; Allow- und Deny-Lists; Einschränkungen auf Prompt-, Tool- und Parameterebene; Datenresidenz für ruhende Daten; Logging-Policies und -Maskierung; Speicherung und Löschung sowie der Change-Audit-Trail. Er richtet sich an Platform Engineers, die diese Regeln umsetzen müssen, und an Compliance-Verantwortliche, die sie rechtfertigen müssen. Alle Aussagen stützen sich auf die öffentliche Dokumentation beider Anbieter.
OpenRouter ZDR stellt sicher, dass Provider keine Prompts oder Antworten speichern. Es kann global, pro Modellgruppe (Anthropic, OpenAI, Google, SpaceXAI und Non-Frontier) über Guardrails oder pro Request über den ZDR-Parameter erzwungen werden. Unabhängig davon leitet provider.data_collection: "deny" Anfragen nur an Provider weiter, die keine Benutzerdaten erfassen. Dies kann pro Request oder als kontoweite Standardeinstellung in den Datenschutzoptionen festgelegt werden. Beide Einstellungen werden unabhängig voneinander gesteuert, da es sich um unterschiedliche Zusagen handelt: Einige Endpunkte nutzen Ihre Daten zwar nicht für das Training, bewahren sie jedoch für Abuse-Scans oder aus rechtlichen Gründen auf. Eine Datenschutzrichtlinie von OpenRouter, die "kein Training" zusichert, entspricht daher nicht automatisch einer Richtlinie, die "keine Speicherung" garantiert.
Drei Grenzen schränken diese Kontrolle ein. ZDR erstreckt sich nicht auf aktivierte Plugins und Tools wie die Websuche, die möglicherweise von Drittanbietern mit eigenen Speicherrichtlinien betrieben werden. ZDR regelt die Speicherung beim Provider, nicht die bei OpenRouter selbst; OpenRouters eigene Inhaltsspeicherung ist ein separater Logging-Schalter auf Workspace-Ebene, der weiter unten behandelt wird. Zudem werden OpenRouter-Metadaten zu Anfragen (Zeitstempel, Modell, Token-Anzahl, Latenz) für Abrechnungs- und Betriebszwecke ohne festgelegte Dauer und ohne konfigurierbaren Zeitraum aufbewahrt. DPA-Vereinbarungen für Enterprise-Kunden decken die ZDR-Konfiguration ab, was für Compliance-Teams der richtige Ankerpunkt ist.
TrueFoundry bietet kein ZDR-Feature, was jedoch strukturelle Gründe hat und keine Lücke darstellt: Sie bringen Ihre eigenen Provider-Keys mit, sodass die Aufbewahrungsbedingungen Ihres jeweiligen Providers gelten. Die entsprechende Kontrolle besteht darin, welches Provider-Konto ein Team verwenden darf. Wo sich beide Produkte überschneiden, ist OpenRouters Zero Data Retention als Routing-Policy im Vergleich zu TrueFoundrys Provider-Account-Berechtigungen als Zugriffskontrolle (Access Policy). Genau das zieht sich durch das gesamte Thema: OpenRouter steuert den Traffic, TrueFoundry autorisiert ihn.
Die Guardrails von OpenRouter bilden die Policy Engine. Eine Guardrail ist ein benanntes Regel-Objekt, das unter Workspaces → Guardrails oder über die Management API (Erstellen, Aktualisieren, Löschen, Auflisten, Zuweisen zu Keys oder Mitgliedern) erstellt wird. Es kombiniert Budgetlimits, Modell-Allowlists, Provider-Allowlists, ZDR pro Modellgruppe, Regex-basierte Prompt-Injection-Erkennung, Sensitive Info (PII-Voreinstellungen plus NLP-Erkennung) und benutzerdefinierte Regex-Inhaltsfilter. In einer Organisation können nur Admins Guardrails verwalten; kontoweite Datenschutzrichtlinien und Provider-Einschränkungen werden vererbt, und eine Guardrail kann Einstellungen nur verschärfen. Die Kompositionsemantik ist pro Regeltyp dokumentiert, was positiv hervorzuheben ist: Allowlists werden geschnitten (die restriktivste gewinnt), ZDR wird pro Modellgruppe ODER-verknüpft, Sensitive-Info-Filter werden zusammengeführt (Blockieren schlägt Redigieren), und Budgets werden auf jeder Ebene separat geprüft anstatt zusammengeführt zu werden. Die Konfiguration erfolgt über UI-Formulare und REST; es gibt keine Policy-Sprache, kein YAML und keinen GitOps-Pfad. Pre-Rollout-Tests sind nur teilweise möglich: Eine Flag-Aktion zeichnet Treffer auf, ohne sie durchzusetzen, funktioniert jedoch nur für den Regex-Injection-Filter. PII-Regeln akzeptieren Blockieren oder Redigieren, während Budgets und Allowlists keinen Dry-Run-Modus bieten.
TrueFoundry definiert Policies als im UI erstellte Regelsätze mit YAML-Äquivalenz ("Apply as YAML" in jedem Regelformular), die unter AI Gateway → Policies in vier Familien unterteilt sind: Guardrails, Budget Limiting, Logging Config und Rate Limiting. Alle vier teilen sich ein einziges Scoping-Modell: Subjekte (Benutzer, Team, virtueller Account), Modelle einschließlich virtueller Modelle, MCP-Server und Tools, Provider-Accounts sowie X-TFY-METADATA-Schlüssel-Wert-Paare (Guardrails-Konfiguration). Für Budgets gibt es eine Simulations-API, die zurückgibt, welche Regeln auf eine hypothetische Anfrage zutreffen würden, bevor Sie sie übernehmen. Guardrails können vor der Durchsetzung im Monitor- oder Warn-Modus ausgeführt werden (Budgets simulieren). Für Fälle, die sich nicht über Formulare abbilden lassen, ermöglichen Cedar- und OPA-Policy-Guardrails das Schreiben von Regeln als Code (Cedar, OPA). Die Auswertungssemantik unterscheidet sich je nach Familie und wird exakt eingehalten: Budgets nutzen eine UND-Verknüpfung über jede passende Regel, Rate-Limits folgen dem First-Match-Wins-Prinzip, beim Logging gewinnt Deny.
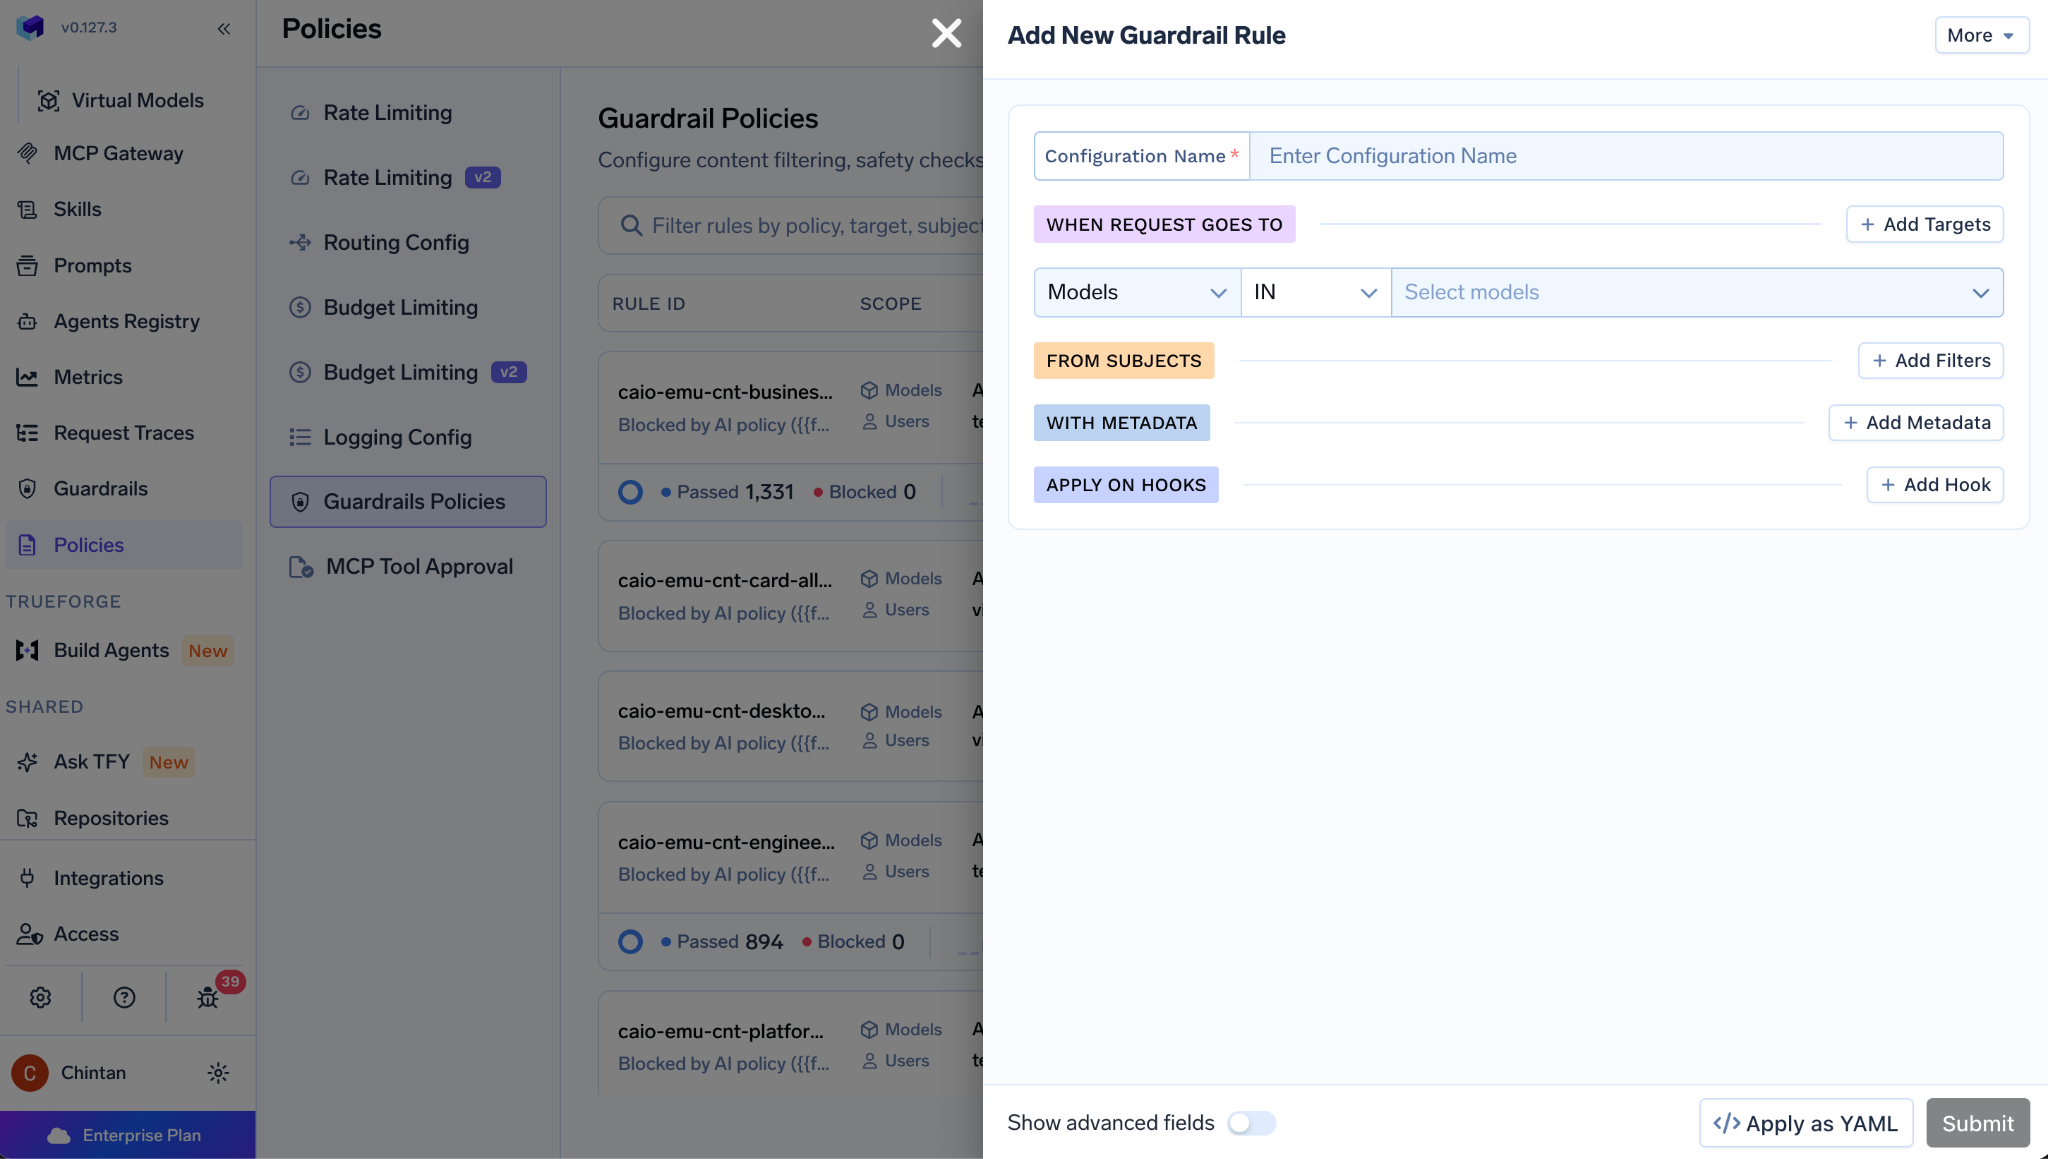
Zwei Dinge dokumentiert keiner der beiden Anbieter, was wir hier deutliche ansprechen: die Versionierung von Policy-Regeln (kein Entwurf/Veröffentlichen, kein Rollback, keine Historie) und ein Genehmigungsworkflow für Policy-Änderungen (Änderungen durch autorisierte Admins werden beim Speichern sofort wirksam, ohne Vier-Augen-Prinzip). Enterprise-API-Management-Produkte bieten hier ausgereifte Change-Management-Prozesse. Bei beiden AI Gateways fehlen diese derzeit noch.
OpenRouter bietet ausschließlich Allow-Lists. Es gibt je eine Allow-List für Modelle und Provider, wobei ein leerer Eintrag "alle erlauben" bedeutet. Eine Primitive für Deny-Lists existiert nicht. Steuerung pro Team funktioniert über Workspace-spezifische Guardrails oder Zuweisungen pro Mitglied; für Umgebungen (Environments) gibt es keinen Mechanismus, da kein Umgebungs-Objekt existiert. Die betrieblichen Kosten eines reinen Allow-List-Ansatzes sind spürbar: Wird ein neues Modell veröffentlicht, muss jede Guardrail manuell angepasst werden, um es freizugeben. Eine Deny-List würde es hingegen automatisch zulassen. Das bedeutet einen sicheren Standard, aber einen höheren Wartungsaufwand, der bei Dutzenden Anwendungen zu einer Daueraufgabe für Administratoren wird. Eine Richtlinie auf Tool-Ebene gibt es nicht; OpenRouter betreibt zwar eigene Server-Tools, es sind jedoch keine Berechtigungen, Einschränkungen oder Einwilligungskontrollen pro Tool dokumentiert, und Plugins fallen nicht unter ZDR. Auch Richtlinien auf Parameterebene sind nicht dokumentiert; Parameter wie Temperature oder max_tokens lassen sich nicht einschränken, und provider.max_price ist eine Routing-Bedingung, keine Richtlinie.
TrueFoundry unterstützt beide Richtungen. RBAC-Freigaben dienen als Allow-List (ein Team sieht und ruft nur Modelle auf, die ihm zugewiesen wurden), und Policy-Regeln ergänzen IN- und NOT IN-Bedingungen für Modelle pro Subjekt. Dies erlaubt auch umgebungsspezifische Vorgaben über Metadaten (environment: production) oder umgebungsspezifische virtuelle Accounts (Gateway-Zugriffskontrolle). Richtlinien auf Tool-Ebene richten sich gezielt an spezifische MCP-Server und einzelne Tools mit Pre-Invoke- und Post-Invoke-Hooks. Richtlinien auf Parameterebene werden über eine Metadaten-Validierungs-Guardrail durchgesetzt, die erforderliche Anfragemetadaten prüft, sowie über Cedar- und OPA-Regeln, die direkt gegen Anfragenparameter geschrieben werden können. Einen Hinweis geben wir Redakteuren wie Käufern mit: Eine konkrete Parametereinschränkung, wie das Blockieren einer Temperature über 1, sollte vorab praktisch getestet werden, bevor sie allgemein vorausgesetzt wird.
Datenresidenz betrifft ruhende Daten (Data at Rest), nicht die Netzwerkverbindung. Die beiden Anbieter beantworten hier unterschiedliche Fragen.
TrueFoundrys Data Routing (AI Gateway → Controls) bestimmt, wo Traces gespeichert werden: in einem von der Control-Plane verwalteten Speicher mit Regionenwahl bei SaaS oder in Ihrem eigenen Object Storage (Bucket und Region) bei Kundenseite. Der Enterprise-Tarif bietet zudem bedingtes Routing mit mehreren Zielen, die top-down nach Metadaten oder Aufrufer-Identität gematcht werden. So landen die Traces des EU-Teams in einem EU-Bucket und alle anderen im Standard-Bucket (Data Routing). Ein regionsspezifischer Datenspeicher ist eine echte Bereitstellungsoption und kein Single-Region-Export. Zwei Einschränkungen sind zu beachten: Metriken fließen immer an das Standardziel und werden ohne Residenzkontrolle dauerhaft aufbewahrt; und im Self-Hosted-Modus liegt die Residenz vollständig bei Ihnen, da keine Daten die eigene Infrastruktur verlassen. Für Teams, die Modelle bereits in ihrer eigenen Umgebung ausführen, behandelt unser Leitfaden zur On-Premise LLM Deployment diesen Bereich.
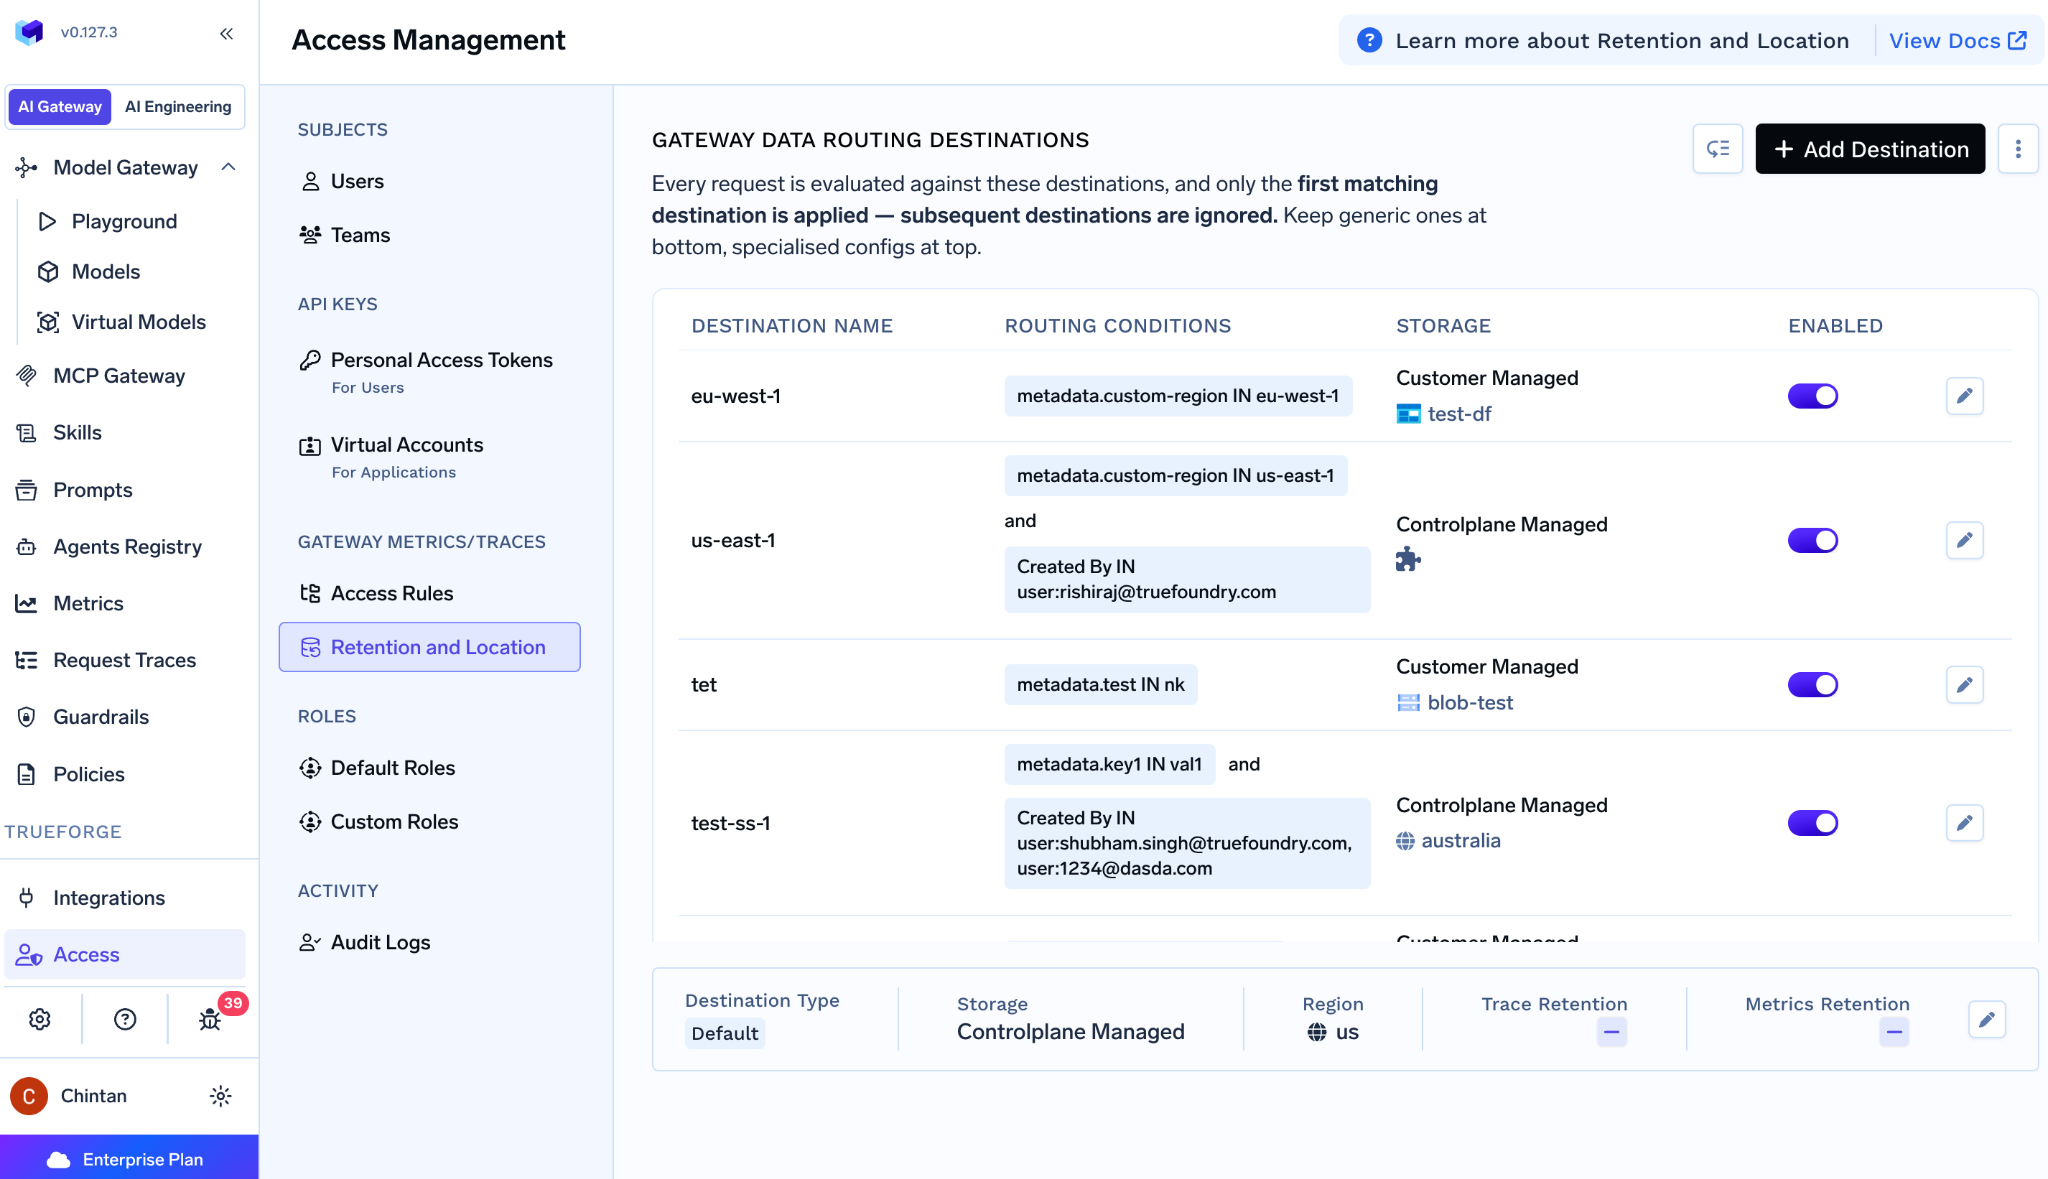
Das in-regionale Routing von OpenRouter betrifft in erster Linie den Verarbeitungsort: Für Enterprise-Kunden werden Prompts und Vervollständigungen innerhalb der ausgewählten Region (EU oder US) entschlüsselt und verarbeitet. Die Standardposition für ruhende Daten ist, dass kaum Daten dauerhaft gespeichert werden, da Inhalte nicht aufbewahrt werden. Wo jedoch die verbleibenden Metadaten liegen und in welcher Region, ist nicht dokumentiert. Das optionale Input & Output Logging speichert Inhalte in einem isolierten Google Cloud Storage-Projekt, dessen Region nicht angegeben ist. Das prägnanteste Ergebnis in diesem Bereich: Das Input & Output Logging gilt nicht für Anfragen, die über EU- oder US-Endpunkte geroutet werden. In-regionales Routing und die Speicherung von Prompt-Inhalten schließen sich also gegenseitig aus. Ein Enterprise-Käufer, der EU-Residenz verlangt, kann somit nicht gleichzeitig Prompt-Debugging oder Auditing über die Plattform nutzen.
Dies ist der am stärksten differenzierte Funktionsbereich. Daher stellen wir ihn als Matrix und nicht als einfache Ja/Nein-Gegenüberstellung dar.
TrueFoundry Logging Configs sind benannte Regeln mit UND-verknüpften Bedingungen für Subjekte, Modelle und Metadaten. Jede Regel enthält einen Schalter für das Logging (Ein/Aus) sowie Schwärzungsmuster aus einem vordefinierten Katalog (E-Mail, US-SSN, Kreditkarten, indische Aadhaar und PAN etc.) sowie benutzerdefinierte Regex mit eigenen Ersetzungstexten. Alle passenden Regeln werden ausgewertet, wobei Deny gewinnt (eine passende Regel mit deaktiviertem Logging unterdrückt den Body vollständig). Schwärzungen werden über alle passenden Allow-Regeln hinweg zusammengeführt. Die Schwärzung gilt nur für die gespeicherte Kopie; die Live-Anfrage an den Provider wird durch dieses Feature niemals verändert. Ein X-TFY-LOGGING-CONFIG-Header pro Request dient als Fallback, wenn keine Regel greift. Metadaten, Kosten, Token-Anzahl und Latenz werden immer aufgezeichnet. Jeder Trace speichert zudem tfy.logging.prompt_logging_enabled und matched_config_names, sodass die Logging-Entscheidung selbst nachvollziehbar bleibt (Logging Config). Die direkte Antwort: Logging-Entscheidung pro Request: ja; Maskierung vor der Speicherung: ja; Anpassung nach Team, Entwickler, Modell, Umgebung und Regex-Match: ja.
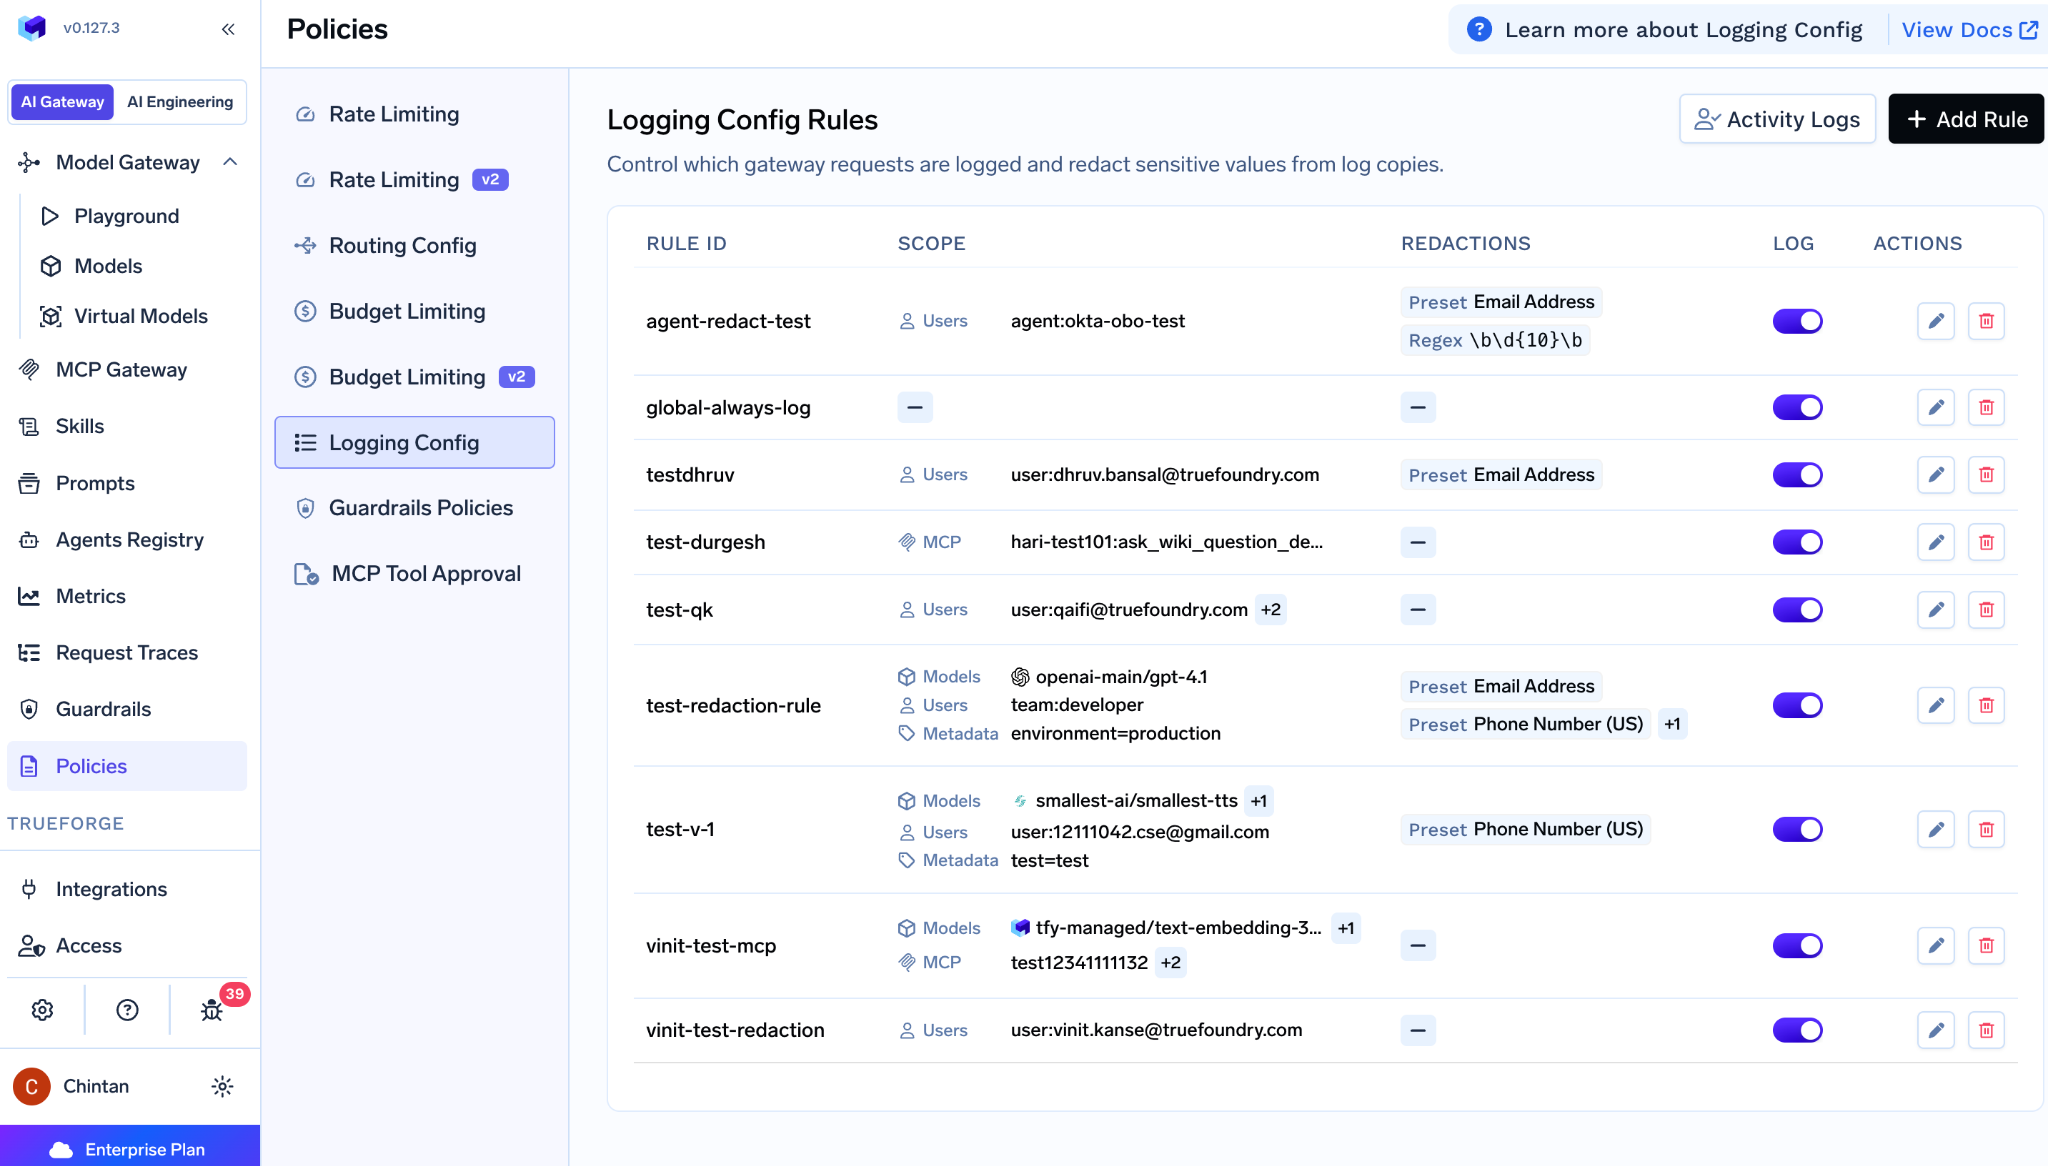
All dies wird auf einer zustandslosen Gateway-Ebene mit etwa 3–4 ms zusätzlicher Latenz und über 350 Anfragen pro Sekunde pro vCPU über mehr als 2.500 LLMs hinweg erzwungen.
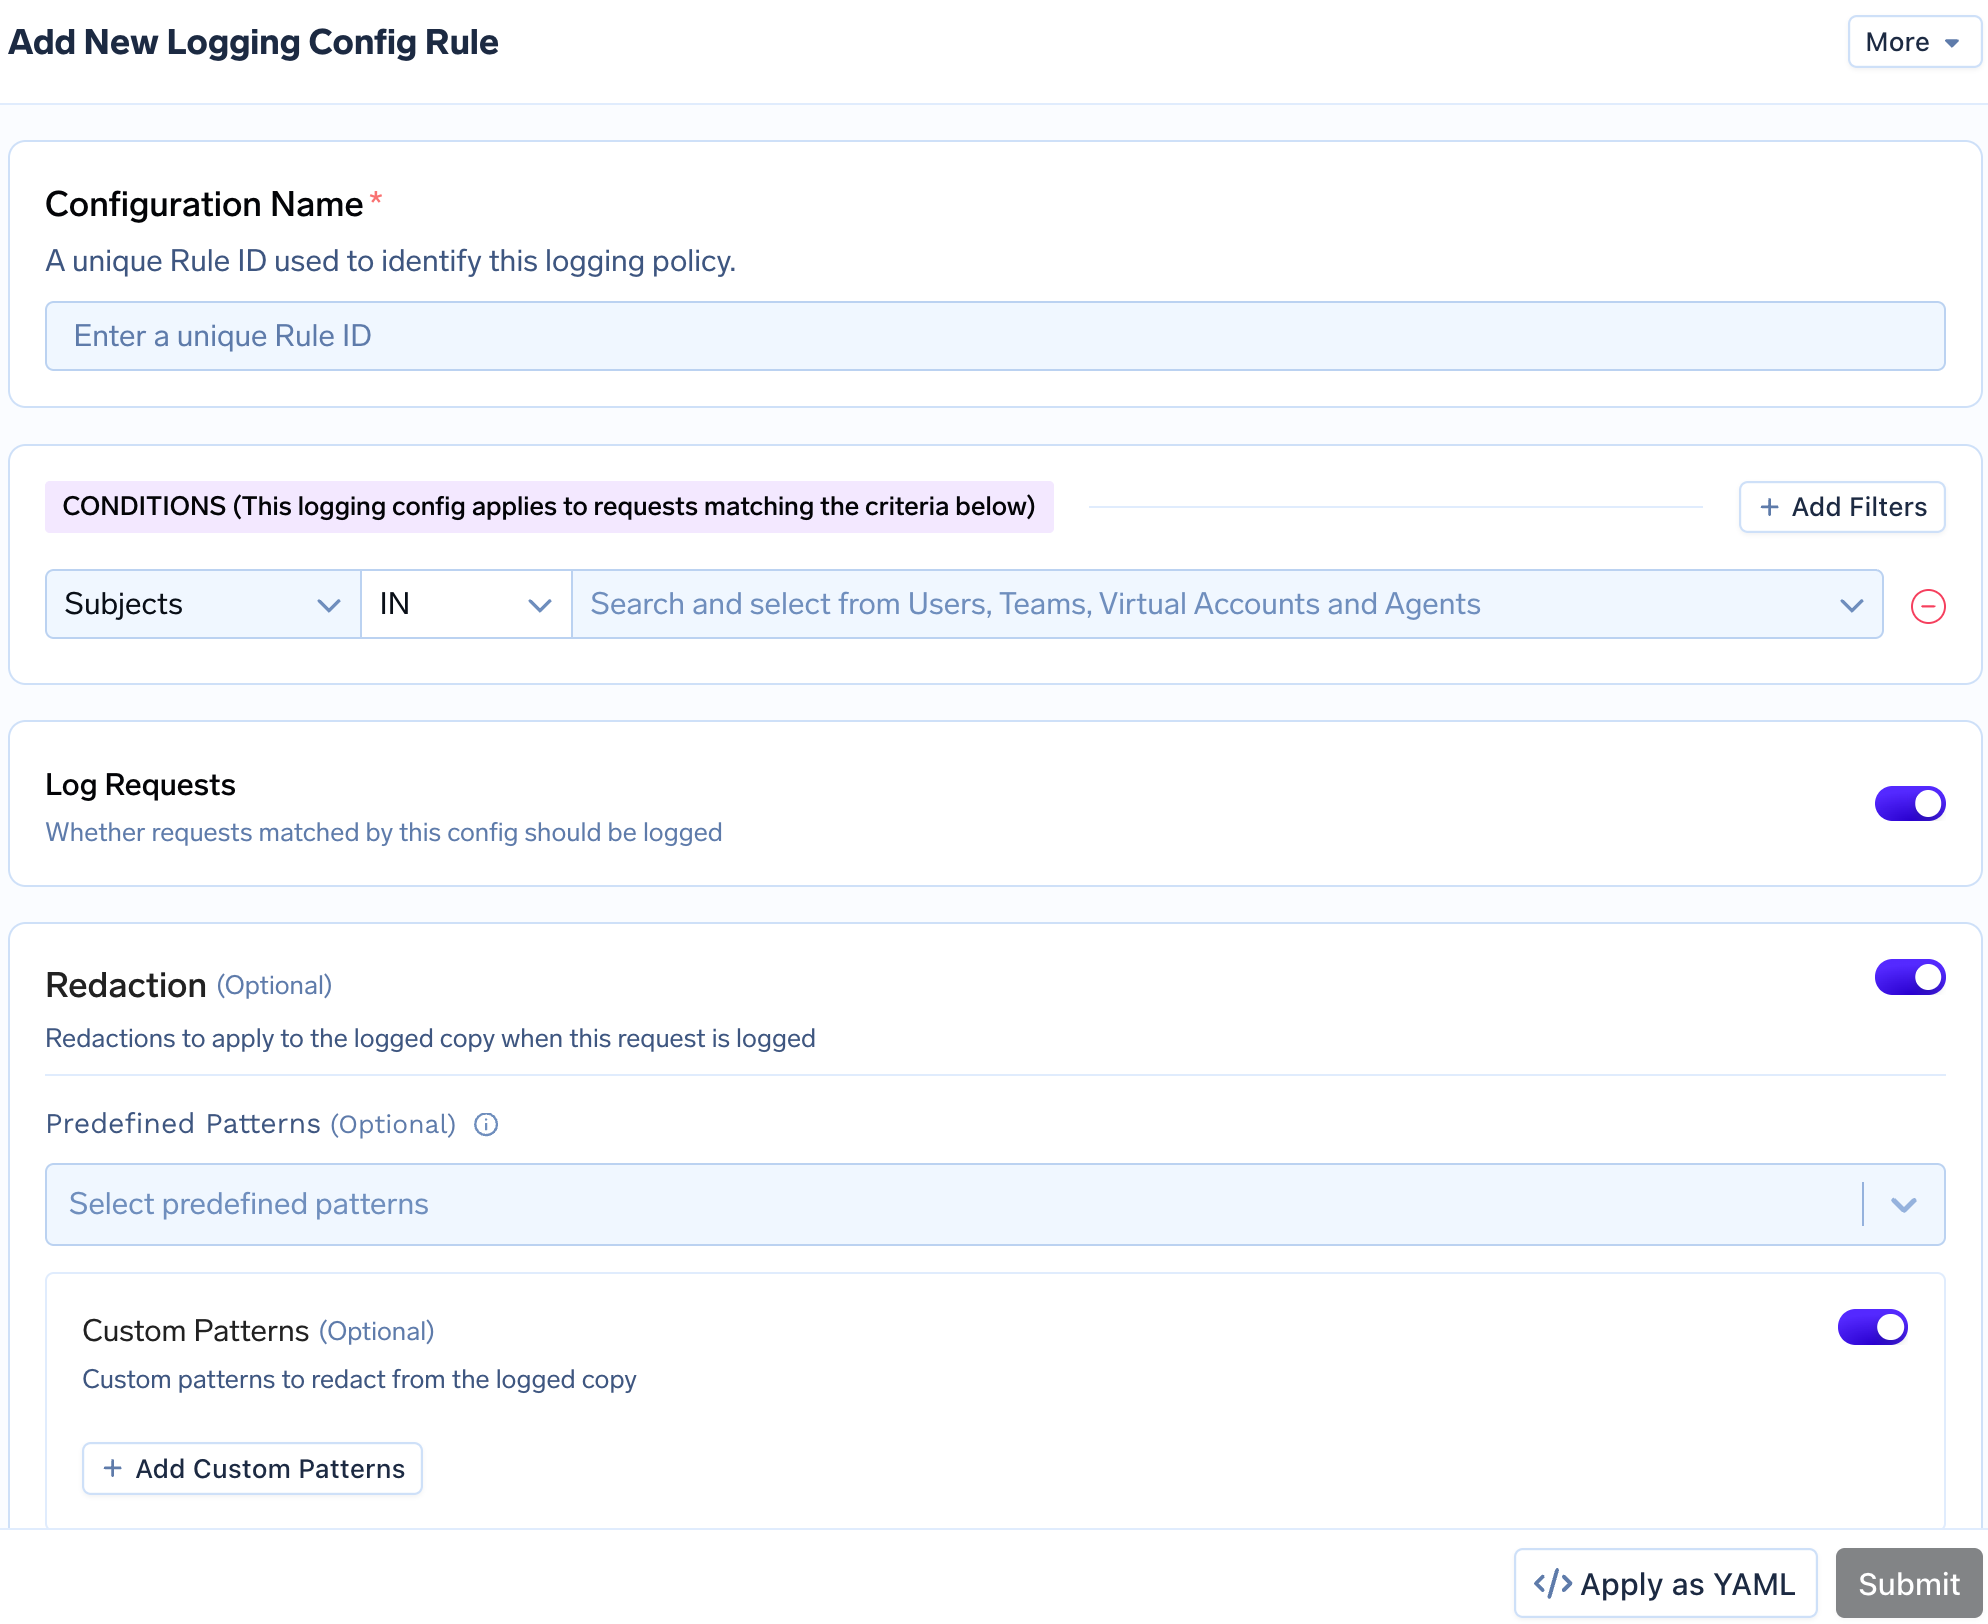
OpenRouter: Entscheidung pro Request, ob geloggt wird: nein, da Input & Output Logging ein Schalter auf Workspace-Ebene ist, den nur Admins ändern können. Maskieren vor dem Logging: nein. Variation nach Team: nur insoweit, als ein Workspace einem Team entspricht. Nach Entwickler, Modell, Umgebung oder Regex-Match: nein. Eine Abgrenzung sollte man beachten: Die Schwärzung, die OpenRouter bietet (Sensitive Info-Voreinstellungen und benutzerdefinierte Regex), modifiziert die Live-Anfrage, bevor der Provider sie sieht. Das ist eine Schwärzung zum Zeitpunkt der Anfrage (Request-Time Redaction), die wir im Sicherheits-Beitrag behandeln, und keine Maskierung zum Zeitpunkt des Loggings (Log-Time Masking). Sie können nicht konfigurieren: "Alles loggen, aber diesen Teil maskieren", unabhängig davon, was der Provider erhält, da beides über dieselbe Kontrolle gesteuert wird. Der ZDR-Parameter regelt die Speicherung beim Provider, nicht das Logging von OpenRouter, und sollte nicht mit einer Logging-Policy verwechselt werden.
Die Speicherdauer (Retention) von Traces bei TrueFoundry lässt sich pro Data-Routing-Ziel konfigurieren, mit einer Standard-Policy, falls nichts eingestellt ist. Metriken werden dauerhaft aufbewahrt und sind nicht konfigurierbar. Das Recht auf Löschung (Right-to-Erasure) einzelner geloggter Anfragen ist nicht als internes Produkt-Workflow dokumentiert; bei kundenverwaltetem Storage besitzen Sie den Bucket selbst, sodass die Löschung technisch in Ihrer Hand liegt. Zum Admin-Audit-Trail äußern wir uns klar: Die Audit-Sprache unserer Dokumentation bezieht sich auf Agenten- und Anfragenaktivitäten. Ein Protokoll darüber, wer welche Policy wann geändert hat (inklusive Export), ist nicht dokumentiert, obwohl die Preisseite Audit-Logs für Enterprise aufführt. Lassen Sie sich diese Funktion im Zweifel vorführen, anstatt sich nur auf das Datenblatt zu verlassen (Data Routing, Preise).
OpenRouters Standard für die Inhaltsspeicherung ist "keine"; Metadaten werden für Abrechnungszwecke ohne angegebene Dauer und ohne konfigurierbaren Zeitraum aufbewahrt. Aufbewahrungsfristen für gespeicherte Prompts sowie das Recht auf Löschung sind nicht dokumentiert. Ein Audit-Log existiert: In der Dokumentation zu SCIM Group Mappings wird angegeben, dass beim Löschen einer Gruppe im Identity Provider und dem damit verbundenen Zugriffsverlust von Mitgliedern diese Entfernungen dort aufgezeichnet werden. Umfang, Aufbewahrung, Ansicht und Export sind jedoch nicht dokumentiert. Es gibt keine eigene Audit-Log-Seite, und ob das Protokoll auch Konfigurationsänderungen wie Guardrail-Edits abdeckt oder nur Mitgliedschaftsänderungen, ist nicht bekannt. Der Activity Export erstellt Nutzungsdaten als CSV oder PDF, gruppiert nach Modell, Key oder Mitglied. Dabei handelt es sich um einen Nutzungsbericht, nicht um ein Audit von Konfigurationsänderungen. Wie ein AI Audit Trail in ein umfassenderes Governance-Programm passt, erläutert unser Beitrag zu AI Governance.
Die Angaben zu TrueFoundry stammen aus unserer Dokumentation; die Angaben zu OpenRouter spiegeln den öffentlich dokumentierten Funktionsstand zum Zeitpunkt der Erstellung dieses Beitrags wider.
Egal für welchen Anbieter Sie sich entscheiden: Haken Sie bei Richtlinienversionierung, Genehmigungsprozessen und exportierbaren Admin-Audit-Trails nach. Keiner von beiden dokumentiert diese Punkte derzeit vollständig. Eine Übersicht über den gesamten Markt finden Sie in unserem Leitfaden zu OpenRouter-Alternativen.
OpenRouter ZDR ist eine klar definierte Kontrolle für einen Bereich, den die meisten Gateways nicht abdecken können: die Aufbewahrungsrichtlinien von Providern, mit denen Sie keine direkten Verträge haben. Zudem bietet OpenRouter Guardrails mit den transparentesten Kompositionsregeln in dieser Kategorie. Die Grenzen liegen in einem flachen Identitätsmodell, reinen Allow-Lists, fehlenden Tool- oder Parameter-Policies und einem Logging-Schalter, der nur für den gesamten Workspace gilt. TrueFoundrys Governance ist eine echte Policy Engine: ein einheitliches Scoping-Modell über Budgets, Limits, Guardrails und Logging hinweg; YAML, Cedar und OPA; Deny-Lists; Hooks auf Tool-Ebene; bedingte Datenresidenz sowie eine Logging-Matrix, die ihre eigenen Entscheidungen nachvollziehbar aufzeichnet. Beide Anbieter lassen bei den drei erwähnten Enterprise-Funktionen noch Fragen offen. Für ein Platform-Team, das seine Entscheidungen lückenlos belegen muss, ist das Ergebnis in diesem Bereich jedoch eindeutig.
Um zu sehen, wie eine Logging-Policy, eine Deny-List und ein regionsspezifisches Trace-Routing zusammen konfiguriert werden, testen Sie das TrueFoundry AI Gateway oder buchen Sie eine Demo, wenn Sie aktuell die Governance für ein teamübergreifendes Rollout planen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





