


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
LiteLLMが人気を博したのには正当な理由があります。MITライセンスで提供され、1つのOpenAI互換APIの裏で100以上のプロバイダーをサポートし、数分でインストールでき、小さなチームがほぼ労力をかけずに「3つのSDKで3つのプロバイダーを呼び出す」状態から「1つのエンドポイントを呼び出す」状態へと移行できます。多くのプロジェクトにとって、これは最初の選択肢として適切であり、本記事の内容もそれを否定するものではありません。
チームがそこから移行する理由は構造的なものであり、予測可能なスケールで表面化します。数十人のエンジニアが百人に増え、1つのアプリが30個に増え、「念のため支出を把握しておこう」という段階から「財務部門がチームごとのコストを必要とし」「セキュリティ部門が監査ログを必要とする」段階へ変化したとき、単一プロセスのPythonプロキシは本来想定されていない役割に対して過剰な負担を抱えるようになります。さらに2026年にLiteLLMの配布チェーンで発生したサプライチェーンインシデントも加わり、「動けばいい」という議論から「モデルへのアクセス権は誰が管理し、それをどのように証明するか?」という議論へとシフトしています。
本記事はLiteLLMの欠点を批判するものではなく、実用的な移行プレイブックです。LiteLLMの許容量を超えたことを示す具体的なサインを特定し、すべてのLiteLLMの概念をガバナンスを備えたGatewayの同等機能にマッピングし、双方ともOpenAI互換APIに対応しているという特性を生かしたリスクの低い段階的な切り替え手順を解説します。ほとんどの場合、アプリケーションコードの変更はベースURLの1行のみです。
LiteLLMの限界を感じていますか?ベースURLの変更だけでガバナンスを備えたGatewayへ移行する方法をご覧ください。デモを予約する。
移行のきっかけを正確に把握しましょう。曖昧な「スケールしなかった」という話は計画の役に立ちません。具体的な障害モードを知ることが重要です。
GILによるスループットの天井。 LiteLLMのプロキシはPythonで作られています。Pythonのグローバルインタプリタロック(GIL)は、1つのプロセスが一度に1つのスレッドでのみPythonバイトコードを実行することを意味します。主にプロバイダーからの応答を待つI/O集中型のプロキシでは、並列度が低い場合にはこれで十分ですが、並列リクエストが増加すると、リクエスト処理、シリアライズ、ロギング、ポリシーチェックがその単一のロックを奪い合うことになり、どれだけハードウェアを追加してもレイテンシが上昇しスループットが伸び悩みます。多数のプロセスやインスタンスに分散(シャード)させることは可能ですが、今度はそのオーケストレーションや共有状態の管理という課題が発生します。
シークレットの集中と被害影響範囲(爆発半径)。 プロキシは前段に配置されたすべてのプロバイダーのAPIキーを保持します。これがプロキシの本来の役割ですが、1つのプロキシが侵害されたり、1つの設定ファイルが漏洩したりするだけで、OpenAI、Anthropic、クラウドモデルのエンドポイントなど、すべてが一度に露出することを意味します。中央集中型のシークレット管理、ローテーション、スコープ設定されたアクセスがない場合、インシデント発生時の被害影響範囲は「すべて」に及びます。
デプロイの分散とパッチ適用。 実行が非常に簡単なため、LiteLLMはあらゆる場所で実行されることになります。各開発者のラップトップに1つ、CIに1つ、本番環境にいくつか、といった形です。脆弱性が発見された場合、すべてのインスタンスを見つけてパッチを適用しなければなりません。「すべての呼び出し元が1つの管理されたエンドポイントを経由する」という単一のコントロールプレーンが存在しないため、「プロキシへのパッチ適用」が宝探しのような作業になってしまいます。
セルフホストHA(高可用性)の負担。 1つのプロキシを実行するのは簡単です。しかし、フェイルオーバー、ダウンタイムなしのアップグレード、ヘルスチェック、SLAに基づく水平スケーリングを備えて運用することは、完全に自社で負担しなければならないプラットフォーム運用作業となります。多くのチームが、このような差別化につながらない煩雑な作業は労力に見合わないと感じる段階に達します。
2026年に発生した2つのイベントにより、これらの構造的な懸念は緊急の課題へと変化しました。恐れることなく、事実を明確に整理しておきましょう。
2026年3月、CIの侵害により悪意のあるLiteLLMのリリース(バージョン1.82.7および1.82.8)がPyPIに公開されました。この悪意のあるパッケージは、それらをインストールしたシステムから資格情報を窃取しました(公式のDockerイメージは影響を受けませんでした)。2026年10月には、2つ目のインシデントとして、窃取されたGitHubトークンを使用して悪意のあるリリース(1.107.0)がPyPIとDockerの両方にプッシュされました。これとは別に、LiteLLMでは複数のCVEが報告されており、これにはCISAのKnown Exploited Vulnerabilities(既知の悪用された脆弱性)カタログに掲載されたもの(APIキー保持者が悪用可能なリモートコード実行のパス)や、任意のベアリートークンでMCPセッションを確立できてしまう問題が含まれていました。
いずれのケースにおいても修復手順は同じでした。バージョンの固定、信頼できる正常なリリースからの再構築、およびすべてのシークレットのローテーションです。ここでの教訓は「LiteLLMが安全ではない」ということではありません。オープンソースプロジェクトはその利用者の多さゆえにターゲットにされやすいのです。重要な教訓は、シークレットの集中とバージョンの分散が組み合わさると、単一のサプライチェーンイベントが組織全体のインシデントへと拡大するということであり、これこそがバージョン、シークレット、アクセスを中央で一元管理し監査可能にするガバナンスを備えたコントロールプレーンが必要とされる理由です。すべての呼び出し元があらかじめ、ローテーションされスコープの絞られた資格情報と完全な監査ログを持つ単一の管理されたエンドポイントを経由していれば、依存関係が侵害された場合でも影響の封じ込めははるかに容易になります。
ガバナンスを備えたAI Gatewayは、LiteLLMが提供していた価値(複数プロバイダーを跨ぐ1つのOpenAI互換エンドポイント)をそのまま維持しながら、軽量プロキシが重視していなかったレイヤーを追加します:
TrueFoundryはこれを単一のコントロールプレーンとして提供します。重要な点として、SaaS、VPC内、オンプレミス、あるいはエアギャップ環境にもデプロイ可能であり、データプレーンは自社ネットワーク内に留まるため、「ガバナンス」のために「トラフィックをサードパーティに引き渡す」必要はありません。全般的な選定基準についてはAI Gatewayの選び方を、アーキテクチャの概要についてはLLMプロキシの役割と機能を参照してください。
TrueFoundryがLiteLLMのキー、予算、モデルをガバナンスポリシーにどのようにマッピングするかをご覧ください。デモを予約する。
移行は意図的に段階的に進められます。組織全体を一度に切り替えることはありません。
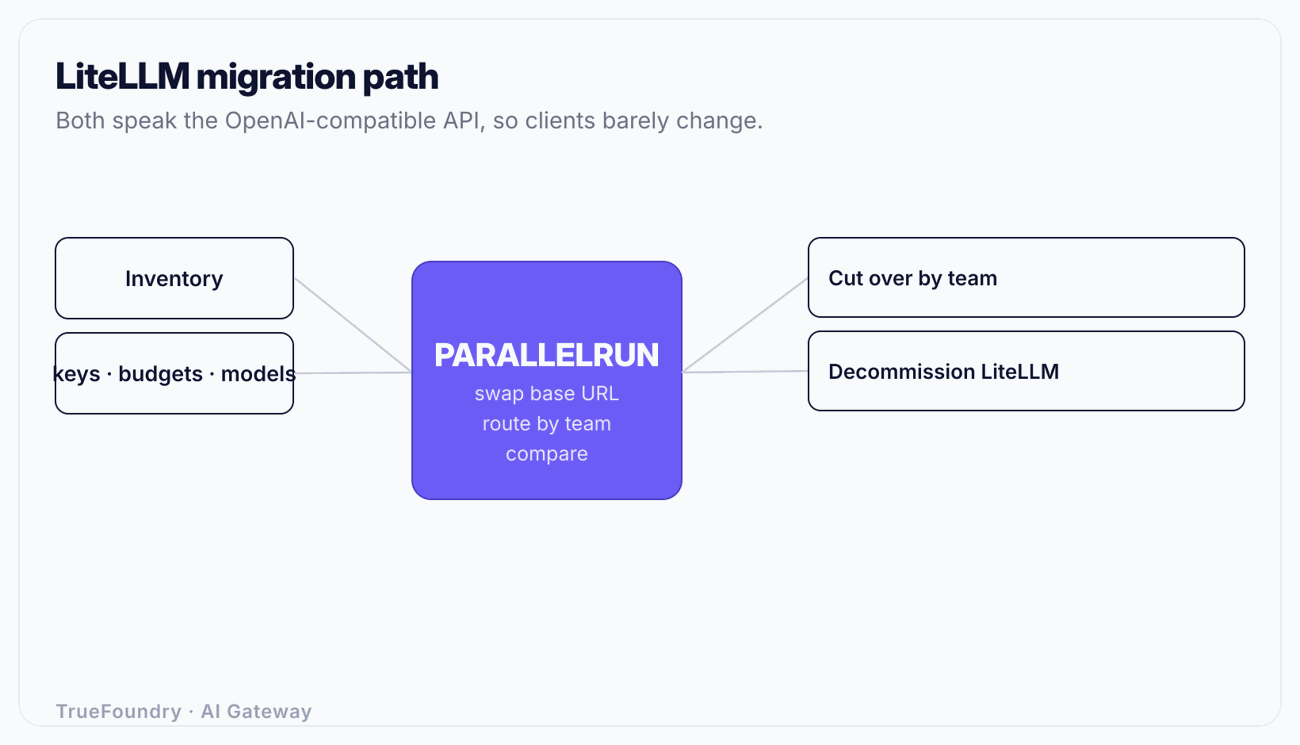
作業に着手する前に、現在LiteLLMが担っている役割をリストアップします:
呼び出し元のインベントリ化は、多くのチームがスキップして後悔するステップです。存在を把握していないトラフィックを切り替えることはできません。コードベースやインフラ全体でプロキシのホスト名を検索(grep)してください。
ゼロから再構築するのではなく、置き換えを行います。LiteLLMのすべての概念には、ガバナンスを備えたGatewayにおける同等の機能が存在します。
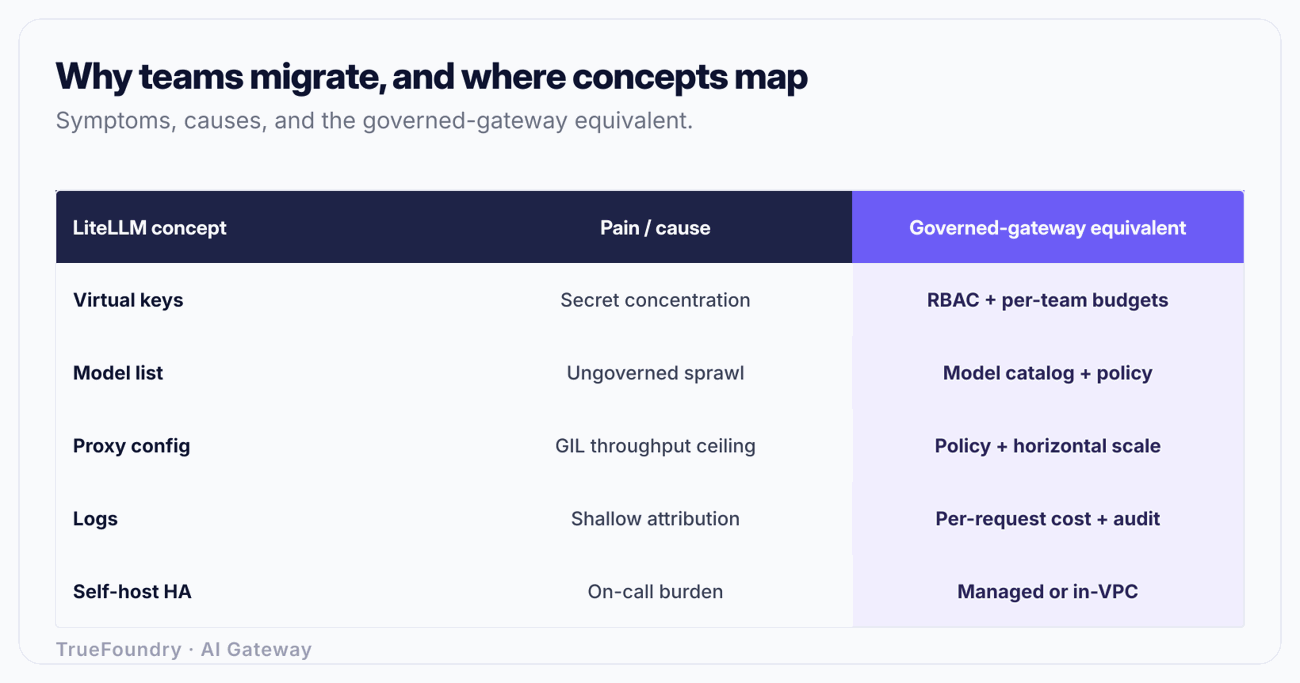
この変換は主に考え方の転換です。LiteLLMはキーと設定ファイル単位で思考しますが、ガバナンスを備えたGatewayはアイデンティティ、チーム、カタログ、ポリシー単位で思考します。機能面の重複が非常に大きいため、移行リスクを低く抑えることができます。
このステップにより、移行全体の安全性が担保されます。LiteLLMとガバナンスを備えたGatewayは、どちらもOpenAI互換のAPIを提供します。そのため、クライアント側で必要な変更は、ベースURLをLiteLLMプロキシのURLからGatewayのエンドポイントに変更することだけです。SDKの差し替えも、リクエストフォーマットの書き換えも、レスポンス解析の変更も必要ありません。
LiteLLMと並行してガバナンスを備えたGatewayを立ち上げます。まずリスクの低い1つのサービスを選択し、新しいベースURLを指すように変更します。レスポンスが同一であること、可視性ツールで正確なコスト割り当てとともにトラフィックが表示されること、予算やガードレールが設定通りに機能することを確認します。両方のエンドポイントが稼働しているため、直接比較することができ、問題が発生した場合でも数秒で旧ベースURLにロールバックできます。
具体例として、インファレンスサービスが環境変数からOPENAI_API_BASEを読み込んでいるとします。このサービスの移行作業は、環境変数を1つ変更して再起動するだけであり、元に戻す場合も値を戻すだけです。両者が同じAPIをサポートしている場合、クライアント側の影響範囲はこれだけに留まります。
すべてのトラフィックを一度に切り替えるのではなく、チームやアプリケーションごとにグループ化して波状に移行を進めます。
チームごとに切り替えることで、明確なロールバック境界が確保され、一度にリスクを冒して複雑な共有キーを移行するのではなく、進行に合わせて各チームに合わせた予算とアクセス権を正確に定義できます。また、レビュー作業も分散され、次のチームに進む前に各チームが自社のトラフィックが正常であることを確認できます。
すべての呼び出し元がGatewayを指すようになり、十分な運用期間を経て問題がないことを確認できたら、LiteLLMを廃止します。プロキシインスタンスを停止し、設定ファイルからプロバイダーシークレットを削除し、重要な手順としてそれらのプロバイダー資格情報をローテーションして、旧プロキシに存在したコピーを無効化します。デプロイの分散が再び発生しないよう、CIや開発環境からもプロキシを削除します。すべてのモデルへの管理されたパスが正確に1つになり、有効なキーを持つ孤立したプロキシが存在しなくなった時点で、移行は完了です。
チームごとのアクセス再定義を行わず、共有キーをそのまま移行してしまう。 LiteLLM運用時には、複数のチームで共有されるバーチャルキーが蓄積されがちです。これらをそのまま移植すると、移行によって解消しようとしていた「ガバナンスのない分散状態」を再現することになります。切り替えの機会を利用して、アイデンティティプロバイダーに基づいてチームごとにアクセス権を再定義してください。それこそが移行の目的の半分を占めています。
呼び出し元のインベントリ作成を省略してしまう。 記憶にあるアプリだけを移行し、Notebook、Cronジョブ、CIステップが旧プロキシを指したまま放置されるケースがあります。そのままLiteLLMを廃止すると、気づかないところでシステムが破損します。プロキシを停止する前に、旧ホスト名で全環境を検索(grep)してください。
廃止時にシークレットのローテーションを忘れてしまう。 LiteLLMを停止しても、保持されていたプロバイダーキーをローテーションしない場合、それらの資格情報は有効なまま、監視されていない廃止済みシステム内に残ることになります。これはまさに2026年のインシデントで悪用された「古いシークレット」の状態そのものです。旧プロキシが保持していたすべての資格情報をローテーションしてください。
ベースURLの変更だけで移行が完了したと勘違いしてしまう。 ベースURLの変更はクライアント側の作業を極めてシンプルにしますが、移行の本来の目的はガバナンス、RBAC、予算、カタログスコープ、監査ログの導入です。ガバナンス設定を適切に行わずにURLだけを変更すると、新しいプロキシを用意しても古い課題がそのまま残ることになります。
一括切り替え(ビッグバン切り替え)を行ってしまう。 組織全体を一度に変更すると、ロールバックの境界が失われます。並行運用とチームごとの段階的な切り替えを行うのは、問題が発生した場合でも影響を1つのチームに限定し、ベースURLを1箇所戻すだけで復旧できるようにするためです。障害対応の呼び出しを楽しみたい場合を除き、一括切り替えは避けてください。
LiteLLMの許容量を超えることは成功の証であり、製品の選定ミスではありません。移行のきっかけは極めて具体的かつ構造的なものです。高並列下におけるPythonプロキシのスループットの限界、1箇所に集中する全プロバイダーのシークレット、環境間に広がるデプロイの分散、セルフホストHAの重圧、そしてシークレットの集中やバージョンの分散リスクを現実のものとした2026年のサプライチェーン問題などが挙げられます。
双方ともOpenAI互換のAPIに対応しているため、クライアント側の変更は通常ベースURLの1行のみであり、移行自体のリスクは非常に低いです。現状をインベントリ化し、キーをRBACと予算へ、モデルリストをカタログへ、設定をポリシーへマッピングし、並行運用を行い、チームごとに順次切り替え、最後に完全なシークレットローテーションを行って旧環境を廃止します。この手順を踏むことで、コードの書き換えを行うことなく利便性の高いプロキシからガバナンスを備えたコントロールプレーンへと移行でき、アクセス、コスト、監査が完全に管理された状態を実現できます。
最小限のアプリケーション変更でLiteLLMから移行しましょう。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












