



November 10, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
データマスキングとは、周囲のデータの有用性を維持しながら、機密性の高い値を安全な代替値に置き換える技術です。これはデータベースの世界に由来します。カード番号がすべて 4111-****-****-1234 に置き換えられた本番環境のコピーを品質保証(QA)チームに提供することで、実際のPII(個人識別情報)を保持することなく、現実的なデータ構造でテストを実施できます。これをLLM gatewayに適用すると状況が変わります。サードパーティへ送られる途中の自由記述テキストを、会話の文脈を成立させ続けたままマスキングしなければならないからです。
これらの用語は常に同義語として使われがちですが、同義ではありません。
最も重要な違いは「可逆(Reversible)か不可逆(Irreversible)か」です。トークナイゼーション、FPE、暗号化は双方向処理(往復)が可能です。ただし、誰かがVaultや暗号鍵という新たな保護対象アセットを管理する必要があります。マスキング、リダクション、匿名化は一方向処理です。よりシンプルで安全ですが、後続の処理で実際の値が必要になった瞬間、役に立たなくなります。
仮名化は匿名化ではありません。GDPRにおいて、仮名化されたデータは依然として個人データであり、規制の対象となります。真に匿名化されたデータのみが規制の対象外となります(前文26)。すべての氏名を「User-8812」のような一貫した値に置き換える処理は「仮名化」であり、これを「匿名化」と呼んでも規制当局の審査を通過することはできません。
もう1つ見落としがちな側面があります。それは「一貫性(Consistency)と可逆性は別物である」ということです。マスキング処理はデターミニスティック(決定論的:同じ入力に対して常に同じプレースホルダーを出力する)でありながら、不可逆であるという設計が可能です。会話全体を通じてモデルが「同一人物」について推論を展開できるのは、この決定論的な一貫性があるからです。
ここが多くの解説記事で省略されがちな部分であり、設計が実運用に耐えられるかどうかを決定づける重要なポイントです。
モデルの出力精度が不均一に低下する。「 Call our office at 312-555-1234(事務所:312-555-1234までお電話ください)」という文章を「Call our office at ************」に変換すると、モデルはそれが電話番号であったことすら認識できなくなります。アスタリスクには型情報が含まれていないためです。[PHONE_NUMBER]のようにラベル付けされたプレースホルダーであれば型情報を保持できますが、プロンプトを閲覧した人に元のデータの種類を教えることになります。要約タスクであればほとんど影響はありませんが、抽出タスクは明確に失敗します。さらに悪質なのは、2つのエンティティの関連付けが気づかないうちに失敗することです。
ツール呼び出しには実際の値が必要になる。これが最も致命的な失敗パターンです。入力時に customer@acme.com をマスキングされたエージェントは、その後 lookup_account(email=...) を呼び出すことができません。モデルへのパスをマスキングしつつツールへのパスを開放したままにすると、逆の脆弱性が生じます。モデル自体はアドレスを目にしていなくても、ツールの引数を通じてサードパーティのMCPサーバーへ実際の値が渡されてしまいます。ツールごとに、どちらのパスをより信頼すべきかを判断してください。
構造化出力とJSON Schemaが壊れる。JSON Schemaによる構造化出力を使用している場合、マスキングによってフィールドの定義を満たさない値が生成される可能性があります。たとえば format: email フィールドに [REDACTED EMAIL] を入れることはできず、整数(integer)型フィールドにアスタリスクを含めることはできません。文字列長を維持するマスキング手法(Length-preserving masking)のほうが、データの形式が崩れないため扱いやすいと言えます。さらに悪いのは出力段階でのマスキングです。モデルが正しく有効なJSONを生成したにもかかわらず、マスキング処理が内部の値を書き換えてしまい、モデルが正しく返したレスポンスに対してパーサーがエラーをスローすることになります。
複数ターンにわたる会話の一貫性の喪失。ターン1:「Priya Ramanがアカウント所有者です。」 ターン4:「彼女はまだ所有者ですか?」 ターン1で氏名がアスタリスクに置換されていた場合、モデルにはコンテキストを追跡するための手がかりが残りません。決定論的な仮名化を行えばこの問題は解決しますが、マスキング処理がターンをまたいでステートを保持している場合に限られます。ステートレスなガードレールでは解決できません。
マスキングされたテキストに対するRAG検索の失敗。インデックス作成前にドキュメントをマスキングすると、エンベディングにエンティティ情報が含まれなくなるため、そのエンティティに対するクエリを実行しても対象のチャンクが取得されなくなります。逆に、未マスキングの状態でインデックスを作成し、検索時にマスキングを行う構成にすると、ベクターデータベース内に未マスキングのコーパスが保持されることになり、回避しようとしていたリスクを抱え込むことになります。
限定的な適用であればマスキングは非常に有効です。しかし全体に一括適用すると、製品の品質を密かに低下させ、誰もその原因に気づかないという事態に陥ります。
マスキングが可逆(復元可能)であると思い込むこと。モデルに送信する手前でPIIをマスキングし、レスポンス時に何らかの処理で復元されると想定してシステムを構築してしまうケースです。可逆的なスキームを選択し、暗号鍵などを管理する仕組みを導入しない限り、呼び出し元にもマスキングされた値が返されます。
プロンプトだけをマスキングし、ツールへのパスを忘れること。データは「モデルへの入力」「モデルからの出力」「ツールへの入力」「ツールからの出力」の4箇所を移動します。そのうちの1つだけを保護するケースが目立ちます。結果として、誰も監視していなかったツールの実行結果経由で漏洩が発生します。
ログのリダクションを「データフロー制御」と混同すること。保存されるログをリダクションすることは、社内の誰がプロンプトを閲覧できるかを制限する効果しかありません。プロバイダー側には依然としてオリジナルのテキストが送信されています。
可逆性が必要な課題に対して不可逆なマスキングを選択すること。後続の処理で元の値が必要になる場合、マスキングは不適切な技術です。Vaultや暗号鍵を伴うトークナイゼーション、または形式保存暗号(FPE)を採用する必要があります。
TrueFoundryにおいて、マスキングは単体の別製品として提供されているわけではありません。すべてのガードレールにはOperation ModeとEnforcement Strategyの2つの設定項目があり、マスキングはOperation Modeの選択肢の1つとなっています。
優先度(Priority)は、マスキング処理における実行順序のモデル全体を決定づけます。1つのフックに対して3つのMutateガードレールが設定されている場合、優先度順に実行され、各ガードレールは前のガードレールが出力した結果を受け取ります。たとえば優先度1にシークレットマスキング、優先度2に正規表現マスキングを設定した場合、正規表現のガードレールはすでに ***REDACTED*** に書き換えられたテキストに対してパターンマッチングを行います。
入力のMutation(変更)はブロッキング処理であり、最初に実行されます。プロンプトの変換が完了するまで、モデルへのリクエストは開始されません。その後、入力のValidation(検証)がバックグラウンドで並行して実行されます。処理の途中で検証が失敗した場合、Gatewayはモデルリクエストをキャンセルするため、モデルの利用料金は発生しません。出力のMutationおよびValidationはレスポンス受信後に同期処理で実行されるため、この時点ではすでにモデルの計算コストが発生しています。

MCPツール呼び出しには、2つの同期フックが追加されます。ツール実行前に評価され、失敗時にツール実行を阻止するpre-invokeと、実行後に評価され、失敗時に結果の返却を阻止するpost-invokeです。ガードレールは個々のツール呼び出しごとに独立して実行されます。5つのツールが呼ばれれば、5回分のチェックが実行されます。

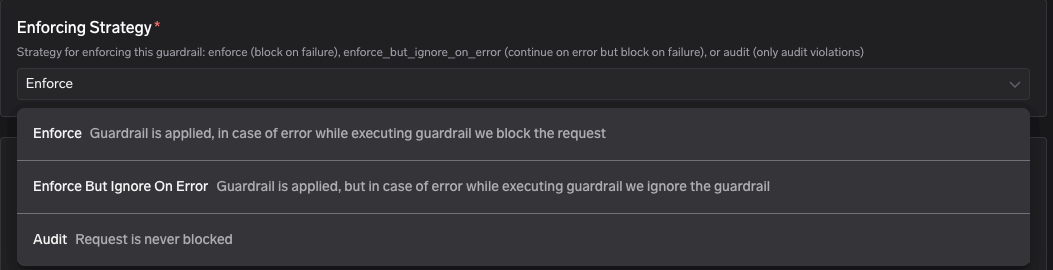
2つ目の設定項目は、「ガードレールが違反を検出した場合」と「ガードレール自体がエラーを起こした場合」という2種類の失敗を区別するためのものです。
Strategy(戦略)
違反検出時の挙動
ガードレールエラー時の挙動
Enforce
ブロック
ブロック(Fail-closed:安全側に倒して拒否)
Enforce But Ignore On Error
ブロック
通過を許可(Graceful degradation:段階的機能低下)
Audit
通過を許可し、ログ記録のみ
通過を許可
公式ドキュメントでは、Enforce But Ignore On Errorを「最も安全なデフォルト設定」として位置づけており、Audit → Enforce But Ignore On Error → Enforce という段階的な導入プロセスを推奨しています。
「PIIガードレールを導入している」という説明だけでは、実際にマスキング処理が可能かどうかは判断できません。
PII / PHI Detectionは特殊な挙動を示します。リクエストをブロックすることはできず、マスキング処理のみを行います。「SSN(社会保障番号)を含むリクエストを一切拒否する」という要件の場合、このガードレールでは要件を満たせません。
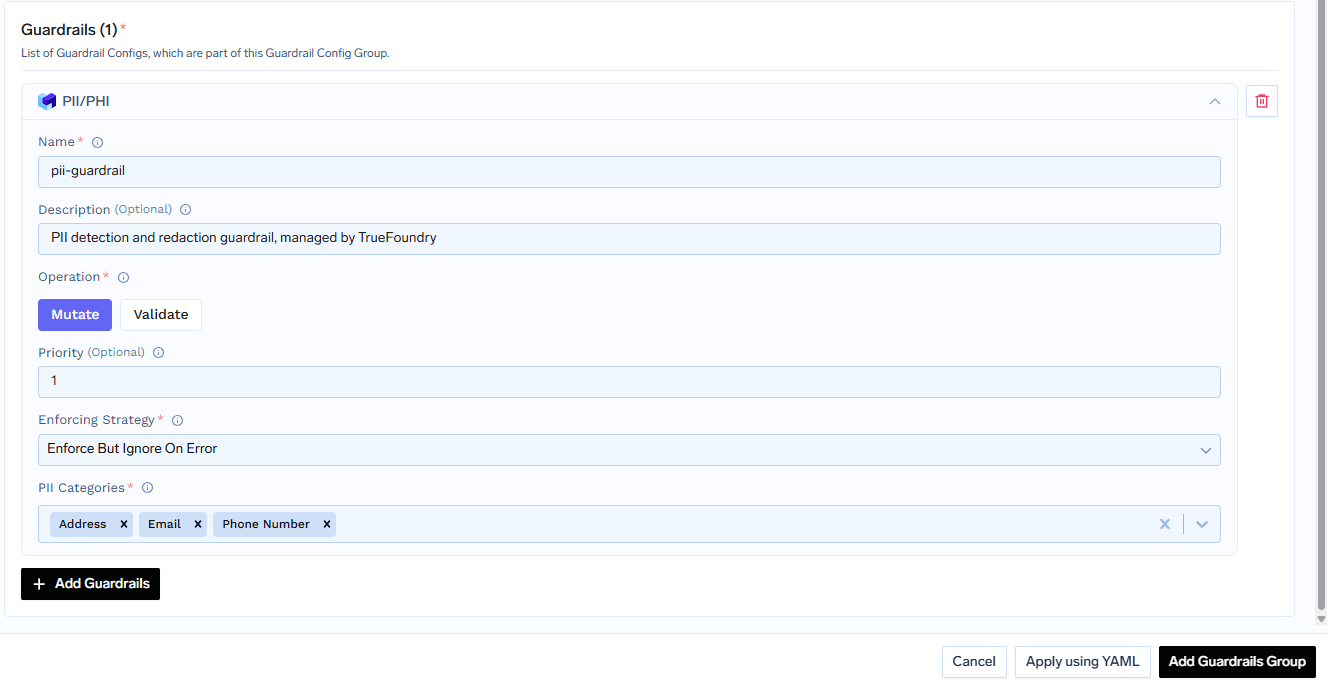
ドキュメントに記載されている適用戦略の選択肢は enforce と enforce_but_ignore_on_error のみです。Secrets、Regex、SQL Sanitizerとは異なり、audit は選択肢に含まれていません。Auditモードからの段階的ロールアウトは、すべてのビルトイン機能で一律に利用できるわけではありません。[検証項目] これが実際の機能制限なのか、ドキュメントの記載漏れなのかについては確認が必要です。
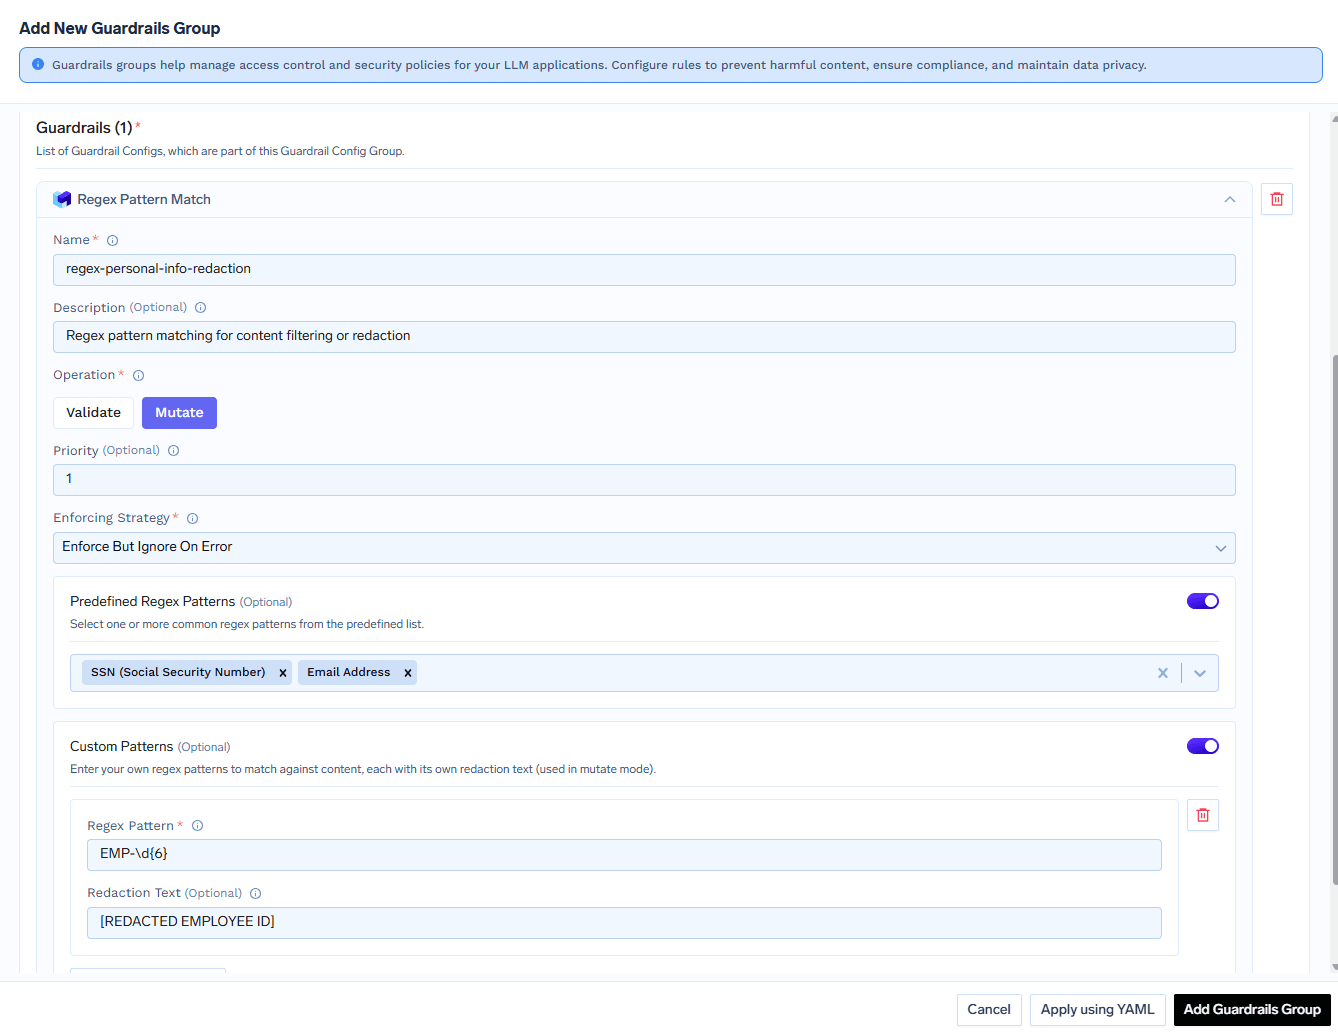
Regex Pattern Matchingを使用すると、アスタリスクではなくラベル付きのプレースホルダーに置換できます。SSN、クレジットカード、10カ国のパスポート、クラウドのAPIキー、GitHub/Slackのトークン、IPアドレスなど、46種類のプリセットが標準提供されているほか、EMP-\d{6} → [REDACTED EMPLOYEE ID] のようなカスタムパターンの追加も可能です。
サードパーティ製ガードレール統合の中でMutateモードに対応しているのは、Google Model Armor、CrowdStrike AIDR、F5 AI Security、TrojAI、Enkrypt AI、Pillar Security、Lasso (classifix)、HiddenLayer (/redact-*)、DeepKeep、Nomaです。なお、後者の2つ(DeepKeep、Noma)はMutateモードの指定が必須となっています。一方で、Validate専用(Validate-only)となっているのは、Cisco AI Defense、Gray Swan Cygnal、Patronus、NVIDIA NeMo、Guardrails AI、Arthur AIです。Validate専用のベンダー製品に対してマスキング機能を求めても実現できません。
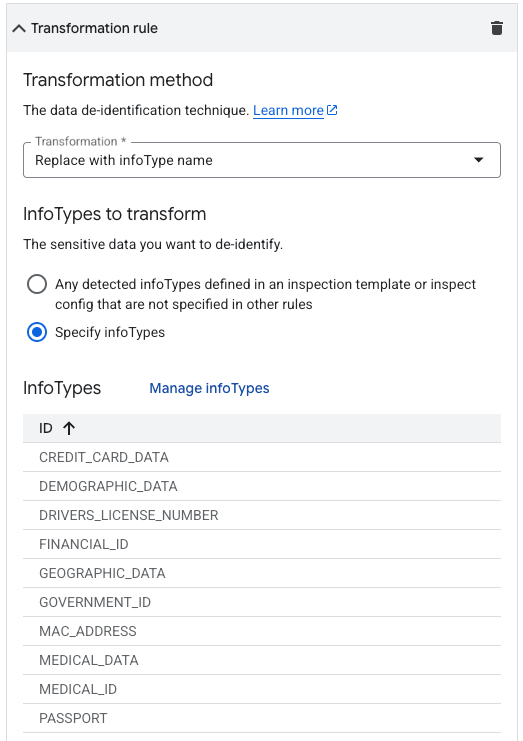
Google Model Armorのセットアップには落とし穴があります。Mutateを機能させるには、Google Cloud側でSDP inspectテンプレートとde-identifyテンプレートの両方を作成し、それらをModel Armorテンプレートに紐付けた上で、変換ルールを「Replace with infoType name」に設定する必要があります。両方が揃っていない場合、Mutate処理は失敗します。
TrueFoundry独自のマスキング用ガードレールは一方向(不可逆)処理です。モデルだけでなく、呼び出し元のアプリケーション側にもマスキングされた値が返されます。PII / PHI Detection、Secrets Detection、Regex Pattern Matchingのいずれのドキュメントにも、元の値を復元する手段は記載されておらず、Gatewayレベルでのトークン保管庫(Vault)やデータの復元ステップは提供されていません。
ドキュメント上で明確に双方向処理(復元)がサポートされているのは、サードパーティ連携の1つだけです。CrowdStrike AIDRは形式保存暗号(FPE)をサポートしています。OperationがMutateに設定され、入力時にFPEで暗号化された場合、Gatewayは出力時にその結果である fpe_context を input_fpe_context としてAIDRに送り返し、POST {baseUrl}/v1/unredact を呼び出します。これにより、一貫して同じ暗号鍵が使用されます。これは実用的な可逆パスと言えますが、CrowdStrike、Mutateモード、そして入力パスからの fpe_context が揃っていることが前提条件となります。
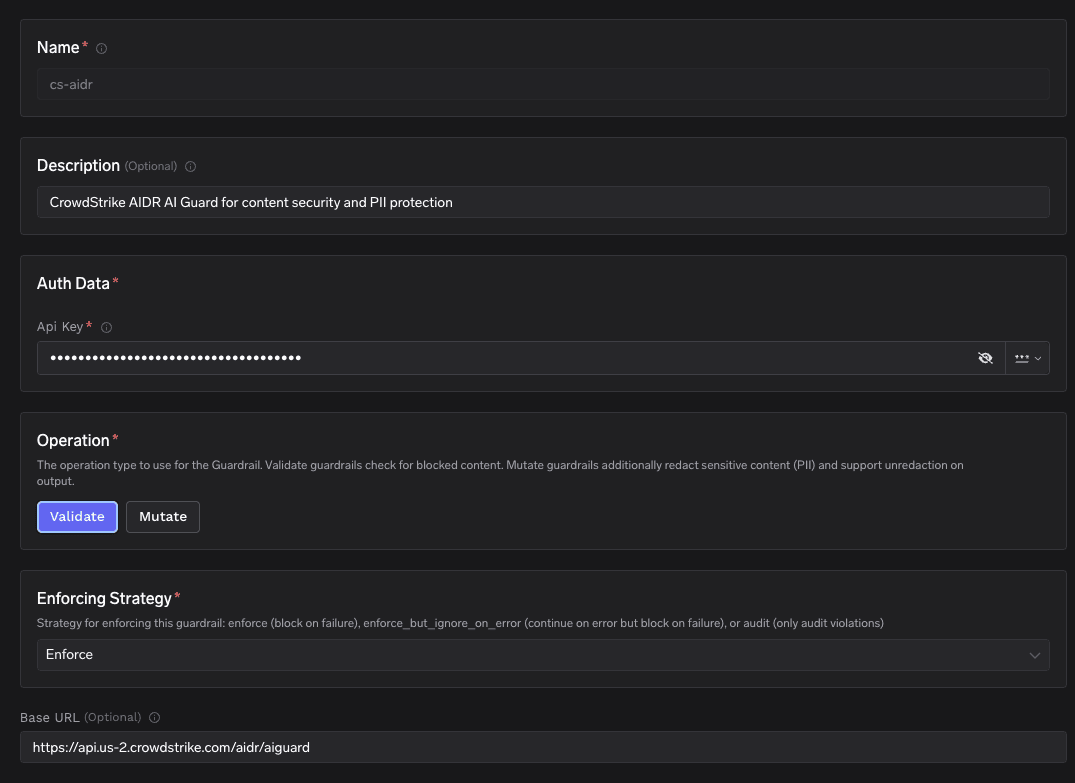
したがって、アプリケーション側で実際の元データを必要とする場合は、Gateway側でそれを復元しようと計画すべきではありません。元データはアプリケーション側で保持し、マスキングされたデータのみをGatewayへ通過させ、自前で管理する識別子(ID)を使ってアプリケーション側で再結合してください。なお、AIDRに関連して予期せぬ挙動となる点として、AIDRが一度違反を検出した場合、Mutateモードであってもリダクション処理へ切り替わって穏便に処理されるわけではなく、リクエストはエラー(400)として遮断されます。
サポートCopilotが問い合わせチケットのテキストを読み取り、MCPサーバー経由で顧客アカウント情報を照会する構成を例に考えます。チケットには顧客のエレクトロニックメールアドレス、電話番号、社内の従業員IDが日常的に含まれています。
プロバイダーへ絶対に渡してはならないデータを特定します。メールアドレスと電話番号はマスキング対象とします。従業員IDは、1つのチケット内でモデルが複数の従業員を区別できるように、ラベル付きでマスキングします。誤って貼り付けられた認証情報(APIキー等)は、出力側でもマスキングします。
モードと優先度を決定します。LLM InputフックにPII / PHI Detectionを設定し、Mutate(このガードレールで利用可能な唯一のモード)、優先度1とします。さらにLLM InputフックにRegex Pattern Matchingを設定し、Mutate、優先度2とし、カスタムパターン EMP-\d{6} → [REDACTED EMPLOYEE ID] を登録します。LLM OutputフックにはSecrets Detectionを設定し、Mutateとします。それぞれのガードレールは、サポートされている最も制限の緩い戦略(Auditなど)からテスト運用を開始します。
ツールへのパスを意図的に設計します。アカウントの照会処理には実際のメールアドレスが必要です。そのため、マスキングルールはMCPサーバーではなくモデル(プロバイダー)へ向かうパスをターゲットにします。一方で、Secrets DetectionはMCPのPost-Invokeフック側で実行するように設定し、ツールから返される実行結果の中に認証情報が含まれていた場合にそれを検知・遮断できるようにします。この設計の根拠を明確にしておきます。「MCPサーバーは社内のVPC内に存在し、モデルプロバイダーは外部に存在するから」という理由です。この明確な方針こそが、実質的なデータ管理の要となります。
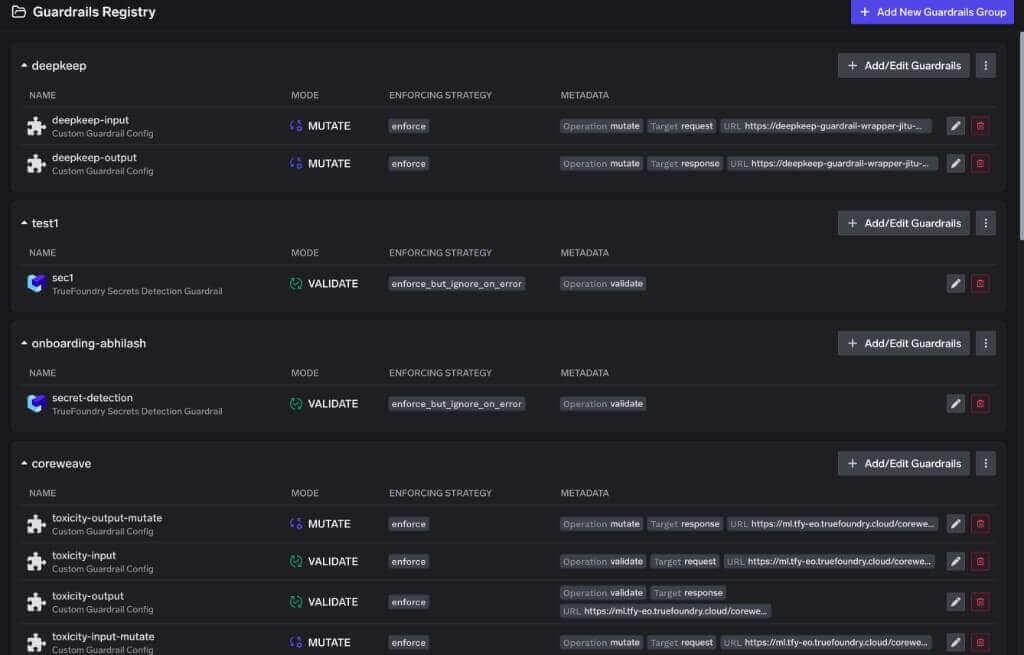
ポリシーを使って適用します。ガードレールを登録しただけでは、実際のトラフィックに適用されません。AI Gateway → Policies → Guardrails → Add Rule へ移動し、ターゲット(モデル、MCPサーバー、必要に応じてツール単位)、適用対象者(IN / NOT IN を使用したユーザー、チーム、バーチャルアカウント)、メタデータ、実行フックを指定してスコープを設定します。合致するルールはフックごとに統合されて実行されます。
信頼する前に挙動を監視します。各ガードレールはMonitor → Request Traces内で独立したスパンとして記録され、実行時間、結果、スコープ、入力、出力、Mutation(変更内容)を確認できます。使用頻度の高いフックでMutation発生率がゼロに近い場合は正規表現パターンの記述ミスが疑われます。逆に100%に近い場合は、マスキング処理が回答精度にどのような影響を与えているかを検証する必要があります。

ストリーミング出力時にはマスキングが実行されません。"stream": true の場合、応答全体の評価にはテキストの完結が必要となるため、出力ガードレールは完全にスキップされます。入力ガードレールには影響しません。ほとんどのチャットインターフェースはデフォルトでストリーミングを使用しているため、ユーザーが実際に目にする画面上では、出力側のマスキングは機能しないことになります。
システムプロンプトはマスキングの対象になりません。Gatewayはガードレールへコンテンツを渡す前にシステムプロンプトを除外するため、検査、ブロック、リダクションのいずれも行われません。唯一の例外はCrowdStrike AIDRで、システムプロンプトを参照しますが内容の改変は行いません。システムプロンプト内に暗号鍵などを記述した場合、いかなるマスキング用ガードレールもそれを保護することはできません。
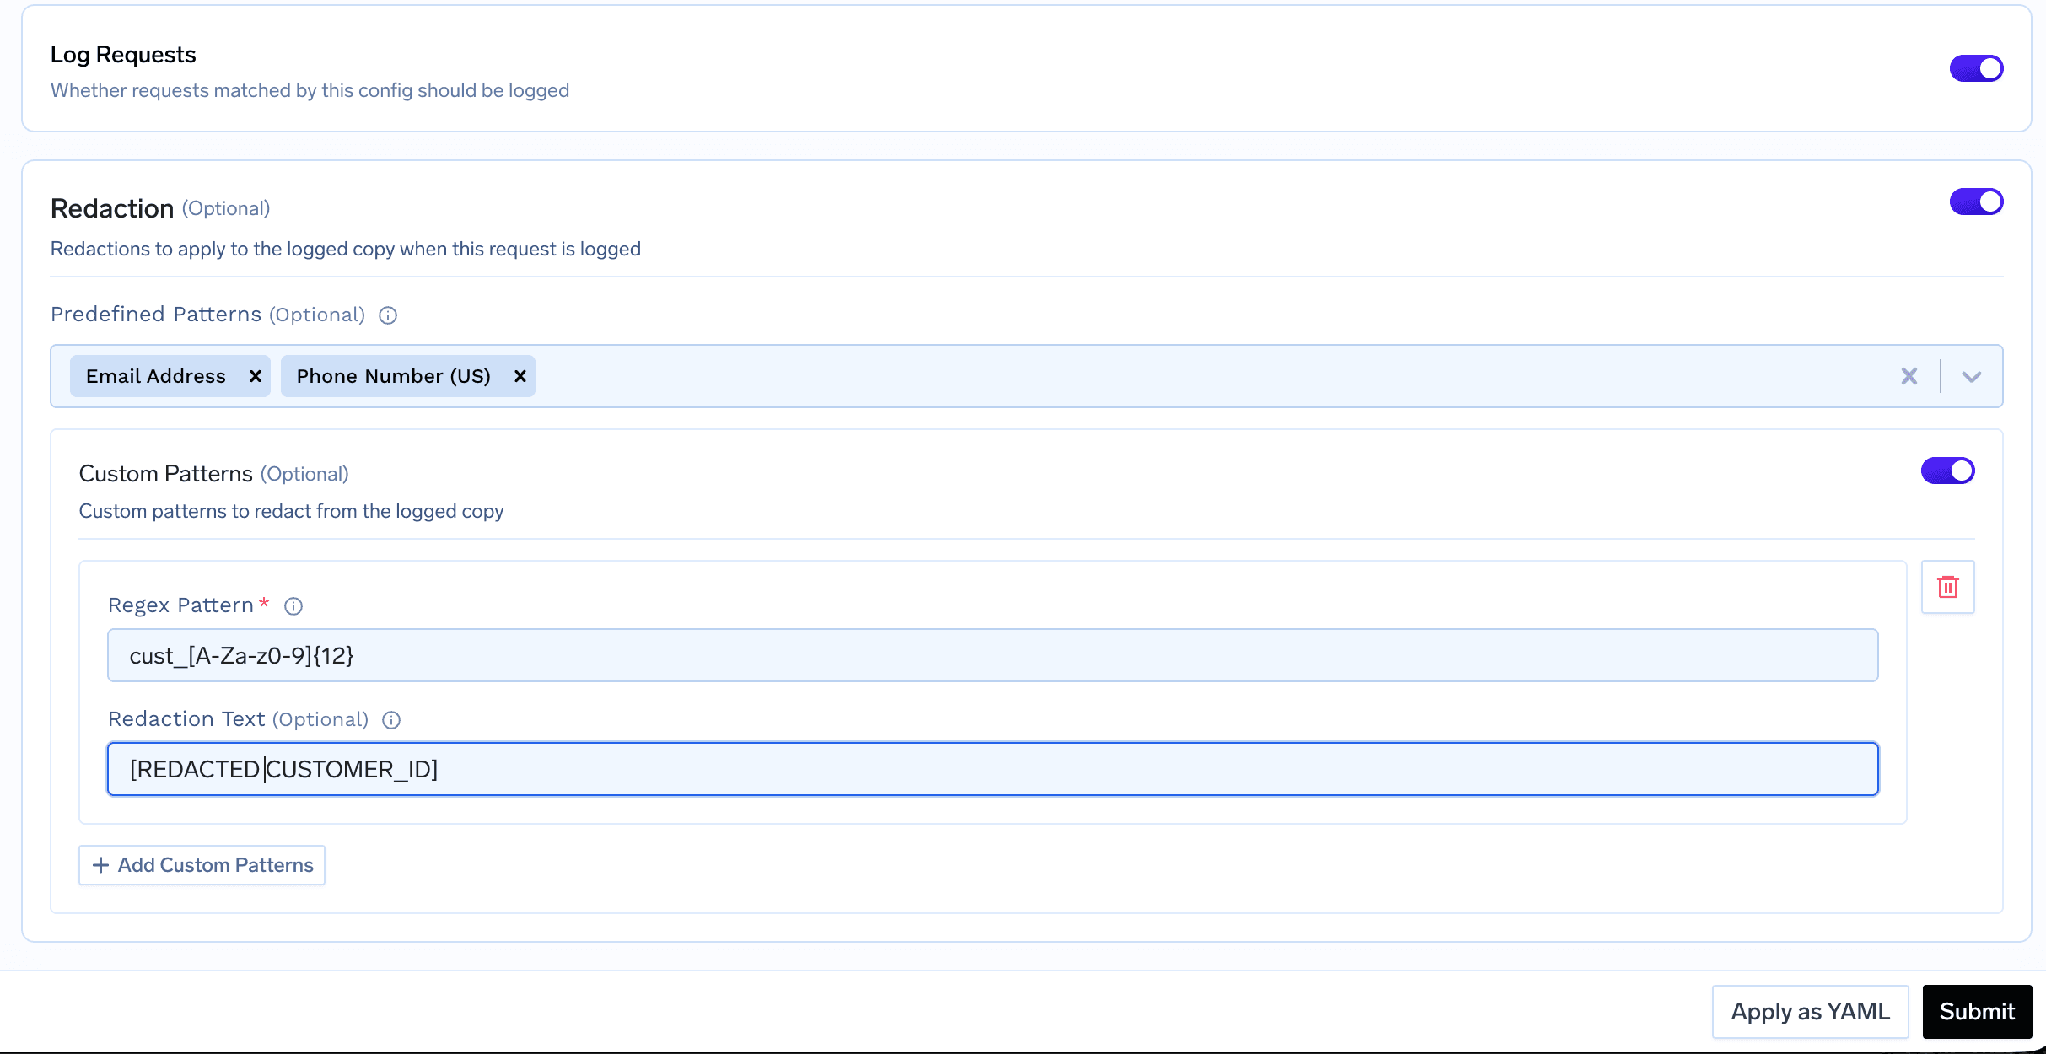
ログのリダクションとMutateは異なる管理機能です。TrueFoundryのルールベースのLogging Configurationは、保存されるリクエスト/レスポンスボディから特定のパターンをリダクションします(拒否優先のセマンティクスが適用され、Logがオフのルールが1つでも合致するとボディ全体が記録されなくなります)。しかし、ドキュメントには「リダクションが適用されるのはログに記録されるコピーのみであり、モデルプロバイダーへ転送されるライブリクエストが変更されることはありません」と明記されています。これは社内スタッフによるプロンプト閲覧を制限するための機能であり、外部へ送信されるデータを制御するものではありません。外部へのデータ送信制御については、関連記事であるLLMトラフィックにおけるデータ漏洩防止(DLP)を参照してください。
ガードレールの実行順序によって「ブロック」が「通過」へ変わってしまう可能性があります。DeepKeepのドキュメントにはこの点が具体的に説明されています。最も深刻なアクションではなく、最初にリストされたルールが優先適用されます。「Adversarial(敵対的攻撃検出)より前にPIIが配置されている場合、ジャイルブレイク攻撃とPII検出の両方に該当するリクエストは、ブロックされずにリダクションされた上で通過を許可されてしまいます。」 これはすべてのMutateチェーンに共通する注意点です。ブロックを必須とするルールは、マスキングを行うルールよりも前に配置してください。
PII / PHI DetectionはTrueFoundryホスト環境専用です。この機能はAzure AI Language上で動作するため、セルフホスト環境やハイブリッド環境(「Gateway Planeのみ」の構成)では利用できません。その場合は、自身のAPIキーを使用してAzure PIIを直接利用するか、CrowdStrikeなどの代替手段を導入してください。
データマスキングは強力な管理手法ですが、適切に運用されず形骸化してしまうケースが多く見られます。原因はマスキング機能自体の不備ではなく、その周辺にある前提の誤りにあります。「マスキングは復元できる」「ツールへのパスもカバーされている」「ログのリダクションと同じである」「モデルはアスタリスクに置き換わったデータでも問題なく推論できる」といった思い込みです。
導入にあたっては、まず次の4つの決定事項を文書化することをお勧めします。1つ目は「外部へ出してはならないエンティティタイプは何か」、2つ目は「各ルールを4つのフックのうちどれで実行するか」、3つ目は「後続の処理で元の値を必要とするか(この結論によってマスキングかトークナイゼーションかが決まります)」、4つ目は「出力品質の低下をどこまで容許できるか(想定ではなく実測で評価します)」です。
構築は小規模かつ段階的に進めます。ガードレールが対応している場合はAuditモードから開始し、1週間分のトレースログを確認した上で Enforce But Ignore On Error へ引き上げ、拒否(Fail-closed)が絶対条件となる主要ルートにのみ完全な Enforce を適用します。すべてのモデル、チーム、エージェントが通過する単一の集約点として、AI Gatewayはこうした処理を実装するのに最適な場所です。ただし、実際の挙動をトレースで確認していないマスキングルールは、運用できていないのと同じです。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




プロンプト、レスポンス、ツールのペイロードに含まれる機密値を、データがモデルプロバイダーや外部ツールに届く前に、リクエスト経路上でインラインに代替値へ置き換えることです。TrueFoundryでは、これがMutate動作モードにあたります。ガードレールが一致した箇所を書き換え、書き換え後のバージョンが後段に進みます。Mutateガードレールは優先度の数値が小さいものから順に実行され、ブロックすることも可能です。
マスキングは文字を上書きし、多くの場合フォーマットを保持します。たとえば4111-****-****-1234はカード番号の形を保っています。一方、墨消しは値を完全に取り除き、通常は[REDACTED SSN]のようなラベルを残します。どちらも元には戻せません。用語ではなく実例を確認してください。TrueFoundryのPIIガードレールは同じ長さのアスタリスクを、Regexガードレールはラベル付きのトークンを出力します。
既定ではできません。TrueFoundryのPII、Secrets、Regexのガードレールは一方向で、モデルも呼び出し元もマスクされた値を見ることになり、復元の手順は文書化されていません。文書化されている唯一の往復処理は、CrowdStrike AIDRのフォーマット保持暗号化で、ゲートウェイが入力側のfpe_contextを出力側でAIDRの/v1/unredactエンドポイントに渡します。後段で実際の値が必要な場合は、アプリケーション側で保持してください。
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、多数のプロバイダーにまたがってルーティングする場合でも、プロンプトとレスポンスがお客様のドメインの外に出ることはありません。
はい。MCP Gateway、Agent Gateway、そしてツール単位のアクセス制御を備えたMCP & Agents Registryが含まれています。LangGraph、CrewAI、AutoGen、または独自のフレームワークで構築されたエージェントを、すべて一元的に統制できます。
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheus、またはお好みのスタックに接続できます。プロンプトからツール、モデルの実行まで、すべてのリクエストを追跡するため、既存のシステムを大幅に変更することなく、統合されたロギングを実現できます。






















