


November 13, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
他のすべての AI ワークロードは、自社が所有するインフラストラクチャ(独自のクラスター、ネットワークポリシー、ローテーション可能な資格情報)上で実行されます。一方 Codex は、開発者のラップトップ上で実行され、ホームディレクトリにある TOML ファイルを読み込んでモデルプロバイダーと直接通信する CLI プロセスです。5つの特性により、これはまったく異なる領域の問題となります:
よくある最初の対応はポリシー文書の作成です。しかし、これが失敗する理由はただ1つ: ポリシーが要求するすべての設定が、開発者が編集可能なファイル内に存在するからです。
すべてのリクエストにおいて、次の4つの特性が維持されている必要があります:
ゲートウェイを導入すれば、これら4つすべてを実現できます — ただし、クライアントがゲートウェイを指し示し、指し示し続けている場合に限られます。そのためには3つの姿勢(Posture)が存在し、強制力を持つのはそのうちの1つだけです:
トークンをローテーションせずにファイルをロックすると改ざんには対処できますが、資格情報の盗難は無視されます。逆にロックせずにローテーションを行うとその逆になります。両方が不可欠です。
モデルプロバイダーのアカウントを管理ポイントとして扱うこと。 Codex のアイデンティティ、SSO、ワークスペースメンバーシップ、および管理コンソールのポリシーは、ゲートウェイではなく OpenAI のコンソールに存在します。プロンプトや出力の保持も同様で、「OpenAI との合意によって統制されます」。ゲートウェイが管理するのはルーティング、支出、ガードレール、および独自のロギングであり、プロバイダー契約そのものではありません。
1回の MDM プッシュで永久に強制適用できると仮定すること。 クライアントはリリース間で設定の優先順位変更を行います。Codex v0.149.0 では、Windows 上の managed_config.toml が完全に廃止されました — 現在は起動時の警告(Ignoring deprecated managed config file)とともにファイルを無視し、レジストリによる代替手段もありません。このリリース前に設定されたフリートは強制適用が解除されており、エラーも報告されません。
共有 API キーを配布すること。 30人の開発者を迅速に稼働させる最も手軽な方法ですが、すべてのダウンストリームコントロールを同時に破綻させます。テナント全体で共有される資格情報から、個人に対するレート制限を設定したり、「誰がそのプロンプトを送信したか」を特定したりすることは不可能です。
Codex は TrueFoundry AI Gateway をモデルプロバイダーとして扱います。トラフィックが管理下の場所に到達することによって、すべてのコントロールが可能になります。ゲートウェイの詳細情報は UI 内のコードスニペットから取得します。
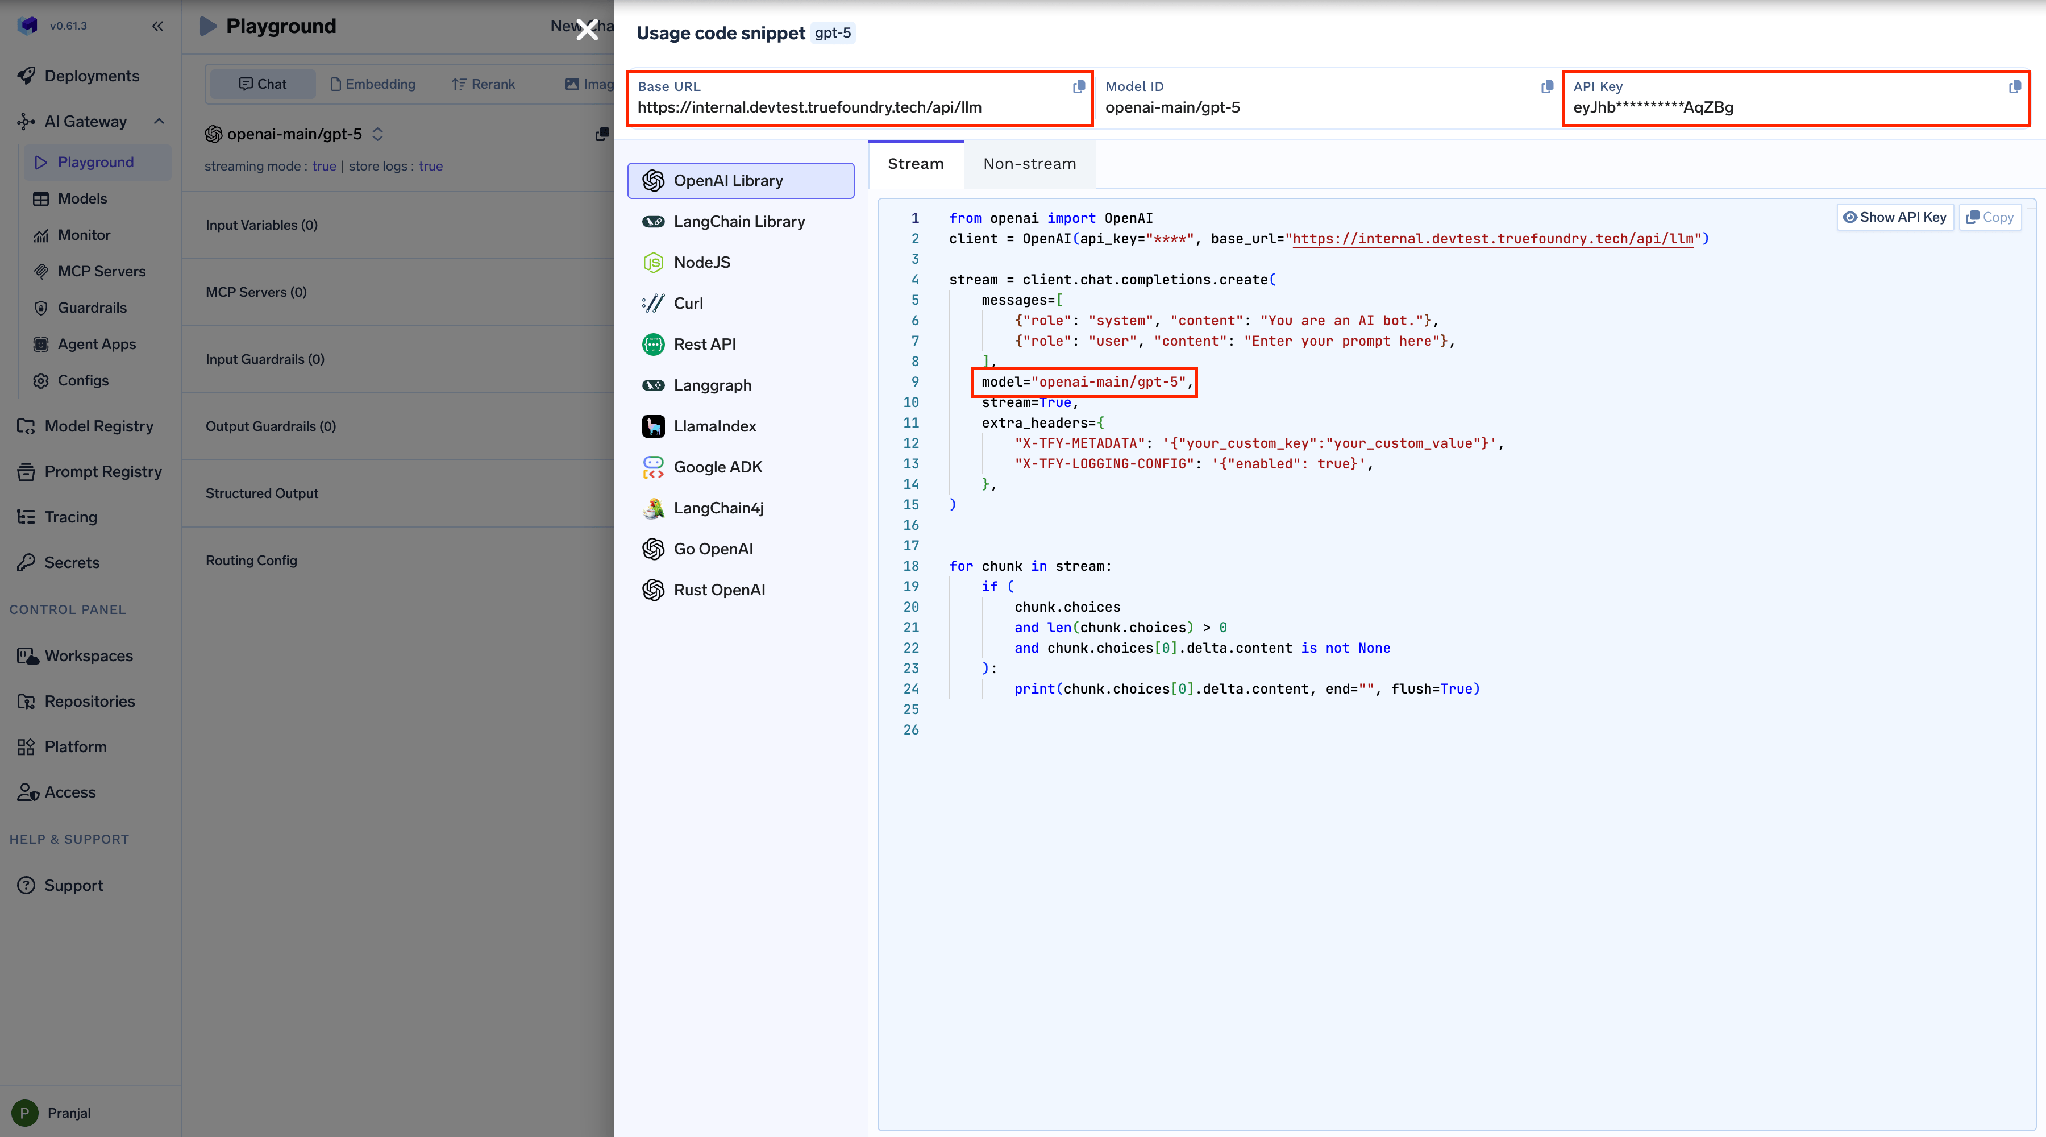
単一開発者向けの形式: トークンは Authorization に配置され、ゲートウェイがそれを個人に解決します。
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer TFY_API_KEY"
開発者の ChatGPT サブスクリプションが推論費用を支払い、ゲートウェイがトラフィックを統制します。変更点は2つです: requires_openai_auth = true が必要になることと、Codex が独自の ChatGPT OAuth トークンのために Authorization を必要とするため、TrueFoundry の資格情報を Authorization から x-tfy-api-key に移動することです。
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
requires_openai_auth = true
[model_providers.truefoundry.http_headers]
x-tfy-api-key = "TFY_API_KEY"
ゲートウェイ側では、Integrations → Providers の下でタイプを OpenAI とし、ベース URL を https://chatgpt.com/backend-api/codex に設定したプロバイダーを作成し、API key フィールドは空のままにしておきます。
フィールドを空にしておくことは意図的な仕様であり、設定漏れではありません。 保存されたキーが存在する場合、ゲートウェイは開発者の ChatGPT 資格情報の代わりにそのキーを使用します。これによりサブスクリプションフローが切断され、誤ったアカウントにトラフィックがルーティングされる可能性があります。管理者が気を効かせてそのフィールドを埋めてしまうと、個別属性を持つ30人の開発者が1つの匿名 API キーテナントに変換されてしまい、エラーも出力されません。
空にしておくことで、二重の帰属管理が実現します: TrueFoundry は x-tfy-api-key から開発者を記録し、OpenAI は使用量をその開発者の ChatGPT シートに帰属させます。モデル ID は chatgpt-codex/gpt-5.2-codex のようになります。
資格情報が1つの ChatGPT アカウントに紐付けられていることから、2つの制約が生じます。Virtual Model のターゲットのうち、ChatGPT サブスクリプションモデルアカウントに指定できるのは1つだけです。API キーでサポートされるターゲットはそれと同居できます。また、開発者個別の 401、403、または 429 エラーが発生しても、共有ターゲットがロードバランサーのクールダウン状態に入ることはないため、1人の開発者のクォータ枯渇が他人に影響を与えることはありません。
(プランの適用条件についてはドキュメント間で記載が異なります: エンタープライズセキュリティのページには Business または Enterprise とあり、CLI のページには Personal も記載されています。ティアを確定する前に [要確認] を推奨します。)
これは、多くのチームがコピーを誤り、半日かけてデバッグすることになる設定行です。ゲートウェイは Responses wire に対してのみ /responses エンドポイントを付加します。wire_api = "chat" に設定すると、リクエストは同じベース URL に対して /chat/completions に送信されますが、これは Codex トラフィックにとって有効なエンドポイントではありません。また、これは gpt-5.x-codex の thinking token を正しく動作させるための設定でもあります。
Codex CLI のページではより寛容な説明になっています — gpt-5.x-codex には responses、その他のモデルには chat。これらは矛盾しません: Codex ファミリーのモデルには Responses wire が必須となります。
Codex は特定のモデルに thinking token を送信し、モデル文字列の照合によってそれらを識別します。完全修飾名(openai-main/gpt-5 や azure-openai/gpt-5 など)は一致しないため、機能検知に失敗します。
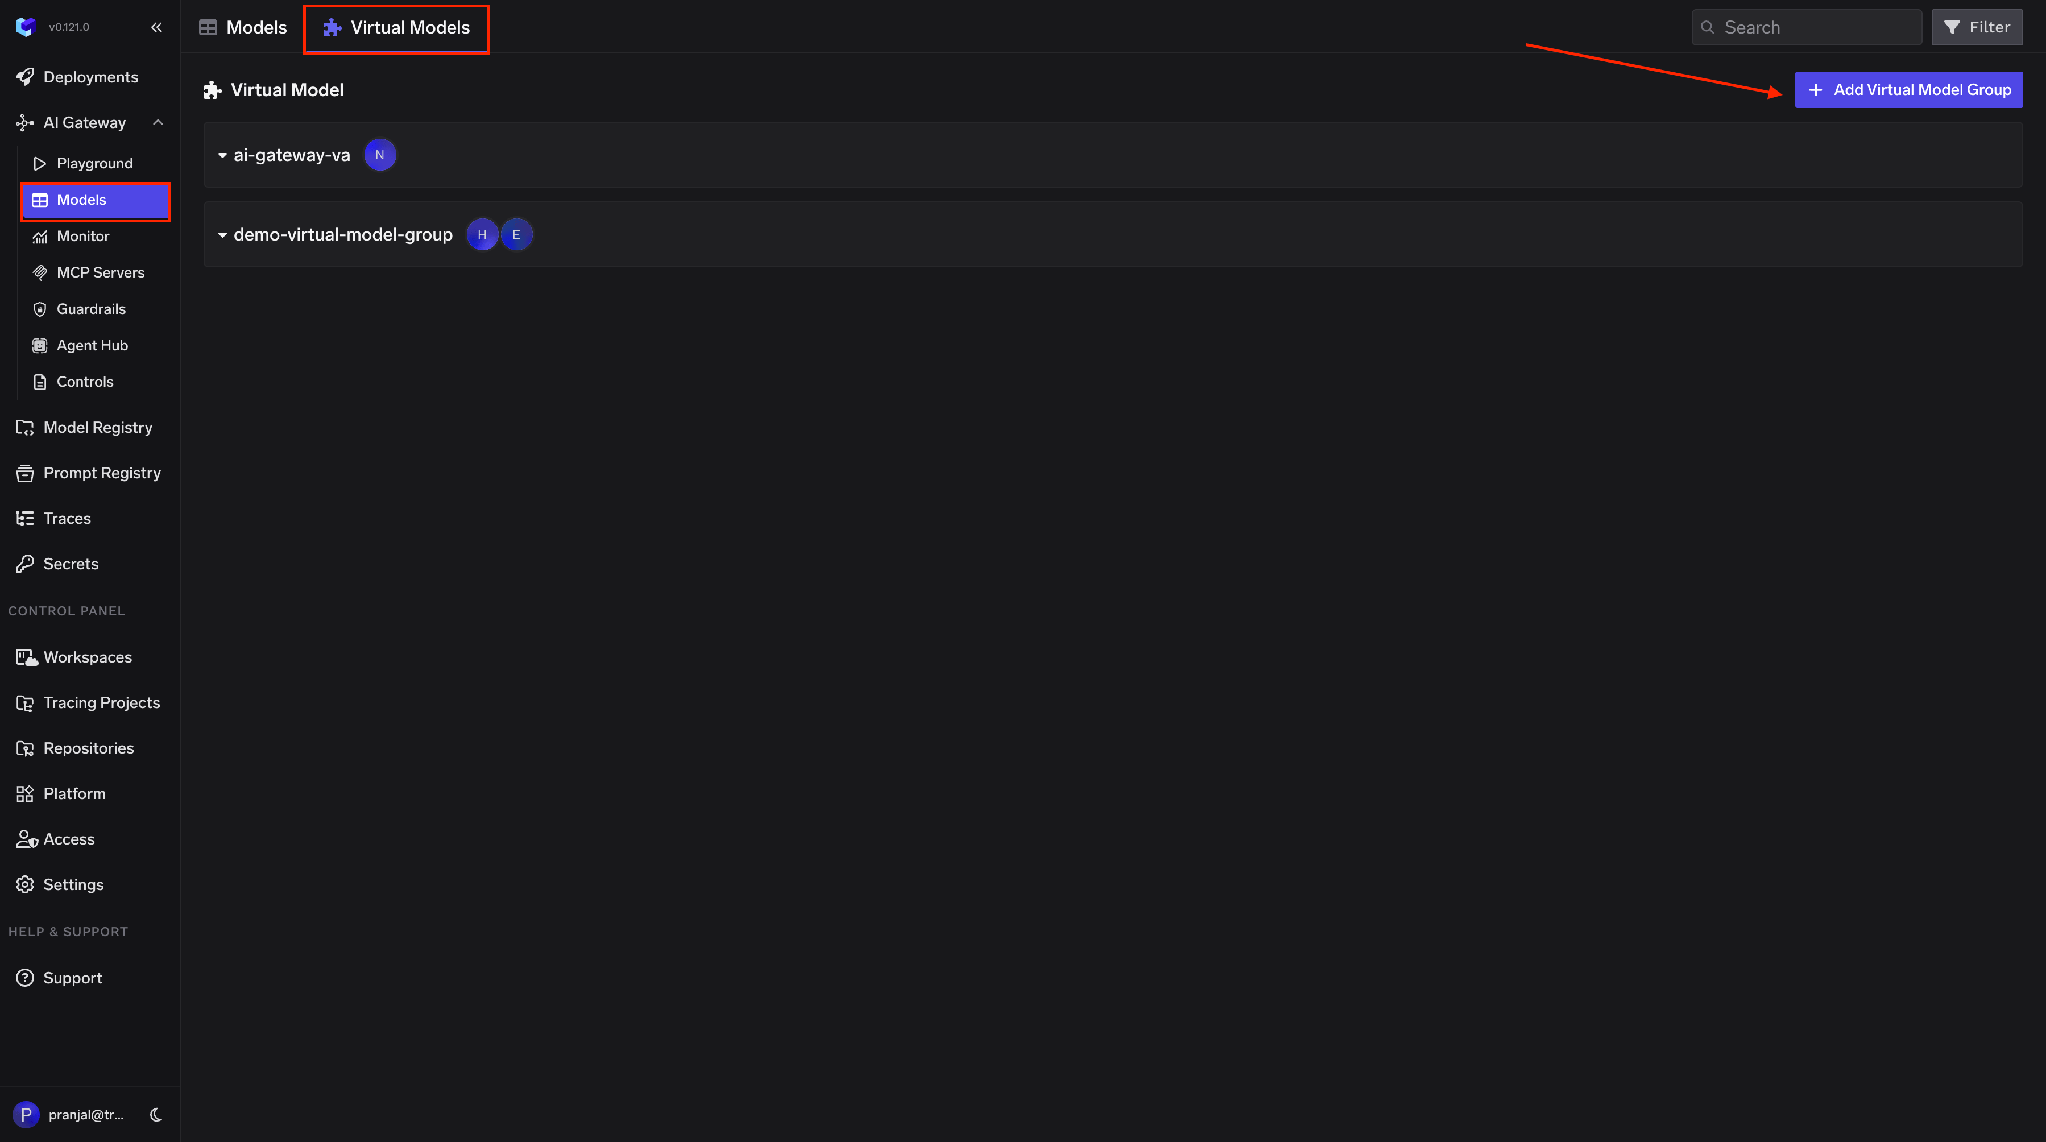
ルール: 実際のモデル ID に一致するスラグを使用すること(例: gpt-5.2-codex)。Codex はそれらの ID を認識し、適切な機能を有効化します。Codex の設定ファイルに完全修飾名を記載しないでください。
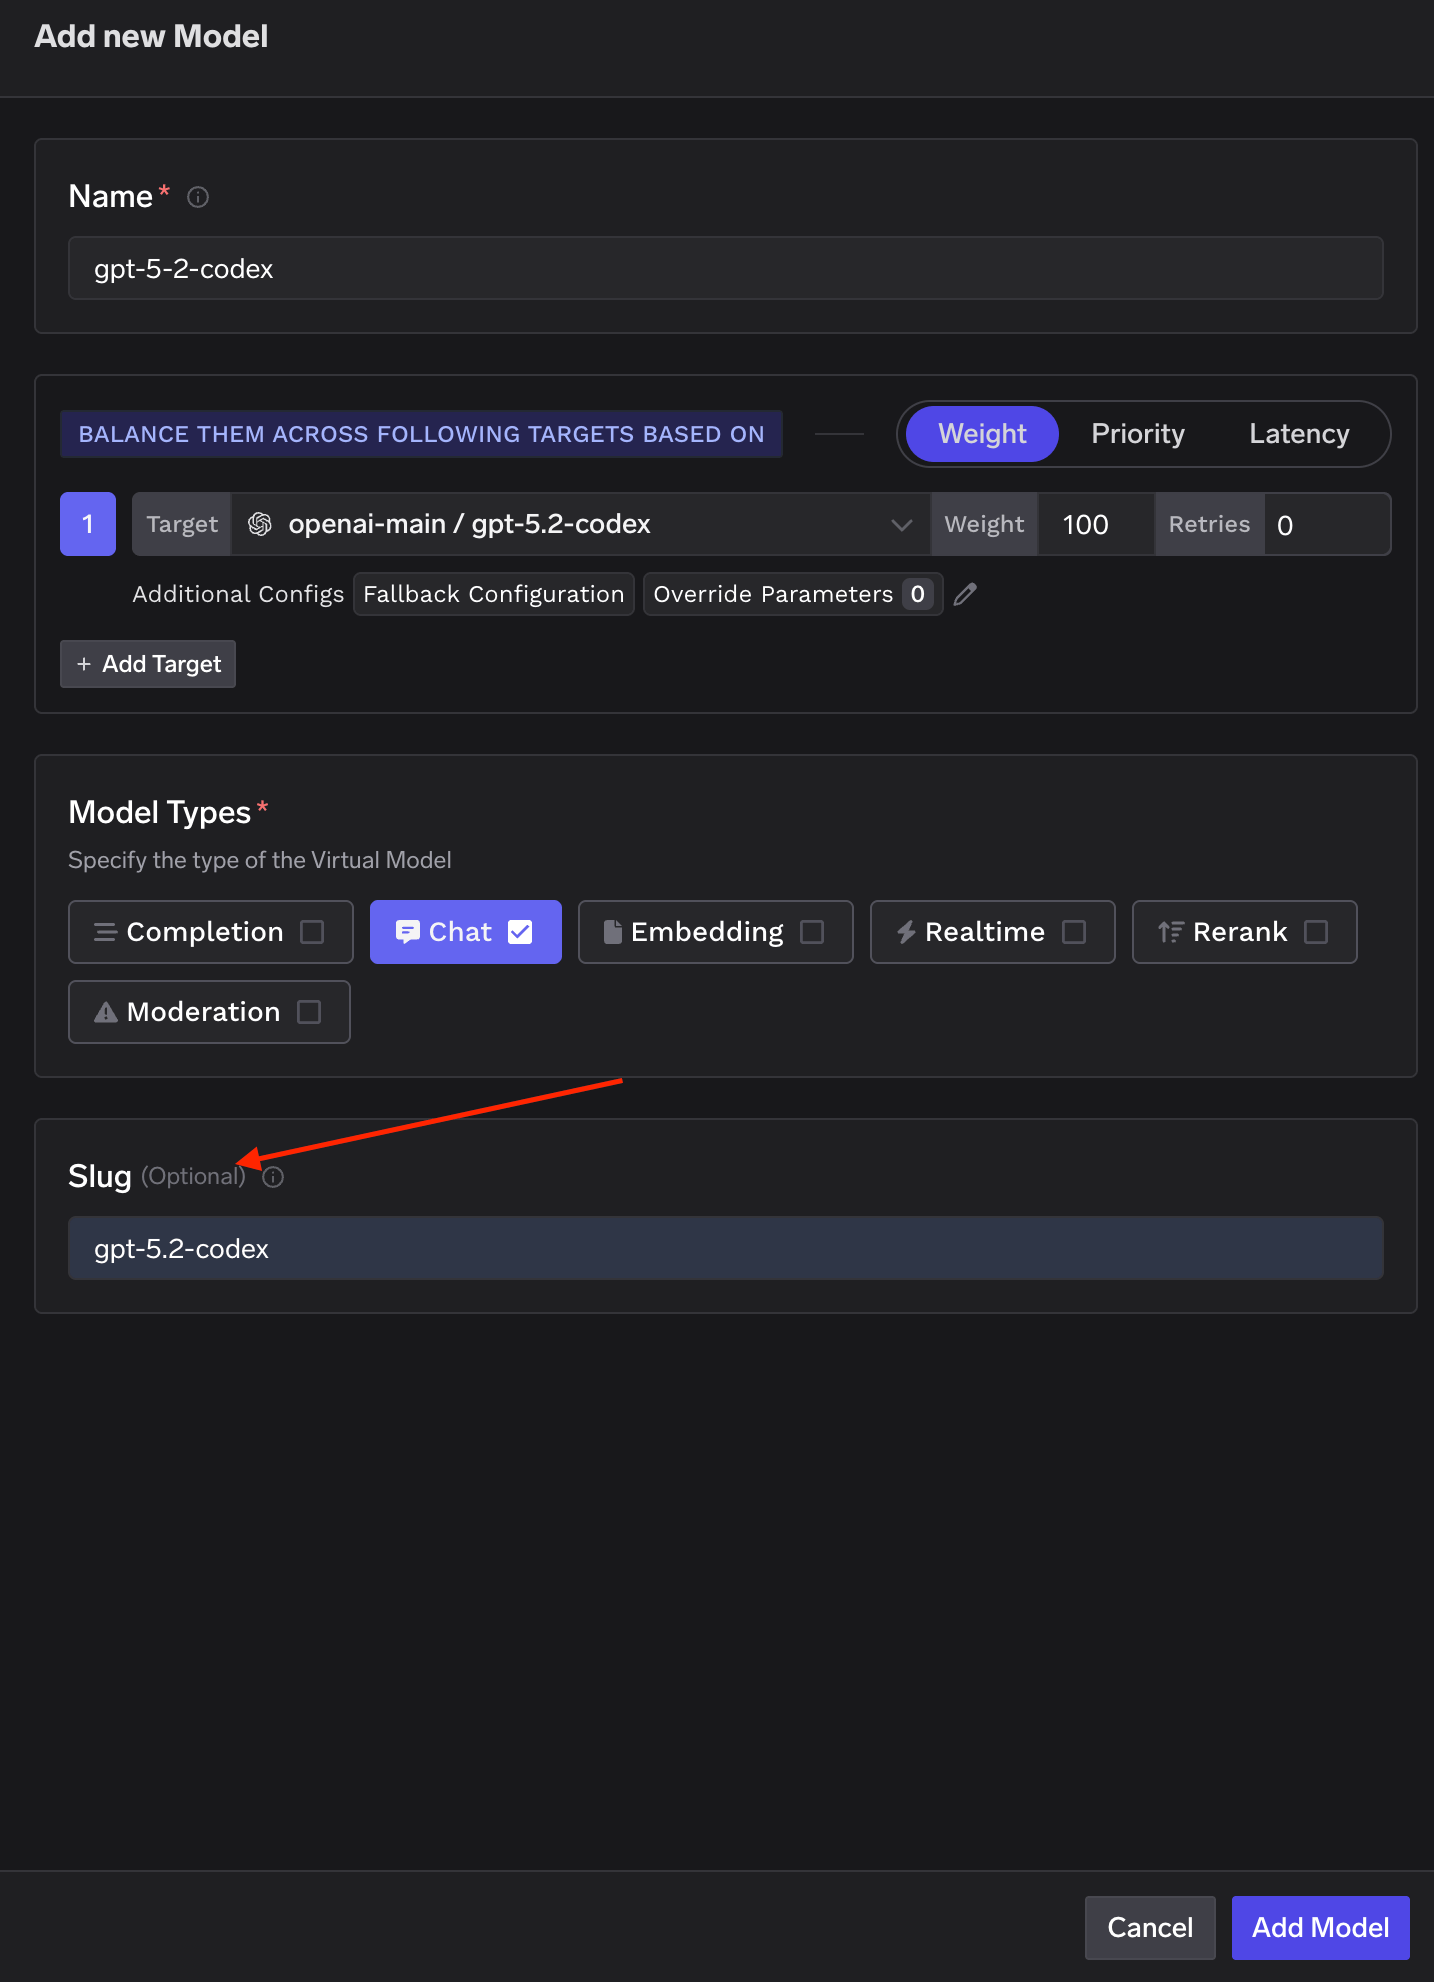
スラグとロードバランスされたプロバイダーターゲットを表示する Virtual Model の詳細ビュー
スラグはテナント全体で一意であり、Virtual Model Provider Group settings で設定されます。リクエストボディ内ではスラグと完全なグループ/モデルパスの両方が機能しますが、Codex にはスラグ形式が必要です。
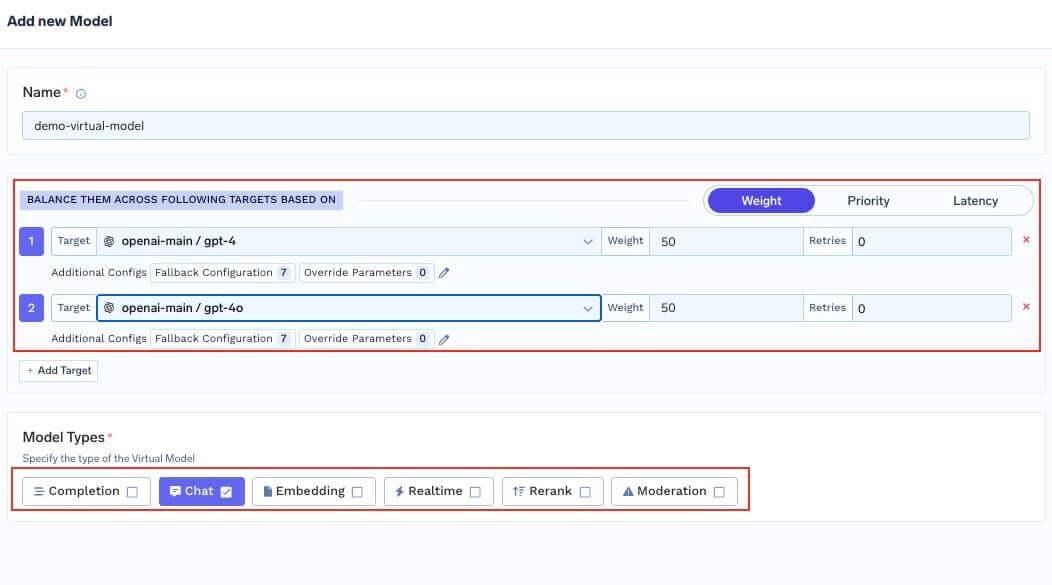
プロバイダーグループ内の Virtual Model 設定画面へのナビゲーション
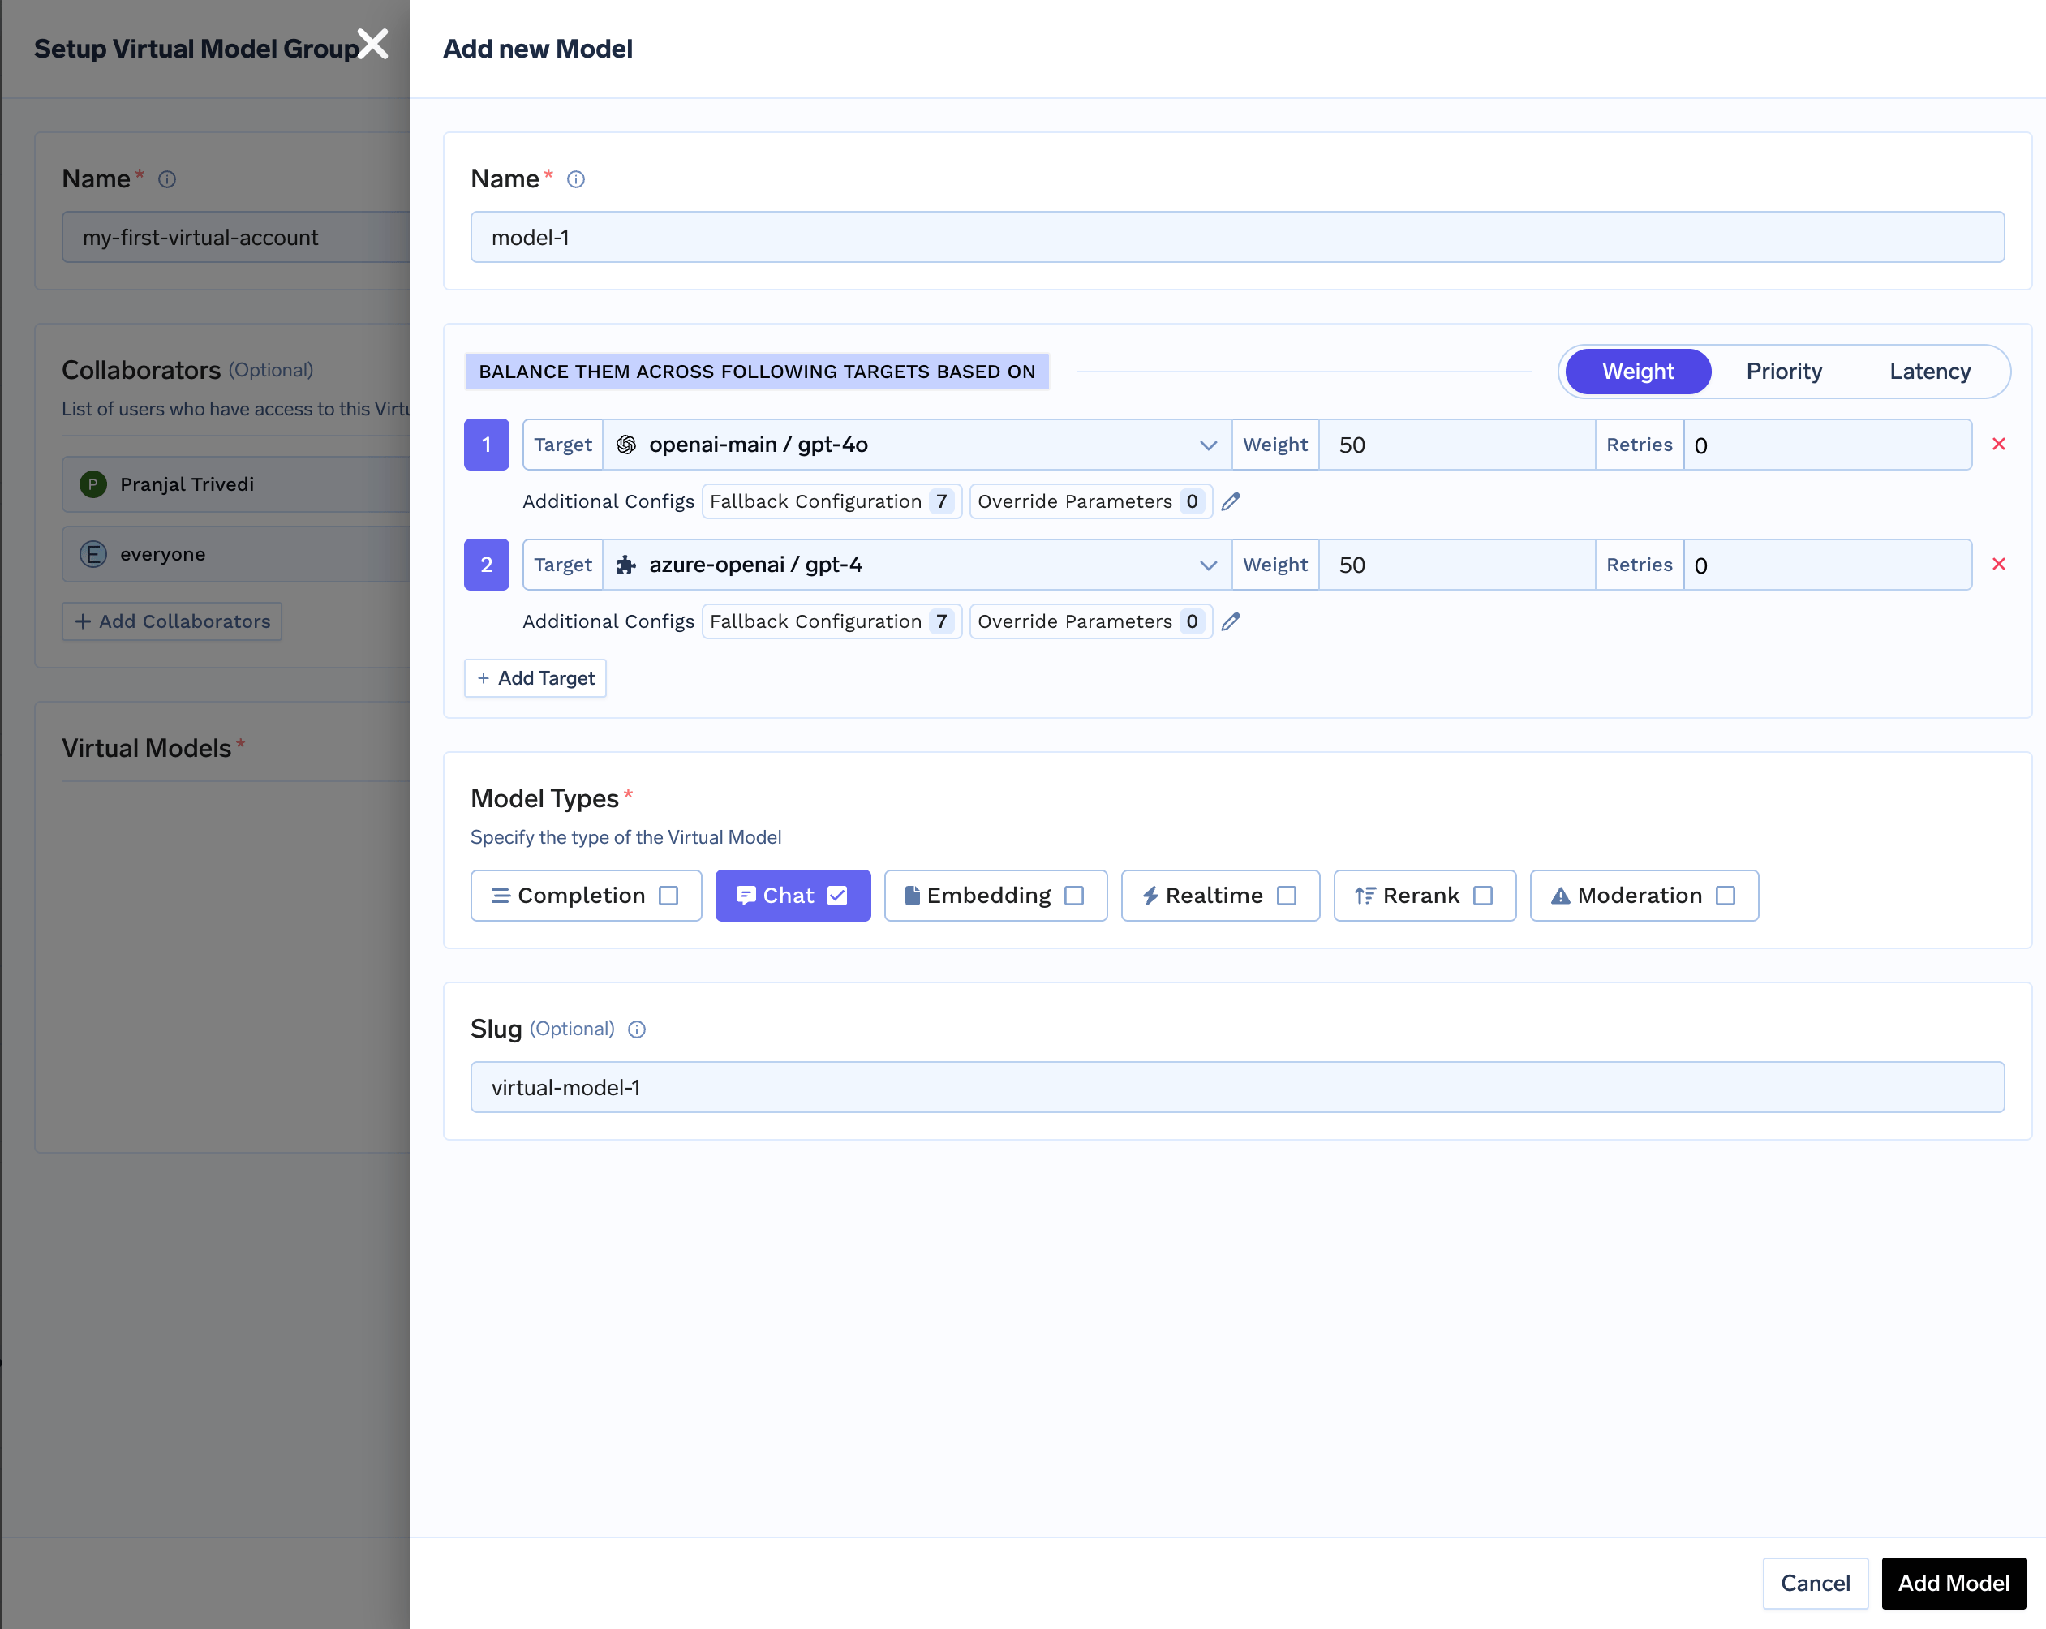
詳細設定フォーム内の Virtual Model スラグフィールド
1つのスラグの背後でターゲットに重み付け(openai-main/gpt-5 を 70、azure-openai/gpt-5 を 30)を行い、model deprecations and staged cutovers で説明されているように、ラップトップに触れることなく構成を変更できます。
スラグの命名規則に関しても、クライアント間で大きな違いがあります。Cursor はスラグのキーワードに基づいてリクエストフォーマットを選択し、スラグに anthropic、claude、openai、gpt、gemini、vertex が含まれている場合はサイレントにフォーマットを切り替えます。Codex はスラグ内にモデル ID を求めますが、Cursor はそれらのキーワードがスラグに含まれないことを求めます。
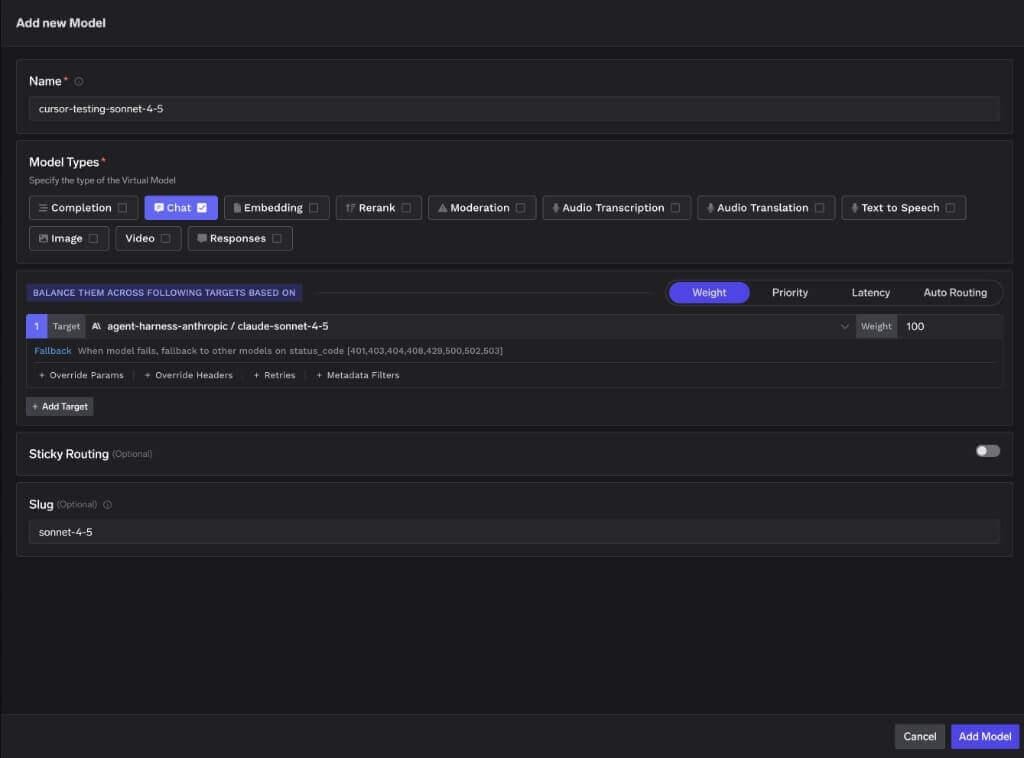
Cursor の Virtual Model スラグ設定フォーム
開発者ごとの設定は単なるドキュメント化されたセットアップであり、コントロールではありません。フリートへの強制適用には tfy-local-ai-setup を使用します。これは MDM によってプッシュされ、github.com/truefoundry/tfy-local-ai-setup/releases から取得して root 権限(Windows では Administrator)で 推奨される1時間ごとの間隔 で実行されるバイナリです。Codex スクリプトは RELEASE_TAG="v1.3.5" を固定して使用します。各実行では次の4つの処理が行われます:
手順3が最も重要です。ラップトップが長期的なゲートウェイトークンを保持することは決してありません。リフレッシュトークンは最終発行から 30日間 有効であり、実行が成功するたびにローテーションされます。また、管理対象設定内の資格情報は新しく取得され、そのユーザーのアイデンティティにスコープ化されます。
必須設定: GATEWAY_URL、CONTROL_PLANE_URL、TENANT_NAME。オプション設定: CODEX_GATEWAY_URL、CODEX_AUTH_MODE、CODEX_DEFAULT_MODEL、CODEX_SETTINGS_FILE。CODEX_AUTH_MODE="api-key" がデフォルトです。"chatgpt-subscription" を指定すると、バイナリは requires_openai_auth = true を書き込み、トークンを x-tfy-api-key に移動します。Codex がインストールされていないマシンでは何も行われません — バイナリは処理をスキップして終了します。
macOS および Linux では、起動ごとに再適用される管理者ファイルが優先されます:
/etc/codex/managed_config.toml → ~/.codex/config.toml → CLI フラグ
model_provider = "truefoundry"
model = "gpt-5.2-codex"
[model_providers.truefoundry]
name = "TrueFoundry Gateway"
base_url = "https://<your-truefoundry-gateway-url>"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer <freshly-fetched-tfy-token>"
トップレベルの model キーは CODEX_DEFAULT_MODEL が設定されている場合のみ書き込まれます。未設定の場合、プロバイダーが強制適用されている間もモデルの選択権は開発者に残ります。
Windows では、ファイル、順序、スキーマのすべてが異なります。
C:\ProgramData\OpenAI\Codex\requirements.toml → ~/.codex/config.toml → CLI フラグ → C:\ProgramData\OpenAI\Codex\config.toml
最後の位置に注目してください: Windows の config.toml はマシンレベルのデフォルトであり、4つのうちで最も優先順位が低く設定されています。そのため、開発者自身のファイルによって上書きされます。一方で requirements.toml はすべてに優先します。プロバイダーブロックは macOS と一致しますが、モデル指定は一致しません:
# C:\ProgramData\OpenAI\Codex\requirements.toml
model_provider = "truefoundry"
# ... macOS と同様の [model_providers.truefoundry] および http_headers ブロック ...
[models.new_thread]
model = "gpt-5.2-codex"
requirements のスキーマにはトップレベルの model キーが存在しません。 CODEX_DEFAULT_MODEL は代わりに [models.new_thread] の下に配置します。macOS のブロックを修正せずに Windows にコピーすると、モデルの固定指定が無言で無視されます。
Windows 上でこれらが有効に機能するかどうかは、2つのバージョン番号によって決まります。v0.149.0 では、Windows での managed_config.toml が廃止されました。強制適用を行うための最小バージョンは v0.156.0 です — Codex はこのビルド以降でのみ requirements.toml 内の model_provider を尊重します。それ以前のビルドでは最も優先順位の低い config.toml にフォールバックし、開発者がホームディレクトリからそれを上書きできるようになります。Windows 環境が統制されていると見なす前に codex --version を確認してください。セットアップバイナリにおける Windows Codex の管理機能は、tfy-local-ai-setup v1.3.5 で導入されます。
ファイルをロックすることで、設定が統制手段へと変わります:
macOS では、/etc/codex/ が root:wheel 755 に設定され、ファイルは root:wheel 644 に加えて schg が付与されます — root 自身であっても編集には chflags noschg を実行する必要があります。
Windows の ACL に関する注意点は独立して記載する価値があります。 C:\ProgramData\OpenAI\Codex\ は Administrators が所有し、継承が解除されています: SYSTEM と Admins がフルコントロール、Users は読み取り専用。両方の TOML ファイルは SYSTEM がフルコントロール、Admins が読み取り専用、Users が読み取り専用となります。この理由は明確です — ProgramData では認証された任意のユーザーがディレクトリを作成可能であり、Codex はユーザーが書き込み可能な設定を拒否せず、そこにある設定をそのまま読み込んでしまうためです。 その ACL を緩和しないでください。制限が緩いディレクトリは、強制適用された設定を単なる「推奨」に変えてしまいます。
Codex がオープン Web にアクセスする方法は2つあります。プロバイダーホスト型の検索は、AWS Bedrock Mantle 上のサポートされているモデルを含め、Responses API の web_search ツールを送信します — 高速ですが、動作はプロバイダーによって異なり、制御可能なツール呼び出しではありません。MCP Web 検索(TrueFoundry MCP Gateway の背後にある Tavily や Exa)は、一貫性を保つための推奨手段です。MCP ツールは、ゲートウェイがどのモデルにルーティングするかに関わらず、Codex プロセス内のクライアント側で実行されるためです。
[mcp_servers.web-search]
url = "https://<gateway>/<tenant>/mcp/<mcp-server-name>/server"
http_headers = { Authorization = "Bearer TFY_API_KEY" }
トークンをインラインで記述するのではなく、bearer_token_env_var = "TFY_API_KEY" を使用してください。プロバイダーホスト型の検索を無効にするには、~/.codex/config.toml で web_search = "disabled" を設定します — これによりプロバイダーホスト型のパスのみが無効化され、MCP サーバーは [mcp_servers.<name>] ブロックを削除するまで動作し続けます。検索を MCP サーバーとして登録することは、MCP gateway access control のもとでそのツールのトラフィックを管理可能にする手段でもあります。
すべての補完リクエストがゲートウェイを通過するため、開発者の意図に関わらず追跡ログが残ります — 解決されたユーザー、提供されたモデル、トークン数、レイテンシを含む各リクエストが Request Traces に記録されます。
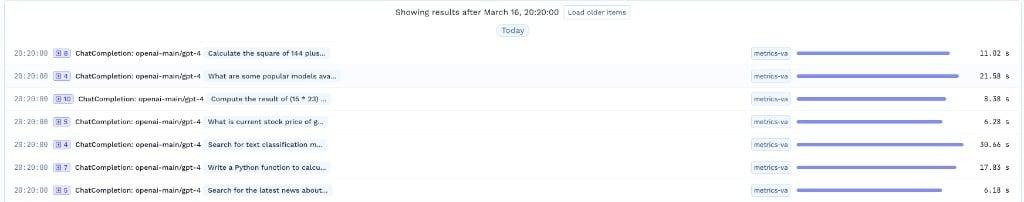
その上位のメトリクスダッシュボードでは、フリート全体のデータが集約されます: ユーザー、チーム、モデルごとの支出とボリューム。
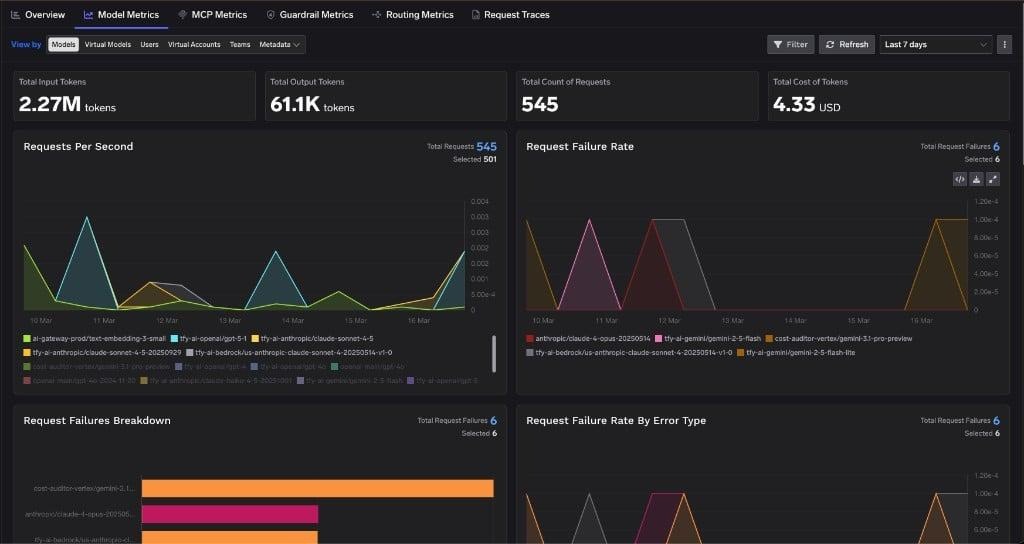
ユーザーとモデル全体で集計されたリクエストボリューム、トークン使用量、コストを表示する TrueFoundry のメトリクスダッシュボード
ゲートウェイ上のすべてのコーディングクライアントが同じビューに集約され、centralising cost control across AI coding IDEs で説明されているように、4つのビューではなく1つのコスト全体像が提供されます。
200人のエンジニア、macOS および Windows、ChatGPT Enterprise を購入済み。開発者は Codex を維持し、セキュリティチームは属性情報を取得し、財務チームはチームごとの数値を取得します。
1. プロバイダーの作成。 Integrations → Providers → OpenAI、ベース URL https://chatgpt.com/backend-api/codex、API key フィールドは空のまま — 次の管理者が「修正」しないように運用手順書に明記します。
2. Virtual Model の作成。 スラグ gpt-5.2-codex — 完全修飾名ではなく、実際のモデル ID を使用します。1つの ChatGPT サブスクリプションターゲットと、フェイルオーバー用の API キーバック型ターゲットを用意します。
3. MDM 設定の準備。 GATEWAY_URL、CONTROL_PLANE_URL、TENANT_NAME に加え、CODEX_AUTH_MODE="chatgpt-subscription" および CODEX_DEFAULT_MODEL="gpt-5.2-codex" を設定します。
4. スクリプトを root 権限で1時間ごとに実行。 tfy-local-ai-setup v1.3.5 をインストールし、各ユーザーのトークンを更新し、macOS では managed_config.toml、Windows では requirements.toml を書き込んで両方をロックします。
5. Windows への展開条件を codex --version に限定。 v0.156.0 未満のバージョンは強制適用が効きません。カバー率を主張する前にフリートのバージョン分布をレポートしてください。
6. 検証。 schg については ls -lO、i については lsattr、所有者 Administrators と Users:(RX) については icacls を確認します。次に Request Traces を開き、リクエストにサービスアカウントではなく開発者の名前が表示されていることを確認します。
7. Web 検索パスの制限。 MCP Gateway の背後に Tavily または Exa を登録し、web_search = "disabled" に設定します。
現実的な限界: これらの手順はモデルプロバイダー、認証、支出を統制します。開発者が有効化できる MCP サーバーまでは制御できません。
MDM スクリプトは MCP サーバーを制御しません。 managed_config.toml の管理は、モデルプロバイダーと認証をカバーします。開発者がどの MCP サーバーを有効化できるかに関する Codex の強制適用機能は、macOS および Linux 上の別のファイル /etc/codex/requirements.toml に存在し、tfy-local-ai-setup はこれを書き込みません。スクリプトとともにそれをデプロイしてください — MDM の設定が MCP のアローリスト指定までカバーしていると監査人に説明してはいけません。
2つの MDM スクリプト、1つの設定ファイル、異なる固定バージョン。 Codex スクリプトは tfy-local-ai-setup v1.3.5 を固定し、Claude Code スクリプトは v1.3.4 を固定します。どちらも同じマシン上で1つの保存された設定ファイルを共有する1つのバイナリを記述しているため、両方を実行するフリートは1時間ごとに異なるバージョンを再インストールすることになります — そして Windows Codex のサポートは v1.3.5 以降でのみ存在します。両方を有効にする前にバージョン固定を [要確認] してください。
ドキュメント内のモデルバージョンの乖離。 Codex のページでは GPT-5.3-Codex がアナウンスされている一方で、すべての設定例、スラグのガイドライン、MDM のデフォルト値では gpt-5.2-codex が使用されています。CODEX_DEFAULT_MODEL で明示的に指定してください。ロールアウト前に現在のモデル ID を [要確認] してください。
Cursor は同じ方法で強制適用できません。 Cursor の MDM ポリシーはモデルではなくフックを対象としています: ベース URL、API キー、モデルリストは MDM で強制適用できないため、開発者はいつでもこれらを変更できます。Copilot CLI にも BYOK 用の settings.json パスはありません。設定が維持されるのは Codex と Claude Code の2つです — 不足している部分は Cursor security でカバーされます。
OpenAI Codex ガバナンスに関するアドバイスのほとんどは、「プロキシ経由でルーティングする」というレベルで終わっています。それは容易な前半部分に過ぎません。難しい後半部分は、そのルーティングが実際のフリート環境で維持されるかどうかを決定することです: ミスのように見えて実は正しい空の API キーフィールド、必須の wire プロトコル、モデル ID と厳密に一致させる必要があるスラグ、独自のスキーマを持つ Windows ファイル、それを下回るとコントロールが無言で無効化される最小バージョン、そして緩和してはならない ACL。
これらはポリシーに関する問いではありません。これらは設定上の事実であり、それぞれ確認のために実行できるコマンドが存在します。それがガバナンス文書と統制されたフリートの違いです: 誰かが任意のラップトップに近づき、ls -lO または icacls を実行して、Yes か No の結果を得られるかどうかという点に集約されます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




開発者の協力がなくても機能する4つの統制です。すべてのリクエストに付与される開発者ごとのID、利用可能なモデルに対する管理者の制御、個人とチームに紐付けられた支出、ネットワーク経路上で生成される監査ログです。実際には、開発者の設定よりも高い優先度で読み込まれる管理者所有の設定ファイル、ファイルロック、有効期間の短い認証情報で実現します。
はい。requires_openai_auth = trueを設定し、ゲートウェイの認証情報をx-tfy-api-keyに移して、CodexがAuthorizationを自身のChatGPT OAuthトークンに使えるようにします。そのうえで、ゲートウェイのプロバイダーはAPIキーの欄を空にして作成してください。キーを保存すると開発者のChatGPT認証情報が上書きされ、フローが壊れます。これにより、ゲートウェイ側では開発者のIDを、OpenAI側ではその開発者のChatGPTシートを利用できます。
Codex v0.156.0以降でのみ可能です。v0.149.0ではmanaged_config.tomlのサポートが削除され、レジストリによる代替手段もありません。強制の仕組みはrequirements.tomlに移行しましたが、これはトップレベルのmodelキーを持たない別のスキーマです。v0.156.0より前では、優先度が最も低いconfig.tomlしか適用されず、開発者自身の設定で上書きされます。
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、多数のプロバイダーにまたがってルーティングする場合でも、プロンプトとレスポンスがお客様のドメインの外に出ることはありません。
はい。MCP Gateway、Agent Gateway、そしてツール単位のアクセス制御を備えたMCP & Agents Registryが含まれています。LangGraph、CrewAI、AutoGen、または独自のフレームワークで構築されたエージェントを、すべて一元的に統制できます。
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheusに接続できます。LLM分類器の呼び出しごとに個別のスパンが生成されるため、分類器のレイテンシを、提供されるモデルのレイテンシとは別に確認できます。






















