


November 13, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Judgeとは、評価対象の出力、「優れた状態」を定義したルーブリック、そして機械判読可能な判定(pass/fail、スコア、または2つの候補間の好み)を返す指示の3つが与えられたモデルのことです。
これが存在する理由は、他の代替手段ではスケールしないためです。完全一致のメトリクスは正解が1つしかない場合に有効ですが、5つの回答がすべて正解になり得るサポート返信には役立ちません。人間はそれを正確に評価できますが、速度は遅いです。Judgeはその中間に位置します。細心の注意を払う人間よりは劣りますが、文字列比較よりも遥かに優れており、数千のサンプルに対して十分な速度を提供します。これを安価でノイズのある、人間と相関したプロキシとして扱ってください。
ここでの最も一般的な間違いは、オフラインのevaluationとオンラインのgatingを、2つのデプロイ先を持つ単一のものとして扱うことです。
注目すべきは failure(失敗時の影響)の行です。オフラインでの誤ったスコアの影響は、次のスプリントで見直す意思決定を誤る程度ですが、オンラインではユーザーがエラー画面を見つめることになります。そのため、再現率を犠牲にしてでも、精度(Precision)を高めるようにオンライン judge を調整してください。モード間でルーブリック(評価基準)をそのままコピーして使用することが、チームが数パーセントの正常なトラフィックをブロックしてしまう原因となります。
Judges は、記述可能だが計算不可能な基準(取得したコンテキストに根ざしているか、医療環境に適したトーンか、など)の評価に優れています。段落としてルールを記述することはできても、正規表現(regex)で表現することはできません。一方で、主に 3 つのパターンで失敗します。
Position bias(位置バイアス)。 2 つの候補が提示された場合、judge は特定の配置のスロットを好む傾向があります。順序を逆にすると、判定の相当な割合が反転します。緩和策は、位置を入れ替えて各ペアを 2 回評価し、一致した結果のみをカウントすることですが、これによりコストが 2 倍になります。
Verbosity bias(冗長性バイアス)。 追加された単語に価値があるかどうかにかかわらず、長い回答ほど高いスコアを獲得する傾向があります。これにより、本番環境のプロンプトが密かに無駄な引き伸ばしへと誘導されます。judge に対して最適化を行うと、judge は長さを高く評価し、トークン費用が増大しますが、その 2 つの因果関係に誰も気づきません。
Self-preference(自己嗜好)。 モデルは、自身が生成したテキストに似ているテキストをより高く評価します。GPT が GPT の出力を評価するとスコアが過大評価されます。これこそが、テスト対象のモデルとは異なるファミリーのモデルを judge として使用すべき強力な理由です。
また、judges は連続的なスケールでの調整が得意ではありません。10 点満点でスコアを求めると、すべてが 7 や 8 に集中します。厳格な基準に対する二者択一の pass/fail(合格/不合格)判定の方がはるかに信頼できます。そして、judge は保持していない事実を検証することはできません。参照資料がなければ、ファクトチェックではなく、そのモデルの事前知識(priors)が出力されるだけです。
自己選好(self-preference)は実際に存在し、回避可能であるため、評価対象のモデルとは異なるファミリーを使用します。判断とは長いプロンプトに対する分類であり、推論ではないため、思っているよりも小さなモデルで十分です。ロールフォワードするプロバイダーエイリアスはコード変更なしに品質基準を変動させてしまうため、バージョンは動的に変化させず固定(Pinned)にします。そして、ジャッジがテールレイテンシの原因とならないよう、保護対象の処理よりも低い p99 を実現する必要があります。
次に行うのが計算です。インラインジャッジは2回目のインフェレンスを意味します。プロンプトとレスポンスの両方をチェックする場合は2回です。これはエンジニアリングで取り除けるオーバーヘッドではないため、どのトラフィックの切り出しに対して適用するかが問題となります。
ルールをコードとして表現できるのであれば、コードとして表現してください。
オフラインのルーブリックをリクエストパスにデプロイしてしまう。 夜間バッチで機能する10次元のルーブリックは、プロダクション環境では低速で分散の大きいブロッキング要因になります。オンラインルーブリックは単一の基準かつバイナリであり、小規模モデルが安定して回答できる程度に厳密に言語化されている必要があります。
ジャッジ自体の計測を行わない。 プロダクション環境のモデルであるにもかかわらず、独自の評価が行われていません。数百件の実際のサンプルに手動でラベルを付け、適合率(precision)と再現率(recall)を個別に計測してください。偽陽性率を提示できない場合、ガードレールがユーザーのどれだけの割合に悪影響を与えているかを説明できません。
いきなりブロッキングに移行する。 精度90%のジャッジは、適用した当日に適切な回答の10回に1回をブロックします。まずは監査モード(Audit)で運用し、1週間分のトレースを確認してから昇格させてください。
ストリーミングレスポンスを考慮し忘れる。 ブラウザにトークンをストリーミングすると、出力ジャッジはストリームが終了するまで判定する対象がありません。TrueFoundryを含むほとんどのゲートウェイは、ストリーミングリクエストでの出力ガードレールをスキップします。
TrueFoundryには評価(eval)プロダクトはありません。 評価ページ、データセット、実験追跡、スコアリングUIなどは存在しません。オフライン評価は専用に構築されたプラットフォームの領域であり、TrueFoundryの役割はOpenTelemetry経由でトレースをエクスポートすることです。その画面から出力されるのはOTELメトリクスではなくトレースです。スコア付きのデータセットやリーダーボードが必要な場合は、Braintrust、Arizeなどの同等ツールを使用し、エクスポート先をそちらに指定してください。
TrueFoundryが実装しているのはオンライン側の処理です。リクエストパス内でガードレールとして動作するジャッジであり、その判定結果、レイテンシ、トークン消費量は、保護対象のリクエストと同じトレース上に記録されます。

LLMガードレールの実行フロー:入力のミューテーション、並列入力バリデーション、モデル呼び出し、そして出力のミューテーションとバリデーション
以下の各ジャッジは、デプロイする小さなサービスであり、カスタムガードレールのコントラクトを通じてレールとしてゲートウェイから呼び出されます。そのコントラクトには、暗記しておくべき重要なルールが1つあります。HTTP 2xxはガードレールが最後まで実行されたことを意味し、ポリシーの決定内容はJSONボディ内にのみ存在します。 ドキュメントにも警告されている通り、HTTP 400として出力された「blocked」はランタイムエラーとして解釈され、スルーされてしまう可能性があります。verdict: false を含めた 2xx を返してください。
NeMoはTrueFoundry上にデプロイされたFastAPIラッパーとして動作します。ゲートウェイからのネイティブNeMo SDK呼び出しや、アプリ内のクライアントSDKの変更は不要です。内部では、小さなジャッジLLMとドメイン特化言語であるColangを使用し、self_check_input および self_check_output レールを通じてプロンプトとレスポンスを評価します。ルーブリックはColangバンドル内に保持され、config/prompts.yml には、v1においてDANスタイルのロールプレイ、「以前の指示を無視する」、システムプロンプトの抽出、およびポリシー回避マーカーを検出するためのFew-shot例が含まれています。
運用上重要な詳細:ジャッジ LLM は同じ TrueFoundry gateway を通してコールバックします。 ラッパーの .env には TFY_BASE_URL、TFY_API_KEY、および JUDGE_MODEL が保持されます。ドキュメントの例は openai-main/gpt-4o-mini です。ジャッジの推論は gateway トラフィックであるため、そのトークン、コスト、レイテンシは他のすべてと同じダッシュボードに反映され、ガードレールのコストを把握できます。ジャッジの交換は1行で完了します。JUDGE_MODEL(ドキュメントでは openai-main/gpt-4o を表示)を変更して再デプロイするだけです。
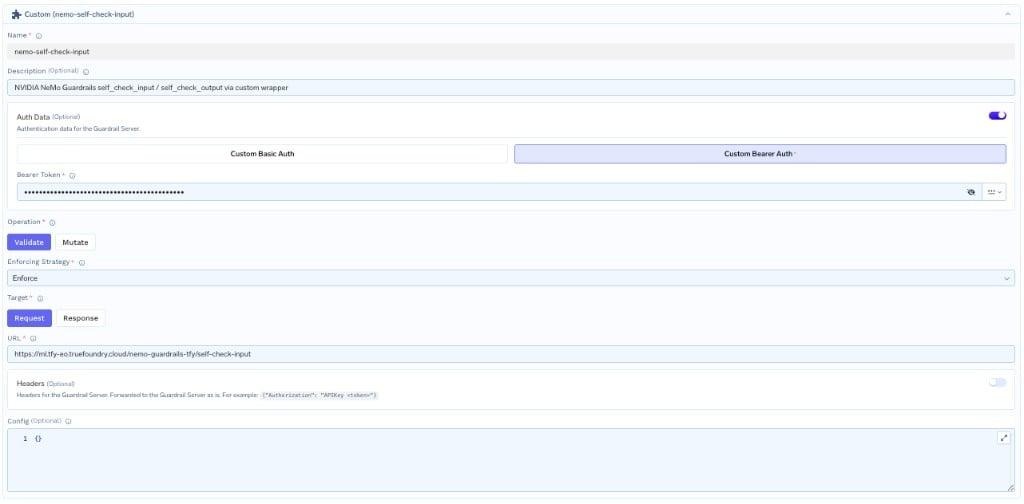
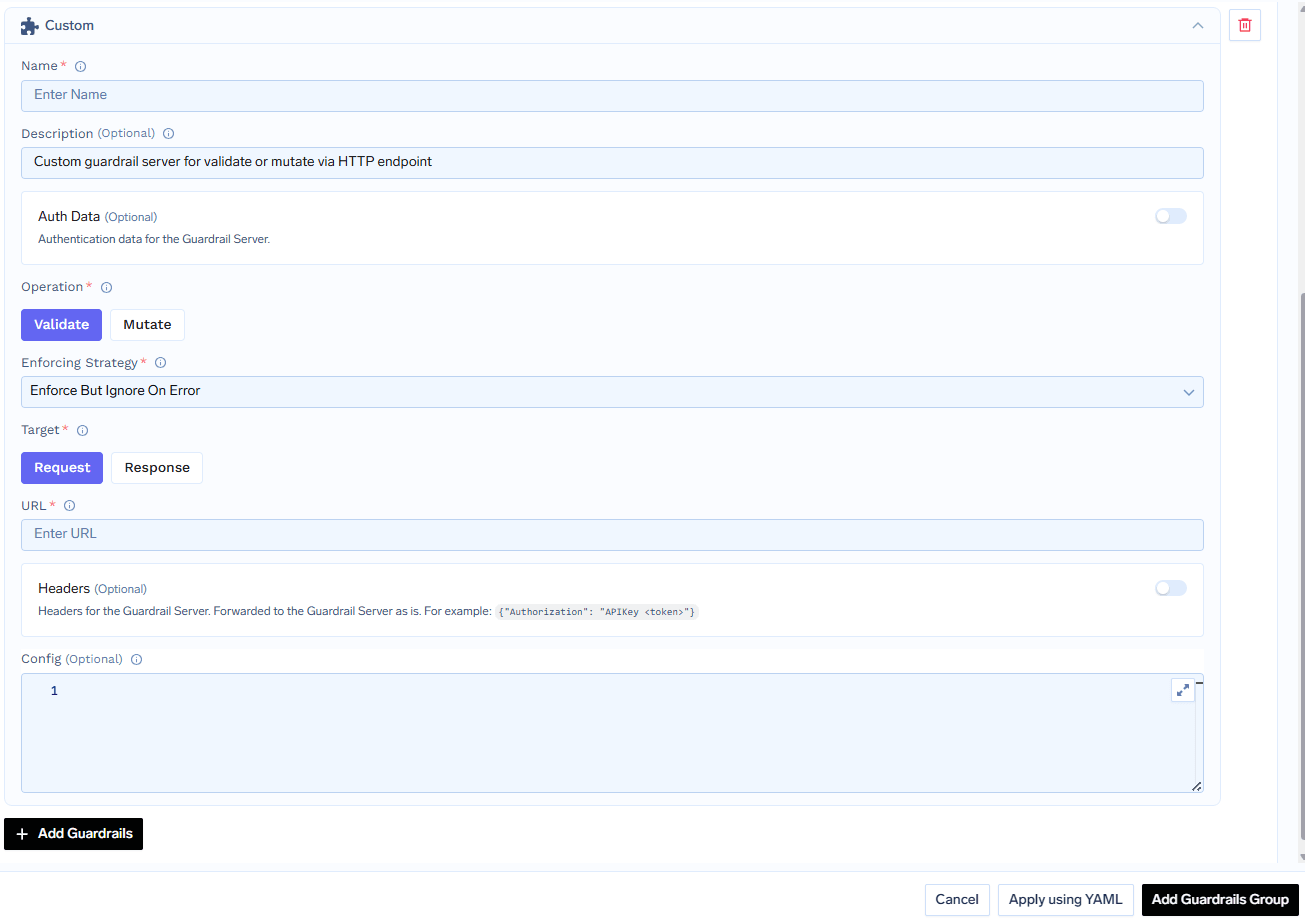
2つのCustom Guardrail Configs(両方ともValidate — セレクターはnemo-self-check/nemo-self-check-inputおよび.../nemo-self-check-output)を登録し、Enforce But Ignore On Errorを推奨します。判定のコントラクトは非常に小さく、HTTP 200と{"verdict": bool, "message": Optional[str]}を返します。本物のエラーは5xxとして送信されます。
Gatewayはインプットrailの呼び出しとモデルの呼び出しを平行してディスパッチするため、Judgeによってtime-to-first-tokenが増加することはありません。ブロック時には、実行中のモデル呼び出しをキャンセルします。アウトプットrailは必須であるため、順次実行されます。
ドキュメントにはコストについての率直な記載があります。既知の制限事項の中で、彼ら自身の言葉で次のように述べられています:保護されたすべてのリクエストにおいて、方向ごとに1回、計1回または2回のLLM呼び出しが追加されます。また、コントラクトがバッファリングされるためストリーミング対応のGuardrailが存在しないこと、およびインメモリ状態がレプリカごとであることも指摘されています。
Patronusはカタログの中で最もターンキー型Judgeに近い存在であり、Validate専用です — 操作は文字通り「validate」であり、ドキュメントには変更(mutate)できないと明記されています。
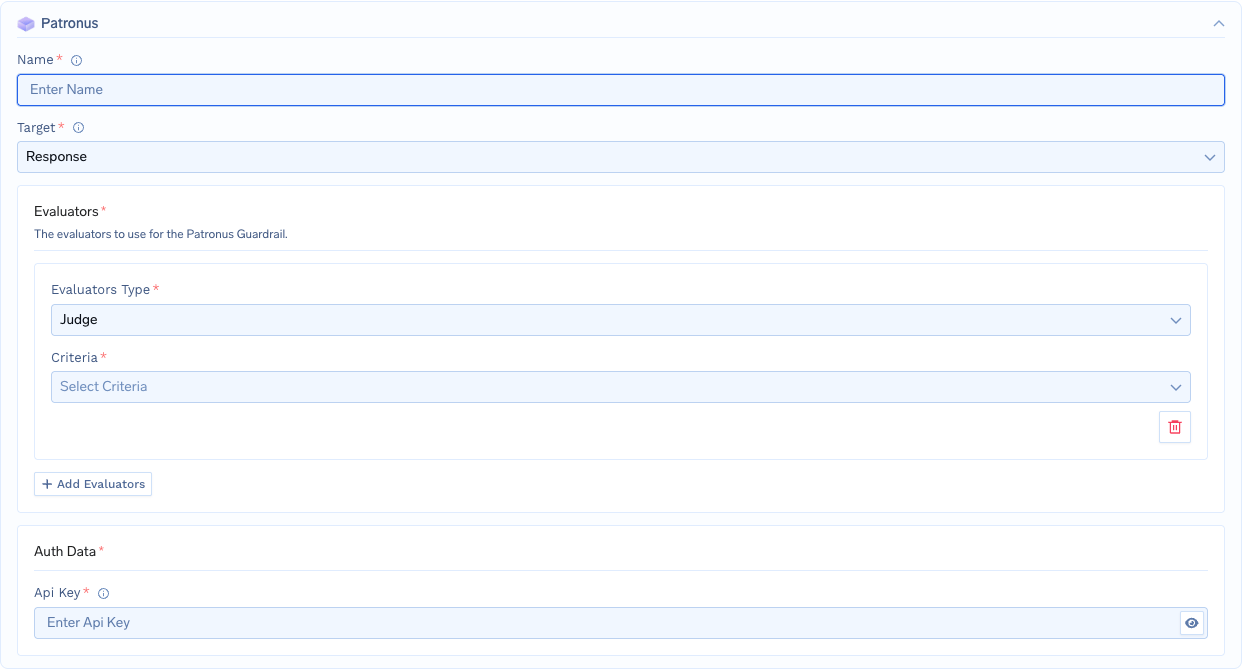
Config typeはintegration/guardrail-config/patronusです。targetをrequestまたはresponseに設定し、評価器(evaluators)をリスト化します。評価器にはanswer-relevance、glider、judge、pii、phi、toxicityの6つのタイプが存在します。judgeタイプはLLM-as-a-judgeであり、そのcriteriaフィールドは必須です。ドキュメント化されている15個の全値は以下の通りです:
姉妹ファミリーであるgliderは、さらに5つを追加します:patronus:is-compliant、patronus:is-factually-consistent、patronus:is-good-summary、patronus:is-harmful-advice、patronus:is-informal-tone。
上記の決定テーブルと比較すると、その役割分担は明確です。is-jsonやis-csvはValidatorのほうがより適切かつ安価に実行できる形式チェックであり、no-harmful-therapeutic-guidanceやis-good-summaryはJudgeが対象とする散文専用の基準です。
data.results[].evaluation_result.passがfalseの場合、リクエストはブロックされ、400が返されます。ドキュメントのレスポンス例では、evaluator_id: "judge-large-2024-08-08"、evaluator_family: "Judge"、profile_name: "patronus:prompt-injection"、pass: false、score_raw: 0、evaluation_duration: "PT4.44S"、usage_tokens: 687、およびevaluation_metadata.highlighted_wordsが表示されています。ページ内では最速で100 msのレスポンス時間を謳っていますが、その4.44秒という例の所要時間は、Judgeのテールレイテンシーがその中央値とは異なることを思い起こさせます。
Guardrails AIの大部分は意図的にJudgeを使用していません。7つのエンドポイントにわたるv1バンドル(DetectPII、SecretsPresent、ToxicLanguage、ProfanityFree)は、ラッパーPod内でローカルに実行され、リクエストごとのLLMラウンドトリップがなく、定常状態のレイテンシーは100 ms未満です。
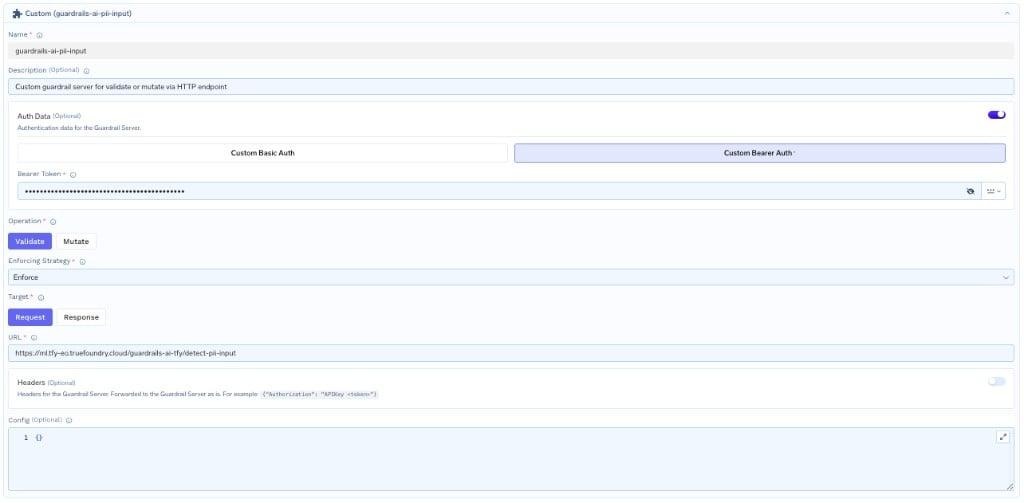
JudgeベースのValidatorはHubからのオプトインティアであり、hub://guardrails/restricttotopic(LLM判定)、hub://guardrails/provenance_llm(ドキュメントで高コストとマークされています)、およびhallucination_checkが含まれます。これらをLITELLM_*環境変数経由で設定し、NeMoがJUDGE_MODELで使用するのと同じパターンで、統合された可観測性のためにGateway経由でルーティングします。それらの隣には低コストな代替手段も用意されています。competitor_checkはアローリストベースであり、regex_matchはドキュメントの言葉を借りれば低コスト(cheap)です。
TrueFoundryのハルシネーションに関するページには、事実的(factual)、文脈的(contextual)、論理的(logical)、情報源(source)の4つのタイプと、正確に2つの実装ルートがドキュメント化されています。1つはGroundingとRelevanceを有効化し、Guardrail ActionをBlockに設定して閾値を設定するAWS Bedrock Guardrails、もう1つはテンプレートリポジトリ上のカスタムGuardrailです。
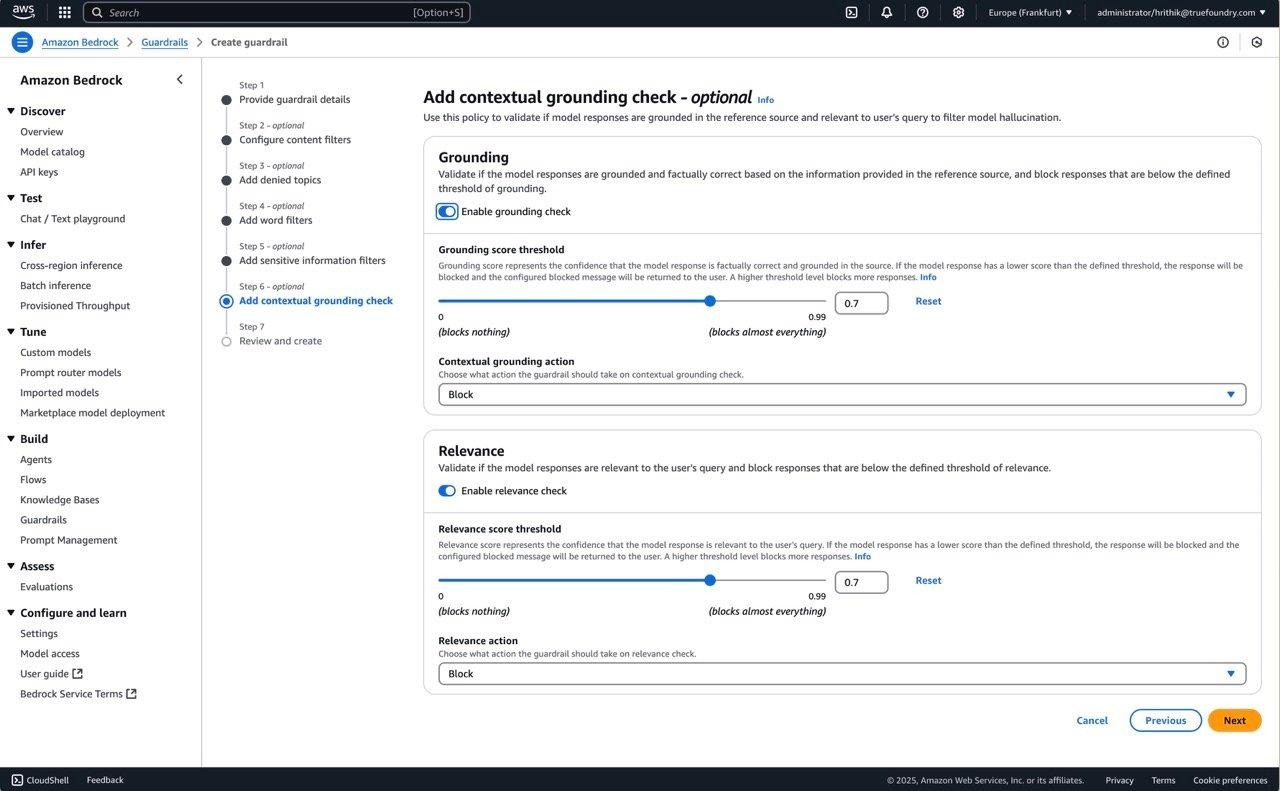
ドキュメントには、テンプレートリポジトリには現在ハルシネーションGuardrailがデフォルトで含まれていないことが明確に記載されています(PIIのマスキングやNSFWフィルタリングなどの例が同梱されています)。カスタムルートを選択することは、チェックボックスをオンにするだけではなく、実際の開発作業が必要であることを意味します。
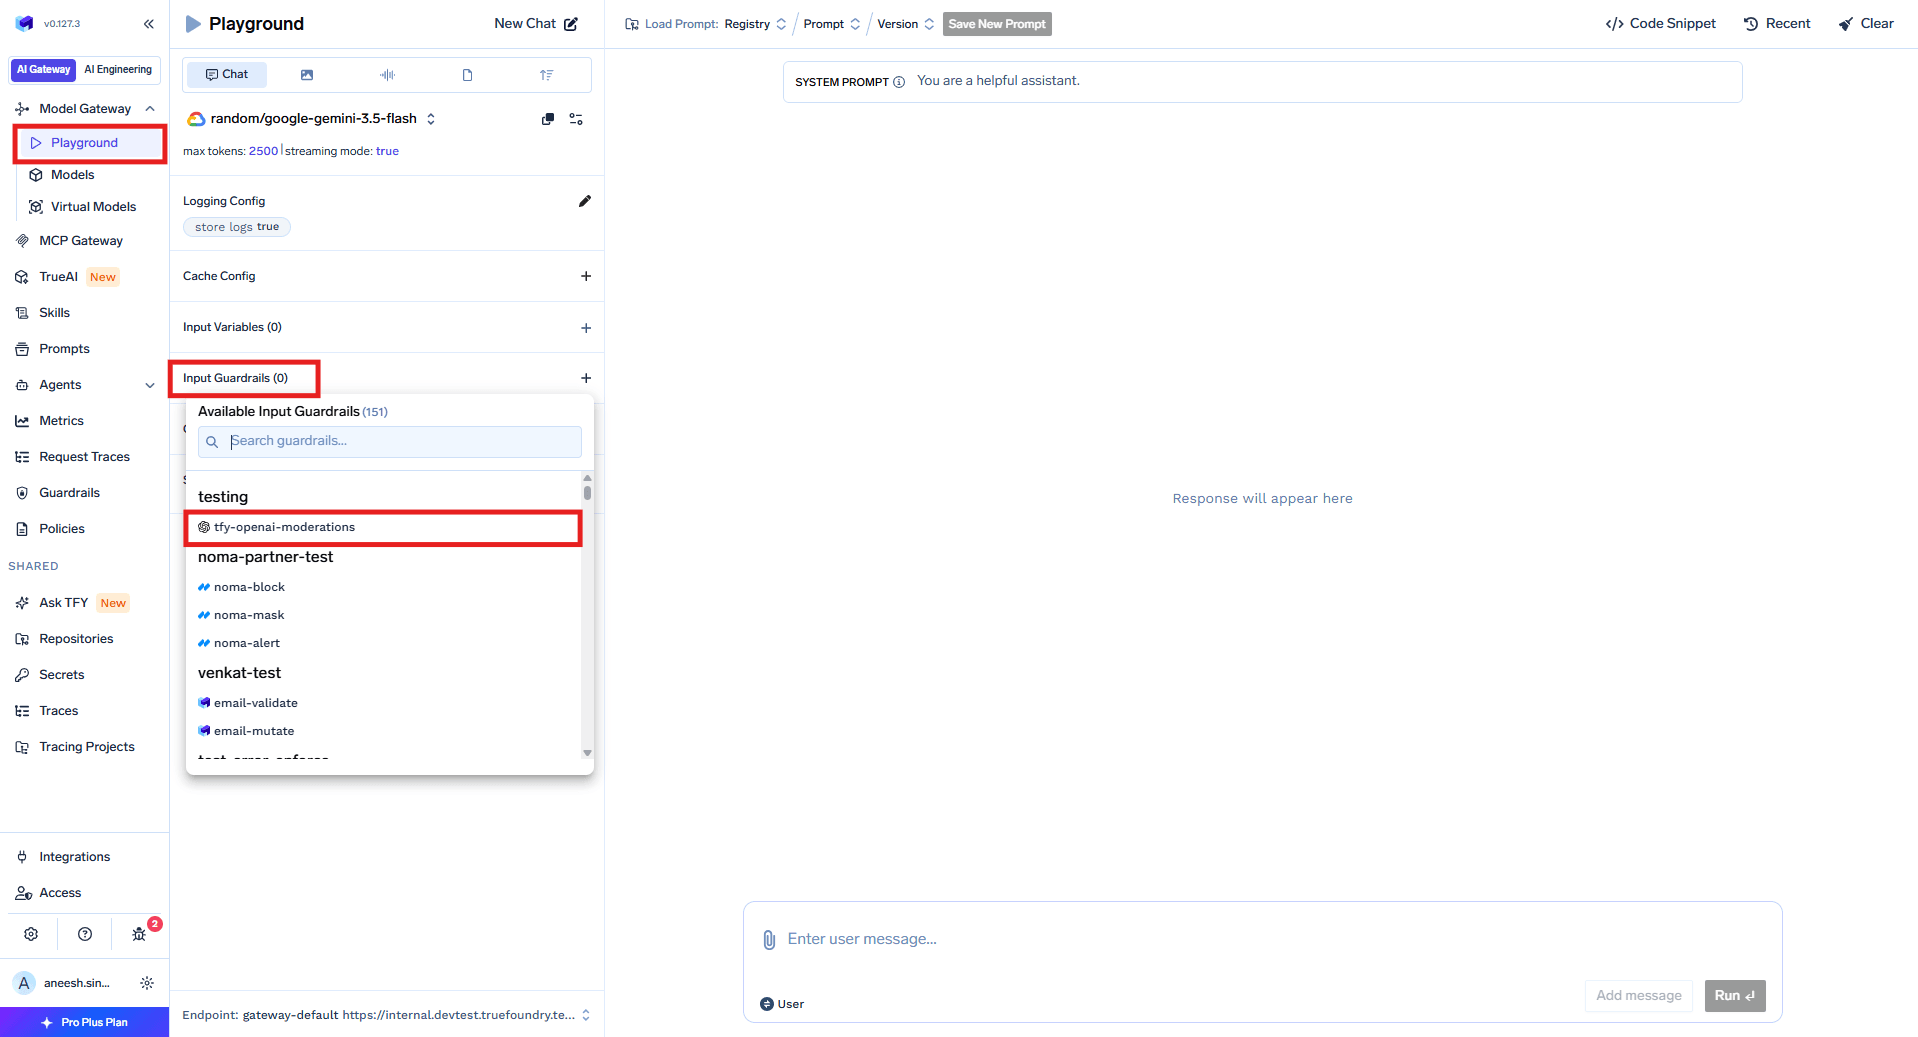
Playgroundは4つのフックすべてを実行するため、ポリシーが存在する前にインプットrailに対して敵対的なプロンプトを送信してテストできます。
運用開始後は、各Guardrail評価がMonitor → Request Traces内で独自のパンくず(span)となり、実行時間、結果、スコープ、入力、出力が記録されます。拒否された呼び出しもブラックボックス化されることなくエビデンスとして保持されるよう、ブロックされたリクエストについてもログが取得されます。

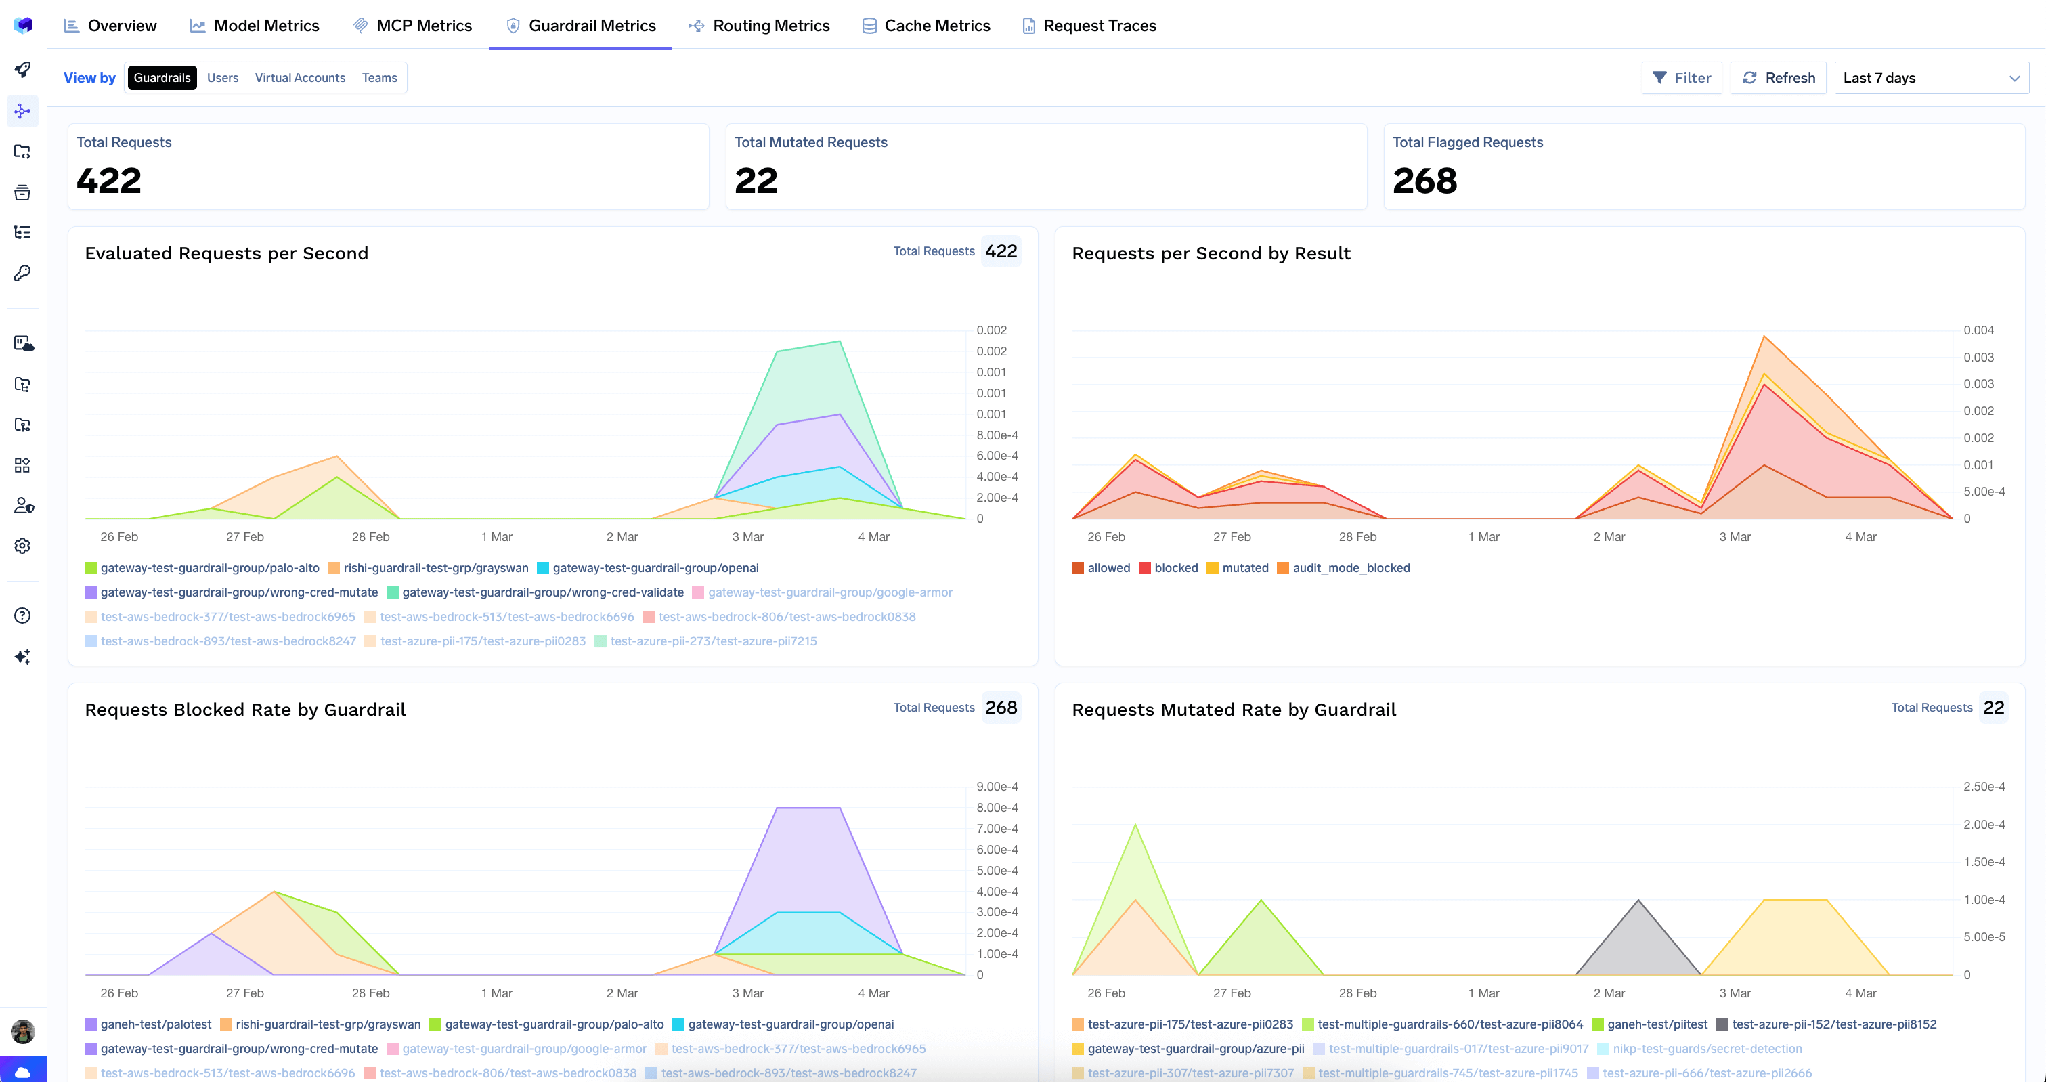
全体としては、Metrics Dashboard のガードレールビューで、リクエスト/秒を allowed、blocked、mutated、audit_mode_blocked に分割し、ガードレールごとのブロック率と変異(mutate)率、および P50、P75、P90、P99 におけるガードレールのレイテンシ を表示します。この最後のチャートにより、judge のテールレイテンシが自社システムのテールレイテンシになってしまっている事態を検知できます。
judge による判定は品質に関する主張であり、それをテストする唯一の方法は、同じリクエストに対する人間の判定と照合することです。AI Gateway のすべてのレスポンスには、x-tfy-feedback-target-id ヘッダーが含まれています。これを POST https://{control_plane_url}/api/svc/v1/gateway-feedback に対して {"target": {"feedbackTargetId": "<base64>"}, "rating": 4, "comment": "...", "metadata": {...}} というボディで送信すると(rating は 1(最低)〜 5(最高))、{"data": {"id": "..."}} が返されます。修正には PUT .../gateway-feedback/{feedback_id} を、削除には DELETE を使用します。フィードバックはスパンの横に表示され、全リストは Raw Data の tfyGatewayFeedbacks に格納されます。
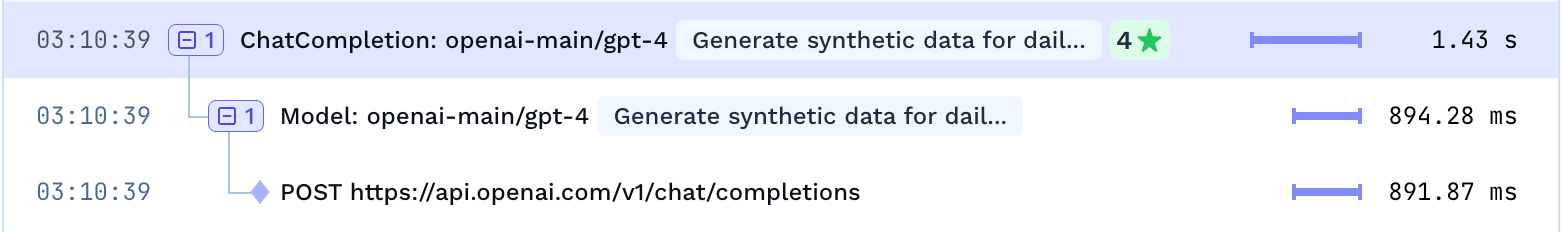
1 つの制限事項として、target ID が指定できるのは ルートスパン のみです。フィードバックはサブステップではなく、リクエスト全体に対して付与されます。
ある社内アシスタントがケアコーディネーターの質問に回答しています。コンプライアンスチームは、有害な治療ガイダンスを絶対に出さないこと、そして臨床的に適切なトーンを保つことの 2 点を求めています。どちらも正規表現では表現できないため、まさに judge の領域です。
1. 最も狭いルーブリック(評価基準)を選択する。 10 個ではなく 2 個の Patronus judge 基準(patronus:no-harmful-therapeutic-guidance と patronus:clinically-inappropriate-tone)を選択し、target: response に設定します。コンプライアンスのリストの残りは、安価な検出器にまわします。
2. Audit モードから開始する。 AI Gateway → Policies → Guardrails の下にあるポリシー規則で、評価戦略を Audit(判定をログに記録し、何もブロックしない)に設定し、アシスタントのモデルとケアコーディネーターチームに適用範囲を絞り込みます。
3. 1 週間分のトレースを確認する。 audit_mode_blocked は、このルールが実際の全リクエストのうちどれくらいをブロックしていたはずかを示し、evaluation_metadata.highlighted_words はその理由を示します。通常、トーン基準は、たまたま簡潔だっただけで問題のない優れた回答に対して誤検知(発火)しています。
4. 人間の判断と比較する。 アシスタントの高評価/低評価コントロールを、x-tfy-feedback-target-id を介してフィードバック API に連携します。フラグが立ったリクエストが人間によって 1 や 2 と評価されたものであれば、judge は期待どおり機能しています。そうでなければ、閾値ではなくルーブリック自体を修正します。
5. 本番(Enforce)へ昇格させ、費用を監視する。 Enforce But Ignore On Error に変更し、Patronus で障害が発生した場合でも自社サービスの停止ではなく、ガードレールなしの状態に安全にデグレードするようにします。Patronus は評価ごとに usage_tokens を報告し、judge の推論はゲートウェイ経由でルーティングされるため、評価のコストは推測ではなく明確に可視化されます。そして、その数値に基づいてサンプリングレートを決定します。
ストリーミングレスポンスでは出力ガードレールがスキップされます。 "stream": true の場合、出力レールは実行されません(入力レールは常に実行されます)。製品がストリーミングを行う場合、judge が保護するのはプロンプトのみとなり、出力は保護されません。
システムプロンプトはガードレールに渡されません。 ゲートウェイは、コンテンツをガードレールに送信する前にシステムプロンプトを除外します(CrowdStrike AIDR のみが唯一文書化されている読み取り専用の例外です)。したがって、judge は指示が守られたかどうかを評価できません。
出力の検証で失敗しても、モデルの呼び出しコストは発生します。 入力レールが処理の途中で失敗した場合、ゲートウェイはリクエストをキャンセルできます。一方、出力レールはレスポンスが生成された後に実行されるため、ドキュメントに記載されているとおり、その時点ですでにモデルのコストが発生しています。
LLM as a judge は、適切な限定的ユースケースにおいて優れた手法です。主観的なテキストを大規模に評価する唯一の方法である一方で、長い回答、自身と同じファミリーの出力、そして最初に提示された候補を偏好するバイアスが存在します。前半のメリットだけを鵜呑みにしたチームは、自社のユーザーを静かにブロックし続けてしまうガードレールを運用することになります。
それを扱いやすいものにする分割は、このポストの冒頭で触れたものです。オフラインスコアリングは評価プラットフォームに属するデータセットの問題であり、TrueFoundryはOTELを介してトレースをそこにエクスポートします。オンラインゲーティングはリクエストパスの問題です。単一の厳しい基準、異なるファミリーからの小さな固定されたjudge、最初に監査モード、再現率よりも適合率、そしてコストに対する誠実な可視性が必要となります。
可能な限りルールをコードとして記述してください。文章でしか記述できない場合は、ジャッジ(審判員)を使用し、モデルとして測定してください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




ある言語モデルを使って、別のモデルの出力を文章化された評価基準に照らして採点し、合否、スコア、候補間の優劣といった機械可読な判定を返す手法です。自由形式のテキストには計算可能な正しさの指標がないために生まれたもので、人間の評価者に代わる、安価でノイズのある代用手段として扱うのが最適です。
範囲が狭く、二値で、厳密に表現された基準であれば、多くの場合は十分です。幅広い品質評価基準では、通常は不十分です。まず、人手でラベル付けした例を使って適合率と再現率を別々に測定してください。精度90%のジャッジは、強制を始めたその日から、正当な回答のおよそ10件に1件をブロックします。
ガード対象のリクエスト1件につき少なくとも1回の追加のモデル呼び出しが発生し、プロンプトとレスポンスの両方を判定する場合は2回になります。TrueFoundryのNeMoのドキュメントにも、この計算が明記されています。調整できるのはカバレッジだけです。テレメトリ用にはサンプリングを行い、絶対に見逃せないチェックにだけ全件カバレッジを割り当ててください。
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、多数のプロバイダーにまたがってルーティングする場合でも、プロンプトとレスポンスがお客様のドメインの外に出ることはありません。
およそ3〜4ミリ秒で、1,000以上のLLMを対象に、1つのvCPUで350 RPS以上を維持します。ガードレールの処理時間は別枠で、P50、P75、P90、P99で報告されます。
はい。ゲートウェイはOpenTelemetryに準拠しており、外部のバックエンドにトレースをエクスポートします。これにより、ゲートウェイのデータがBraintrust、Langfuse、Arizeなどのプラットフォームに届きます。TrueFoundry自体はオフラインのスコアリングジョブを実行しません。






















