


November 13, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
従来のレッドチーミングは軍事演習に由来します。チームが任命され、攻撃者のようにシステムを攻撃し、成功した手法を報告します。AI レッドチーミングはその目的を維持しつつ、ターゲットを変更します。モデルの指示追従性、取得したコンテンツの信頼境界、および周辺エージェントが実行する可能性のあるアクションを分析・テストします。
テスト対象はモデルではなく、システム全体です。単体で有害なリクエストを拒否するモデルであっても、その周囲のエージェントが Web ページを取得し、隠された指示を読み取り、ツールを実行してしまうのであれば、それは不十分な結果です。脆弱性は個々のコンポーネント間の縫い目に潜んでいます。
本格的なキャンペーンで発生する事象の大部分は、主に5つのファミリーに分類されます。これらは単一の対策(コントロール)を共有するものではありません。
間接的プロンプトインジェクションは脅威モデルを根本から変えます。 TrueFoundry の agent-guardrails ドキュメントでも引用されている2025年の Comet ブラウザの事例がその代表例です。Web ページに要約エージェント向けの隠し指示が埋め込まれており、エージェントはそれに従ってしまいました。ユーザーが騙されたわけでも、クレデンシャルが盗まれたわけでもありません。コンテンツそのものが攻撃だったのです。エージェントが信頼できないテキストを読み込んだ時点で、そのすべてが信頼できない指示ストリームとなります。
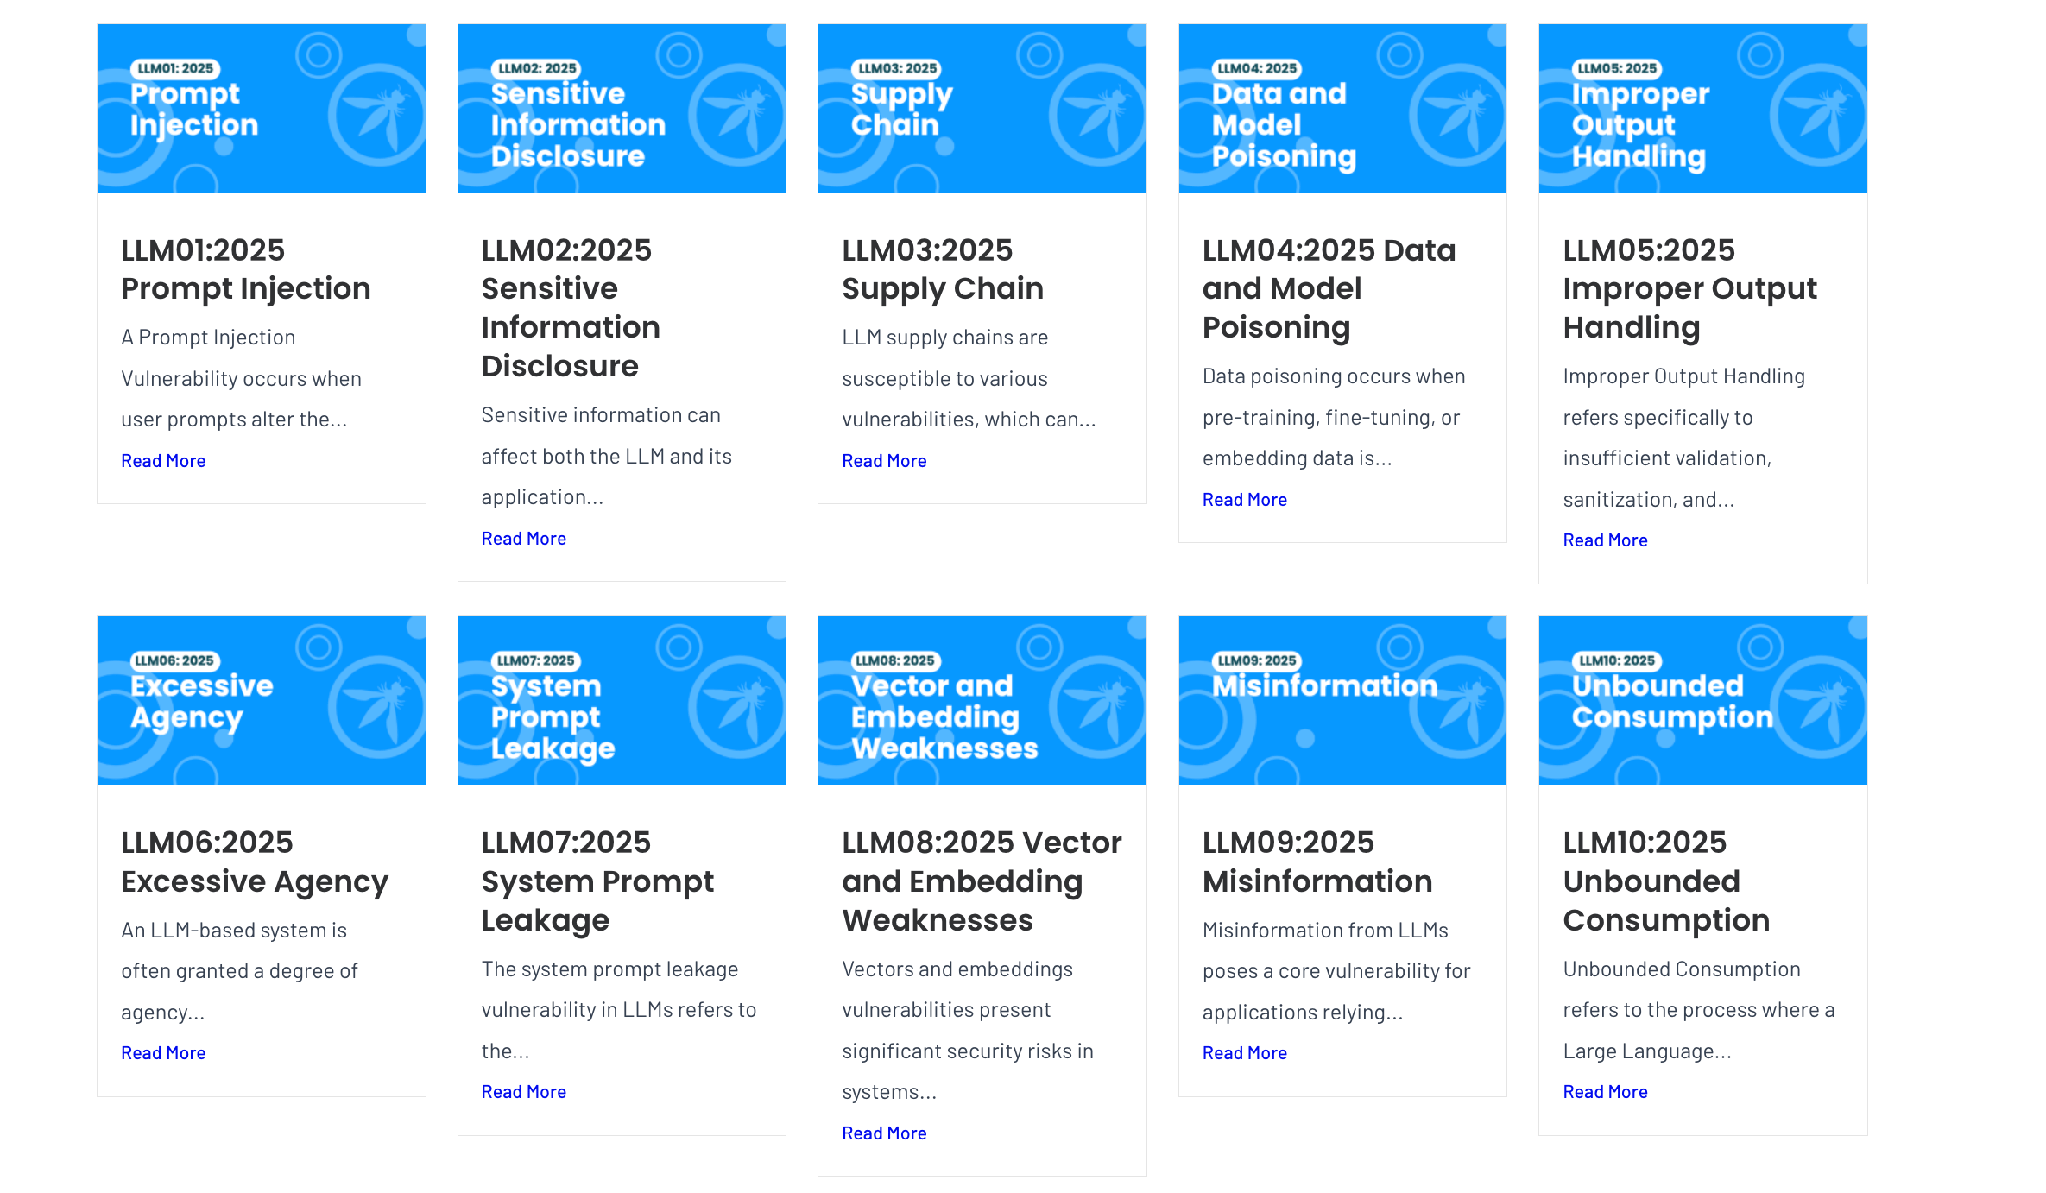
スポンジ攻撃は単なる課金上のトラブルとして処置されがちですが、本質的にはセキュリティ問題です。OWASP が「Model Denial of Service」を LLM10 Unbounded Consumption(無制限の消費) に改称したのはまさにこれが理由です。OWASP LLM Top 10: which risks a gateway actually fixes にて全リストのマッピングをまとめています。10 個のうち 4 個はリクエストパスにおける問題であり、これら 4 個こそが稼働中エンドポイントのレッドチーミングによって浮き彫りになるリスクです。
規律は共通していますが、扱う領域の性質(フィジックス)が異なります。
2つの異なるプロダクトであり、解決する課題も異なります。
キャンペーンは何を強制(Enforce)すべきかを教え、強制はその発見事項の影響を無効化します。 キャンペーンで 40 ページにおよぶレポートを作成しても、リクエストパスに何も変更を加えなければリスクは軽減されません。一方で、キャンペーンを伴わないランタイム強制は、既に検出器が作成されている攻撃に対してしか防御できません。リリース前だけでなく、プロバイダーのチェックポイント更新を含むあらゆるモデル変更時や、ツールの露出面が変更された際(1つの新しい MCP サーバーがモデル変更以上に影響範囲を広げる可能性があります)にもキャンペーンを実行してください。
システムではなくモデルのレッドチーミングを行ってしまう。 チームがベースモデルをテストし、問題のない結果を得た後、データベースツールと Web 取得機能を備えたエージェントをデプロイしてしまうケースです。モデル自体は失敗していませんが、隠された指示を含む最初のページを読み込んだ時点でシステムが崩壊します。
「検出」を「防御」とみなしてしまう。 インジェクション検出器はすべて分類器(Classifier)です。分類器には偽陰性(False Negative)が存在し、攻撃者は低コストで手口を更新してきます。インジェクションは時に成功することを前提とし、侵害されたエージェントが実行できるアクションを最小限に絞り込んでください。読み取り専用のエージェントであれば単なるインシデントレポートで済みますが、シェル権限を持つエージェントの場合は重大なブリーチ(侵害)につながります。
キャンペーンを1回しか実行しない。 古いレポートは、すでに存在しない過去のシステム(異なるチェックポイント、新しい MCP サーバー、変更されたシステムプロンプトなど)を示しているに過ぎません。また、ガードレールがリクエスト全体を認識できることは稀です。除外条件はプラットフォーム依存であるため、コントロールマトリクスを作成する前に自社の条件を確認してください。
最初に、境界を明確にしておきます。 TrueFoundry のガードレールはランタイムでのインライン強制です。リクエストパス内のコンテンツを検証または変異させ、判定を返します。TrueFoundry は、オフラインのレッドチームキャンペーン用ツール(攻撃生成、対抗コーパス、スケジュールスキャン、レッドチームレポートなど)を提供もドキュメント化もしていません。AI Gateway ガードレールのドキュメント全体において、「レッドチーミング」という用語は、OWASP LLM04 のガイダンス内で「特定の評価フレームワークやレッドチーミングに対してモデルをテストする」ことを推奨する箇所に本質的に一度登場するのみです(これは外部の推奨事項であり、機能ではありません)。DeepKeep はレッドチーミング機能が表面化しているパートナーページですが、これはベンダー側で提供される DeepKeep の機能です [要確認]。キャンペーンが必要な場合は、キャンペーン専用ツールを購入してください。以下で説明するのは、強制(Enforcement)側の機能です。
ガードレールは 4 つのフックにアタッチできます:LLM Input、LLM Output、MCP Tool Pre-Invoke、および MCP Tool Post-Invoke。

LLM パスはドキュメント化された 7 つのステップで実行され、そのうちステップ 4 が特に重要です。入力の変異(Mutation)が最初に実行され、完了するまでブロックします。その後、入力のバリデーション(Validation)がモデルへのリクエストと並行してバックグラウンドで開始されるため、最初のトークン生成時間(Time to First Token)に影響を与えません。処理の途中で検証が失敗した場合、Gateway は実行中のモデルリクエストをキャンセルするため、その分の料金は課金されません。出力の変異とバリデーションはレスポンス受信後に同期的に実行されるため、出力側でブロックが発生した場合でもモデル呼び出しのコストは発生します。
ガードレールごとに 2 つの独立した設定があります。Operation Mode は Validate(検証)または Mutate(変異)です。Validate はコンテンツを変更せずにブロックし、Mutate はコンテンツを書き換えた上でブロックも可能であり、優先順位(数値が小さい順)に従って実行されます。Enforcement Strategy は、違反発生時およびガードレールエラー発生時の動作を個別に決定します。
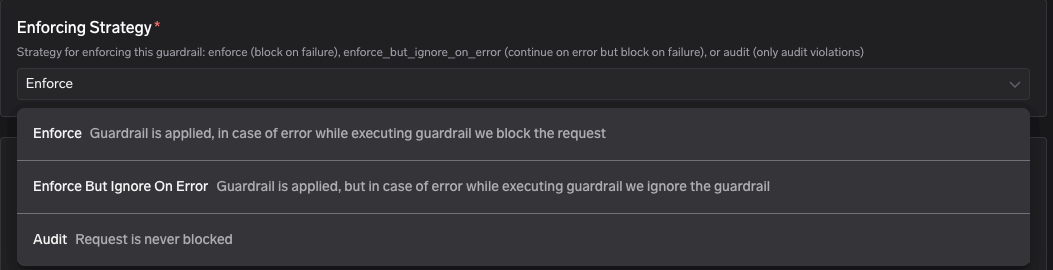
Enforce But Ignore On Error は Fail-Open / Fail-Closed を切り替える設定であり、画面上で最も重要なドロップダウンです。完全な Enforce を指定すると、サードパーティベンダーの障害によって自社のアプリケーションまで停止することになります。ドキュメントで推奨されている段階的導入の手順は Audit → Enforce But Ignore On Error → Enforce です。
公式の truefoundry-guardrails ページによると、10 個のガードレールがネイティブで提供されています:Secrets Detection、Code Safety Linter、SQL Sanitizer、Regex Pattern Matching、Prompt Injection、PII Detection、Content Moderation、Metadata Validation、Cedar、および OPA Guardrails。なお、ドキュメントに一部不整合があり、概要ページには Metadata Validation を除いた 9 個が記載されている場合があります。10 個のリストを正として運用してください。
マネージド Azure サービス上で動作する 3 つの機能(Content Moderation、PII/PHI Detection、Prompt Injection)は、TrueFoundry が Gateway をホストしている場合のみ機能し、セルフホスト環境やハイブリッドの「Gateway Plane のみ」のデプロイでは動作しません。それぞれの機能に対して BYOK(固有キー持ち込み)の代替案がドキュメント化されています(インジェクション対策には Prisma AIRS、PII 対策には CrowdStrike、モデレーションには Bedrock Guardrails)。
対抗テスト・セキュリティに関連する主なパートナー(各社のドキュメントより抜粋):
セキュリティに特化したパートナーは計 13 社存在します。これに評価(Judge)・モデレーション系の統合(Patronus、NVIDIA NeMo、Guardrails AI、Arthur AI、Verra、Azure PII、Azure Prompt Shield、OpenAI Moderations、AWS Bedrock Guardrails)を加えると、2026年9月時点でラインナップは約 20 社に達し、さらに独自のカスタムガードレールを構築するための仕組みも備わっています。

Pre-invoke(実行前)はツールの引数に対して同期的に実行され、検証に失敗した場合ツールは実行されません。Post-invoke(実行後)は実行結果に対して処理が行われ、失敗した場合はその結果がモデルに渡されず遮断されます。Pre-invoke はツールの悪用を防ぐ場所です(引数文字列をチェックする SQL サニタイザーや、コード実行ツールに対するコードセーフティリンターなど)。Post-invoke は、ツールの結果という信頼できないコンテンツから発生する間接的インジェクションを阻止する場所です。
ガードレールは個々のツール呼び出しごとに個別に実行されます。 5 回連続でツールが呼び出された場合、5 回分のフルチェックが行われます。なお、LLM ガードレールの適用範囲を直近 N 件のメッセージに絞り込む X-TFY-GUARDRAILS-SCOPE ヘッダーは、MCP フックには適用されません。ツール定義側のセキュリティについては MCP tool poisoning and gateway defense を参照してください。
ガードレールを登録しただけでは、稼働中のトラフィックには何も影響を与えません。ポリシー(Policy)をバインドして初めて有効化されます。設定パス:AI Gateway → Policies → Guardrails → Add Rule。画面は 4 つのセクションで構成されています — When Request Goes To(モデル、MCP サーバー、特定のツールオプション)、From Subjects(ユーザー、チーム、バーチャルアカウント)、With Metadata、および Apply on Hooks。
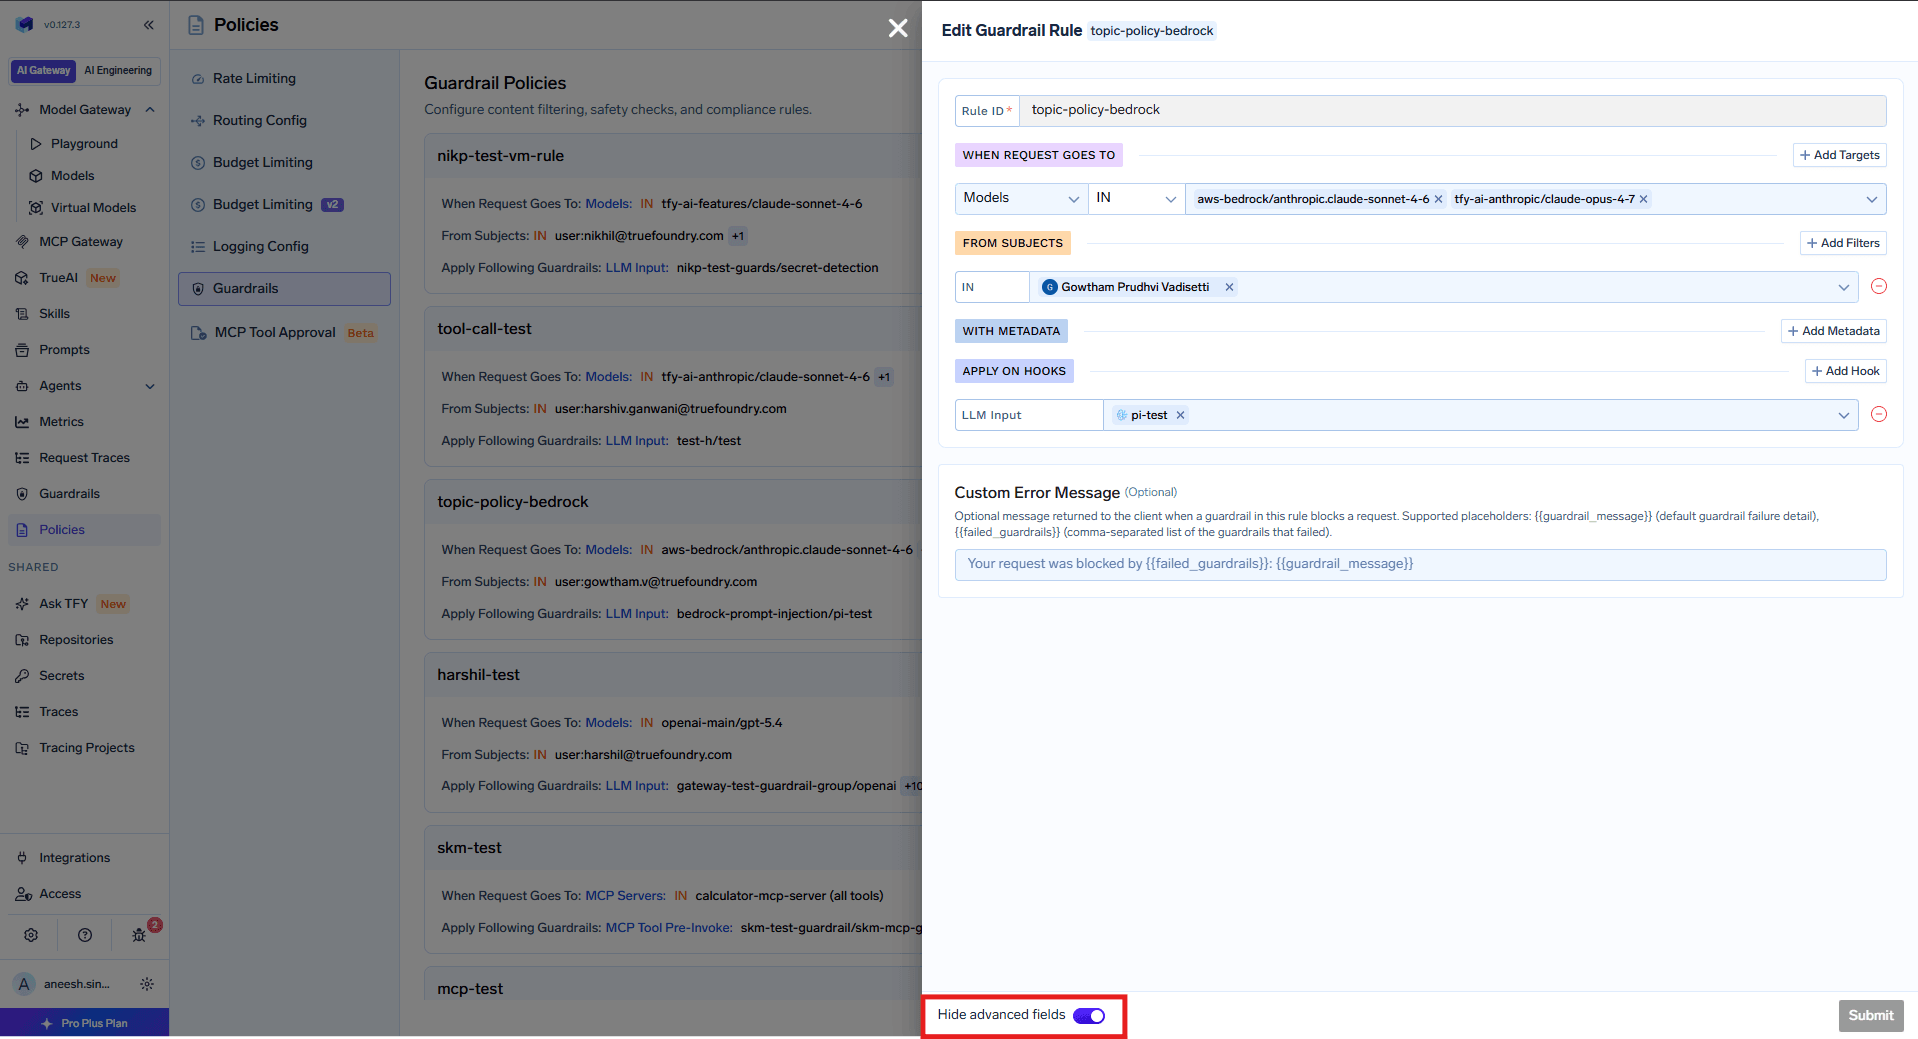
すべてのルールはリクエストごとに評価され、合致するルールはフック単位で和集合(Union)として統合されます。そのため、寛容なベースラインルールと厳格な本番用ルールの両方が同時に適用されます。唯一の例外は X-TFY-GUARDRAILS ヘッダーであり、これはポリシーを完全にスキップするため、特権アクセスとして慎重に取り扱ってください。
2026年9月時点におけるスコープの制限事項:ポリシーの対象(Subject)はユーザー、チーム、およびバーチャルアカウントであり、エージェント自体ではありません。 エージェント ID に連動したポリシー、委任コンテキストを使用したチェーン認識条件、および Agent Gateway 自体に対するフック機能は、ロードマップ上「間もなく提供予定(Coming Soon)」とされています。
メトリクスダッシュボードの Guardrails ビューでは、評価済み(Evaluated)、変異済み(Mutated)、フラグ設定済み(Flagged / ブロック)のリクエスト数が集計されます。判定結果(allowed、blocked、mutated、audit_mode_blocked)ごとの Rps(1秒あたりのリクエスト数)、ガードレールごとのブロック率・変異率、および P50 / P75 / P90 / P99 のレイテンシがグラフ表示され、Guardrail、User、Virtual Account、Team 単位でピボット分析が可能です。
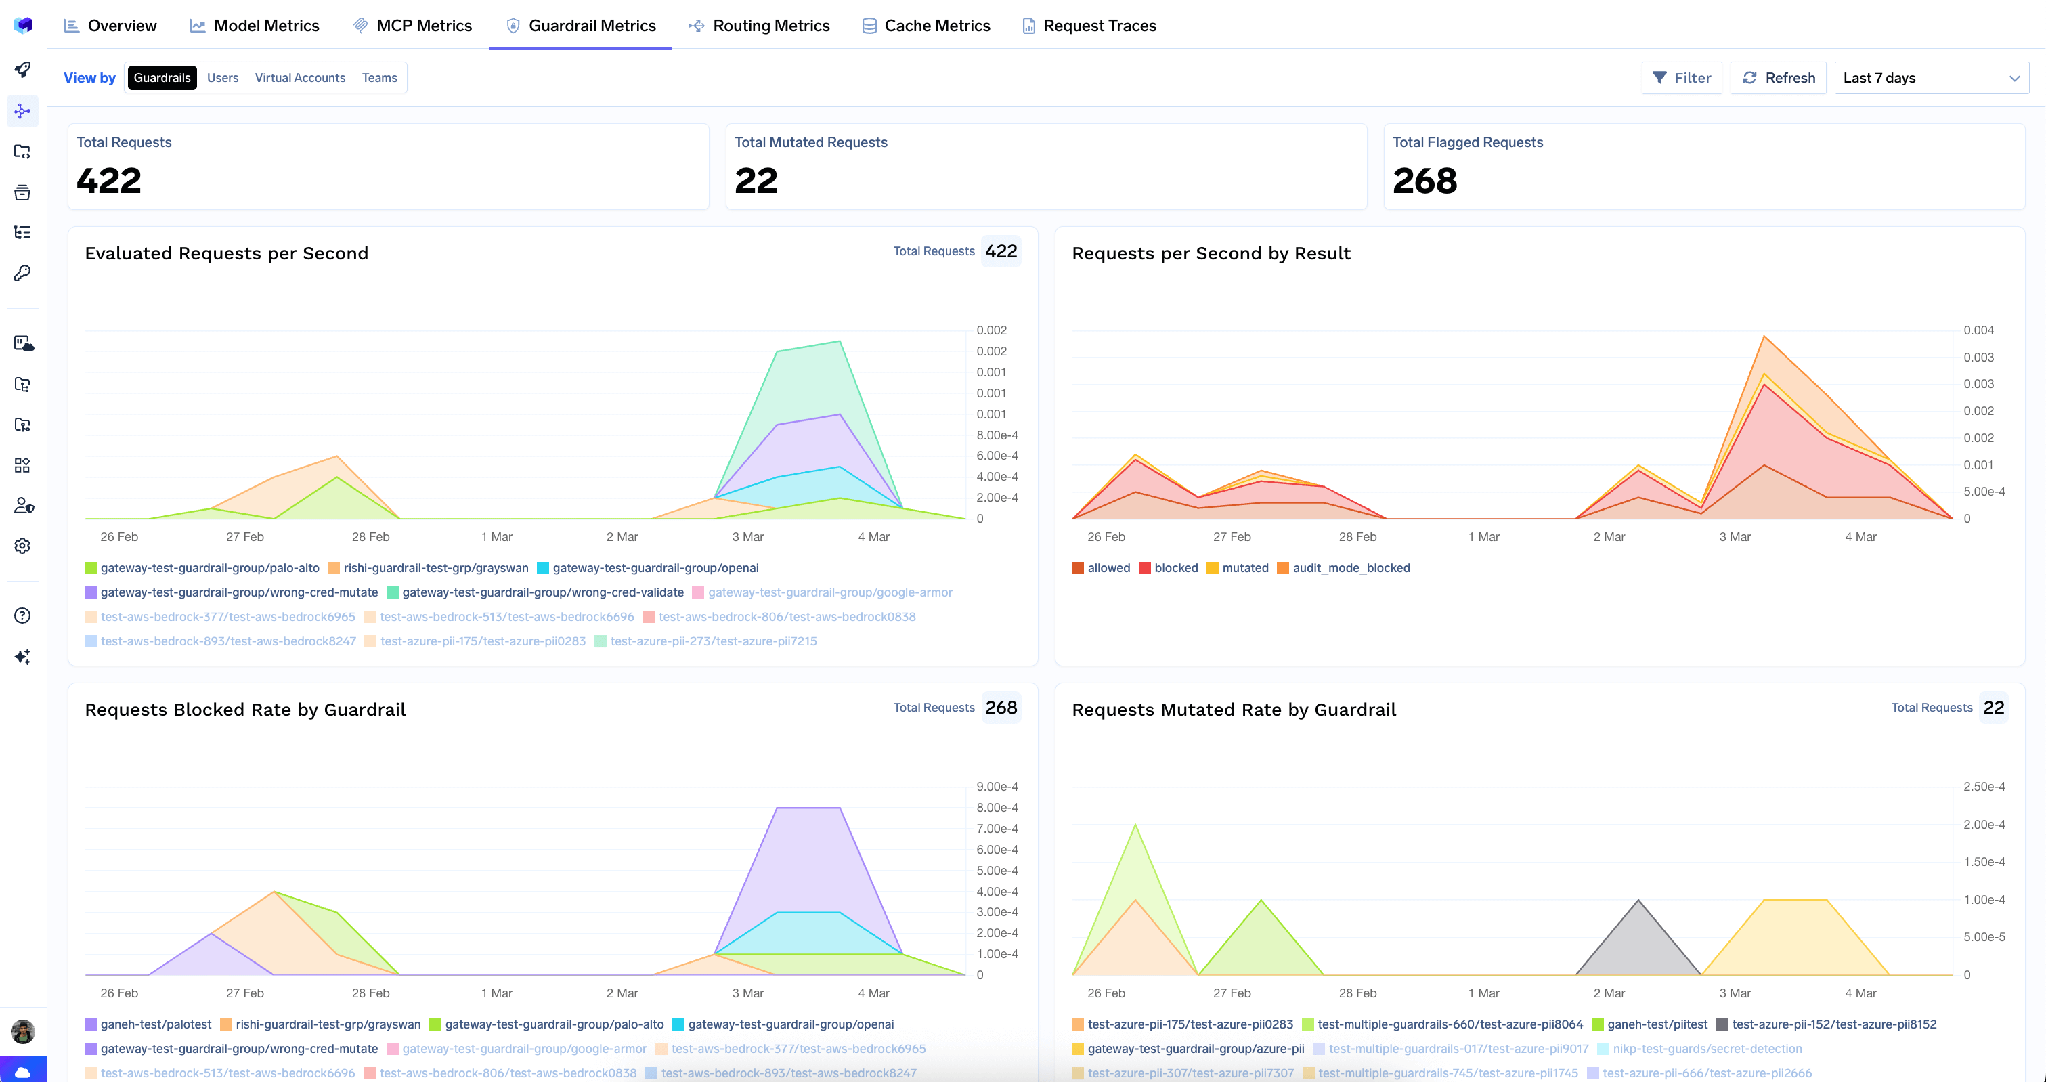
audit_mode_blocked は、Audit モードによる段階的導入を成功させるための重要な指標です。ブロックされていたはずのリクエスト数をカウントするため、実際に強制を開始する前に影響範囲のサイズを把握できます。
カスタマーサポートエージェントに対するキャンペーンを実施した結果、3 つの脆弱性が発見されたケースを考えます。ナレッジベースの記事に含まれる間接的インジェクションにより、呼ぶべきではない内部ツールが呼び出された。エージェントが顧客の電話番号を要約内にそのまま出力した。特定の細工された質問によって 12 回のツールループが発生した。
発見事項をフックにマッピングする。 ドキュメント化されているエージェントトラフィックの基本構成を初期状態とします:入力時の PII 伏字化(Mutate)およびプロンプトインジェクション検出(Validate)、出力時の機密情報検出、ツール実行前の SQL サニタイザーおよびコードセーフティリンター、ツール実行後の PII・機密情報の伏字化。インジェクションの脆弱性対策において最も重要なフックは、汚染された記事がコンテキストに入り込む Post-Tool(ツール実行後) フックです。
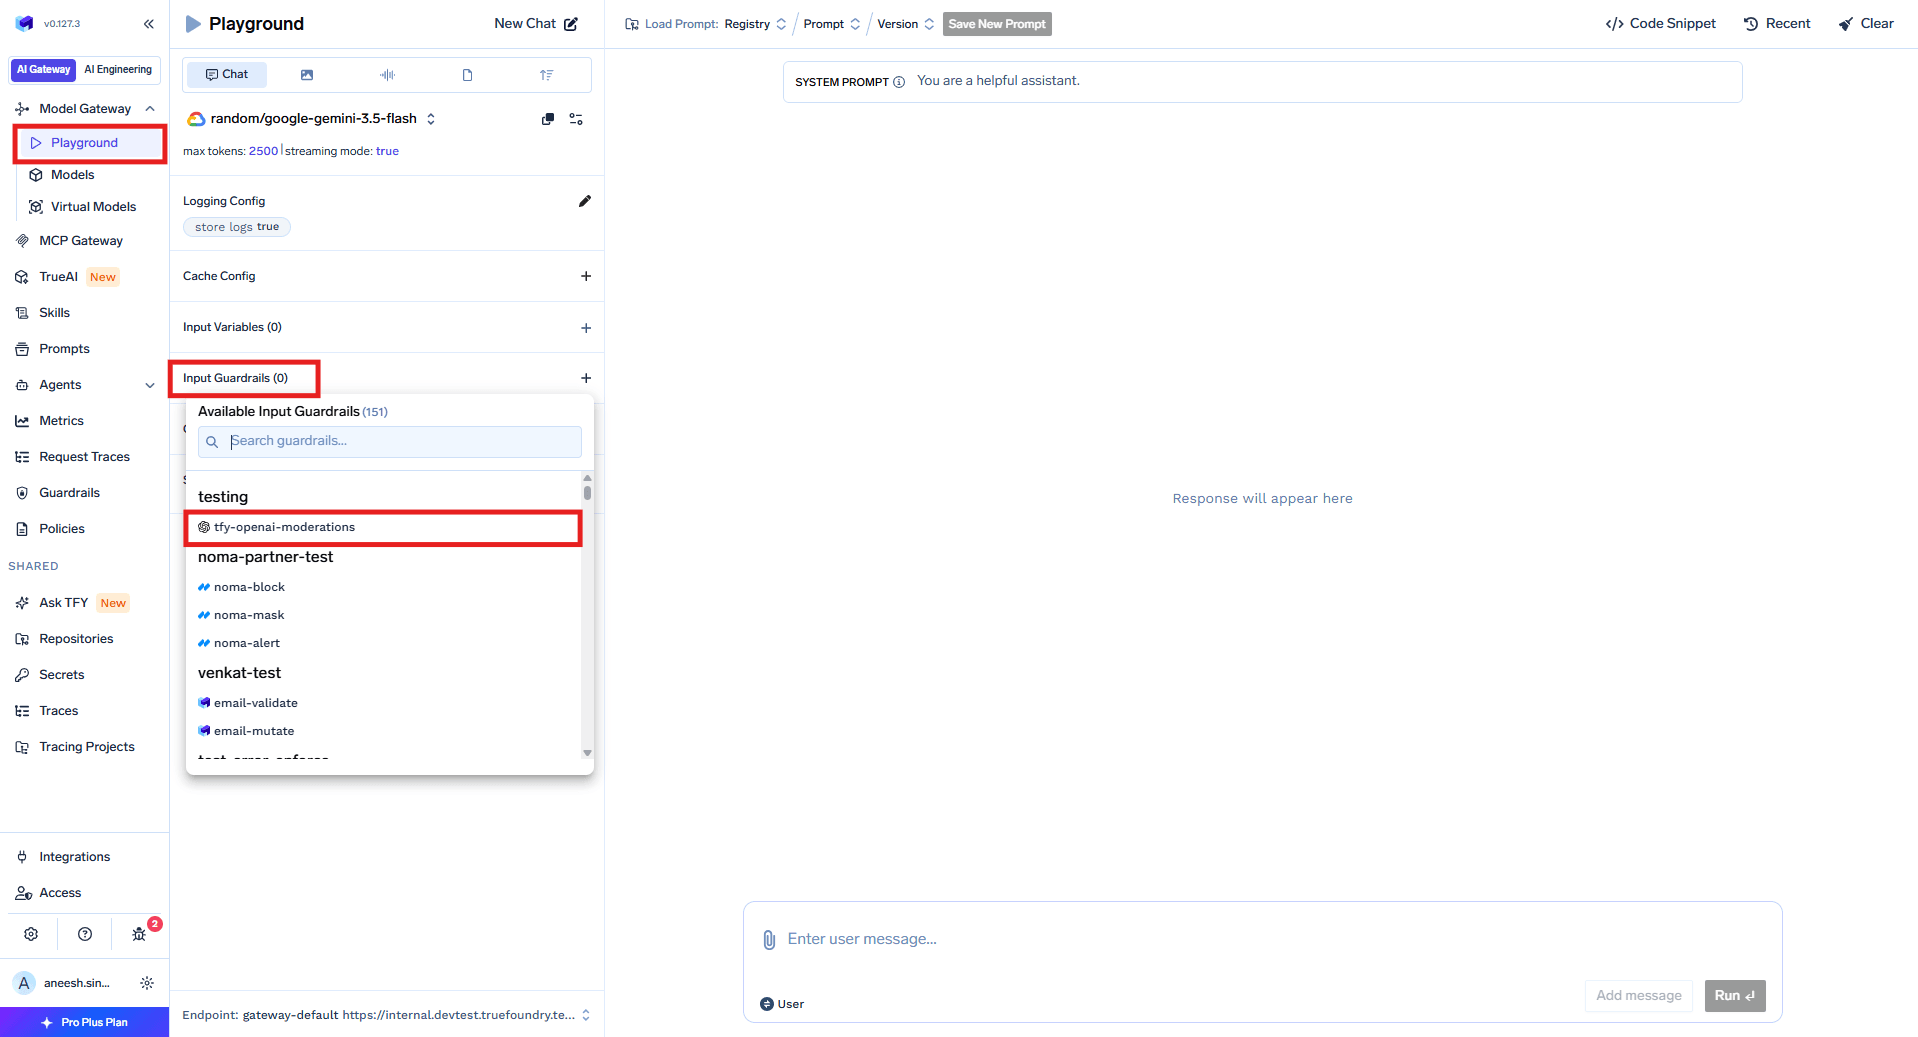
最初に Playground でテストする。 4 つのフックすべてが AI Gateway → Playground でテスト可能です。Code ボタンをクリックすると、X-TFY-GUARDRAILS があらかじめ設定されたコードスニペットが生成されます。
対象エージェントのモデルおよび MCP サーバーに限定したポリシーを Audit モードでアタッチし、1 週間運用します。正当なサポートチケットの 8% で誤検知してしまう検出器は、まだ強制モードに移行すべきではありません。問題がないことを確認したら、Enforce But Ignore On Error に昇格させ、Hide advanced fields トグル内から {{guardrail_message}} や {{failed_guardrails}} をサポートするカスタムエラーメッセージを設定します。
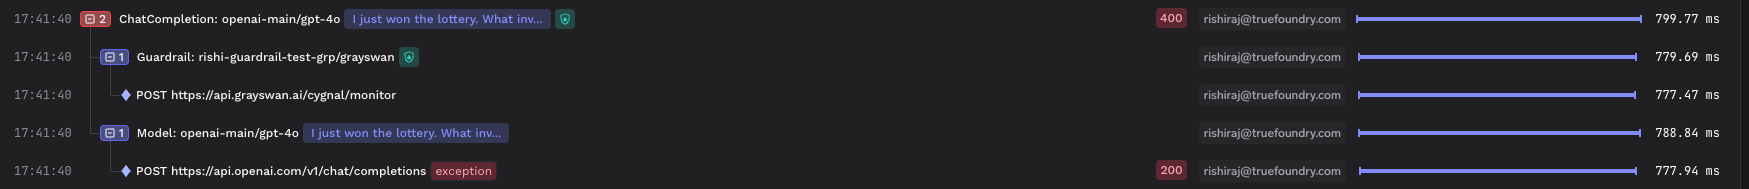
トレースで検証する。 各ガードレールは Monitor → Request Traces 内で個別のスパン(Span)として表示され、実行時間、結果、スコープ、変異内容が記録されます。ブロックが発生した場合、HTTP 400 と error.type = "guardrail_checks_failed" が返されます。

スポンジ攻撃によるループの脆弱性を別のレイヤーで解決する。 12 回におよぶツールループの問題は、レート制限および予算設定によって解決すべき課題です。各イテレーション自体が正当な形式である場合、ガードレールだけでループを阻止することはできません。
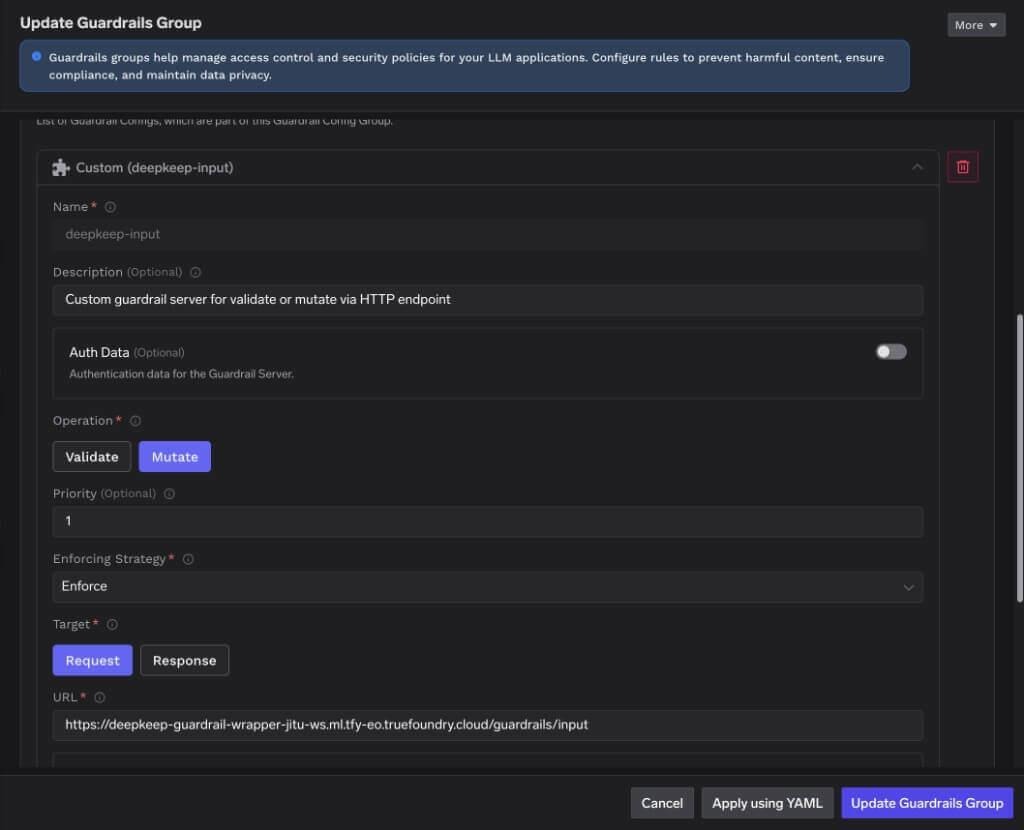
ルール(Rail)の順序によっては、ブロック判定が許可(Allow)に変化してしまうことがある。 DeepKeep は、検知されたルールのうち最も深刻なアクションではなく、リスト内で最も上に配置されたルールを優先して適用します。PII Detector を Adversarial Prompt Defense より前に配置した場合、PII を同時に含んでいるジェイルブレイク攻撃は、ブロックされずに伏字化された上で通過してしまいます。上部に配置された伏字化処理が優先され、ジェイルブレイク文字列は電話番号が伏字になった状態でそのままモデルへ送信されます。ドキュメント化されている回避策は、推奨される順序(Credentials Leakage → PII → Adversarial → Toxic)を守ることです。さらに良い方法は、2つのファイアウォール構造に分割し、Adversarial Prompt Defense は Pre(前処理)ファイアウォールのみに配置し、認証情報や PII は Post(後処理)側に配置することです。
ストリーミングレスポンスでは出力ガードレールがスキップされる。 stream: true が指定されている場合、レスポンス全体の評価には完了したテキストが必要となるため、出力ガードレールは一切実行されません。入力ガードレールは常に実行されます。ほぼすべてのチャットインターフェースがデフォルトでストリーミングを採用しているため、ユーザーから見過されがちなセキュリティ上のリスクとなります。
システムプロンプトは検査されません。 Gateway はガードレールにコンテンツを送信する前にシステムプロンプトを除外します(CrowdStrike AIDR はドキュメント上唯一の例外ですが、システムプロンプトを修正することはありません)。「プロンプト全体をスキャンしている」という前提で運用を行わないよう注意してください。
独自の検出器を構築する場合は 2xx を返してください。 カスタムガードレールの仕様において明確に定められています。HTTP 2xx は「ガードレールの実行が正常完了した」ことを意味し、ブロックの有無はボディ内の verdict: false で示します。ブロックを示すために 400 を返してしまうのは典型的な実装エラーであり、Gateway がそれをエラーとみなしてリクエストをそのまま通過させてしまう可能性があります。
これら 2 つのアプローチは補完関係にあります。キャンペーンは脆弱性を「発見」します。エピソード的で高コストですが、検出器がまだ存在しない未知の失敗分類を発見できる唯一の手法です。ランタイム強制は状態を「維持」します。継続的でリクエストあたりのコストが低く、誰も定義していない攻撃に対しては効果がありません。前者しか導入していないプログラムはレポートを作成するだけで終わり、後者しか導入していないプログラムは誤った安全性への過信を生むことになります。
TrueFoundryは明確に後半の位置付けであり、それを曖昧にするのではなく堂々と言明します。このゲートウェイにより、すべてのモデル、チーム、MCPツール呼び出しにわたって検出結果を適用する単一の場所が提供されます。機能が停止するのは攻撃の生成部分です。ベンダーが自社のファイアウォールによりレッドチーミングは不要であると主張する場合は、その検出器がどの攻撃クラスで、いつトレーニングされたのかを尋ねてみてください。その上でキャンペーンを敢行し、そこで発見された内容を適用するのです。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




AIシステム(モデル、プロンプト、取得したコンテキスト、ツールの全体)に対する敵対的テストで、システムを意図に反して動作させる入力を見つけるために行います。分類としては、ジェイルブレイク、直接的・間接的なプロンプトインジェクション、データの持ち出し、ツールの悪用、リソースを枯渇させる「スポンジ」攻撃があります。ペネトレーションテストと異なるのは、攻撃対象領域が自然言語であること、結果が確率的であること、そしてモデルのアップグレードによって一度塞いだ分類が再び開く可能性があることです。
いいえ。LLMファイアウォールはランタイムでの強制であり、インラインのガードレールがすべてのリクエストを検査、書き換え、またはブロックします。レッドチーミングはオフラインでの発見であり、攻撃を生成して何が通用したかを報告するキャンペーンです。キャンペーンは何を強制すべきかを教え、強制はその発見による損失を止めます。
キャンペーンという意味では行いません。提供しているのはランタイムでの強制の側です。4つのフックでのガードレール、10種類のネイティブ組み込みガードレール、約20のパートナー連携、モデル、MCPサーバー、ツール、ユーザー、チーム、仮想アカウント単位でのポリシーの紐付け、ガードレールごとのメトリクスがあります。攻撃の生成、敵対的コーパス、スケジュールされたスキャン、レッドチームのレポートについては文書化されていません。パートナーの中には、キャンペーン側の機能を独自に備えたセキュリティベンダーも複数あります。
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、多数のプロバイダーにまたがってルーティングする場合でも、プロンプトとレスポンスがお客様のドメインの外に出ることはありません。
はい。MCP Gateway、Agent Gateway、そしてツール単位のアクセス制御を備えたMCP & Agents Registryが含まれています。LangGraph、CrewAI、AutoGen、または独自のフレームワークで構築されたエージェントを、すべて一元的に統制できます。
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheus、またはお好みのスタックに接続できます。プロンプトからツール、モデルの実行まで、すべてのリクエストを追跡するため、既存のシステムを大幅に変更することなく、統合されたロギングを実現できます。






















