



November 10, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
従来のAPIレート制限は、リクエストが代替可能(同等)であることを前提としていました。GET /users/42 のコストは次のリクエストとほぼ同じであるため、リクエスト数のカウントは負荷の優れた代理指標となります。これまでに設定したすべてのレートリミッターはこの前提の上に構築されています。
LLMのトラフィックはこの前提を打ち破ります。同じエンドポイント、同じ時間帯(分)、同じユーザーであっても、「これを1行で要約して」というリクエストは往復で約50トークンですが、推論モデルに送信された150ページの契約書は200,000トークン近くになります。どちらも1つのリクエストであり、1分あたり1,000リクエストという制限は双方を許可してしまいます。
エージェントが関与すると、このばらつきがプロダクションのトラフィックにおける通常のパターンとなります。エージェントの1ターンごとに会話全体、ツールの実行結果、取得したコンテキストが毎回プロンプトに引き継がれるためです。リクエスト数は一定のままでもトークン数は桁違いに増加します。これがCI/CDにおけるエージェント的トークン爆発のメカニズムです。
したがって、単位を変更する必要があります。トークンは購入対象そのものであるため、トークン数をカウントしてください。 リクエスト数もゲートウェイやプロバイダー接続を保護するために引き続き重要であるため、両方を実行・運用してください。
ここでの混乱の多くは用語の解釈に起因します。4つの問題、4つのメカニズムが存在しますが、チームは1つの機能を導入しながら別の機能を導入したと思い込んでいることがよくあります:
レート制限は可用性の制御であり、予算は財務の制御です。 これらは失敗のモードが異なり、所有者も異なります。プラットフォームチームが前者を所有し、財務チームが後者を所有します。
よくある誤りは、トークンレート制限を設定してそれをコスト制御と呼ぶことです。安価なモデルでの1分あたり20,000トークンは1日あたり数ドルですが、最先端の推論モデルではまったく異なる金額になり、プロバイダーが価格改定を行うたびに変動します。トークンスループットはお金そのものではありません。
プロバイダーの制限には注意が必要です。チームは意図せずそれに依存してしまいがちだからです。OpenAIやAnthropicの組織制限は1つの共有プールです。バッチジョブがそれを飽和させると、顧客向け製品が「アシスタントを常に優先する」といった表現ができないシステムによってスロットリングされてしまいます。だからこそ、自社で制御できるゲートウェイが必要になります。
アルゴリズムによって通過できるバーストの量が決まります。これはエージェントにとって決して小さな詳細ではありません。
アルゴリズム カウント方法とバーストの挙動 固定ウィンドウ クロック間隔ごとに1つのカウンターを設定し、境界でリセット。最悪の場合、制限の2倍を許可(11:59:59に全クォータを消費し、12:00:00に再度消費) スライディングウィンドウ ローリング期間にわたってサブバケットを合算するため、境界でのスパイクはサブバケットサイズに限定される トークンバケット 設定されたレートでトークンが補充され、リクエストごとに消費。補充レートにスロットリングされる前に、バケットの深さまでのバーストを許可
人間のチャットトラフィックの場合、固定ウィンドウで十分です。人間は同期して行動しないためです。一方、エージェントは偶発的に同期します。失敗時の再試行、並列展開、スケジュール実行を行うため、多くの呼び出し元が同一の時刻に集中し、2倍消費のケースが理論上の話ではなくなります。スライディングウィンドウはリセットの瞬間を持たないことでこの問題を解決します。トークンバケットは別の課題に対応するもので、短時間のバーストを許可したいトラフィックに適していますが、調整すべきパラメータが増えるというトレードオフがあります。
ダウングレードは最も活用されていない手法です。モデルレベルの制限に達した場合、フォールバックチェーンにより、ユーザーに429を返すのではなく2番目のプロバイダーからレスポンスを返すことができます。これはLLMルーターに関する記事で取り上げたフェイルオーバーメカニズムであり、429はトリガーとなるステータスコードです。一方、予算の超過は異なります。お金がなくなればそれまでであり、気づかれないようにより安価な場所で密かに消費することは、財務チームが求めていることではありません。
特定のルールよりも一般的なルールを上に配置してしまう。 最初の一致が優先される(ファーストマッチ)適用ルールでは、上部にある広範なルールが、下部にあるより狭いルールに一致すべきトラフィックを飲み込んでしまいます。結果として狭いルールが起動することはありません。
1つの共有カウンターをユーザーごとの制限として扱ってしまう。 スコープを設定せずに「1分あたり20,000トークン」とすると、全員で1つのカウンターになります。最初の呼び出し元がそれを使い果たしてしまいます。
失敗したリクエストは無料であると思い込む。 リクエストベースの制限では無料ではありません。そしてトークン制限においては動作が異なります。
TrueFoundryでは意図的に分離された2つのポリシーオブジェクトを提供しています。レート制限はスループットを統制し、予算はお金を統制します。
レート制限ルールは、完全なセットとして6つの単位を受け入れます:
requests_per_minute · requests_per_hour · requests_per_day · tokens_per_minute · tokens_per_hour · tokens_per_day
秒単位の指定は存在しません。単一のLLMリクエストが数万秒かかる場合もあるため、秒単位の制限はノイズを測定することになってしまうからです。設定は Config タブで行います:
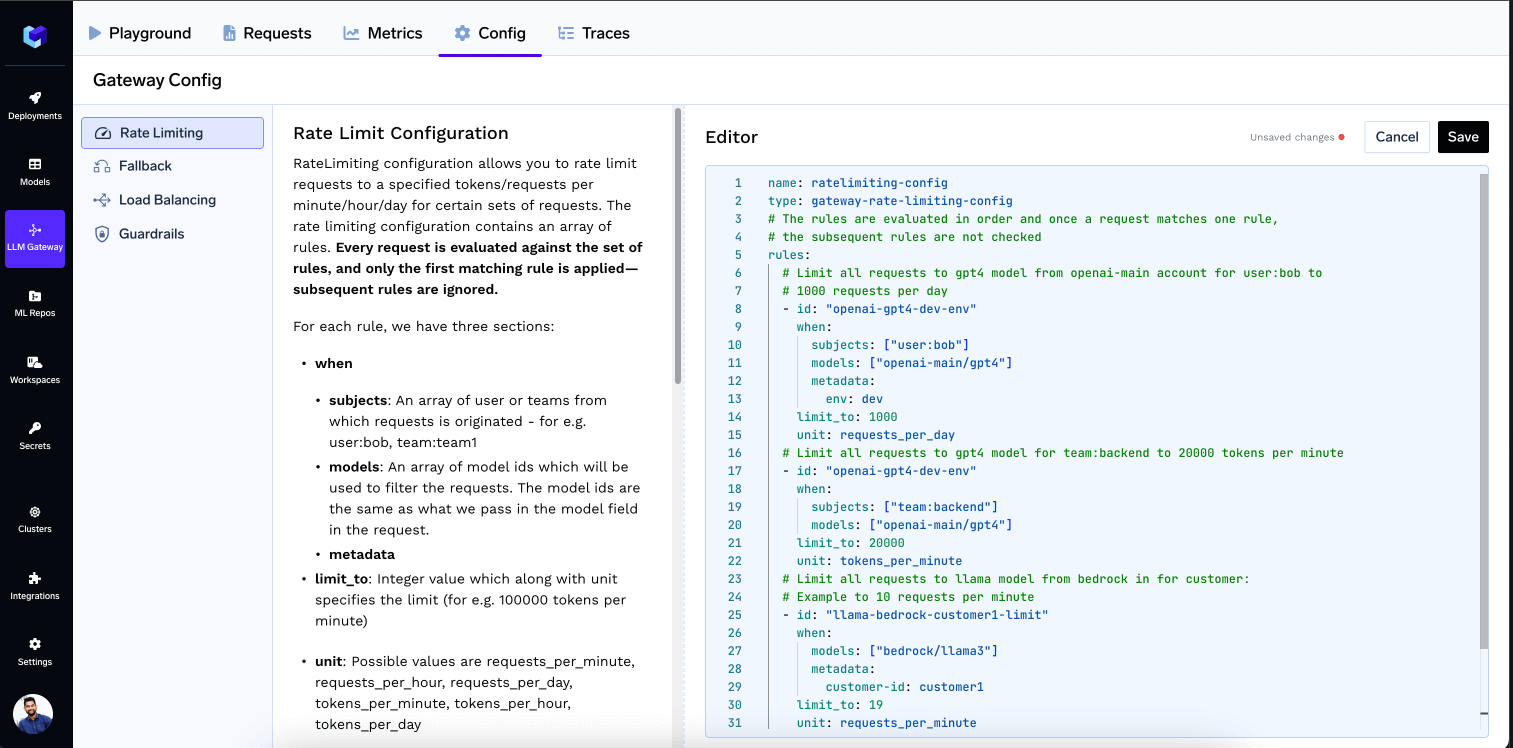
ルールセットは type: gateway-rate-limiting-config であり、ルールのリストを持ちます。各ルールには静的な id、subjects、models、metadata の条件が AND で結合された when ブロック、整数値の limit_to、単位、およびオプションの rate_limit_applies_per が含まれます。subjects には user:、team:、virtualaccount: などのプレフィックスが付き、metadata は X-TFY-METADATA ヘッダーを読み取ります。
最小単位が分単位であるため、ゲートウェイは 60秒のウィンドウを維持し、ユーザー、モデル、チーム、またはカスタムセグメントごとに 10秒ごとの時間ベースバケットを保持し、直近の6つのバケットを合算してカウンターを評価します。古いバケットは除外されます。頭に入れておくべき数値は10秒の解像度です。バーストは1回のリセット境界で2倍許可されるのではなく、6つのサブインターバルにわたって平滑化されます。
これが設定されていない場合、ルールは一致するすべてに対して 1つの共有カウンターとなります。設定されている場合、カウンターはエンティティごとに分割されます。許容される値は user、virtualaccount、model、および独自のキーを持つ metadata.* です。1つのルールにつき最大2つの値を設定できます。
['user'] はすべてのユーザーに個別の許容量を与え、['model'] はすべてのモデルに個別の許容量を与えます。最後のルールは、多くのチームが最終的に必要とするパターンです。アプリケーションが送信済みのメタデータキーに基づくプロジェクトごとの上限であり、新しいプロジェクトが登場してもルールを編集する必要がありません。
これは動的なルールIDフォーマットを置き換えたものです。移行は機械的です。{user}-daily-limit は id: 'user-daily-limit' と ['user'] に変更され、project-{metadata.project_id}-limit は id: 'project-limit' と ['metadata.project_id'] に変更されます:
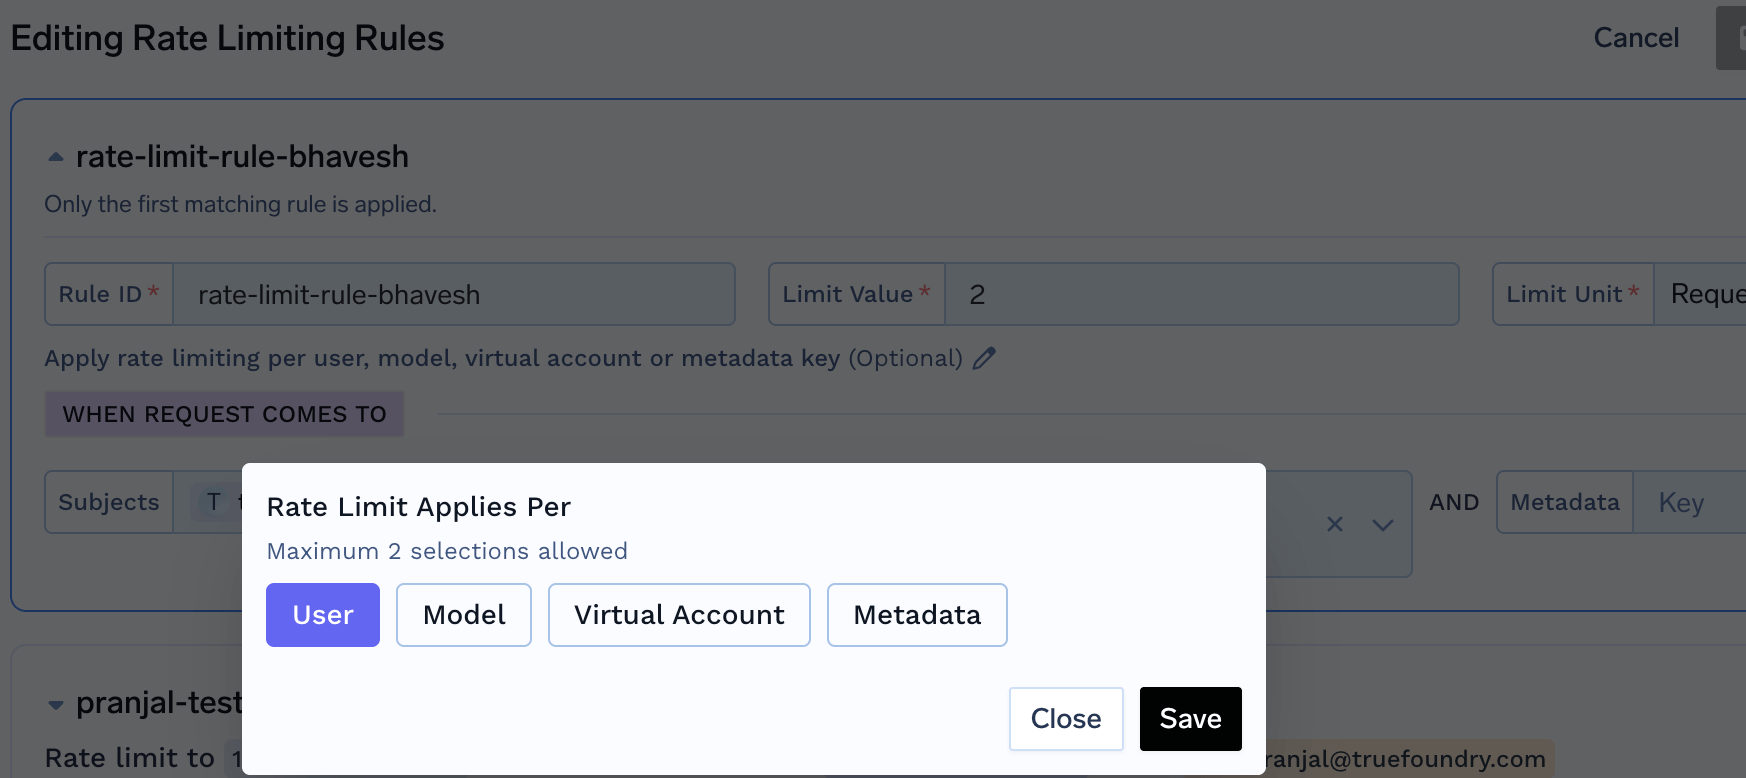
すべてのリクエストはすべてのルールに対して評価されますが、強制適用されるのは最初に一致したルールのみです。 それ以降の一致によってブロックされることはありません。ただし、使用量はリクエストが一致するすべてのルールに対してカウントされます。
そのため、専門的なルールは上部に配置してください。ドキュメントに記載されている失敗例として、app-a-limit(10,000 rpm、virtualaccount:app-a)を tenant-wide-limit(5,000 rpm、when: {})より上に配置すると、アプリAのトラフィックは両方でカウントされ、テナントカウンターだけを飽和させてしまいます。その結果、テナントルールが最初に一致する全員が、5,000 rpmを大幅に下回る段階で429エラーを受け取ることになります。解決策は順序変更ではなくスコープの適用です:rate_limit_applies_per: ['user', 'virtualaccount']。
ゲートウェイによって拒否されたリクエスト、またはプロバイダーが 4XX/5XX で失敗したリクエストは、一致したすべての requests_per_* ルールに対して 1リクエストとしてカウントされます。1つの例外として、レート制限自体によってすでに 429 で拒否されたリクエストは除外され、再試行ストームによって自ら溝を深めることがないようになっています。
トークン制限の挙動は異なります。失敗したリクエストはトークンクォータを消費しません。失敗したリクエストはトークン数を報告しないためです。 カウントすべき対象が存在しません。これが、トークンダッシュボードが正常に見える一方で、リトライループによってリクエスト予算が使い果たされる理由です。
違反が発生すると、HTTP 429 と error.type: "RateLimitError"、error_origin_level: "rate_limit_budget" が返され、起動したルール名を示す x-tfy-applied-rules ヘッダーが付与されます。
予算はお金を制御する機能であり、コスト専用(USD単位の cost_per_*)です。トークン単位の予算は存在しません。トークンの上限を設定したい場合は、レート制限を使用します。
予算 V2 は v0.158.0 でリリースされ、適用ロジックが逆転しました。一致するすべてのルールがチェックされ、すべてがリクエストを許可する必要がある(予算間での AND 条件)ようになりました。レート制限は最初の一致が優先(ファーストマッチ)されますが、予算はすべて通過が必須(オールパスマッチ)です。V1 ではファーストマッチを使用していたため、移行は構文ではなくセマンティクス(意味的)の変更となります。
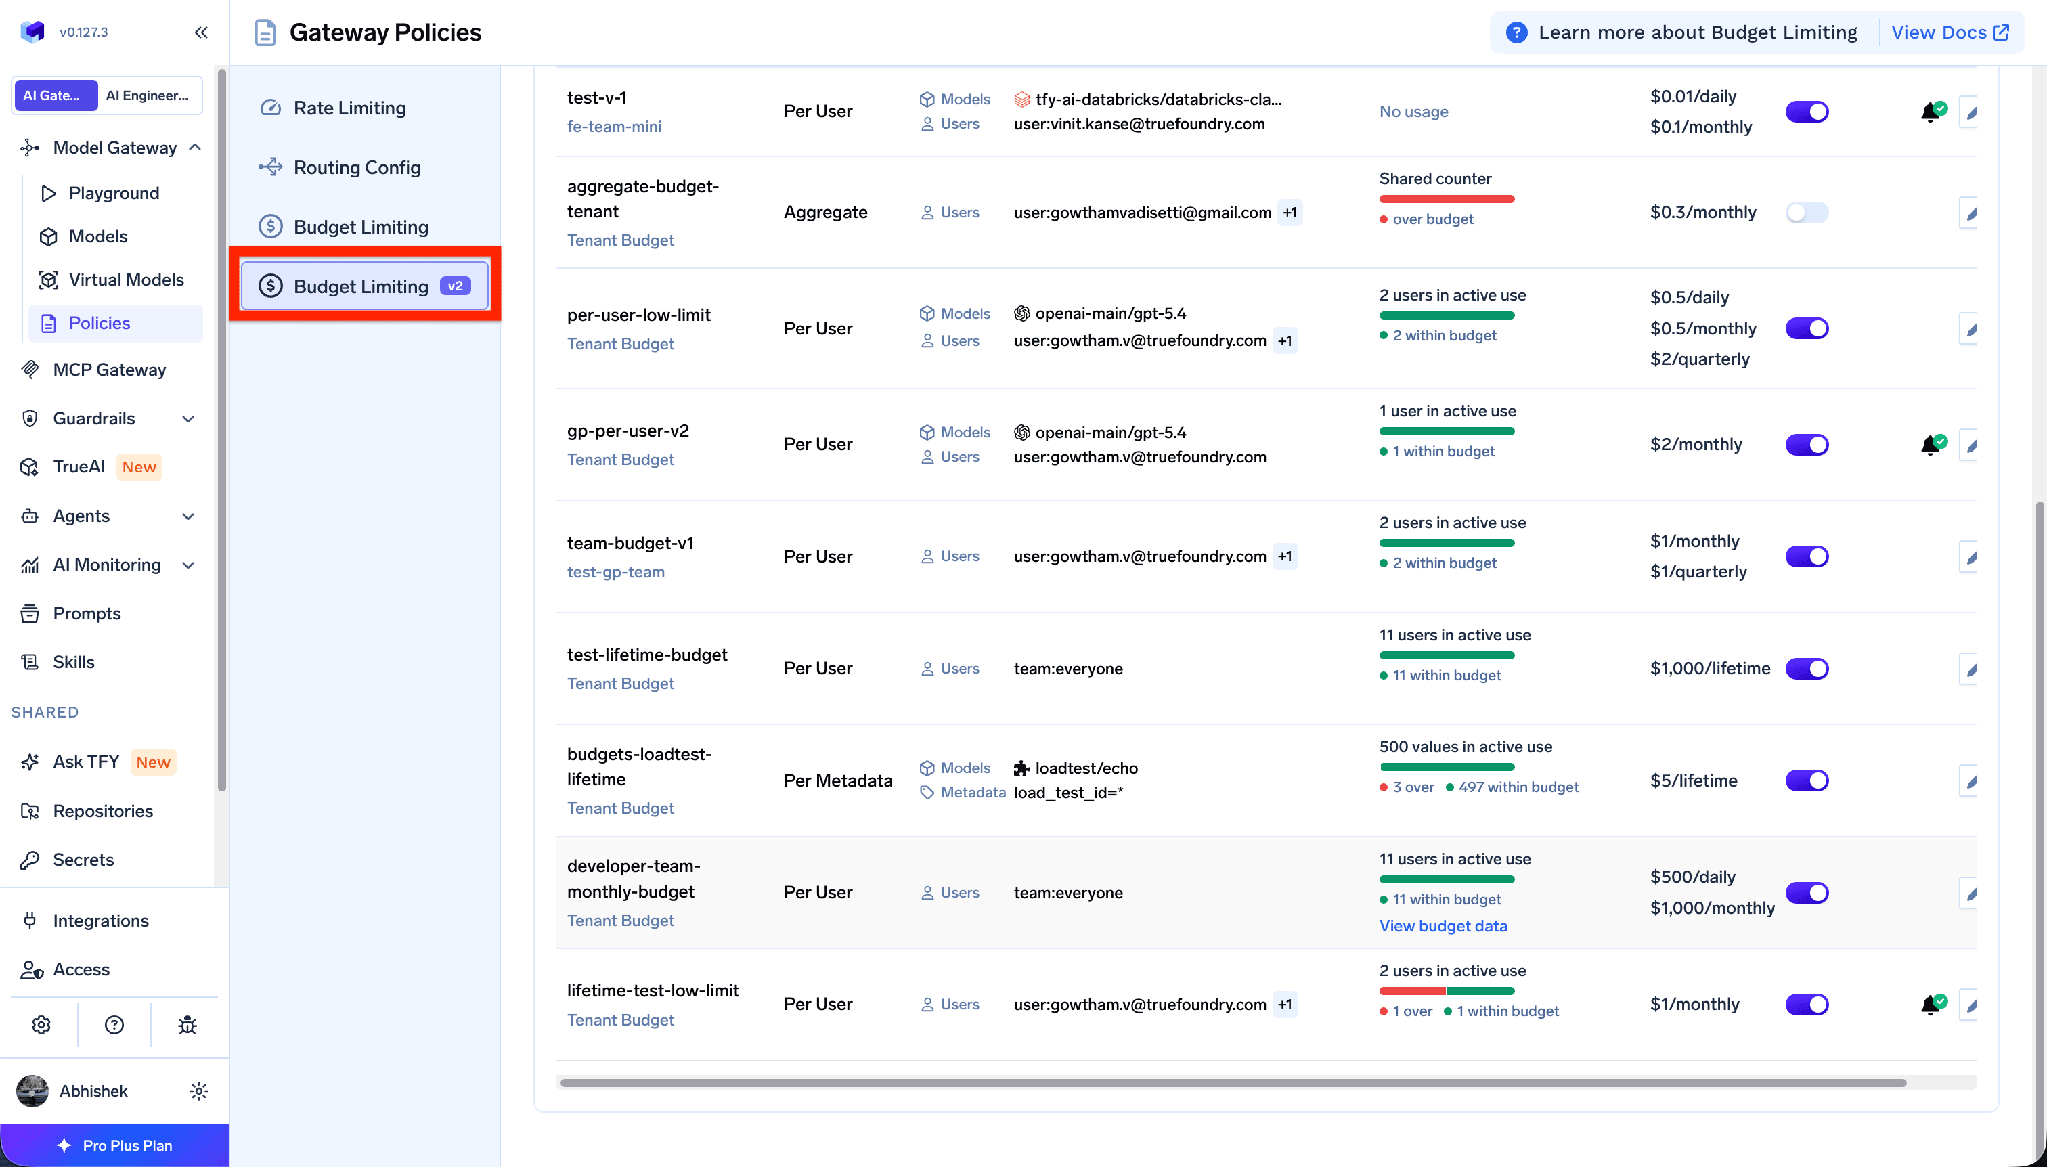
ルールは AI Gateway → Policies → Budget Limiting → Add Rule の下に配置され、テナント(tenant-budget-config)またはチーム(team-budget-config、RBAC強制の team_name を伴う)の2つのスコープが存在します。
5つのリセット期間(すべてUTC):日次(00:00)、週次(月曜 00:00)、月次(1日)、四半期(1月1日、4月1日、7月1日、10月1日)、および無期限(リセットなし)。これは上記の表の支出上限に該当します:
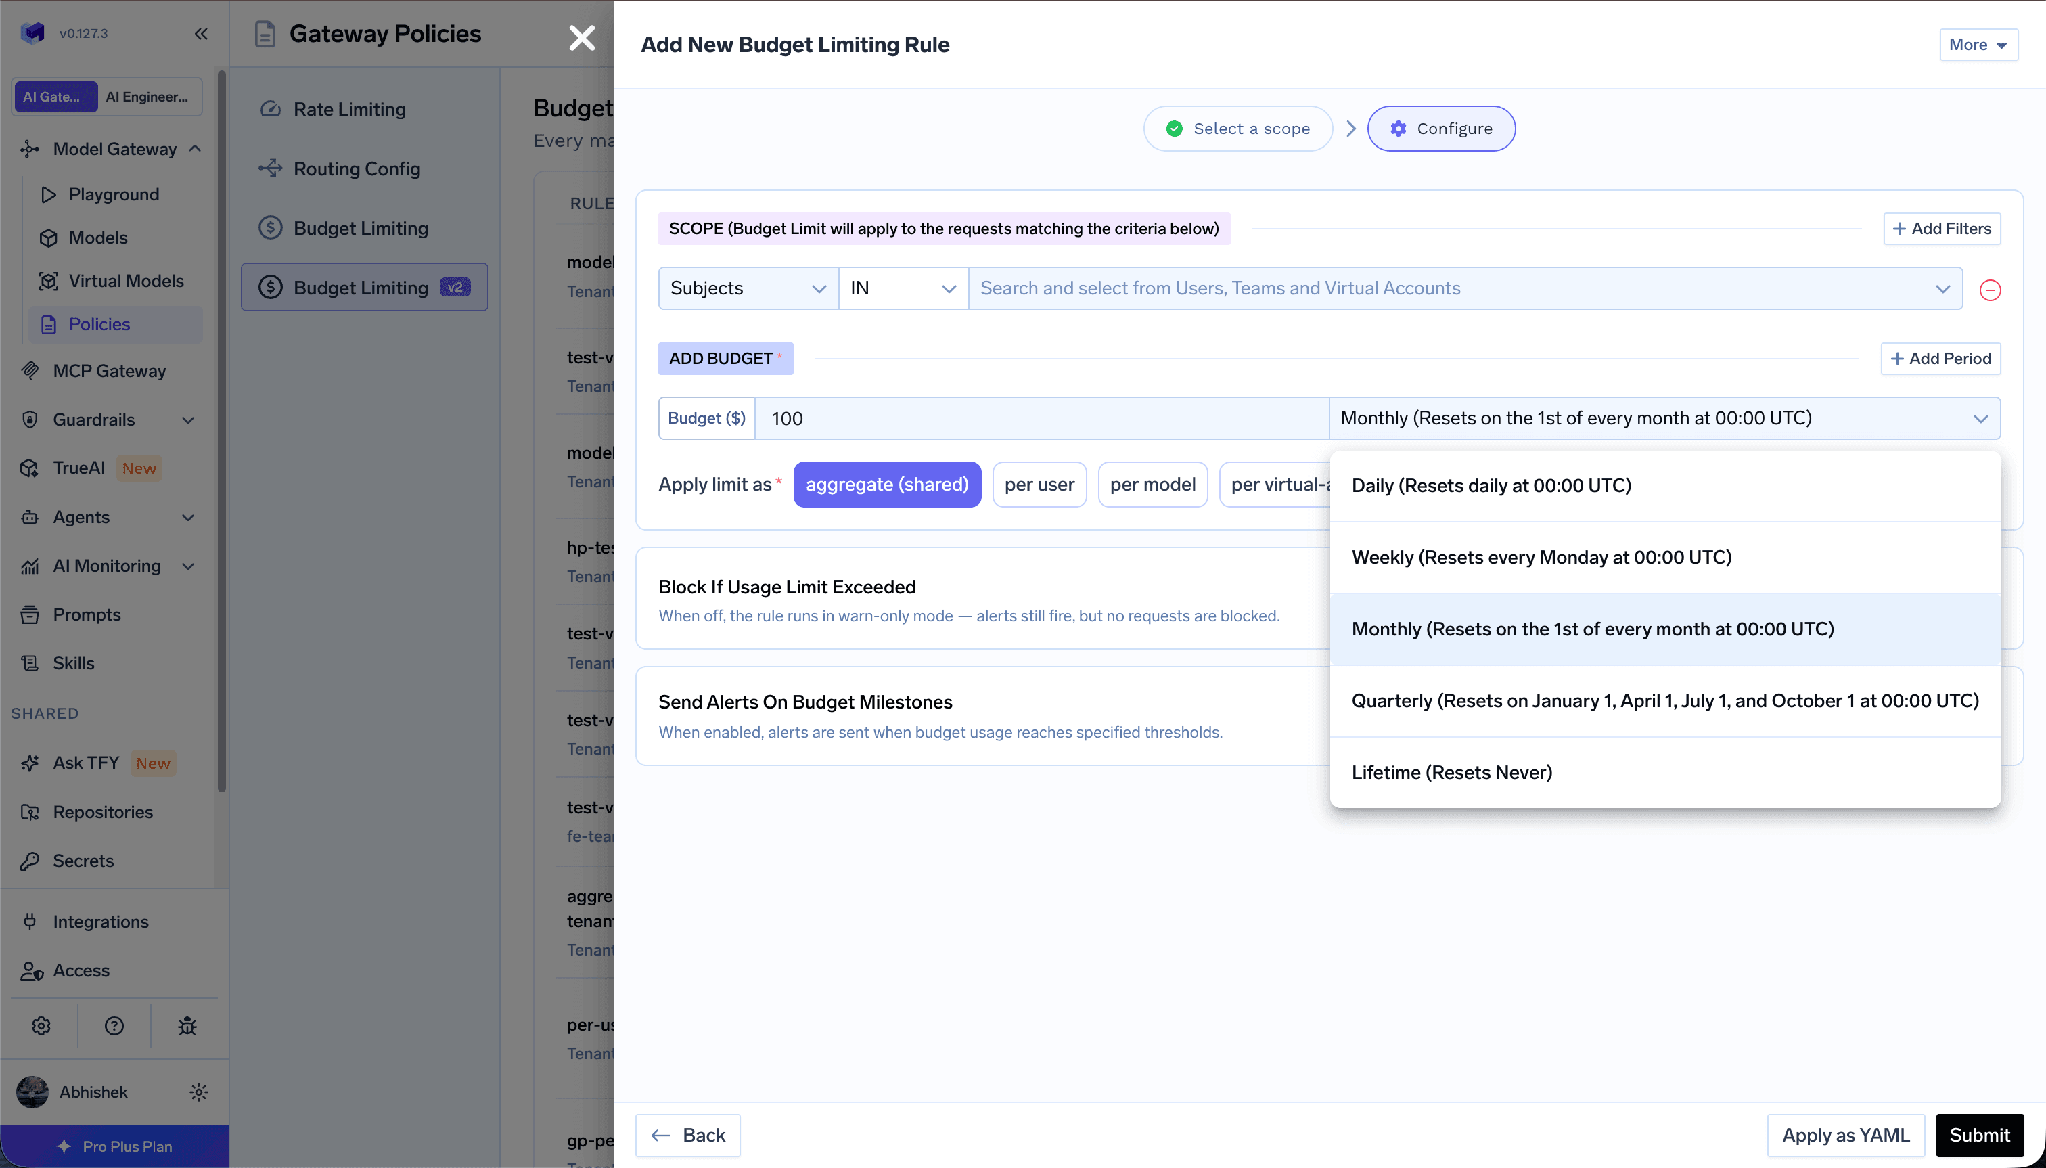
単一のルールで複数の期間を同時に強制適用することができ、いずれか1つでも超えるとブロックされます。ドキュメントのマルチ期間上限の例では、cost_per_day: 0.5、cost_per_month: 0.5、cost_per_quarter: 2 をまとめて設定しています。スコープフィルター(Subjects、Models、Provider accounts、Metadata)は IN/NOT IN を受け取り、AND で結合されます:
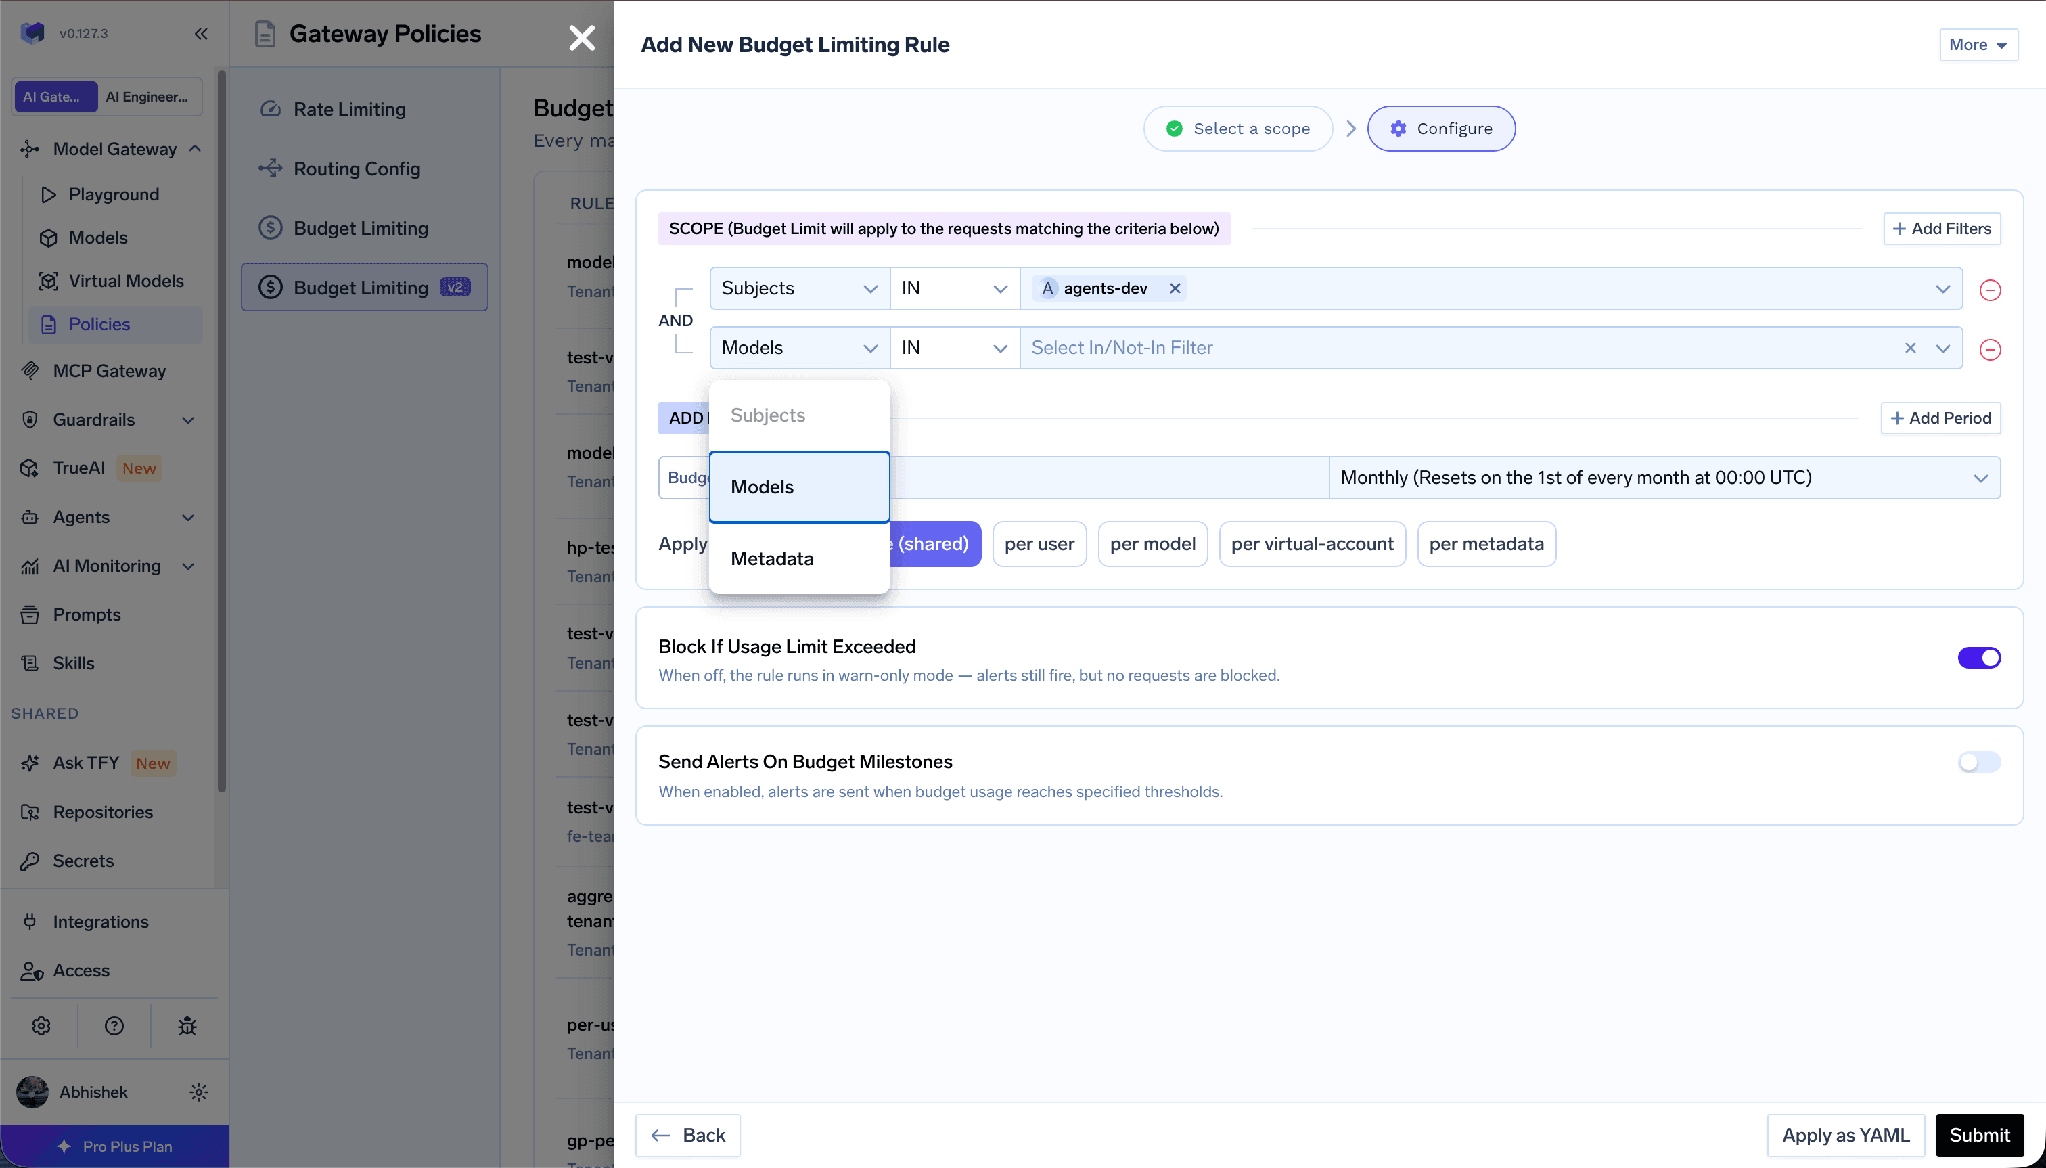
Apply limit as(applies_to.type)は aggregate(全体)、per-user(ユーザーごと)、per-model(モデルごと)、per-virtual-account(バーチャルアカウントごと)、またはキー付きの metadata を受け取り、作成後に変更することはできません。エンティティごとのルールでは、指定したユーザー、モデル、バーチャルアカウント、またはメタデータ値に対するオーバーライドがサポートされています:
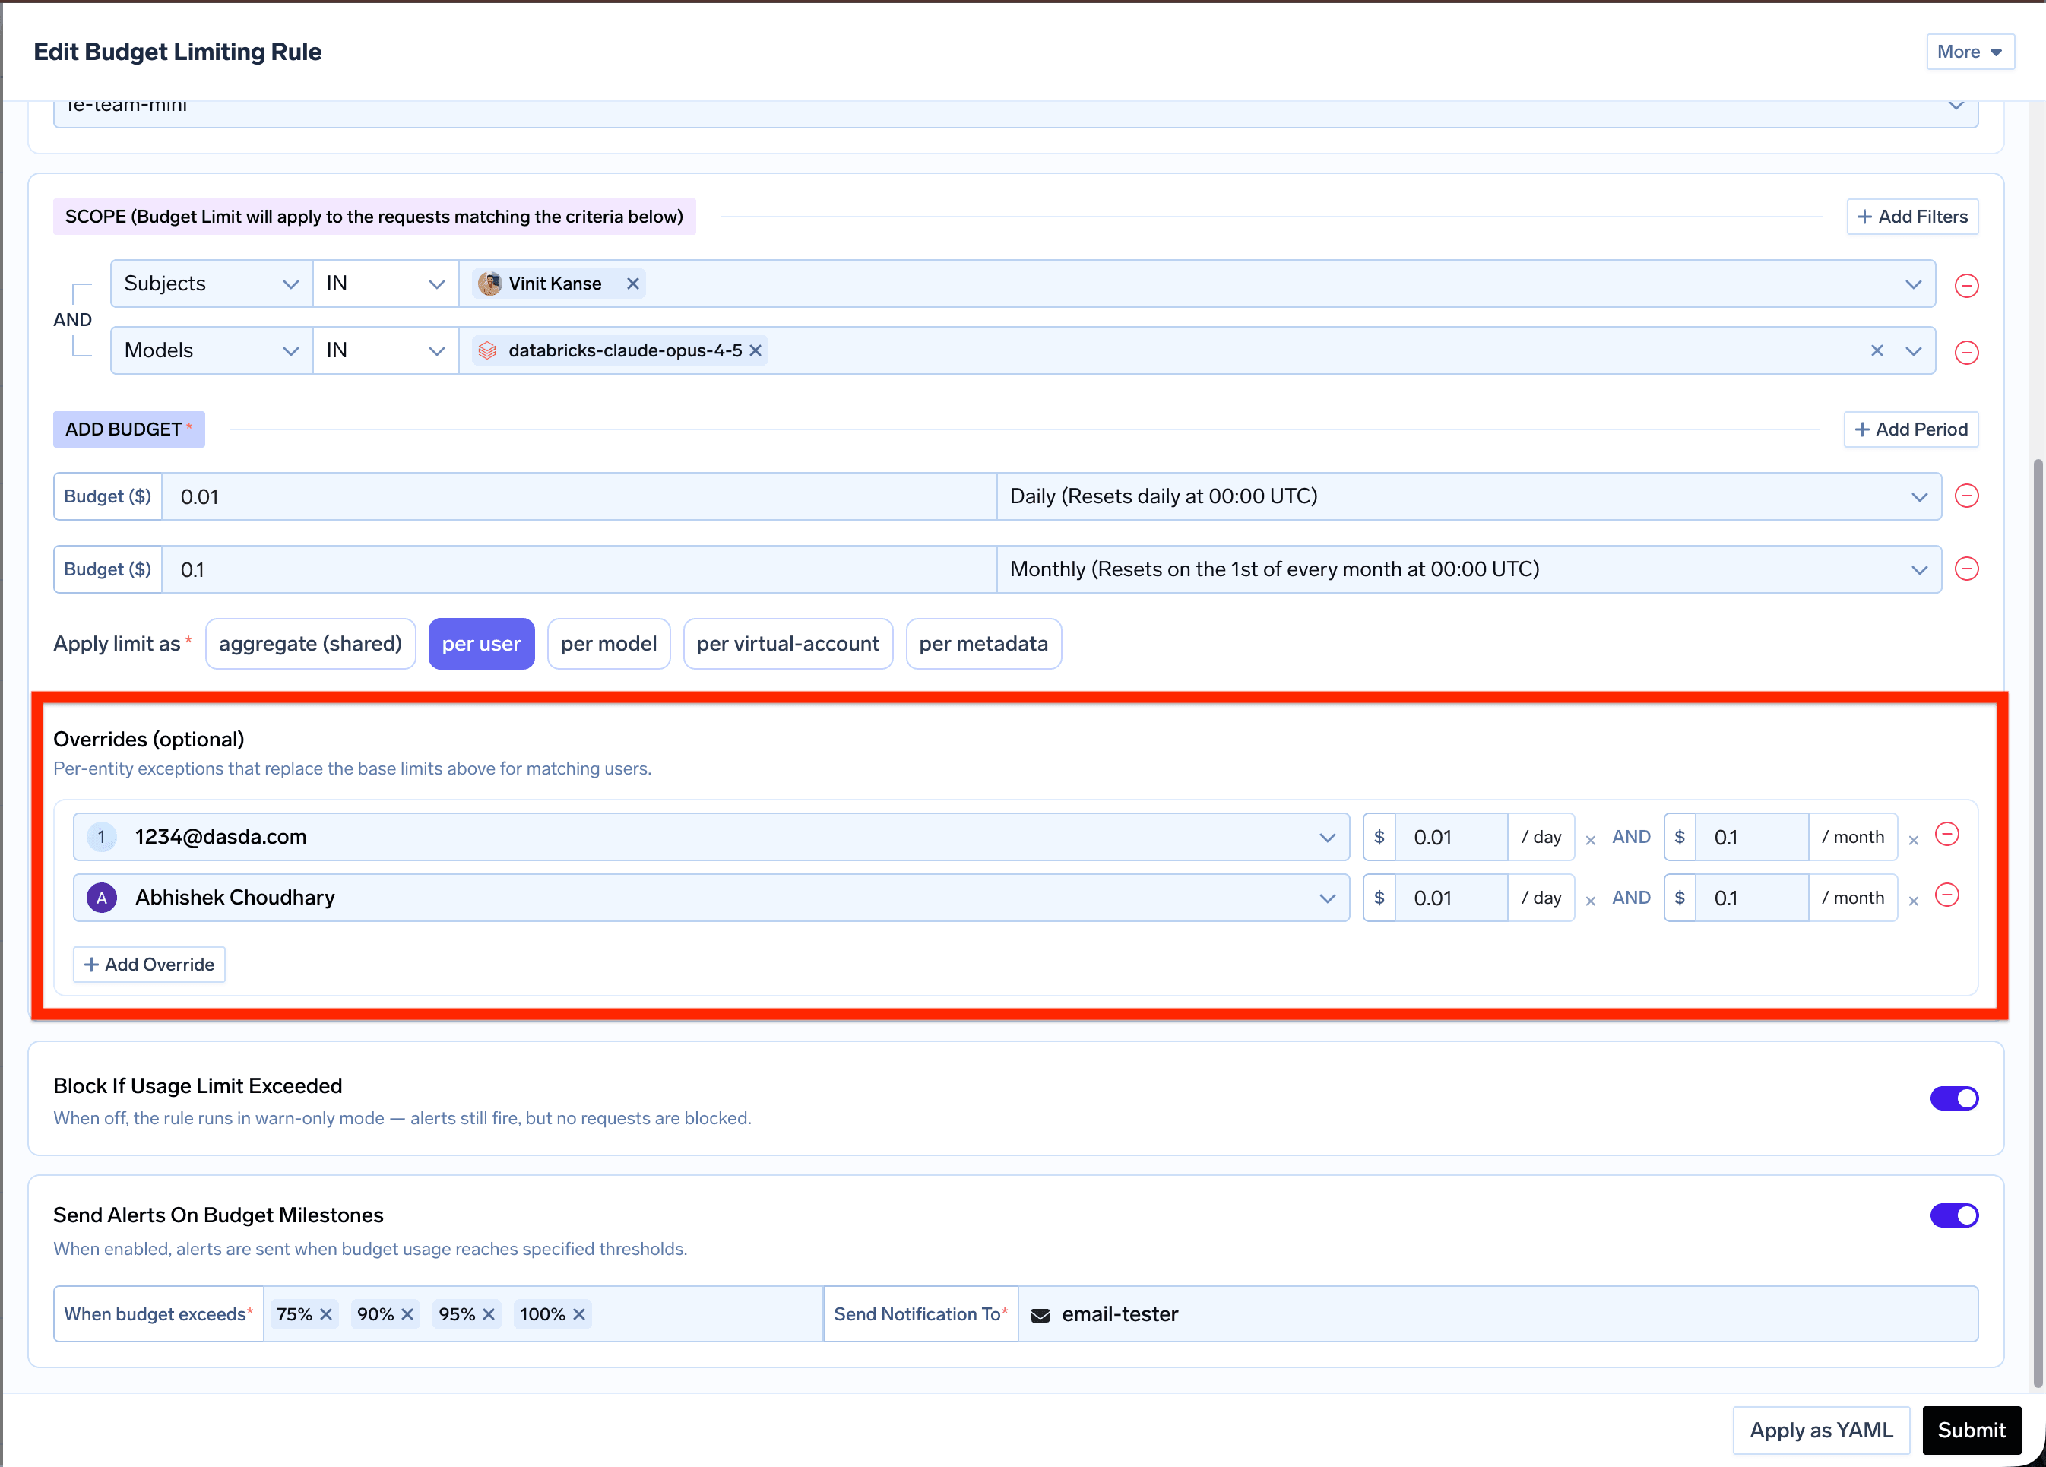
オーバーライドはそのエンティティのすべての期間を置き換えます。 基本ルールが日次と四半期の上限を設定しており、オーバーライドが日次のみを設定している場合、そのエンティティには四半期の上限が一切適用されなくなります。適用したいすべての期間を含めるようにしてください。
3つのモード:enforce(デフォルト、拒否)、audit(通過を許可、追跡とアラートは実施)、 soft_enforce(他の同等な予算がまだ許可できる場合にのみブロック。他に余裕があればリクエストは通過し、違反は監査違反としてログ記録)。どこかでハードな enforce 違反が発生した場合はそれが優先されます。
アラートは75%、90%、95%、100%で発信され、エンティティごとの予算ではエンティティごとに個別に、予算期間ごとに1回発信されます。無期限(Lifetime)予算では、しきい値ごとに生涯で1回アラートが発信されます。送信先ターゲット:email、slack-webhook、slack-bot、pagerduty、ms-teams-webhook。ユーザーごとの配信には {{user.email}} を使用できます。
注意点として、予算カウンターは期間の開始時ではなくルールの作成時から開始されます。 それ以前の支出は遡ってカウントされないため、月の途中で作成されたルールはその期間の請求書と整合性が取れません。
予算機能は背後にある価格設定の正確さに依存するため、その価格設定はオープンになっています。github.com/truefoundry/models のカタログはパブリックコスト追跡に使用される価格設定データベースであり、truefoundry.com/models で閲覧可能です。課金されるレートを確認し、誤りがある場合はPRを送信してください。
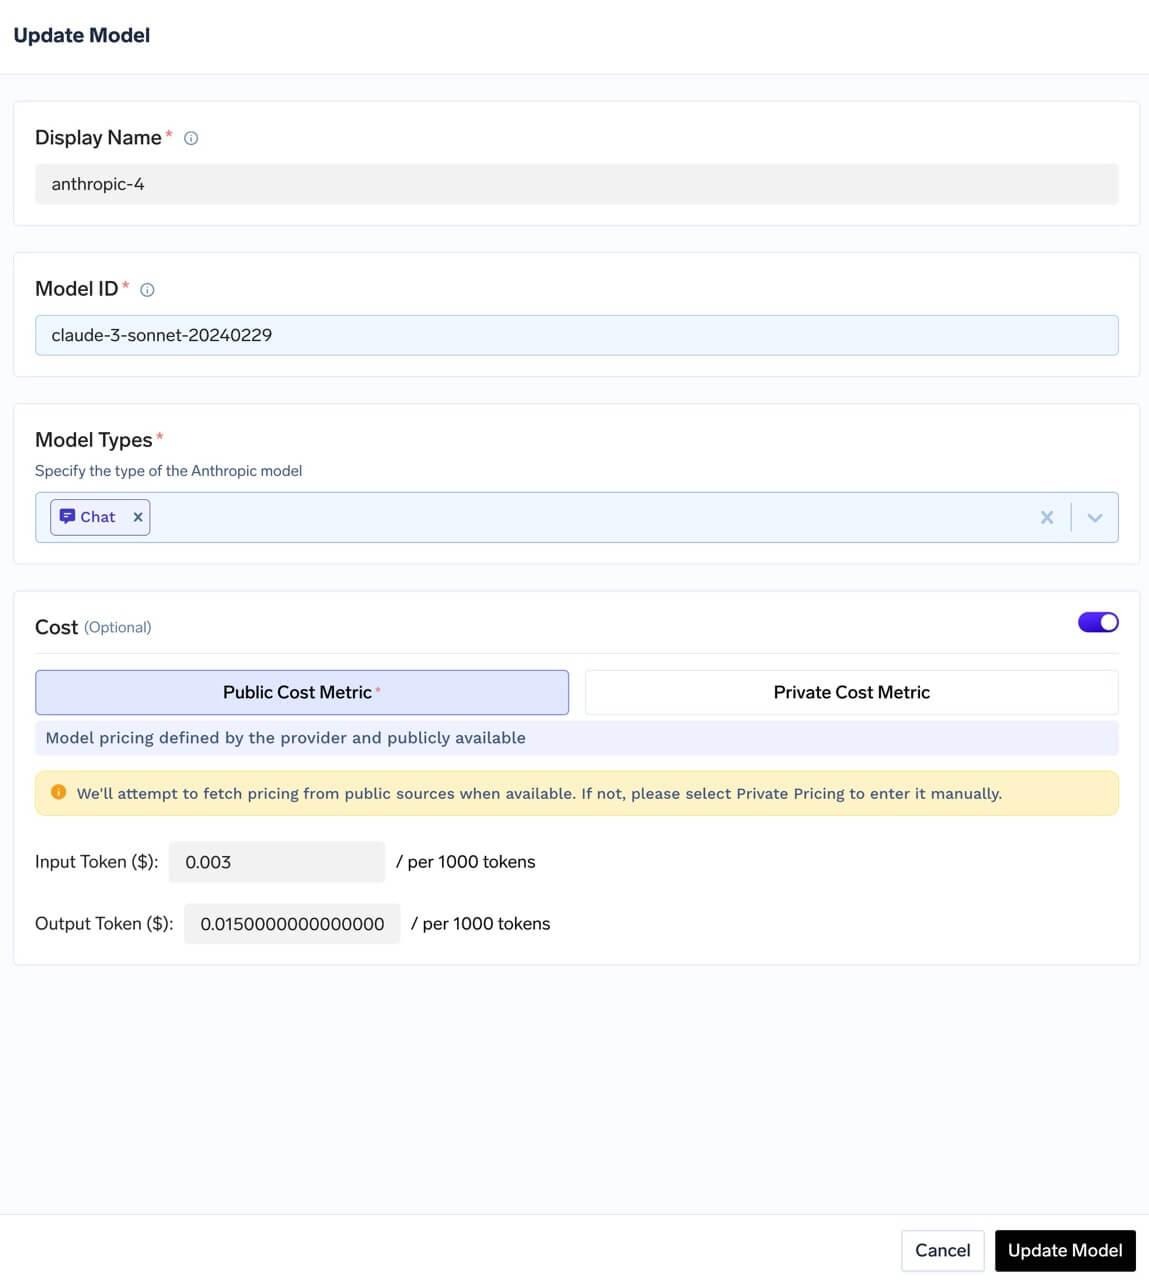
重要な2つの詳細。リージョンごとの価格設定: providers/aws-bedrock/us.amazon.nova-lite-v1:0.yaml には us-west-2、us-west-1、eu-central-1、eu-west-1 ごとに異なる入力・出力レートが保持されているため、マルチリージョントラフィックが一律のレートで誤って評価されることはありません。段階的価格設定: providers/google-gemini/gemini-2.5-pro.yaml にはベースレートに加えて200Kトークンを超える場合のより高いレートがあり、gemini-1.5-flash.yaml には128Kトークンからの段階設定があります。ロングコンテキストは線形には価格設定されません。パブリックな価格設定がないモデルは Private Cost エントリを使用します。
ユーザーごとの予算が正しく機能するのは、リクエストが確実に帰属管理されている場合のみです。開発者の規律に依存するのではなく、以下の3つのメカニズムによって自動化されます:
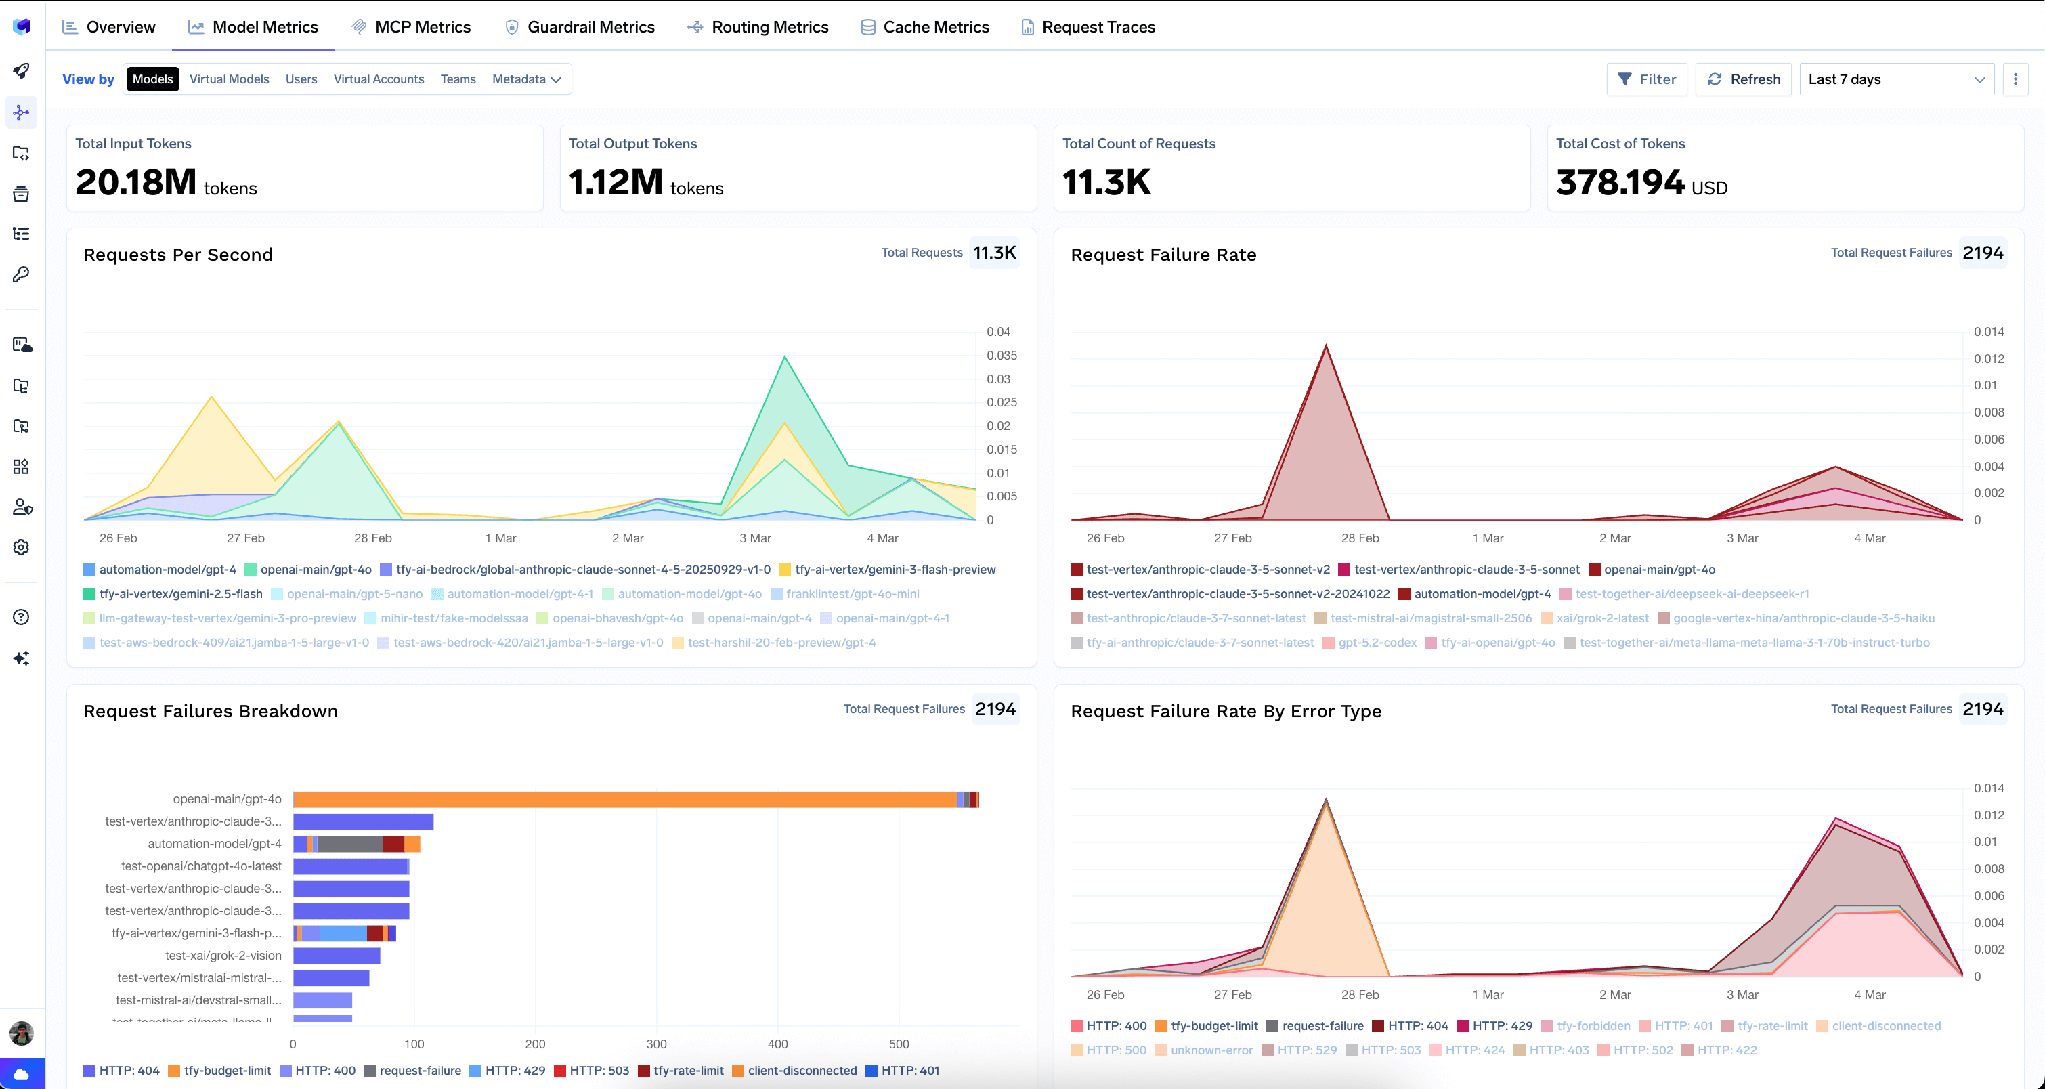
Model Metrics では Total Input Tokens、Total Output Tokens、および USD 単位の Total Cost of Tokens を追跡し、ユーザー名、モデル名、チームごとにグループ化して Metrics → 3 dots → Download Raw Data からエクスポートできます:
1つのゲートウェイ、3つのグループ:顧客向けアシスタント、内部コーディングエージェント、大量抽出を行うデータチームのすべてが1つのプロバイダーアカウント上で運用されています。先月、コーディングエージェントが午後に異常動作を起こし、他の全員が429エラーを受け取りました。
リソース枯渇を防止する。 問題は制限の不足ではなく、カウンターの共有にありました。coding-agent-tpm ルール(200,000 tokens_per_minute、subjects: ["virtualaccount:coding-agent"])を一般的なテナント全体ルール(500,000 tokens_per_minute、when: {})の上に配置し、一般的なルールには rate_limit_applies_per: ['virtualaccount'] を付与して、エージェントが両方に一致することで全員の許容量を使い果たすのを防ぎます。同じサブジェクトに requests_per_minute ルールも追加します。失敗したリクエストはそちらにカウントされますが、トークンルールにはカウントされません。
金額の上限を追加する。 コーディングエージェントにエンジニア1名のオーバーライドを伴うユーザーごとの月次予算を設定し、さらに抽出プロジェクトに無期限(Lifetime)の上限を設定します:
両方は一致するすべてのリクエストでチェックされ、両方を通過する必要があります。オーバーライドは他の誰かの制限を緩和することなく1人のエンジニアの制限を拡大し、すべての期間を置き換えるため基本ルールの期間を反復して定義します。
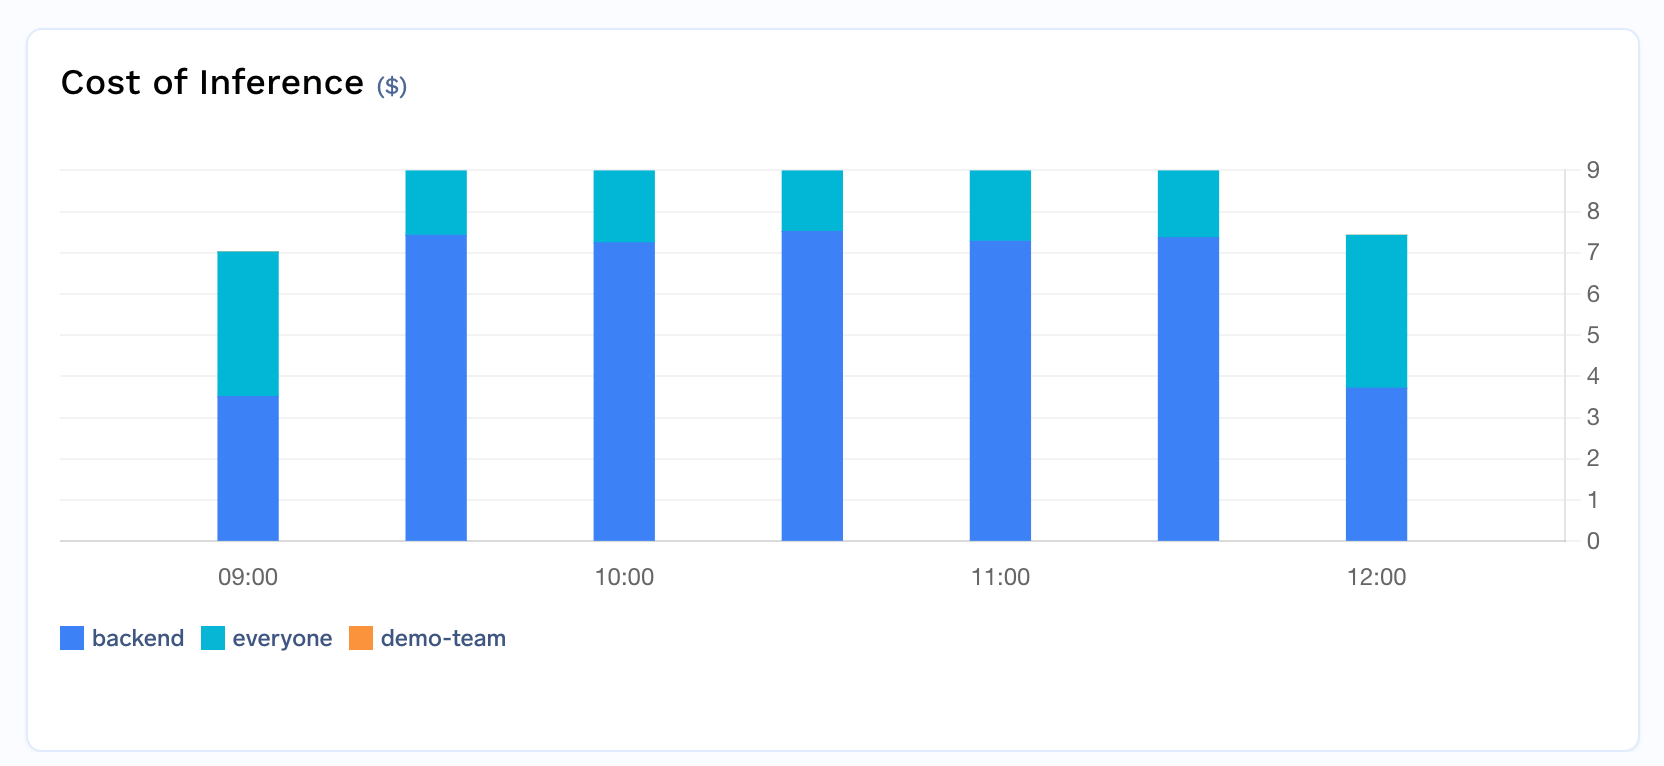
監査モードから開始し、帰属を整理する。 1週間 mode: audit で運用します。使用量は追跡されアラートは発信されますが、何もブロックされません。75%のアラートを確認し、実際のトラフィックに合わせて調整した後に強制適用(enforce)に切り替えます。各バーチャルアカウントにタグを付け、PATでのチーム選択を必須化することで、チャージバックレポートが自動的に作成されます。これがチームごとのコスト帰属管理の目的です。
2つのシステムは逆方向に強制適用されます。 レート制限は最初の一致が優先され(ファーストマッチ)、正確に1つのルールがブロックします。予算制限 V2 はすべて通過が必須であり(オールパスマッチ)、一致するすべてのルールがブロックする可能性があります。一方のメンタルモデルをもう一方に持ち込むと、ポリシーの挙動に驚くことになります。
予算をトークンで設定することはできず、レート制限をドルで設定することはできません。 両方が必要です。また、ドキュメントのURLは /ai-gateway/ratelimiting (1単語)であり、ハイフンを入れると404エラーになります。
音声コストの追跡範囲はトークンコストの追跡範囲よりも狭くなります。 ElevenLabs および Google Vertex の text-to-speech、speech-to-text をカバーしています。その他の音声プロバイダーは使用量を記録しますが、文字ごとや秒ごとのコストは記録されません。また、プライベート音声価格設定は Google Vertex のみです。プロバイダーから期間が報告されない speech-to-text はコストゼロとして計算されます。 予算機能は、無料であるとみなした制限のないトラフィックを通過させてしまいます。
リクエスト数からトークン数への移行は、設定変更としてはわずかですが、非常に大きな結果をもたらします。リクエストカウンターはどれだけ話が混雑しているかを教え、トークンカウンターは何を購入しているかを教え、予算はいつ停止すべきかを教えてくれます。
適切なレイヤリングを実現すれば、あとは自然とついてきます。トークン制限が分単位を平滑化し、リクエスト制限がパスを保護し、予算が月単位を統制し、無期限上限が残りの異常値を捉えます。本稿で説明した挙動は、2026年9月時点のTrueFoundryドキュメントに基づいています。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




考え方は同じで、呼び出し元が一定のウィンドウ内に消費できる量に上限を設けますが、単位が変わります。従来のAPIレート制限はリクエスト数を数えるもので、リクエストあたりのコストがほぼ同じ場合には機能します。LLMのリクエストはトークン数が桁違いに変動するため、トークン制限のほうが実際の消費をはるかに正確に捉えます。両方を併用してください。トークンは支出のペースを制御し、リクエスト数はリトライの集中から接続を保護します。
両方です。トークン制限はローリングウィンドウに対するスループットの制御で、特定の呼び出し元が今この瞬間にキャパシティを独占するのを防ぎます。予算は暦上の期間に対する財務上の制御で、チームが今月使いすぎるのを防ぎます。同じトークン数でもモデルによってコストが異なるため、トークン制限では金額を表せません。また、予算は現在の1分間については何も示しません。
失敗したリクエストは、ゲートウェイに拒否された場合も、プロバイダー側で4XXまたは5XXになった場合も、一致したすべてのrequests_per_*ルールに対して1リクエストとしてカウントされます。唯一の例外は、レート制限自体によってすでに429で拒否されたリクエストです。トークン制限には影響しません。失敗したリクエストはトークンを報告しないためです。
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、多数のプロバイダーにまたがってルーティングする場合でも、プロンプトとレスポンスがお客様のドメインの外に出ることはありません。
オーバーヘッドはおよそ3〜4ミリ秒で、単一のvCPUで350 RPS以上を処理し、1,000以上のLLMに対応しています。例外はオプションのLLM分類器で、リクエストを転送する前に実際のモデル呼び出しが1回加わります。
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheusに接続できます。LLM分類器の呼び出しごとに個別のスパンが生成されるため、分類器のレイテンシを、提供されるモデルのレイテンシとは別に確認できます。






















