



August 26, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
組織がチームやアプリケーション全体でLLMを採用するにつれて、モデルへのアクセスはすぐにセキュリティとガバナンス上の懸念事項となります。サービス間で共有される単一のAPIキーから始まったものが、可視性や制御がほとんどないまま多数のアプリケーション、エージェント、ワークフローがすべてモデルを呼び出す状態へと急速に変化することがよくあります。
これは現実的なリスクを生み出します。適切なアクセス制御がなければ、チームは特定のモデルを使用できるユーザーを簡単に制限したり、エージェントによる誤用を防いだり、本番環境でAIシステムがどのようにアクセスされているかを監査したりすることができません。プロバイダーレベルのAPIキーやSDK権限は、これらの要件を大規模に処理するようには設計されていません。
LLMアクセス制御は、実行時に誰がどのモデル、プロンプト、エージェント、ツールにアクセスできるかを適用することで、このギャップを解決します。コードに埋め込まれた静的な資格情報に依存する代わりに、リクエストが実行される際にアクセス決定が一元的に評価されます。
このブログでは、LLMアクセス制御が実践において何を意味するのか、本番システムでの実装がなぜ難しいのか、そしてゲートウェイベースのアーキテクチャが安全で監査可能なAIワークロードをどのように実現するのかを解説します。
LLMアクセス制御とは、誰が、または何が、どのような特定の条件の下でAI資産と相互作用することを許可されるかを決定するフレームワークです。従来のIT環境では、ファイルやサーバーへのアクセス制御に慣れています。AI時代において、「資産」はより動的です。それは生の知能(モデル)、自律機能(エージェント)、および外部アクション(ツール)の組み合わせです。
安全な境界を構築するには、これら3つの重要な次元にわたってアクセス制御を適用する必要があります。
組織内のすべてのユーザーがすべてのモデルへのアクセスを必要とするわけではありません。例えば、新しい機能をテストするエンジニアはLlama 3のようなオープンソースモデルへのアクセスのみで十分かもしれませんが、高度なデータサイエンティストはGPT-4oやClaude 3.5 Sonnetの推論能力を必要とする場合があります。
モデルレベルでのアクセス制御により、コスト、機密性、必要性に基づいてゲートキーピング(アクセス制限)を行うことができます。これにより、従業員が未検証のサードパーティプロバイダーで実験を行う「モデルの乱立」を防ぎ、最も高価なトークンがそれを実際に必要とするユーザーのために確保されるようになります。
LLMベースのエージェントのデプロイは、シンプルなチャットボットの使用とは根本的に異なります。エージェントは、ステップを「思考」し、時間をかけてワークフローを実行できる永続的なエンティティです。
アクセス制御が弱い場合、どのユーザーでも技術的にはバックグラウンドで実行される自律エージェントをデプロイできてしまい、潜在的に再帰ループに入ったり、承認されていない何千ものAPI呼び出しを行ったりする可能性があります。
ここでのガバナンスとは、どのチームが「デプロイ」権限を持つかを定義し、すべてのエージェントに明確な所有者と厳格に定義されたライフサイクルを持たせることを意味します。
これは3つの中で最も重要な層です。LLMにCRM、社内ドキュメント、メールサーバーなどの「ツール」へのアクセス権を与えるということは、実質的にLLMに「手」を与えることを意味します。
詳細なアクセス制御とは、エージェントが呼び出せるツールを正確に定義することです。カスタマーサポートボットはナレッジベースを読み取る権限を持つかもしれませんが、本番データベースへの書き込みは厳格にブロックされるべきです。
ツールレベルの権限がない場合、単純なプロンプトインジェクション攻撃によってエージェントが騙され、その上位権限を使用してデータを外部漏洩させたり重要なレコードを削除したりする可能性があります。真のアクセス制御は、悪意のあるプロンプトによってLLMが「侵害」されたとしても、被害を与える能力がスコープ定義された権限によって物理的に制限されることを補償します。
チームがLLMワークロードを本番環境に移行する際、アクセス制御の問題は悪意によるものではなく、初期の実験段階で行われた近道から発生することがよくあります。これらのギャップは、チーム、エージェント、環境全体で使用規模が拡大するにつれて、深刻なリスクとなります。
多くのチームは、複数のサービスや開発者にわたって、モデルプロバイダーの単一の共有APIキーから使い始めます。便利ではありますが、このアプローチはアイデンティティや責任追跡の概念をすべて排除してしまいます。
共有キーを使用すると、ユーザー、アプリケーション、エージェントを識別することが不可能になります。キーが漏洩したり誤用されたりした場合、システム全体が危険にさらされます。1人のユーザーのアクセスを取消すことは、通常、全員のアクセスを断つことを意味し、これは本番環境においては運用上のリスクとなります。
エンタープライズのセキュリティとコンプライアンスは、単純な疑問に答えられるかどうかにかかっています:誰が、いつ、何にアクセスしたのか?
中央集権的なアクセス制御層がない場合、LLMの使用状況はローカル環境、ノートブック、CIパイプライン、サードパーティのダッシュボードに分散します。この断片化により、インシデント発生後にイベントを再構築することが困難になります。機密データが露出したり、モデルが予期せぬ挙動を示したりした場合、チームには根本原因を特定するために必要な監査ログが不足していることがよくあります。
規制の厳しい業界では、監査可能性の欠如は、意図に関わらずセキュリティポスチャの不備として扱われます。
エージェントは有用な作業を実行するために権限の昇格を必要とすることが多いですが、必要以上の広範なアクセス権が与えられがちです。設定のオーバーヘッドを避けるためだけに、ツール、データストア、またはAPIへの制限のないアクセス権を持つエージェントがデプロイされるのをよく目にします。
これにより、強力なモデル、過剰な権限を持つツール、およびプロンプトインジェクションの脆弱性が組み合わさって影響を増幅させる、ハイリスクなシナリオが作成されます。悪意のあるプロンプトによってエージェントが操作された場合、その過剰な権限により、データの外部漏洩や破壊的なアクションなどの実害を引き起こす可能性があります。したがって、エージェントの権限を制限することは、被害半径(ブラストライジアス)を縮小するために極めて重要です。
効果的なLLMアクセス制御には、ユーザー、アプリケーション、エージェントにわたって一貫して動作する複数の適用レイヤーが必要です。これらの機能は実行時に適用され、既存のエンタープライズアイデンティティおよびセキュリティシステムに統合される必要があります。
RBACにより、権限が個々のユーザーではなくロールに紐付けられることが保証されます。AIの文脈において、これにより組織は管理者、開発者、エンドユーザーの間に明確な境界を定義できます。
例えば、開発者は非本番環境でモデルやプロンプトの実験を行うことが許可され、エンドユーザーは承認されたエージェントとのみ対話できます。RBACを既存のアイデンティティプロバイダーと統合することで、チームメンバーの変更に伴うアクセスの自動オンボーディングと取消が可能になります。
開発環境、ステージング環境、および本番環境を分離することは、リスクを制御するために不可欠です。アクセス制御ポリシーにより、高権限のモデル、ツール、および資格情報には、追加のセーフガードを備えた本番環境からのみアクセスできるようにする必要があります。
これにより、実験的なワークロードが機密性の高い本番データと誤って相互作用するのを防ぎ、意図しない変更がエンドユーザーに届くリスクを軽減します。
モデルによって、コスト、機能、データの露出プロファイルが異なります。モデルレベルの権限により、チームはこれらの要因に基づいてアクセスを制限できます。
高価なモデルや機密性の高いモデルは特定のチームやプロジェクトに制限し、低コストのモデルやセルフホスト型モデルにはより広範なアクセスを許可することができます。これにより、支出を管理し、必要のない外部プロバイダーへの露出を減らすことができます。
ツールレベルのアクセス制御は、エージェントが呼び出された後に実行できるアクションを定義します。広範なAPIアクセスを付与するのではなく、権限は特定の機能や操作にスコープを絞る必要があります。
例えば、エージェントはドキュメントリポジトリからの読み取りは許可されても、レコードの変更や削除はブロックされる場合があります。このレベルで権限を適用することで、不正確な推論やプロンプト操作の影響を制限し、エージェントが予期せぬ挙動を示した場合でもコアシステムを保護します。
アプリケーションレベルでアクセス制御を管理することは、本番AIシステムではスケールしません。複数のチーム、エージェント、およびサービスが異なるモデルプロバイダーと直接統合されると、アクセスポリシーが断片化し、一貫して適用することが困難になります。
AI Gatewayは、アプリケーションとモデルプロバイダーの間の集中型適用レイヤーとして機能することで、この問題に対処します。サービス全体に資格情報や権限を埋め込む代わりに、リクエストがモデルに到達する前に、アクセス制御が実行時に評価されます。
ゲートウェイは、すべてのLLMトラフィックに対する認証と認可の単一ポイントとして機能します。プロバイダーの資格情報はアプリケーションコード全体に分散されるのではなく、ゲートウェイ内に安全に保存されます。
アプリケーションとエージェントは、マネージドアイデンティティを使用してゲートウェイで認証を行います。これにより、セキュリティチームはアプリケーションを再デプロイすることなく、アクセスを取消したり、プロバイダーキーをローテーションしたり、ポリシーを中央で更新したりできます。サービスやエージェントが侵害された場合、そのアクセスはゲートウェイレイヤーで即座に無効化できます。
単純な認証を超えて、ゲートウェイはポリシー駆動型のアクセス制御を可能にします。各リクエストは、以下のようなコンテキスト属性に対して評価できます:
これらの属性に基づいて、ゲートウェイは定義されたポリシーに従ってリクエストを許可、拒否、または再ルートできます。これにより、高コストのモデルを特定のチームに制限したり、特定のエージェントが機密ツールにアクセスするのを防いだりするなど、きめ細かな制御が可能になります。
すべてのリクエストがゲートウェイを通過するため、ゲートウェイは監査データの信頼できる情報源となります。すべてのモデル呼び出しは、リクエストを開始したユーザー、アクセスされたモデル、リクエストがどのように処理されたかなど、完全なコンテキストとともにログに記録できます。
この一元化された監査ログは、コンプライアンスやフォレンジック分析において極めて重要です。これにより、組織はセキュリティレビューや監査の際にイベントを正確に再構築し、AIシステムへの制御されたアクセスを実証できます。
アクセス制御をゲートウェイに移行することで、チームは散在する暗黙的な権限から、システムの複雑さや組織の成長に合わせてスケールする明示的で強制力のあるポリシーへと移行します。
ゲートウェイ評価のための主要メトリクス
| 評価基準 | 何を評価すべきか? | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | 最初のトークンまでの時間(TTFT)に10ミリ秒未満(p95)のオーバーヘッドを追加するか? | 必須 | ✅ 対応済み |
| データレジデンシー | ログを自地域(EU/米国)内に保持するか? | ユースケースによる | ✅ 対応済み |
| レイテンシベースのルーティング | リアルタイムのレイテンシや障害に基づいて自動的に再ルートするか? | 必須 | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須 | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須 | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須 | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須 | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーをローテーションまたは失効できるか? | 必須 | ✅ 対応済み |

TrueFoundryは、アクセス制御の理論的要件を本番環境に対応した実用的な機能へと変えます。統合コントロールプレーンとして動作し、プラットフォームチームがボトルネックとなるレイテンシを発生させることなく、単一のインターフェースから何千ものモデルやユーザーを管理できるようにします。
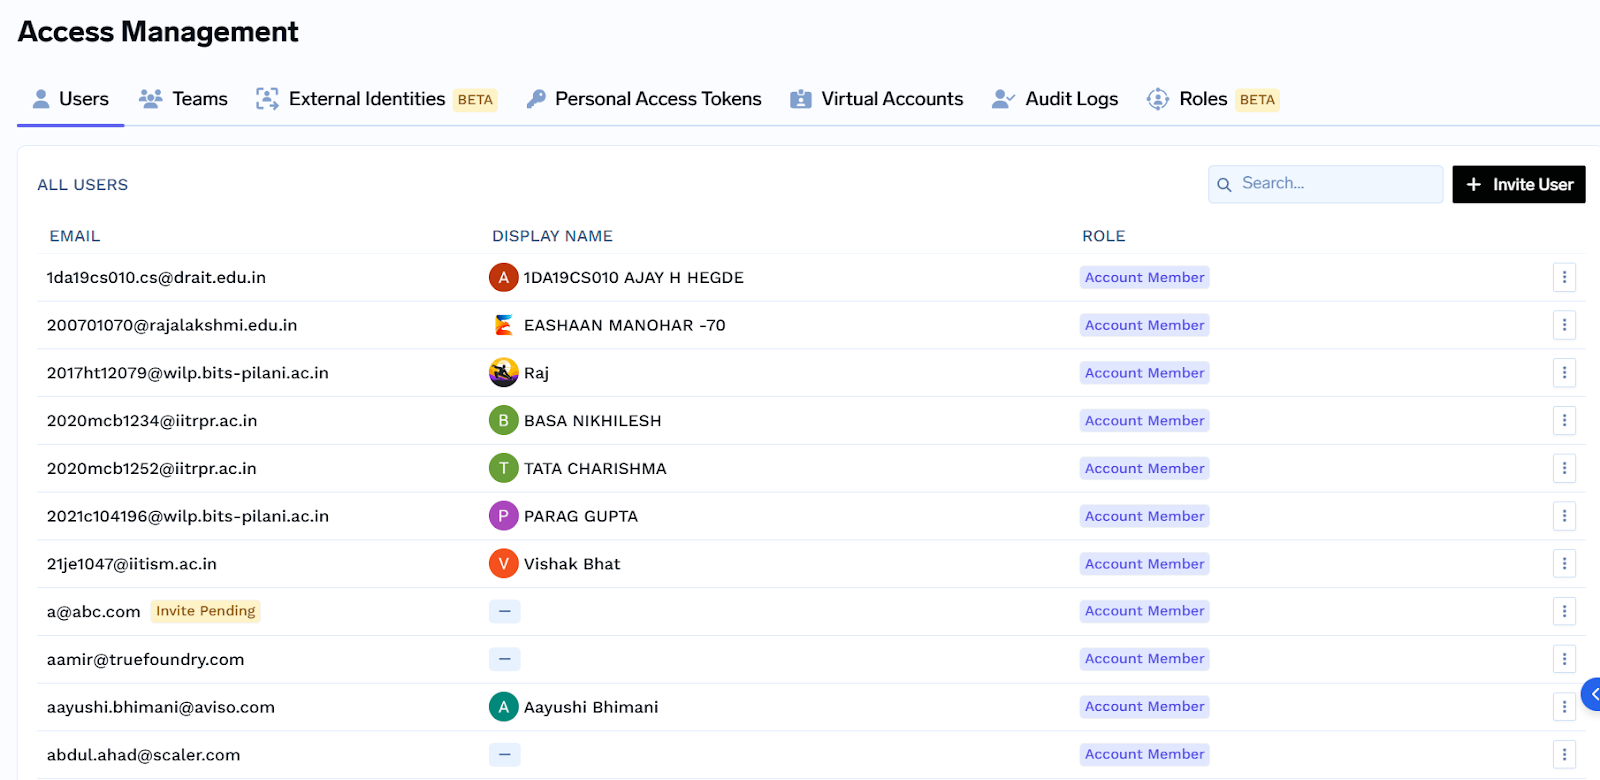
ガバナンスのためのゲートウェイレベルの制御
TrueFoundryのAI Gatewayは、UIを介してプロバイダーアカウントレベルで設定されるいくつかのきめ細かな制御機能を提供します。これらの機能により、ガバナンスが後付けではなくインフラストラクチャに組み込まれることが保証されます。
アクセス制御と権限 プラットフォームはプロバイダーアカウントに対して2つの異なる権限レベルを利用し、管理業務と日常の使用を分離します:
トークンによるマネージドアクセス 開発者と本番システムの異なるニーズに対応するため、TrueFoundryは2種類のキーを提供します:
セキュリティとコンプライアンスへの対応
TrueFoundryにおけるセキュリティは多層防御です。まず、OIDC、JWT、マネージドAPIキーを使用したエンタープライズグレードの認証から始まり、すべてのリクエストの背景に検証済みのアイデンティティが存在することを保証します。これに続き、ロールベースアクセス制御 (RBAC) による認可が行われ、ユーザーが使用を許可されたモデルとツールのみが表示されるようにします。
新たなAIの脅威から保護するため、ゲートウェイはコンテンツの安全性のためのガードレールを統合しています。これには、機密データの漏洩を防ぐためのリアルタイムのPII(個人識別情報)検出、有害なコンテンツをブロックするモデレーション、およびプロンプトインジェクション攻撃を停止する専用フィルターが含まれます。すべての相互作用はリクエストおよびレスポンスログを通じて記録され、コンプライアンスやフォレンジックデバッグに不可欠な改ざん不可能な監査ログを作成します。
高度な構成制御
単純なアクセスを超えて、ゲートウェイはシステムを安定させ、費用対効果を維持するための技術的制御を提供します:
エンタープライズAIの最前線を保護することは、イノベーションのスピードを落とすことではありません。実験を安全にするためのガードレールを構築することです。共有キーから脱却し、一元化されたゲートウェイ駆動モデルへ移行することにより、組織は最終的にLLMをセキュリティスタックのファーストクラス市民として扱うことができるようになります。詳細な権限管理と堅牢な監査ログにより、プロトタイプから本番環境への移行は戦略的な強みとなります。真のガバナンスは、データを保護するだけでなく、チームが確信を持って構築できるように支援します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.































