


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
Model Context Protocol は、適合する任意のクライアントにおいて、LLMがツールを呼び出し、コンテキストを読み取り、プロンプトを再利用するための標準的な方法を提供します。これに対応するサーバーを構築すること自体は難しくありません。しかし、正確で、安全に公開でき、モデルにとって使いやすいサーバーを構築するには、クイックスタートチュートリアルで扱われている以上のいくつかの決定が必要です。このガイドでは、サーバーが公開するもの、選択すべきトランスポートとその理由、モデルが効果的に使用できるツールの定義方法、リモートサーバーの認証方法、テスト方法、ローカル環境から本番環境へ移行する際の変化など、プロセス全体を順を追って解説します。
実行例は Python 風のスタイルの構造的擬似コードです。特定の SDK バージョンに依存せず、正確な構成(名前、スキーマ、ハンドラーのシグネチャ)を示しています。コンテキストの構造が共通して適用できるためです。概念的な基礎を最初に確認したい場合は、MCPサーバーとはでモデルについて解説しています。本記事は構築に特化した内容です。
MCPサーバーを構築しましたか? 認証、レジストリ、監査のためにゲートウェイの背後に配置しましょう。デモを予約する。
MCPサーバーは、クライアントに対して3種類の機能を提供します。設計段階でこの違いを正しく理解しておくことで、すべての機能をツールに詰め込んでしまうという最も一般的な設計上の誤りを防ぐことができます。
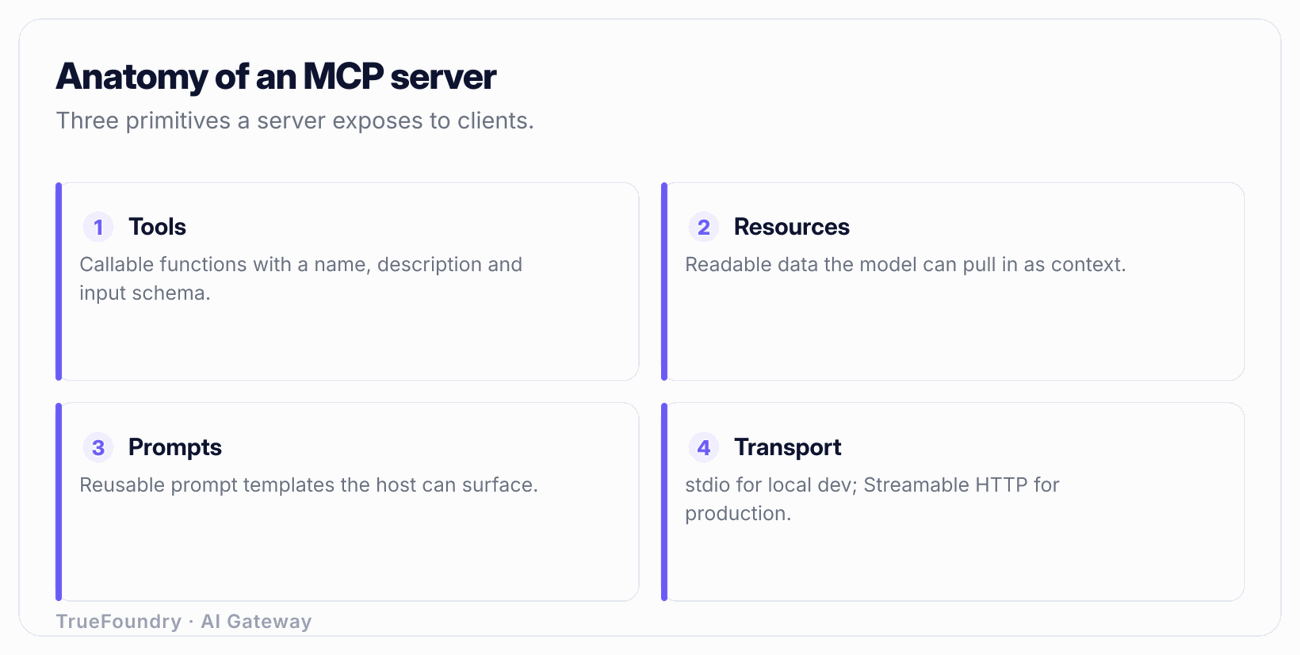
ツールは、モデルによって呼び出される関数です。モデルは会話中に、データベースへのクエリ実行、チケットの作成、内部APIへのリクエスト送信などの処理を完遂するためにツールを呼び出す決定を下します。ツールは副作用を持つことができます。モデルに行動させる必要がある場合に選択するプリミティブです。ツールには名前、説明、入力用の JSON Schema があり、構造化されたコンテンツを返します。
リソースは、URIによって識別されるアプリケーション制御の読み取り専用コンテキストです。リソースは、ファイル、設定ドキュメント、レコードの現在の内容など、クライアントが読み取ってモデルにコンテキストとして渡すことができるデータです。ツールとの決定的な違いは、制御の主体と意図です。リソースは読み取り専用であり、通常はモデルが推論の途中で効果を発生させるために呼び出すのではなく、アプリケーションやユーザーによって選択されます(例:「このドキュメントを添付する」)。公開しようとしている機能が状態を変更せず、実質的に「読み取るべきコンテキスト」である場合は、ツールではなくリソースとして設計します。
プロンプトは、ユーザーが呼び出すテンプレートです。プロンプトは、ユーザーが明示的にトリガーする、再利用可能でパラメータ化されたメッセージ(またはメッセージシーケンス)であり、多くの場合、クライアント内でスラッシュコマンドやメニュー項目として表示されます。pr_url パラメータを使用した「このPRを自社スタイルで要約する」といった指定はプロンプトにあたります。プロンプトはユーザーによって制御され、モデルによって自律的に選択されるものではありません。
実践的なルール:モデルが使用するタイミングを判断すべき場合はツールを構築します。ユーザーまたはアプリがロードするコンテキストを決定する場合はリソースを構築します。ユーザーが繰り返し使用する定型命令を望んでいる場合はプロンプトを構築します。多くのサーバーは正当な理由からツールのみを公開していますが、例えば社内運用手順書(ランブック)を公開するようなサーバーの場合、モデルが呼び出し方を推測しなければならない get_runbook ツールよりも、リソースとしてモデル化する方が適しています。
プロトコルは、クライアントとサーバーが JSON-RPC メッセージを交換する方法を定義します。重要なトランスポートは2つあり、その選択がデプロイ方法のほぼすべてを決定します。
ローカル stdio は、サーバーをクライアントのサブプロセスとして実行し、標準入力および標準出力を介してメッセージを交換します。これは、サーバーがユーザーと同じマシン上で実行される IDE やローカルアシスタントなどのデスクトップクライアントや、開発環境に適した選択肢です。ネットワークや設定すべき認証は存在せず、クライアントがプロセスのライフサイクルを管理します。コーディングクライアント内でローカルサーバーを実行する具体的な方法については、Claude CodeにおけるMCPサーバーを参照してください。デメリットは明白です。stdio は単一のローカルユーザーのみに対応し、共有、ロードバランス、ネットワーク経由でのアクセスができません。
リモート Streamable HTTP は、ネットワークサービスとしてサーバーを実行し、クライアントが HTTP 経由でアクセスします。通知や進捗状況の送信にはサーバーからクライアントへのストリーミングを使用します。マルチユーザー環境、ホスト環境、本番環境のすべてにおいて採用されるトランスポートです。ここで 2026-07-28 のプロトコルリビジョンが重要になります。Streamable HTTP はステートレスモードをサポートしており、サーバーは1つのインスタンス上の長期セッションにクライアントを固定(スティッキー)する必要がありません。ステートレス運用により、ロードバランサーの背後で多数の同一レプリカを実行し、水平スケーリングを行うことができます。これは本番環境ホスティングにおいて最も重要な特性です。同リビジョンでは、リクエスト上の Mcp-Method および Mcp-Name ヘッダーも標準化され、HTTP レヤーで JSON-RPC メソッドやツール/リソース名が公開されるようになりました。これは些細なことに思えるかもしれませんが、非常に重要です。ゲートウェイ、プロキシ、またはロードバランサーが、JSON-RPC のボディを解析することなく、ツール単位でルーティング、レート制限、認可、ログ記録を行えることを意味します。これこそが大規模環境でサーバーをガバナンスするために必要な機能です。
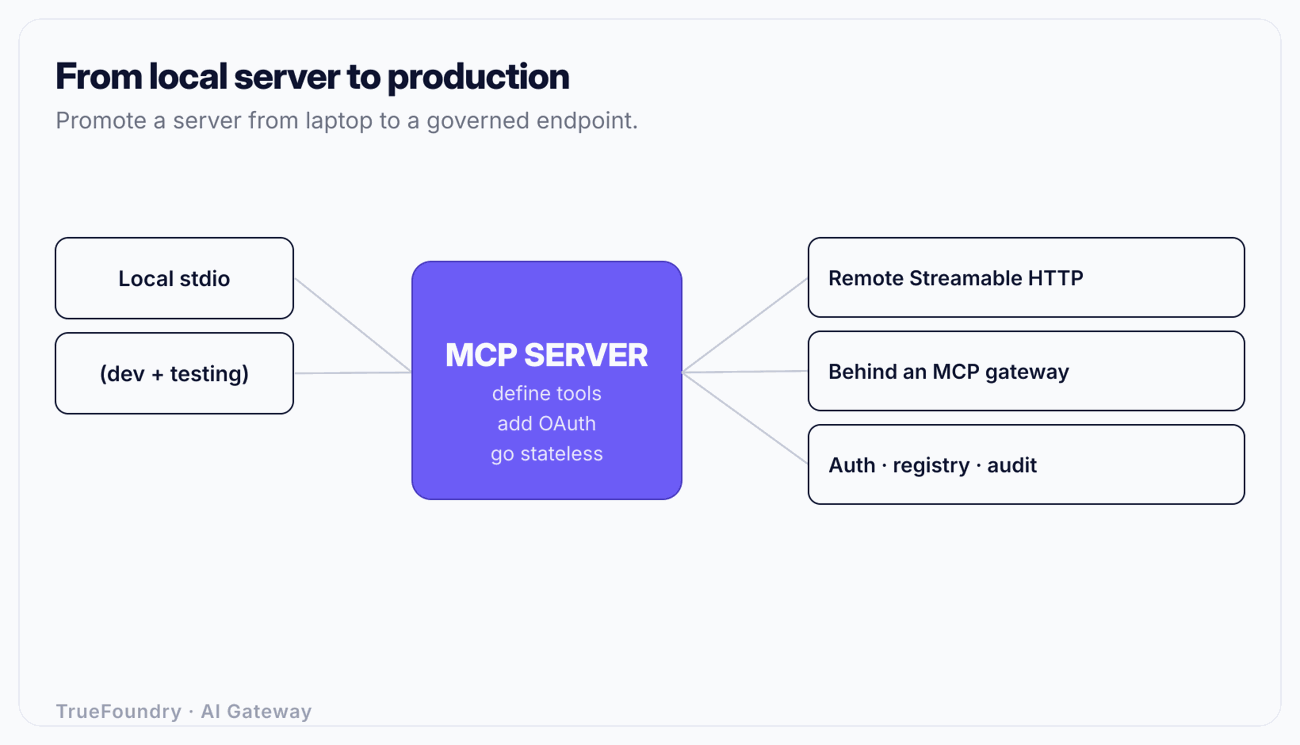
stdio で構築・デバッグし、Streamable HTTP で本番デプロイを行います。トランスポートが薄い外部レイヤー(メッセージの受信経路に依存しないハンドラー)になるようにサーバーを記述することで、ロジックを書き換えることなく両者間を移行できます。
ツール定義は3つの要素で構成され、モデルの挙動はそのすべてによって制御されます。これが「サーバーが機能しない」問題のほとんどの発生源です。
# Structural pseudocode — shape, not a specific SDK version.

@server.tool()
def search_orders(
    customer_id: str,        # required
    status: str = "any",     # enum: open | shipped | cancelled | any
    limit: int = 20,         # 1..100
) -> list[Order]:
    """Search a customer's orders by status.

    Use this when the user asks about the state, history, or
    contents of orders for a known customer_id. Returns up to
    `limit` orders, newest first. Does NOT create or modify
    orders. If the customer_id is unknown, ask the user for it
    rather than guessing.
    """
    ...
3つの構成要素:
名前(Name)。 簡潔で、動詞から始まり、あいまいさがないこと。orders や do_order_stuff ではなく search_orders を使用します。モデルは、利用可能な多数のツールから選択する際、最初に名前を読み取ります。
Description (説明)。 これは記述する中で最も重要なテキストであり、ドキュメント作成ではなくプロンプトエンジニアリングです。モデルは、ほぼ全般的にこの説明のみに基づいて、ツールを呼び出すかどうか、およびその引数をどのように埋めるかを決定します。ツールが何をするのか、いつ使用するのか、いつ使用してはいけないのか、何を返して、欠落した入力をどう処理するのかを明確に述べてください。上記の例では、モデルに対して読み取り専用であること(「作成または変更しない」)を伝え、フォールバックの動作(「推測せずにユーザーに確認する」)を与えています。説明があいまいだと、モデルは誤ったツールを呼び出したり、正しいツールを間違った引数で呼び出したり、呼び出すべきでないときに呼び出したりしてしまいます。あらゆる説明を、ミニシステムプロンプトとして扱ってください。
Input schema (入力スキーマ)。 精確な JSON Schema です。必須フィールドには required マークを付けます。閉じられた値のセットには enum を使用し(status は4つの値のうちの1つ)、モデルが "in_progress" をでっち上げないようにします。境界を設定します(limit は1から100の間)。各フィールドに説明を添えます。厳密なスキーマは、モデルを制約すると同時に、ハンドラーが実行される前にサーバーやその前のゲートウェイがデータを検証することを可能にします。
誰もがハマる2つの落とし穴:
create_refund)は、効果を二重にすることなく、同じ入力で2回呼び出されることに耐えなければなりません。冪等性キーを受け入れるか、操作自体を本質的に冪等なものに設計してください。実際に提供されるのは「少なくとも1回の配送(at-least-once delivery)」であるため、それを前提に設計してください。ローカルの stdio サーバーはユーザーのマシンの信頼を継承するため認証は不要です。しかし、サーバーを HTTP 経由で公開した瞬間から、本格的な認証が必要になります。そしてプロトコルは「本格的」が何を意味するかを明確に定義しています。
MCP の認可モデルは OAuth 2.1 に基づいています。特に重要なのが2つの要素です。第一に、サーバーは OAuth で保護されたリソースです。クライアントは認可サーバーからアクセストークンを取得し、それをベアラートークンとして提示します。第二に、見落とされがちですが、仕様ではリソースインジケーター(RFC 8707)を求めています。これにより、トークンは汎用的なトークンになるのではなく、発行対象の特定の MCP サーバー(リソース)にバインドされます。リソースインジケーターがない場合、サーバー A 用に生成されたトークンが、同じ認可サーバーを信頼するサーバー B に対して再利用される可能性があり、混乱した代理(confused-deputy)問題が発生します。リソースインジケーターがあれば、認可サーバーは意図したリソースにスコープされたトークンを発行し、各サーバーは自身に向けられていないトークンを拒否します。
実際には、これを自作する必要はありません。OAuth を正しく終了し、すべてのトークンのオーディエンスを検証するものの後ろにサーバーを配置します。それが MCP ゲートウェイの役割の1つです。より詳細な仕組み、トークン検証、スコープ、混乱した代理の障害モードについては、MCP 認証で解説しています。本ガイドでのルール:静的な共有 API キーで保護されたリモート MCP サーバーは認証されておらず、難読化されているだけです。オーディエンスバインドされたトークンと合わせて OAuth 2.1 を使用してください。

TrueFoundry がリモート MCP サーバーをどのようにホストおよびガバナンスするかをご覧ください。デモを予約する。
外部に公開する前に、MCP クライアントを介してサーバーを動かし、メッセージのやり取りを確認します。
ステップ 3 のモデル駆動テストは、多くのチームがスキップしがちですが、最も重要なテストです。技術的には正しくてもツールの説明が不十分なサーバーは、ログからデバッグするのが最も困難な方法で失敗します。つまり、モデルが単に使い方を間違えるのです。
ラップトップ上で stdio 経由で実行されるサーバーと、実際のトラフィックに公開しても安全なサーバーは全く別物です。そのギャップに含まれるものは以下のとおりです。
ホスティングとライフサイクル。 サーバーはデプロイ、監視、ロールアウト、ロールバックを行うサービスになります。ヘルスチェック、リソース制限、デプロイ先ターゲットが必要になります。MCP サーバーのホスティングでは、オプションとトレードオフをカバーしています。
ステートレスなスケーリング。 ロードバランサーの背後で複数のレプリカを実行するには、リクエストごとにサーバーをステートレスに保ちます。これは 2026-07-28 の Streamable HTTP ステートレスモードが意図している設計です。セッション状態はインスタンスのメモリではなく共有ストアに存在する必要があります。そうしないと、異なるレプリカにルーティングされたクライアントのフォローアップリクエストが失敗します。
認証と認可。 認証にはリソースインジケーター付きの OAuth 2.1 を使用し、次に認可を設定します。どのユーザーやどのエージェントがどのツールを呼び出せるかを定義します。エージェントを、その背後にいる人間だけでなく、ファーストクラスのアイデンティティとして扱ってください。AI エージェントアイデンティティとツールごとのきめ細かな認可こそが、高性能なサーバーが負債と化すのを防ぎます。
レジストリによるディスカバリ。 クライアントとプラットフォームチームは、サーバーを見つけ、そのバージョンを知り、何が公開されているかを把握する必要があります。レジストリは、組織全体でサーバーを発見可能かつ管理可能にするカタログです。MCP レジストリとはを参照してください。レジストリがなければ、各チームが手動で同じサーバーを再発見し、再設定することになります。
オブザーバビリティ(可視性)。 誰がどのツールを、どの引数で呼び出し、どれだけの時間がかかり、エラーが発生したか、コストがいくらかかったかなど、呼び出しごとの可視性が必要です。生のサーバーはこれらを標準的な方法で出力しません。
ガードレール。 ツールの入力と出力には、PII、シークレット、あるいは返されたコンテンツを介して密輸されたプロンプトインジェクションのペイロードが含まれている可能性があります。これらを検査することは横断的な関心事であり、サーバーごとに再実装したくない機能です。
これを扱いやすくするパターンは、そのレイヤーをサーバーごとに再構築しないことです。Streamable HTTP 上で1つの役割を優れて果たすようにサーバーを構築し、認証、認可、レジストリ、オブザーバビリティ、ガードレールを一元的に提供する MCP ゲートウェイの背後に配置します。これが、生のサーバーを公開することと、それらのフリートを運用の違いです。MCP ゲートウェイとはでモデルを説明しており、エンタープライズ MCP ガバナンスでそれに伴う制御、監査、アクセス要件をカバーしています。TrueFoundry は、これを RBAC、SSO、SCIM アクセス制御およびガードレールを備えた MCP ゲートウェイおよびレジストリとして提供しており、SaaS、In-VPC、オンプレミス、あるいはエアギャップ環境にデプロイ可能なため、データプレーンはご自身のネットワーク内に保持されます。
すべてをツールにしてしまう。 読み取り専用のコンテキストが、アプリケーションが添付すべきリソースであるべきなのに、モデルが呼び出し方を推測しなければならない get_* ツールに詰め込まれてしまいます。繰り返し使用される定型的な指示は、ユーザーが呼び出すべきプロンプトであるべきなのに、ハードコードされてしまいます。3つのプリミティブを意図してモデル化してください。
ツールの説明を簡素に書いてしまう。 1行の説明では、モデルがツールをいつどのように呼び出すかを推測することになり、推測を誤ります。説明は動作を制御するものです。いつツールを使ってはいけないかを含め、システムプロンプトのように記述してください。
共有キーの背後でリモートサーバーをリリースしてしまう。 静的な API キーは認証ではありません。リモートサーバーには、あるサーバーのトークンが別のサーバーに対して再利用されないよう、オーディエンスバインドされたトークン(リソースインジケーター)を持つ OAuth 2.1 が必要です。これをスキップすると、混乱した代理のセキュリティホールが生まれます。
冪等性を無視してしまう。 クライアント、ネットワーク、ゲートウェイのフォールバックはすべてリトライを行います。冪等でない副作用を持つツールは、極めて正常なリトライ条件の下で、二重課金、二重作成、二重送信を引き起こします。少なくとも1回の配送を前提に設計してください。
「動いている」を「本番対応完了」と勘違いしてしまう。 動作するサーバーは始まりに過ぎません。ホスティング、ステートレススケーリング、認証、レジストリ、オブザーバビリティ、ガードレールこそが、安全に公開するための実際の作業であり、それをサーバーごとに再構築することは、組織内に管理されていない無数のエンドポイントを生み出す原因となります。
MCP サーバーの構築は、短い道のりと長いテールのようなものです。道のりとはクイックスタートのことです。トランスポートを選択し、名前、説明、スキーマを指定してツールを登録し、クライアントでテストします。半日もあれば動作するサーバーが完成します。テールとは、サーバーを正確かつ安全にするためのすべてです。ツール、リソース、プロンプトを意図的にモデリングすること、モデルが適切に動作できる説明を書くこと、副作用のあるツールをべき等にすること、OAuth 2.1 とリソースインジケーターでリモートアクセスを認証すること、そしてステートレスにスケールさせることです。
多くのチームが過小評価している段階は、「自分のノート PC で動く」から「実際のトラフィックに公開する」へのジャンプです。そのジャンプとは、ホスティング、認証、認可、ディスカバリ、オブザーバビリティ、ガードレールであり、そのレバレッジは、サーバーごとにそのレイヤーを再構築しないことにあります。Streamable HTTP 上で機能するようにサーバーを構築し、ガバナンスのために MCP ゲートウェイとレジストリの背後に配置すれば、誰もセキュリティを確保できず見つけられない単発のエンドポイントではなく、実際に運用可能なものを手にすることができます。
ローカルの MCP サーバーをプロダクションレベルでガバナンスされた状態に進化させましょう。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












