


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
モデルの直接比較では、往々にして誤った問いが立てられがちです。「Terraか、Flashか?」という問いは、どちらか一方と永続的に付き合う必要があるかのような印象を与えます。しかし、GPT-6.1 TerraとGemini 3.6 Flashは、ラダーの同じ段に位置しています。つまり、中価格帯、大容量コンテキスト、フラグシップには及ばないものの強力なコーディング能力を備え、互いに価格帯の近いモデル同士です。これほど性能と価格が近く、代替可能な2つのモデルが存在する場合、どちらか一方だけを選んでコードにハードコーディングしてしまうことこそが、最もコストの高くつく失敗です。低コストで堅牢なアプローチは、両者の間でルーティングを行い、それぞれの優位性(性能や価格)に応じて使い分け、片方のプロバイダーに障害が発生した際にもう一方へフォールバックすることです。
本記事では、重要な観点(価格、コンテキスト長、コーディング性能、処理速度)において両モデルを比較(すべて報告ベースの数値を前提とします)した上で、本当の主張をお伝えします。それは、これら2つのモデルをルーティングポリシーにおける相互交換可能なターゲットとして扱い、難度の高い処理のみ上位のフラグシップモデルへエスカレーションさせるべきだということです。
精度に関する注記:参考として使用しているClaudeの数値を除き、以下に記載するすべての仕様は2026年11月時点のサードパーティによる報道・報告に基づくものであり、ソースによって一部食い違いがあります。実際の構築にあたっては、必ずOpenAIおよびGoogleの公式ページで数値をご確認ください。
タスクと価格に応じた中価格帯モデル間のルーティングおよび自動フォールバックを導入しませんか? デモを予約する。
GPT-6.1 Terraは、2026年10月26日頃にOpenAIのGPT-6.1ラインナップの中価格帯モデルとしてリリースされたと報じられています。報告されているスペック:入力100万トークンあたり$1、出力100万トークンあたり$5、コンテキストウィンドウは約1.05M、Coding Indexは約48です。最大の特徴はその価格であり、報告通りの$1 / $5であれば、GPT-6.1 Sol(報告価格:$2 / $10)のコーディング能力の大部分を維持しながら、トークンあたりのコストを約半減に抑えていることになります。
Gemini 3.6 Flashは、2026年7月頃にGoogleの速度最適化型・中価格帯モデルとしてリリースされたと報じられています。報告されているスペック:入力100万トークンあたり$1.50、出力100万トークンあたり$7.50、コンテキストウィンドウは1M、スループットは毎秒約280トークン、Intelligence Indexは約50、SWE-Bench Proは約58.7%です。最大の特徴は、中価格帯でありながらコーディング性能と処理速度を両立している点です。

価格およびベンチマークは2026年11月時点の報道に基づくものです。モデル仕様は頻繁に変更されるため、必ず各プロバイダーの公式価格ページでご確認ください。なお、本記事内で言及されるClaudeの数値のみが唯一の一次情報確認済みデータです。
この表を読み解く上での注意点:
この比較から導き出される結論は、「Terraの勝ち」でも「Flashの勝ち」でもありません。結論は「この2つは相互に代替可能なほど似通っており、代替可能なモデル同士こそルーティングの対象に最適である」ということです。
2つのモデルが互いに代替可能である場合、1つのモデルだけに固執してもメリットはなく、むしろ2つのデメリットが生じます。タスクごとに適したモデルを使用する機会を失う点と、単一プロバイダーの障害リスクを直接受けてしまう点です。両者間でルーティングを行えば、この両方の問題を解決できます。
Terraの報告価格の低さを活かし、大量生成、長文チャット、日常的な高ボリュームのコーディングなど、出力が多くコスト感度の高いトラフィックにはTerraをデフォルトとして割り当てます。一方、Flashの優れたコーディング性能と処理速度(約280トークン/秒)を活かし、コーディング比率の高いリクエストやレイテンシが重視されるパスにはFlashを優先的に割り当てます。システム全体でどちらか1つに固定するのではなく、タスクの種別ごとに選択するのです。これがコストと品質を考慮したモデル選定であり、それを支える仕組みがLLMルーターです。
互いに代替可能であるため、一方のモデルはもう一方の自然なフォールバック先となります。Terraをプライマリ、Flashをフォールバック(またはその逆)として設定しておけば、片方のプロバイダーでエラー、タイムアウト、レート制限が発生しても、もう片方が処理を吸収します。ユーザー側にはわずかなレスポンス遅延が生じるだけで、システムエラーとして失敗することはありません。これこそがLLMフォールバックのコアバリューです。実質的に同等の中価格帯モデルを2つ用意することで、どうせどちらか1つを運用する予定であったシステムに、ほぼゼロコストでプロバイダーの冗長性を組み込むことができます。
どちらのモデルも最上位のフラグシップではありません。長時間のコンテキスト維持が必要なエージェント型コーディングや高度な推論においては、どちらのモデルからでもフラグシップ階層へとエスカレーションさせるべきです(公式に確認されている堅牢なデフォルトとしてはClaude Opus 5.5があり、GPT-6.1 SolやGemini 3.1 Proも同等クラスとして報じられています)。中価格帯のペアで大半の処理を捌き、難度の高い部分のみをフラグシップで処理します。この分岐を担うのがルーティングルールです。
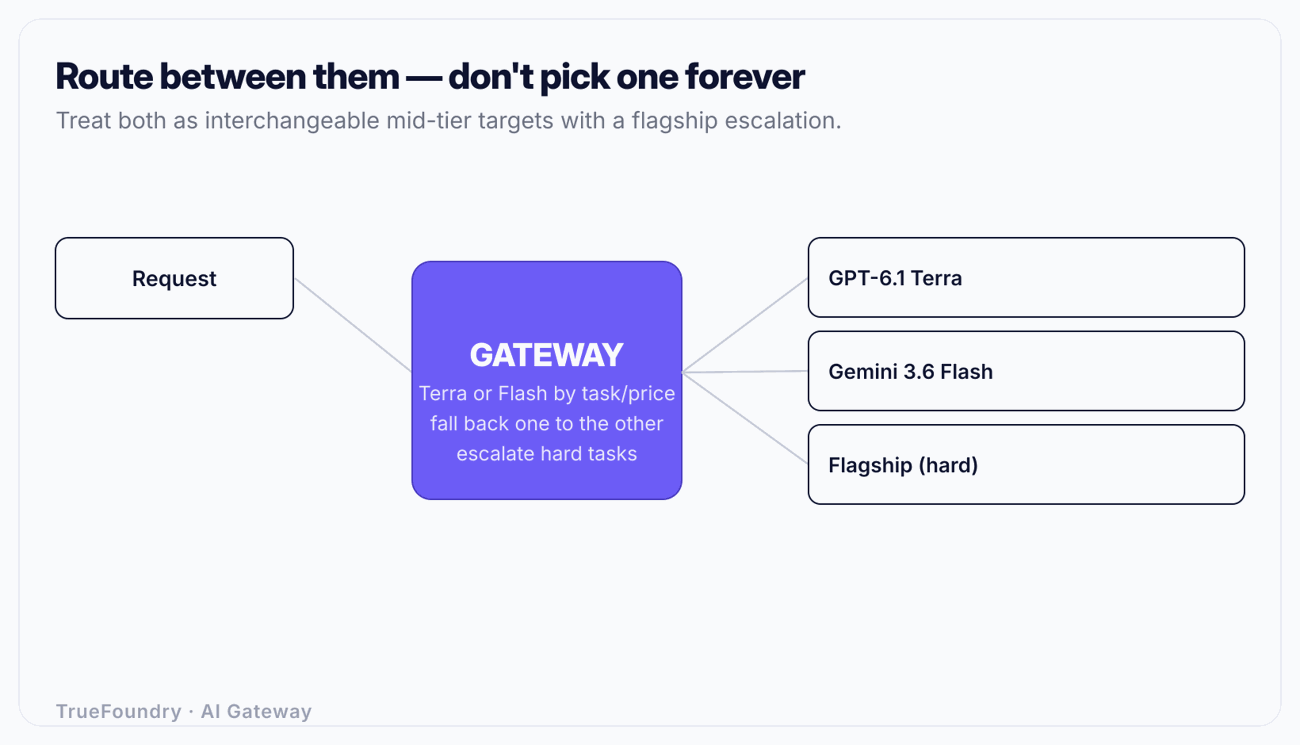
TrueFoundryが代替可能なモデルを1つのルーティングポリシーとして統合・管理する方法をご覧ください。デモを予約する。
価格およびベンチマークは2026年11月時点の報道に基づくものです。モデル仕様は頻繁に変更されるため、必ず各プロバイダーの公式価格ページでご確認ください。
多くの行において、単一のモデルを排他的に選ぶのではなく、2つのモデルをプライマリとフォールバックのペアとして指定している点に注目してください。これが設計意図です。固定の勝者を決めるのではなく、状況に応じて入れ替え可能な役割を割り当てるのです。
上記のポリシーを機能させるには、設定変更や管理のコストが低いことが前提となります。統一されたOpenAI互換APIを備えたAI Gatewayを使えば、それが実現できます。アプリケーションは固定されたエイリアスを呼び出し、Gateway側がTerra、Flash、あるいはフラグシップのいずれに送信すべきか、そしてエラー発生時にどう対処すべきかを判断します。
両モデルがエイリアス化されているため、将来GPT-6.2やGemini 3.7が登場した場合や、いずれかのモデルが値下げされた場合でも、設定ファイルを更新するだけで対応できます。ルーティングポリシーは柔軟に適応し、アプリケーションコードに変更を加える必要はありません。
月間400万件の中価格帯コーディングリクエストを処理する開発者ツール製品を例に考えてみましょう。このワークロードは出力比率が高く、1リクエストあたり平均入力600トークン、出力1,500トークンを消費します(コード生成は大量のトークンを出力します)。
このケースでは出力が大部分を占めるため、出力価格が総コストを左右する主要因となります。Terraの報告価格である出力1Mトークンあたり$5の場合、1リクエストあたりの出力コストは約$0.0075です。一方、Flashの報告価格である$7.50 / 1Mの場合、同じリクエストの出力コストは約$0.01125となり、約50%高くなります。月間400万件の規模では、この差額は無視できない金額になります。
しかし、Flashはコーディング精度がやや高く、処理速度も速いと報じられています。したがって、ポリシーは「すべてTerraにする」のではなく、次のように設計します。定型的な生成処理の大部分は出力単価の安いTerraにルーティングしてコストメリットを享受し、より難易度の高い処理や速度が求められるコーディングリクエストはFlashにルーティングします。そして、エラー発生時には互いへフォールバックさせます。運用を開始したら、オブザーバビリティツールでモデルごとのコストと品質を監視し、トラフィックの配分割合をチューニングします。自社のトラフィックでTerraの品質が十分維持できているならTerraの割合を増やし、Flashのコーディング能力によってリトライ回数が減っていることが確認できれば配分を見直します。これらを正確に把握するには計測が不可欠であり、だからこそルーティングとオブザーバビリティは別々のツールではなく、1つの統合システムとして運用する必要があるのです。
また、リトライの発生は単なる価格表の比較では見えてこない影響を与えます。Terraの出力単価が33%安くても、間違った回答を出力して再呼び出しが発生する確率がFlashより5%高ければ、リトライによる課金が2重に発生するため、価格面の優位性は相殺されてしまいます。表面的な単価比較だけでは不十分であり、呼び出しあたりの単価ではなく「成功したレスポンスあたりの実効コスト」を測定しなければならないのはこれが理由です。名目的には安価であってもリトライ回数が多くなるモデルは、最終的な実利用コストが高くつく可能性があります。これを見抜く唯一の方法は、自社のリクエストに対するコストと失敗率の両方をモデル別にトラッキングできるオブザーバビリティを導入することです。
なお、エスカレーションによって意図しない過大請求が発生するのを防ぐため、トークンレート制限と予算上限を設定してフラグシップ階層にキャップを設けておきます。これにより、予期せぬ請求の代わりにHTTP 429エラーを返して制限をかけることができます。
GPT-6.1 TerraとGemini 3.6 Flashは、一方が他方を打ち負かすような決闘関係にはありません。これらは互いに代替可能な中価格帯の実用モデルであり、価格差は3割程度の中に収まり、ともに約100万トークンのコンテキストを保持しています。そして、Terraは「価格」、Flashは「コーディング性能と処理速度」という、それぞれ微細な強みを持っています。モデル同士がこれほど接近している場合、検討すべきは「どちらを王者に選ぶか」ではなく「いかにして両方を巧みに使い分けるか」です。
タスクの特性とコストに応じて両モデル間でルーティングを行い、エラー時にはお互いにフォールバックさせることで、コストをほとんどかけずにプロバイダーの冗長性を確保します。そして、本当に難度の高い処理のみをフラグシップモデルへエスカレーションさせます。これらすべてを、単一のOpenAI互換APIの背後にあるGateway上のポリシーとして定義しておけば、将来どちらかのプロバイダーが新しいリリースや値下げを行っても、システムの移行作業をすることなく設定変更だけで即座に対応できます。これこそが、特定のインフラやプロバイダーに依存することなく、両者の強みを最大限に活用する方法です。
単一モデルの選定から脱却し、TerraとFlashの柔軟なルーティングを始めましょう。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












