


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
ほとんどのチームにおいて、問題になるのはフラグシップモデルではありません。「デフォルトモデル」の選択こそが問題です。中央値のリクエストに応答するモデル、つまりチャットのロングテール、要約、日常的なコーディング、RAGによる回答を処理するモデルこそが、ボリュームが集中するため実際の請求額を押し上げる要因となります。Gemini 3.6 Flashが注目されるのはまさに、このデフォルトのポジション向けに設計されているからです。ユーザーがフラグシップからのダウングレードを感じないほど十分な性能を持ち、大量のトラフィックをそのまま流し込めるほど低価格です。
本記事では、Gemini 3.6 Flashとは何か(2026年11月時点での報告内容)、超低価格の小型モデルとフラグシップモデルの間のどこに位置づけられるのか、どのような場合に選択し、どのような場合に選択すべきでないか、そして、真に高度な処理を必要とするリクエストのみを昇格させながら、これをデフォルトとして活用するためのゲートウェイパターンについて解説します。
あらかじめ正確性についてお断りしておきます。Claudeの数値を除き、以下の仕様はサードパーティのレポートや時に相反する情報源に基づいています。これらは出発点として扱い、構築を進める前にGoogleの公式モデルおよび価格設定ページで検証してください。モデルの仕様は頻繁に変更されます。
トラフィックの大部分をFlashクラスモデルにルーティングし、難度の高いリクエストのみを昇格させたいとお考えですか?デモを予約する。
Gemini 3.6 Flashは、GoogleのGemini 3.xラインナップにおける中位ティアの速度最適化モデルとして、2026年7月頃にリリースされたと報告されています。報告されているスペックのプロファイルは以下の通りです:
1行でまとめるなら:主力フラグシップの日常的な有用性の大部分を、中価格帯で提供し、フラグシップ級のコンテキストと高いスループットを備えたモデルです。この組み合わせこそが、まさにデフォルトモデルがあるべき姿です。
価格設定/ベンチマークは2026年11月時点で報告されているものです。モデルの仕様は頻繁に変更されるため、使用する前に各プロバイダーの公式価格ページで確認してください。
お使いのアカウントや地域で 3.6 Flash がまだ表示されない場合、安全で一般提供されている(GA)フォールバックは Gemini 3.5 Flash です。3.6 を直接確認できるまでは、3.6 をターゲットとし、3.5 GA をバックストップとして扱ってください。
Flash を考える上で有用なのは、3段のはしごの中央の段として捉えることです。その下には超低価格層が存在します。その上にはフラグシップが存在します。それぞれの段には役割があります。
超低価格層(入力およそ $0.10–$0.25)。 Claude Haiku 5.5 は $0.10 / $0.50 からと確認されています。報告されている GPT-6 Luna は $0.10 / $0.50、Gemini 3.1 Flash-Lite は $0.25 / $1.50 付近に位置します。これらは分類、抽出、ルーティング、その他の短く明確なタスク用です。入力価格では Flash よりおよそ15倍安価です。能力は高くありませんが、それを目指して作られているわけではありません。
Flash 級ワークホース(入力およそ $1–$2)。 Gemini 3.6 Flash は報告価格 $1.50 / $7.50 であり、同等レベルの Claude Sonnet 5.5(確認済み $2 / $10)や報告されている GPT-6.1 Terra($1 / $5)と並びます。これがデフォルトの層です:チャット、要約、RAG の回答、日常的なコーディングなど、真の能力を必要とするものの、最も深い推論までは必要としないあらゆるタスクが含まれます。
フラグシップ層(入力およそ $2–$10、高出力)。 Gemini 3.1 Pro(報告価格 $2 / $12)、Claude Opus 5.5(確認済み $4 / $20)、報告されている GPT-6 Astra($10 / $50)。これらがその価格に見合う価値を発揮するのは、長期スパンのエージェント型コーディング、深い推論、困難な分析といった高度で難易度の高い一部のタスクのみです。

このはしごのポイントは、各段が価格または能力のいずれかにおいて約1桁離れているため、リクエストを間違った段に送ると、一方向ではコストが高くなり、もう一方向では品質が低くなる点です。Flash は、ほとんどのトラフィックが属すべき段です。
Flash は適切なデフォルトですが、すべてに対する適切な正解ではありません。判断基準は以下の通りです。
料金/ベンチマークは2026年11月時点で報告されている内容です。モデルの仕様は頻繁に変更されるため、利用前に各プロバイダーの公式価格ページで確認してください。Claudeに関する数値は一次情報として確認済みです。
TrueFoundryがどのように安価なモデルをデフォルトに設定し、自動的にフォールバックするかをご確認ください。デモを予約する。
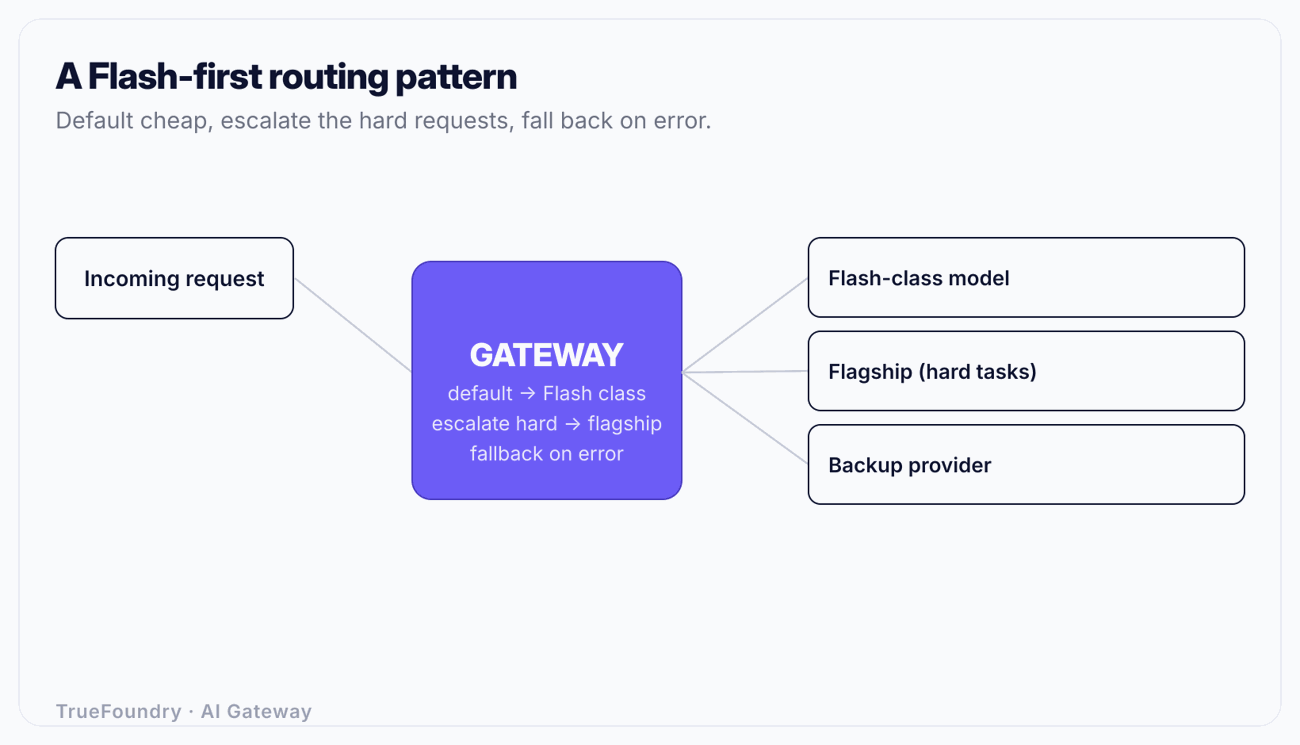
Flashをデフォルトにすべきだと知っているだけでは十分ではありません。トラフィックの大部分をFlashに送信し、より高い能力を必要とするリクエストを認識してそれらのみをエスカレーションし、Googleで数分間の障害が発生しても失敗しない仕組みが必要です。その仕組みが、統合されたOpenAI互換APIを備えたAIゲートウェイです。
以下は4つのステップによるパターンです。
1. Flashをデフォルトルートにする。ゲートウェイの設定でモデルエイリアス(例えばdefault-chat)をGemini 3.6 Flashにポイントします。アプリケーションはdefault-chatを呼び出し、「gemini-3.6-flash」をハードコードすることはありません。代わりにSonnet 5.5やTerraをデフォルトとしてテストしたい場合は、設定を1行変更してトラフィックの割合を移行するだけで済み、アプリケーションのデプロイは不要です。これは実践におけるコストと品質を意識したモデル選択であり、その根本にある考え方がLLMルーターの役割です。
2. 難しいリクエストをエスカレーションする。より高い処理能力を必要とするリクエスト(アプリからの複雑さのシグナル、特定のエンドポイント、確信度の低い回答の後の再試行など)にタグを付け、ゲートウェイがそれらをフラグシップのエイリアスにルーティングするようにします。ほとんどのトラフィックはFlashに残り、難易度の高いわずかなリクエストのみがフラグシップの料金を支払います。この制御は、サービス全体に分散されたコードの分岐ではなく、ルーティングルールとして機能します。
3. エラー時にフォールバックする。Googleがエラーを返したりタイムアウトしたりした際に、Flashが2番目のプロバイダーにフォールバックするように設定します。Flashクラスのリクエストは、Claude Sonnet 5.5やGPT-6.1 Terraにフォールバックできます。リクエスト内の再試行とプロバイダーのフォールバックにより、プロバイダーのインシデントは障害ではなく、一時的なレイテンシの増加にとどまります。詳細はLLMのフォールバックとは何かを参照してください。
4. キャッシュと計測。完全一致キャッシュおよびセマンティックキャッシュにより、同じ質問に対して二重にFlashへの支払いを発生させないようにします。詳細はセマンティックキャッシュを参照してください。また、すべての呼び出しはユーザー、チーム、モデルごとにタグ付けされたトークン、レイテンシ、コストとともに記録されるため、Flashが処理量を維持し、フラグシップが難易度の高い部分のみに対応していることを証明できます。詳細はLLM可視性ツールを参照してください。
月に500万リクエストを処理するプロダクトを例に挙げます。大部分はチャットとRAGで、一部に複雑な推論を必要とする難易度の高いロングテールが存在します。内訳が日常的な処理75%(Flashに適している)、軽微な処理20%(最安値モデルに適している)、高度な処理5%(フラグシップに適している)で、平均800入力トークンおよび400出力トークンであると仮定します。
すべてを$2 / $12のフラグシップで実行した場合、Flashで同様に回答できた375万リクエストや、$0.10のモデルでまったく同じように回答できた100万リクエストを含む、すべての500万リクエストに対してフラグシップの出力料金を支払うことになります。
代わりにティアごとにルーティングします:
20%の軽微な処理の層は、Flashから最安値ティアに変更することで、入力コストを約15分の1に削げます。75%の日常的な処理の層は、フラグシップの出力($12)からFlashの出力($7.50)へ下がり、主要なコスト要素を約40%削減できます。5%の高度な処理の層のみフラグシップを維持します。実際のトークン構成における最終的な効果として、いずれのティアでも品質を落とすことなく、全体の請求額を3分の1以上削減できます。これは、すべてのリクエストが適切なサイズのモデルに届いているためです。この数値を確認するにはティアごとのコスト計測が不可欠であり、だからこそ可視性とコストアトリビューションの仕組みがルーティングと同等に重要となります。
高度な処理の層が予算を静かに圧迫するのを防ぐため、トークンレート制限と予算設定で上限を設けます。チームやモデルが上限を超えるとゲートウェイがHTTP 429を返すため、エスカレーションパスによって支出が無制限に膨らむのを防ぐことができます。
Gemini 3.6 Flashは、支出の大部分を占める中央値のリクエストを処理するために構築されています。1Mのコンテキストウィンドウと高いスループットを備え、報告されている$1.50 / $7.50という価格設定により、フラグシップの価格を支払うことなく日常的な有用性の大部分を提供します。また、軽微なジョブを処理すべき最安値ティアよりも明らかに一段上の性能を持っています。適切な思考モデルはラダー(梯子)であり、Flashは大部分のトラフィックが収まるべき段に位置しています。
これをゲートウェイのデフォルト設定にし、難度の高いリクエストのみをフラッグシップモデルにエスカレーションし、Googleがダウンした際はセカンドプロバイダーにフォールバックし、モデルごとのコストを測定して振り分けが機能していることを証明します。これを行うことで、「Gemini 3.6 Flashを使用する」という判断は単発の決定ではなくなり、次のモデルや次の値下げが行われた瞬間に調整可能なルーティングポリシーになります。
十分な性能を持つ最も安価なモデルへルーティングします。 デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












