


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
「コーディングに最適なLLMは何か?」という問いは、安定した答えが存在しないため不適切です。クリーンな40行の関数を書くモデルは、30ファイルに及ぶリファクタリングでトークンを消費させたいモデルとは異なりますし、複雑なコンカレンシーバグを解決するモデルは、ゲッターの自動補完にはオーバースペックです。ベンチマークは数週間ごとに順位が入れ替わります。1月に1つのモデルをツールチェーンにハードコードしたチームは、4月にはその決定を再検討することになります。
より適切な質問は、「このクラスのコーディングタスクにおいて、この予算内で、どのモデルにルーティングすべきか — そして、100人のデベロッパーがそれぞれ異なる判断をしたときに、どのようにコストとセキュリティを管理下に置くべきか?」 ということです。本記事はこの質問にお答えします。各競合モデルが得意とする分野を解説し、単一のベンチマークにとらわれないタスク別モデル選定フレームワークを提示します。さらに、多くのチームが見落としがちな部分である、モデルの選択をコードの書き換えではなく設定値として扱うためのルーティングおよびガバナンス層について解説します。
あらかじめ正確性に関する注記を差し上げます。以下のAnthropicのClaudeの価格設定は2026年11月時点で確認されたものです。競合他社のベンチマーク数値は報告または集計された数値です。出所と日付を明記していますが、実際に資金を投入する前に各ベンダーで再確認することをお勧めします。
すべてのコーディングモデルにおいてデベロッパーごとのコスト追跡とガードレールを設定したいですか? デモを予約する。
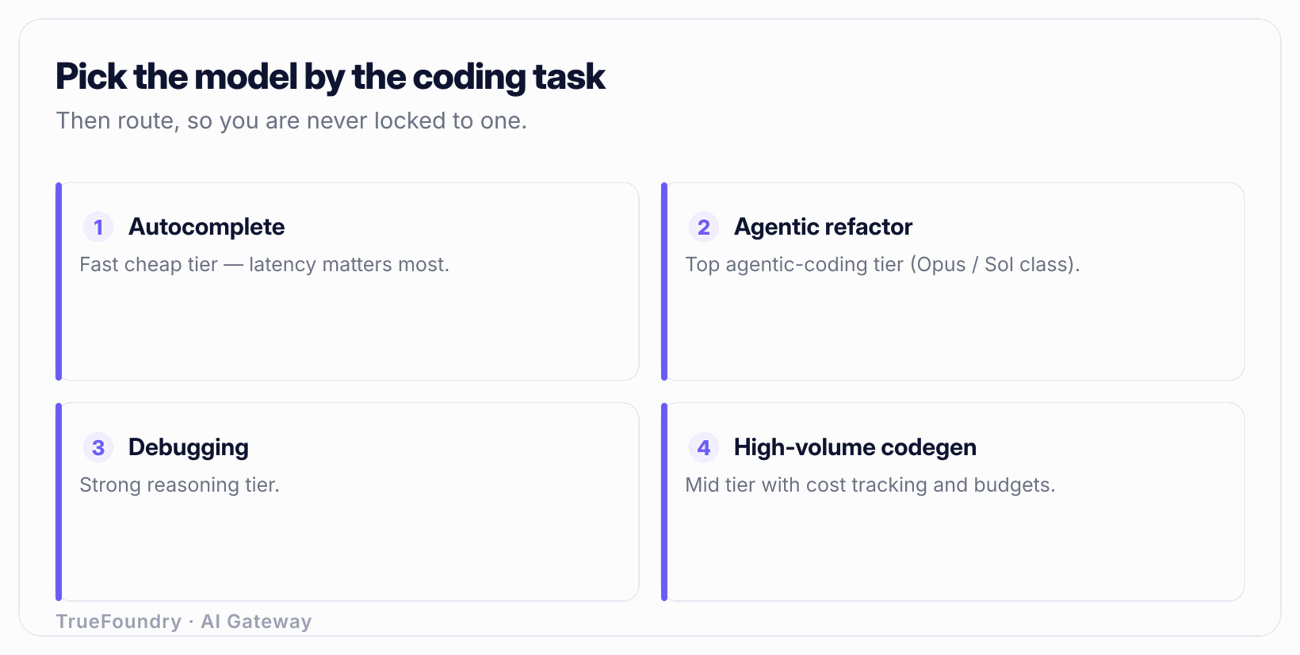
モデルを選択する前に、タスクの性質を明確にする必要があります。「最適なコーディングLLM」の比較の多くが失敗するのは、相反する要件を持つタスクを平均化してしまうためです。コーディングを4つのパターンに分解すると、選択は非常に明確になります。
オートコンプリート / インライン補完。 タイピング中にモデルが次の数行を予測します。レイテンシがすべてであり、おおむね300〜500msを超えると開発のフローが妨げられます。コンテキストは小規模です(現在のファイルと周辺の数ファイル)。デベロッパー1人あたり1日に数百〜数千回の呼び出しを行うため、単価が支配的になります。必要なのは最も賢いモデルではなく、高速で安価なモデルです。
エージェントによる複数ファイルのリファクタリング。 モデルが計画を立て、多くのファイルを読み込み、複数を編集し、テストを実行し、イテレーションを行います。このループは数分間実行され、単一のタスクで数万から数十万のトークンを消費することがあります。ここでは、推論の深さ、長文コンテキストにおける一貫性、そして多くのステップにわたって計画を維持する能力が真価を発揮します。また、性能の低いモデルが最も高くつくケースでもあります。試行錯誤でトークンを浪費した挙げ句、壊れたDiffを出力するためです。
高度なデバッグ。 レースコンディション、メモリーリーク、高負荷時にのみ発生するハイゼンバグなど、1つの難解な問題に対する作業です。タスクのボリュームは少ないものの、正解を得る価値は高くなります。最大限の推論品質が求められ、インシデントごとにコストを支払う価値があります。
大量のコード生成。 スキャフォールディング、ボイラープレート、テストスタブ、マイグレーションスクリプト、docstringなど、大量のシンプルなコード。品質に対する要求は中程度であり、スループットと生成あたりのコストが最重要となります。通常、総所有コスト(TCO)の観点からはミッドティアモデルが優れています。
これらの4つの形状が1つのモデルに収まることは滅多にありません。同じ開発者が、同じ時間内に、補完には高速で安価なモデルを、行き詰まっているバグには深い推論モデルを、バックグラウンドで開始したリファクタリングには強力なエージェントモデルを求めています。これこそが、単一モデルの標準化が失敗する構造的な理由です。
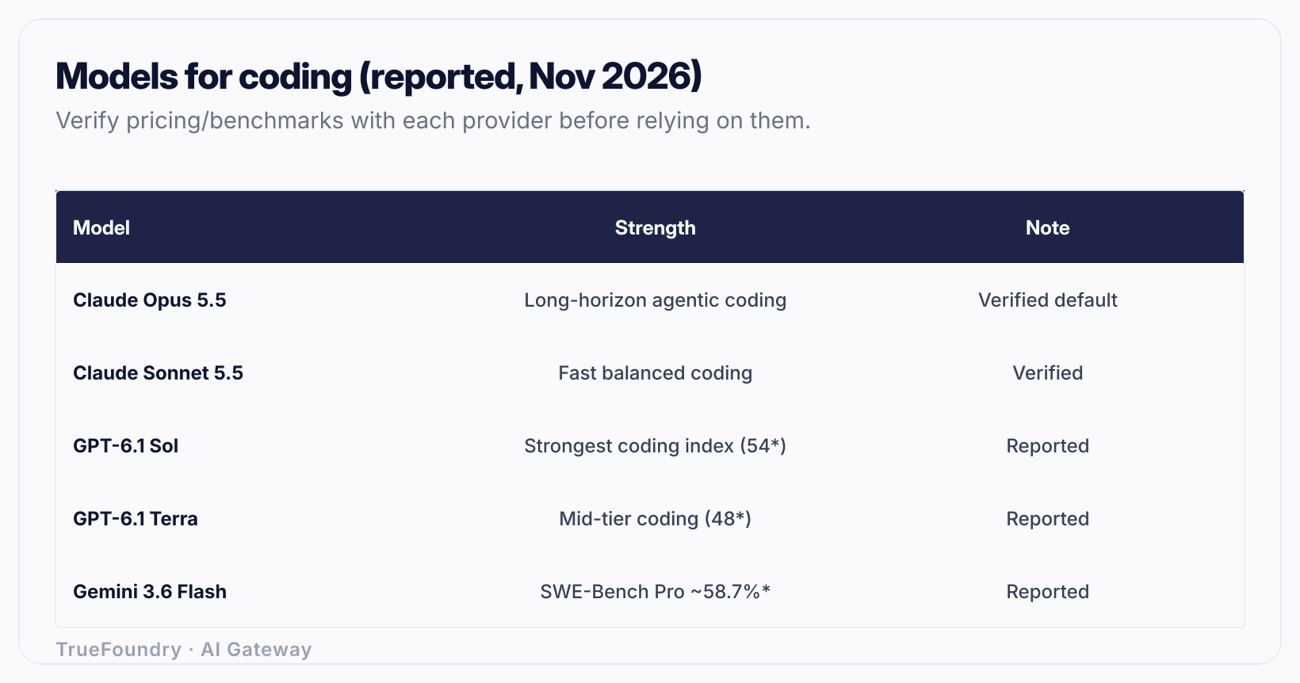
2026年11月時点の正直な現状は以下の通りです。Claudeの価格設定は確認済みですが、その他は報道ベースであり、再確認が必要です。
Claudeの5.5世代は、上記のタスク形状ごとに明確に分割されています:
実践的なパターンは、Claude単体内部での階層化戦略です。補完と大量処理にはHaiku、ほとんどのエージェント作業にはSonnet、難易度の高いリファクタリングと行き詰まったデバッグセッションにはOpusを使用します。
2026年11月時点の報道によると、GPT-6.1 Solは一般的なコーディング能力の頂点に位置し、アグリゲーターの「Coding Index」は約54であり、GPT-6.1 Terraは少し遅れておよそ48となっています。Solは最先端のコーディングモデルとして、Terraはより高速で安価なティアとして位置づけられています。インデックスの数値は単一の標準化されたテスト環境からではなく、サードパーティの集計によるものであるため、指標として捉えてください。また、予算を確定する前に、OpenAI独自の価格設定とティア名を同社サイトで確認する必要があります。
Gemini 3.6 Flashは、実際のリポジトリに対するリアルなプルリクエストスタイルの修正を測定するベンチマークであるSWE-Bench Proで約58.7%を記録したと報じられています。その数値が正しければ、Flashはスピードとコストに位置づけられたティアでありながら、実践的なソフトウェアエンジニアリングタスクにおいて競争力があります。繰り返しになりますが、これらは2026年11月時点の報道であるため、Googleで確認してください。
SWE-Benchやコーディングインデックスは、厳選された問題に対して正確なパッチを生成するモデルの能力を測定します。それらは、あなたのエージェント内、あなたのコードベース上、そしてあなたのツールとコンテキスト制限の下でモデルがどのように動作するかを測定するものではありません。公開ベンチマークで2ポイント高くスコアを獲得したモデルであっても、処理が遅かったり、有効なコンテキストウィンドウが小さかったり、使用している言語やフレームワークの処理が不十分だったりすると、実際の実務では大きく劣る可能性があります。ベンチマークを使用して候補リストを作成し、実際の作業に類似したタスクで独自の評価を行ってください。
報道されている現状を1つの表にまとめました。これらの数値を引用する前に、下部の注意事項をお読みください。
ご注意: Claudeの価格は2026年11月時点のものです。競合他社の数値はすべて2026年11月時点の報告済または集約されたサードパーティの数値であり、異なるハーネス間での直接比較はできません。これらに依存する前に、各ベンダーで仕様、利用可能性、価格を再確認してください。
「最高のモデル」を1つ選ぶのではなく、タスクの形状ごとのデフォルトとエスカレーションパスを選択してください。これが、来月リーダーボードが入れ替わっても変わらない重要な考え方です。
論理はシンプルです。確実に成功する最も安いティアで各タスクを開始し、テストの失敗、ディフ(差分)が大きすぎる、エージェントがループしているなど、具体的なシグナルがある場合にのみエスカレーションします。中位ティアのモデルが10回の高コストなイテレーションを行って失敗するようなリファクタリングも、2回で完了させる最上位ティアのモデルを使った方が結果的に安上がりです。一方で、最上位モデルが完璧にこなす補完処理であっても、それを毎日1万回も呼び出すのであれば、そこにコストをかけるべきではありません。
このフレームワークが運用面で何を求めているかに注目してください。アプリケーションを書き換えることなく、タスクの種類やシグナルに基づいて、異なるリクエストを異なるモデルに送信できる能力です。これこそがルーティングであり、ゲートウェイの出番です。このロジックがどのようにエンコードされるかについては コストと品質を考慮したモデル選択 を、その仕組みについては LLM ルーターとは を参照してください。
TrueFoundry がコーディングトラフィックをルーティングし、開発者ごとの支出を制限する方法をご覧ください。デモを予約する。
開発者200人規模の組織を思い浮かべてみてください。Cursor を使う人もいれば、Claude Code を使う人もおり、VS Code の Copilot を愛用する人も数人いて、データチームはノートブックから直接モデルを呼び出しています。ツールごとにデフォルトのモデルが異なり、開発者ごとにそれぞれのこだわりがあります。今日、単一のモデルを強制したとしても、6週間後にはより優れたモデルが出荷され、優秀なエンジニアたちはその強制を回避して新しいモデルを使い始めるでしょう。
これは規律の欠如ではありません。これが正しい最終状態なのです。タスクによって適したモデルは異なり、ツールによって公開されるモデルも異なり、フロンティアは毎月移動します。その断片化と戦うのは敗北への道です。勝利への手立ては、モデルを標準化しようとするのをやめ、代わりにモデルの手前にあるコントロールポイントを標準化することです。
具体的には、組織内のすべてのコーディングエージェント(Claude Code、Cursor、Copilot、自作スクリプトなど)が、各ベンダーの API を直接呼び出すのではなく、1つの OpenAI 互換エンドポイントを指すようにすることを意味します。そのエンドポイントの背後で、ルーティングを決定し、すべてのリクエストを可視化し、ポリシーを適用します。モデルは単なる設定値となります。Sonnet をより新しいモデルに差し替えたり、デバッグのエスカレーション先として GPT-6.1 Sol を追加したりすることは、全社規模のコード移行ではなく、設定の変更だけで済みます。
AI ゲートウェイ は、コーディングエージェントとモデルプロバイダーの間に位置し、統一された OpenAI 互換 API を提示します。特にコーディングにおいては、4つの機能が重要となります。
開発者、チーム、モデルごとのコスト帰属。 コーディングエージェントは、財務チームが驚くほどのトークンを消費します。エージェントによるリファクタリングは、1つのタスクで300,000トークン以上を消費することがあります。コスト帰属の仕組みがないと、プロバイダーからの1枚の区別のつかない請求書が届くだけで、その支出がプラットフォームチームのリファクタリングによるものなのか、1人の開発者の暴走ループによるものなのかが分かりません。ゲートウェイはすべてのリクエストにユーザー、チーム、モデルのタグを付けるため、「誰がどのモデルにいくら使ったか」をリクエスト単位まで回答できます。これは、コスト帰属とチーム予算、そして一般的な AI のための FinOps の基盤となります。
開発者またはチームごとの予算とレート制限。 チームごとの月額ドル予算と、開発者ごとのリクエストレート制限を設定します。制限を超えると、ゲートウェイはサイレントに請求額を膨らませるのではなく、HTTP 429 を返します。これにより、設定ミスがあったエージェントのループが、一晩で5桁の驚くべき請求額に化けるのを防ぎます。このメカニズムについては トークンレート制限と予算設定 で解説しています。
シークレット漏洩に対するガードレール。 コーディングエージェントはソースコードを読み取ります。ソースには、ハードコードされた認証情報、内部ホスト名、フィクスチャ内の顧客データ、テストファイル内の PII(個人識別情報)が含まれています。これらはすべて、プロンプトに含まれてモデルプロバイダーに送信される可能性があります。ゲートウェイは、送信リクエストをスキャンしてシークレットや PII を検出し、ネットワークから出る前にブロックまたはマスキングできます。規制の厳しい組織にとって、これは多くの場合、「承認」か「禁止」かを分ける決定的な違いとなります。検出タイプについては AI ガードレール を参照してください。
監査とオブザーバビリティ。 誰が、どのモデルを、何トークン使い、レイテンシ、コスト、ガードレールの合否はどうだったかという、すべてのリクエストの単一のログトレイル。セキュリティチームから「前四半期に当社のコードが外部モデルに漏洩したか」と尋ねられたとき、肩をすくめる代わりに明確な回答を出せます。ゲートウェイのログを LLM オブザーバビリティツール と連携させることで、レイテンシや品質の経時的な追跡が可能になります。
TrueFoundry の AI ゲートウェイは、まさにこのコントロールプレーンを提供します。レイテンシ/加重/優先度ルーティング、自動フォールバックとリクエスト内リトライ、完全一致およびセマンティックキャッシュ、ユーザー/チーム/モデルごとの予算とレート制限、完全なリクエスト単位のオブザーバビリティ、PII/シークレット/プロンプトインジェクションガードレールを備えた、統一された OpenAI 互換 API です。SaaS、お客様の VPC、オンプレミス、またはエアギャップ環境にデプロイできるため、ソースコードを運ぶデータプレーンはネットワーク内部に保持されます。
具体的に考えてみましょう。3人の開発者が1週間、異なる作業を行ったとします。
3人の開発者、3つのタスク形状、3つのティアで、週の合計支出は約 $40 に収まりました。開発者 C のディープリファクタリングのコストは、開発者 A の補完の約14倍です。ここで、帰属追跡なしで200人の開発者がいる場合を想像してみてください。1枚の請求書を見るだけで、価値のある使用なのか暴走なのか判別できません。ゲートウェイがあれば、開発者 C のリファクタリングは高コストだったがそれだけの価値があったこと、開発者 A の補完は効率的であること、そして4人目の開発者のエージェントが午前2時にループし始めた場合でも、予算キャップによって問題になる前に 429 でストップがかかることが分かります。
上記の数値は説明のために検証済みの Claude の価格設定と概算数値を使用しています。実際のトークン数は異なります。重要なのは構造です。タスクの形状がティアを動かし、ティアがコストを動かし、帰属追跡によって恐ろしい総額が管理可能なラインアイテムへと変わるのです。
リーダーボードを追いかけること。 チームはベンチマークが更新されるたびに「最高のコーディングモデル」を選び直し、そのたびにツールの設定を再構築します。ベンチマークの差分は通常、切り替えにかかるコストよりも小さいものです。タスクの形状ごとにデフォルトを選択してルーティングし、モデルの変更は設定としてゲートウェイに吸収させましょう。
すべてを最上位モデルにルーティングすること。 自動補完に Opus 5.5 や GPT-6.1 Sol を使用するのは安全に思えますが、静かに壊滅的な結果をもたらします。最も量が多く、最も価値の低い呼び出しにフロンティアモデルの価格を支払うことになるからです。ティアをタスクに適合させてください。確実に成功する最も安いモデルが正解です。
請求書が届くまでコストの帰属追跡を行わないこと。 多くのチームは、財務チームからエスカレーションを受けて初めてコーディングエージェントの支出に気づきます。その時点では、どのチームやどの行動が原因なのか特定できません。帰属追跡は、シート数を拡大した後ではなく、拡大する前に整えておく必要があります。
コードからのシークレットや PII の流出を無視すること。 コーディングエージェントの最大のリスクは、間違ったコードではなく、正しいコードが漏洩することです。ソースファイルには認証情報や顧客データが含まれており、エージェントはそれらをサードパーティのモデルに送信します。送信ガードレールがない場合、シークレットを外部に漏洩させ、インシデントレビューになって初めてそれに気づくことになります。
モデルの選択をアプリケーション側の関心事として扱うこと。 モデル名や API キーを各ツールやサービスにハードコーディングすると、モデルを変更するたびにデプロイが必要になります。選択肢をゲートウェイエンドポイントの背後に配置することで、モデル選択は1回設定すればどこにでも適用されるポリシー決定へと変わります。
「コーディングに最適な LLM」は変わり続けるターゲットであり、それを追いかけるのは終わりなき作業です。永続的な戦略は、1つのモデルを選ぶのをやめ、ポートフォリオを管理し始めることです。補完や大量処理のための「安価で高速なティア」、日常的なエージェント作業のための「バランスの取れたティア」、そして高度なリファクタリングやディープデバッグのための「フロンティアティア」を用意し、それらの間に明確なエスカレーションシグナルを設定します。Claude の Opus/Sonnet/Haiku の組み合わせは、今日のこのフレームワークにほぼ1対1で対応しており、発表されている GPT-6.1 や Gemini の数値も、設定変更だけで組み込めるエスカレーションや比較の選択肢を提供してくれます。
そのポートフォリオをガバナンス可能にするのが、その手前に位置するレイヤーです。すべてのコーディングエージェントを1つの AI ゲートウェイ経由でルーティングすることで、モデル選択は設定値となり、コストは開発者やチームごとに帰属可能となり、予算設定によって暴走する支出を 429 で停止させ、ガードレールによってソースコードのシークレットがプロバイダーに漏洩するのを防ぐことができます。これこそが、請求書や影響範囲の管理を失うことなく、常にフロンティアに立ち続ける方法です。
単一のゲートウェイからコーディングエージェントのモデル利用をガバナンスします。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












