August 27, 2025
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: October 6, 202615
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Ollama ist eine Open-Source-Runtime für den Betrieb von LLMs auf Ihrer eigenen Infrastruktur – sei es ein Laptop, ein lokaler GPU-Server oder eine private Cloud-Instanz. Sie laden ein Open-Weight-Modell wie Llama, Mistral oder Qwen herunter, und Ollama stellt es lokal über einen HTTP-Endpunkt bereit. Entscheidend ist, dass dieser Endpunkt eine OpenAI-kompatible API verwendet, sodass Code, der für das OpenAI-SDK geschrieben wurde, mit nur einer Änderung der Basis-URL mit einem lokalen Ollama-Modell kommunizieren kann.
Teams entscheiden sich aus einigen klaren Gründen für Ollama:
Der häufigste Vergleich ist Ollama gegenüber vLLM, da beide OpenAI-kompatible APIs bereitstellen und beide Open-Weight-Modelle selbst hosten. Sie sind jedoch für unterschiedliche Anforderungen optimiert.
Kurz gesagt: Ollama ist die einfachste Lösung, um ein Modell für eine einzelne Person auszuführen, während vLLM darauf ausgelegt ist, viele gleichzeitige Benutzer mit hohem Durchsatz zu bedienen. Viele Teams nutzen beides: Ollama für die lokale Entwicklung und vLLM für die Produktion. Das Gute daran ist, dass beide OpenAI-kompatibel sind. Sie können also alles, worauf Sie sich standardisieren, hinter demselben Gateway betreiben und sogar zwischen den beiden Instanzen routen.
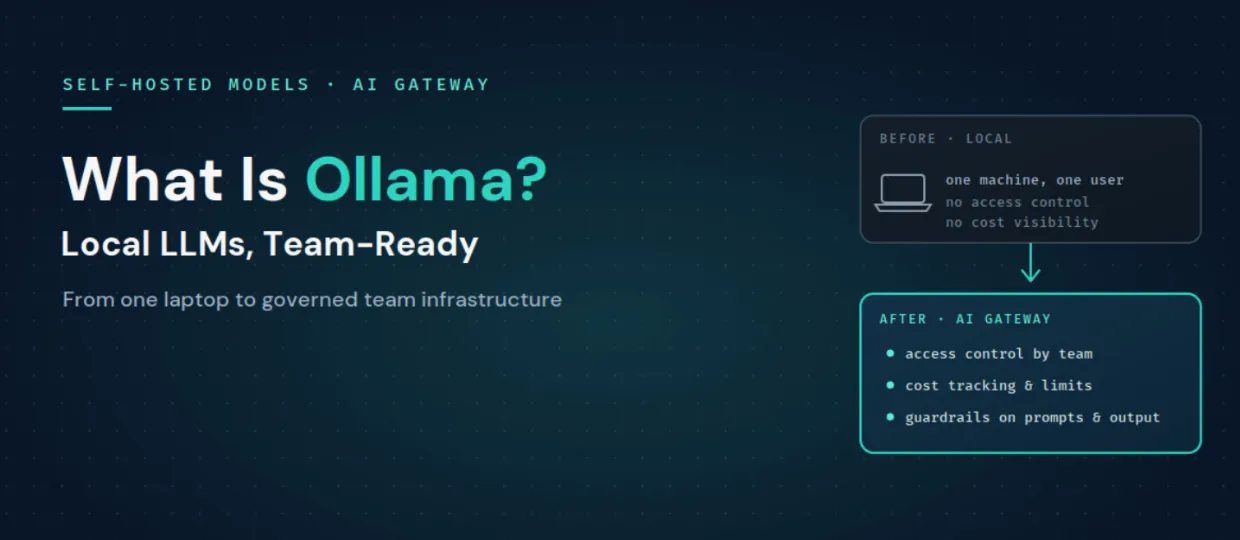
Ollama erfüllt seinen Zweck hervorragend, doch beim Einsatz in einem Unternehmen zeigen sich Lücken, die außerhalb seines Funktionsumfangs liegen.
Genau diese Probleme löst ein Gateway. So verwandeln Sie einen lokalen Modell-Runner in eine echte Infrastruktur für Ihr Team.
TrueFoundry behandelt einen Ollama-Server als selbst gehostetes Modell. Sie verbinden ihn mit dem AI Gateway indem Sie die Endpunkt-URL und die Authentifizierungsdaten angeben. Sobald das Modell registriert ist, erscheint es im Modellkatalog des Gateways neben den Cloud-Anbietern. Dabei stehen Ihnen alle Gateway-Funktionen zur Verfügung: Routing, Guardrails, Ratenbegrenzung, Kostenverfolgung und Observability. Ollama wird hier explizit unterstützt, da es eine OpenAI-kompatible API bereitstellt – das Format, mit dem das Gateway am besten arbeitet.
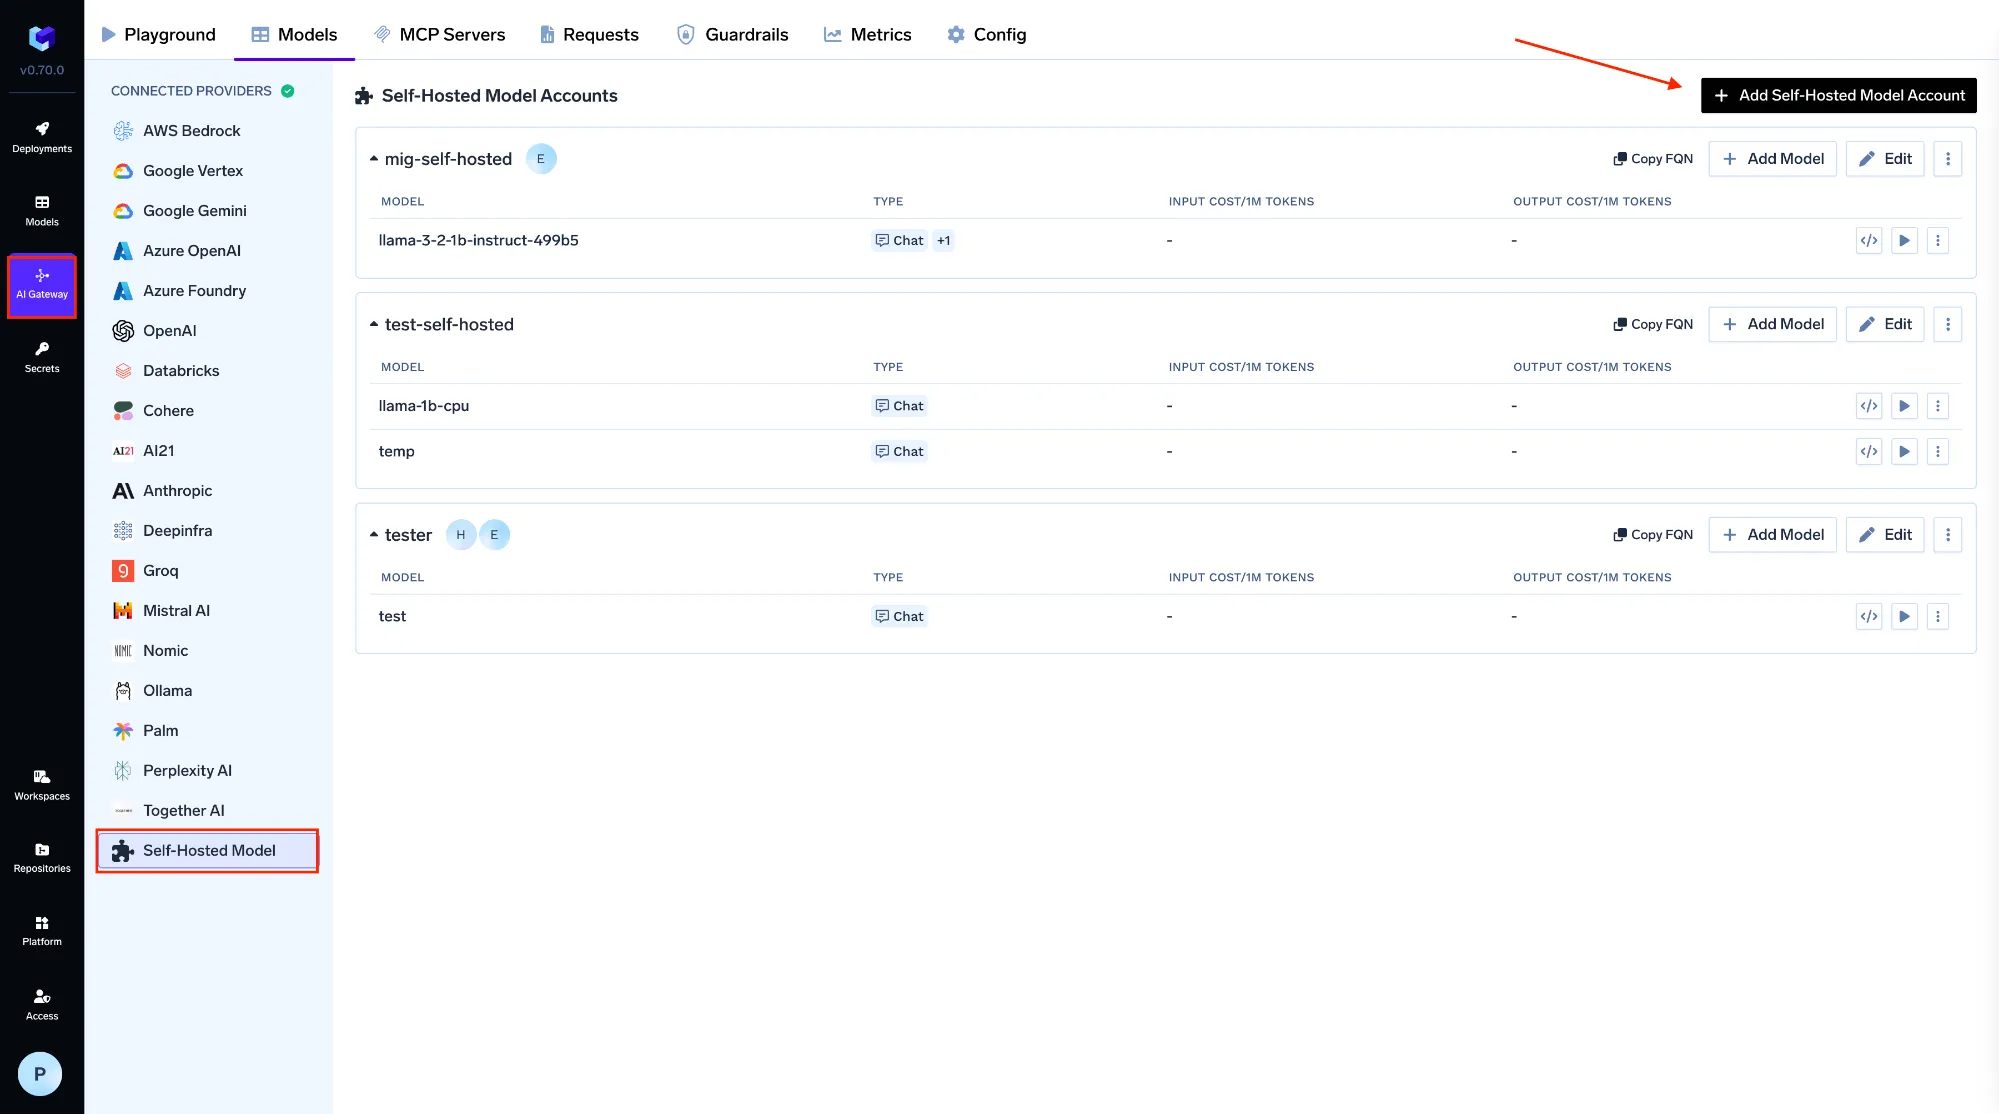
Sie registrieren das Modell unter „AI Gateway“, dann „Models“ und schließlich „Self Hosted Models“. Geben Sie einen Namen, eine Modell-ID, die URL Ihres Ollama-Servers sowie den Modellserver-Typ und optional die Authentifizierungsdaten an. Ab diesem Zeitpunkt kommunizieren Anwendungen und Agenten nicht mehr mit einem rohen Localhost-Endpunkt, sondern rufen das Gateway über eine einheitliche API auf:
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-api-key",   # a gateway token, not a raw endpoint
    base_url="https://gateway.truefoundry.ai",
)

resp = client.chat.completions.create(
    model="self-hosted/llama-3-8b-ollama",   # your registered Ollama model
    messages=[{"role": "user", "content": "Summarize this ticket"}],
)
Genau diese eine Änderung macht Ollama für Teams einsatzbereit:
Da das Gateway anbieterunabhängig ist und mit über 1.000 OpenAI-kompatiblen Modellen funktioniert, können Sie ein lokales Ollama-Modell mit einer vLLM-Bereitstellung und Cloud-APIs unter derselben Schnittstelle kombinieren. Dies knüpft direkt an die Portabilität von KI-Agentenan. Und da TrueFoundry in Ihrer eigenen VPC läuft, bleibt der Datenschutz, der Sie ursprünglich zu Ollama geführt hat, durchgängig gewahrt.
Ollama ist der schnellste Weg, um ein Modell lokal auszuführen, und in puncto Datenschutz und Kosten kaum zu schlagen. Es wurde jedoch nicht als Infrastruktur für Teams konzipiert – genau hier kommen Zugriffskontrolle, Kostentransparenz, Sicherheitsvorkehrungen und Routing ins Spiel. Verbinden Sie Ollama als selbst gehostetes Modell mit dem AI Gateway: So behalten Sie die Vorteile von Datenschutz und niedrigen Kosten bei und erhalten gleichzeitig alles, was ein Team für den produktiven Einsatz benötigt.
Erfahren Sie, wie TrueFoundry lokale Modelle in eine kontrollierte, teamfähige Infrastruktur verwandelt. Demo buchen oder kostenlos starten.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Ollama ist ein Open-Source-Tool, das große Sprachmodelle lokal auf Ihrer eigenen Hardware ausführt und sie hinter einer einfachen, OpenAI-kompatiblen HTTP-API bereitstellt. Teams nutzen es für private, offline betriebene und kostengünstige Inferenz mit Open-Weight-Modellen wie Llama, Mistral und Qwen.
Ollama ist für einfache lokale Inferenz auf einem einzelnen Rechner optimiert, während vLLM für produktives Serving mit hohem Durchsatz und hoher Parallelität gebaut ist. Beide stellen OpenAI-kompatible APIs bereit; viele Teams nutzen daher Ollama für die Entwicklung und vLLM für die Produktion und stellen beide hinter dasselbe Gateway.
Das Modell läuft auf einer Infrastruktur, die Sie kontrollieren, was gut für den Datenschutz ist; ein roher Ollama-Endpunkt hat jedoch keine Zugriffskontrolle, keine Kostenzuordnung und keine Inhalts-Guardrails. Um ihn im Team sicher zu nutzen, stellen Sie ihn hinter ein Gateway, das Authentifizierung, RBAC, Rate Limits sowie die Prüfung auf PII und Secrets ergänzt.
Binden Sie den Ollama-Server als selbst gehostetes Modell an ein AI Gateway an, indem Sie eine URL und die Authentifizierung angeben. Anwendungen rufen dann die einheitliche API des Gateways statt eines rohen Endpunkts auf, was Ollama um gemeinsame Zugriffskontrolle, Kostenverfolgung, Guardrails und Routing ergänzt.
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass die lokale, private Inferenz, die Ollama Ihnen bietet, im gesamten Stack privat bleibt.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet