


November 21, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
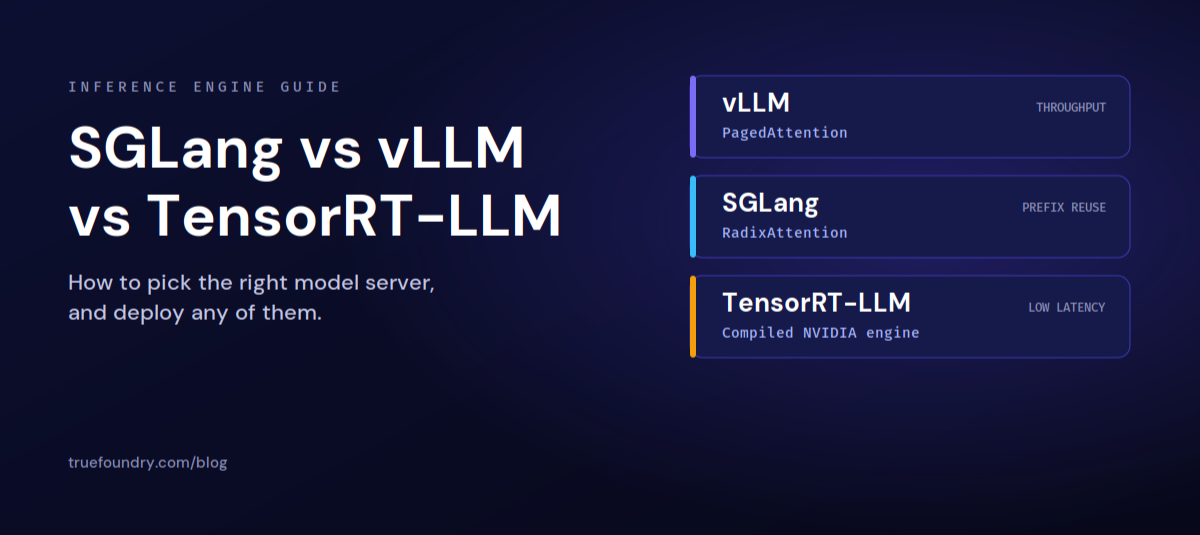
Die Inference Engine entscheidet darüber, wie effizient Ihre GPU Tokens ausgibt. Dasselbe Modell auf derselben Hardware kann je nach Engine und der Abstimmung von Batching und Caching sehr unterschiedliche Durchsätze, Latenzen und Kosten liefern.
Es gibt keinen universellen Gewinner. vLLM, SGLang und TensorRT-LLM werden alle aktiv weiterentwickelt und konvergieren bei vielen Techniken, darunter Continuous Batching, Paged KV Cache, Prefix Caching und Quantisierung. Die richtige Wahl hängt von Ihrem Modell, der GPU, den Sequenzlängen, der Batch Size und der Concurrency ab.
vLLM basiert auf PagedAttention, das den Attention Key-Value Cache in nicht zusammenhängenden Seiten verwaltet, ähnlich wie ein Betriebssystem den virtuellen Speicher steuert. Das reduziert die Speicherfragmentierung und ermöglicht es dem Server, mehr parallele Sequenzen auf einer einzelnen GPU unterzubringen.
Es ist eine starke Allround-Wahl für High-Throughput-Serving mit Continuous Batching, breiter Modellabdeckung und einem einfach zu nutzenden OpenAI-kompatiblen Server. Wählen Sie vLLM, wenn Sie eine breite Modellunterstützung und soliden Durchsatz ohne Compilierungs-Schritt suchen. Für genauere Einblicke lesen Sie unseren vLLM Explainer.
SGLang basiert auf RadixAttention, das den KV Cache über Requests hinweg, die ein Präfix teilen, mithilfe eines Radix-Baums wiederverwendet. Das kommt Workloads mit starkem Prompt-Sharing zugute, etwa Few-Shot Prompts, langen gemeinsamen System-Prompts, agentischen Multi-Turn-Unterhaltungen und Tree-of-Thought.
Zudem liefert es schnelle, zuverlässige strukturierte Ausgaben, einschließlich JSON-, Regex- und Grammatik-beschränktem Decoding, was komplexen Prompting- und Tool-Calling-Pipelines hilft. Greifen Sie zu SGLang, wenn Prefix Reuse und constrained Generation Ihren Traffic dominieren.
TensorRT-LLM ist die NVIDIA-Bibliothek, die Modelle in optimierte Engines für ein spezifisches GPU-Ziel compiliert. Dazu nutzt sie Fused Kernels, optimierte Attention, Quantisierung auf unterstützter Hardware und In-Flight Batching über Triton.
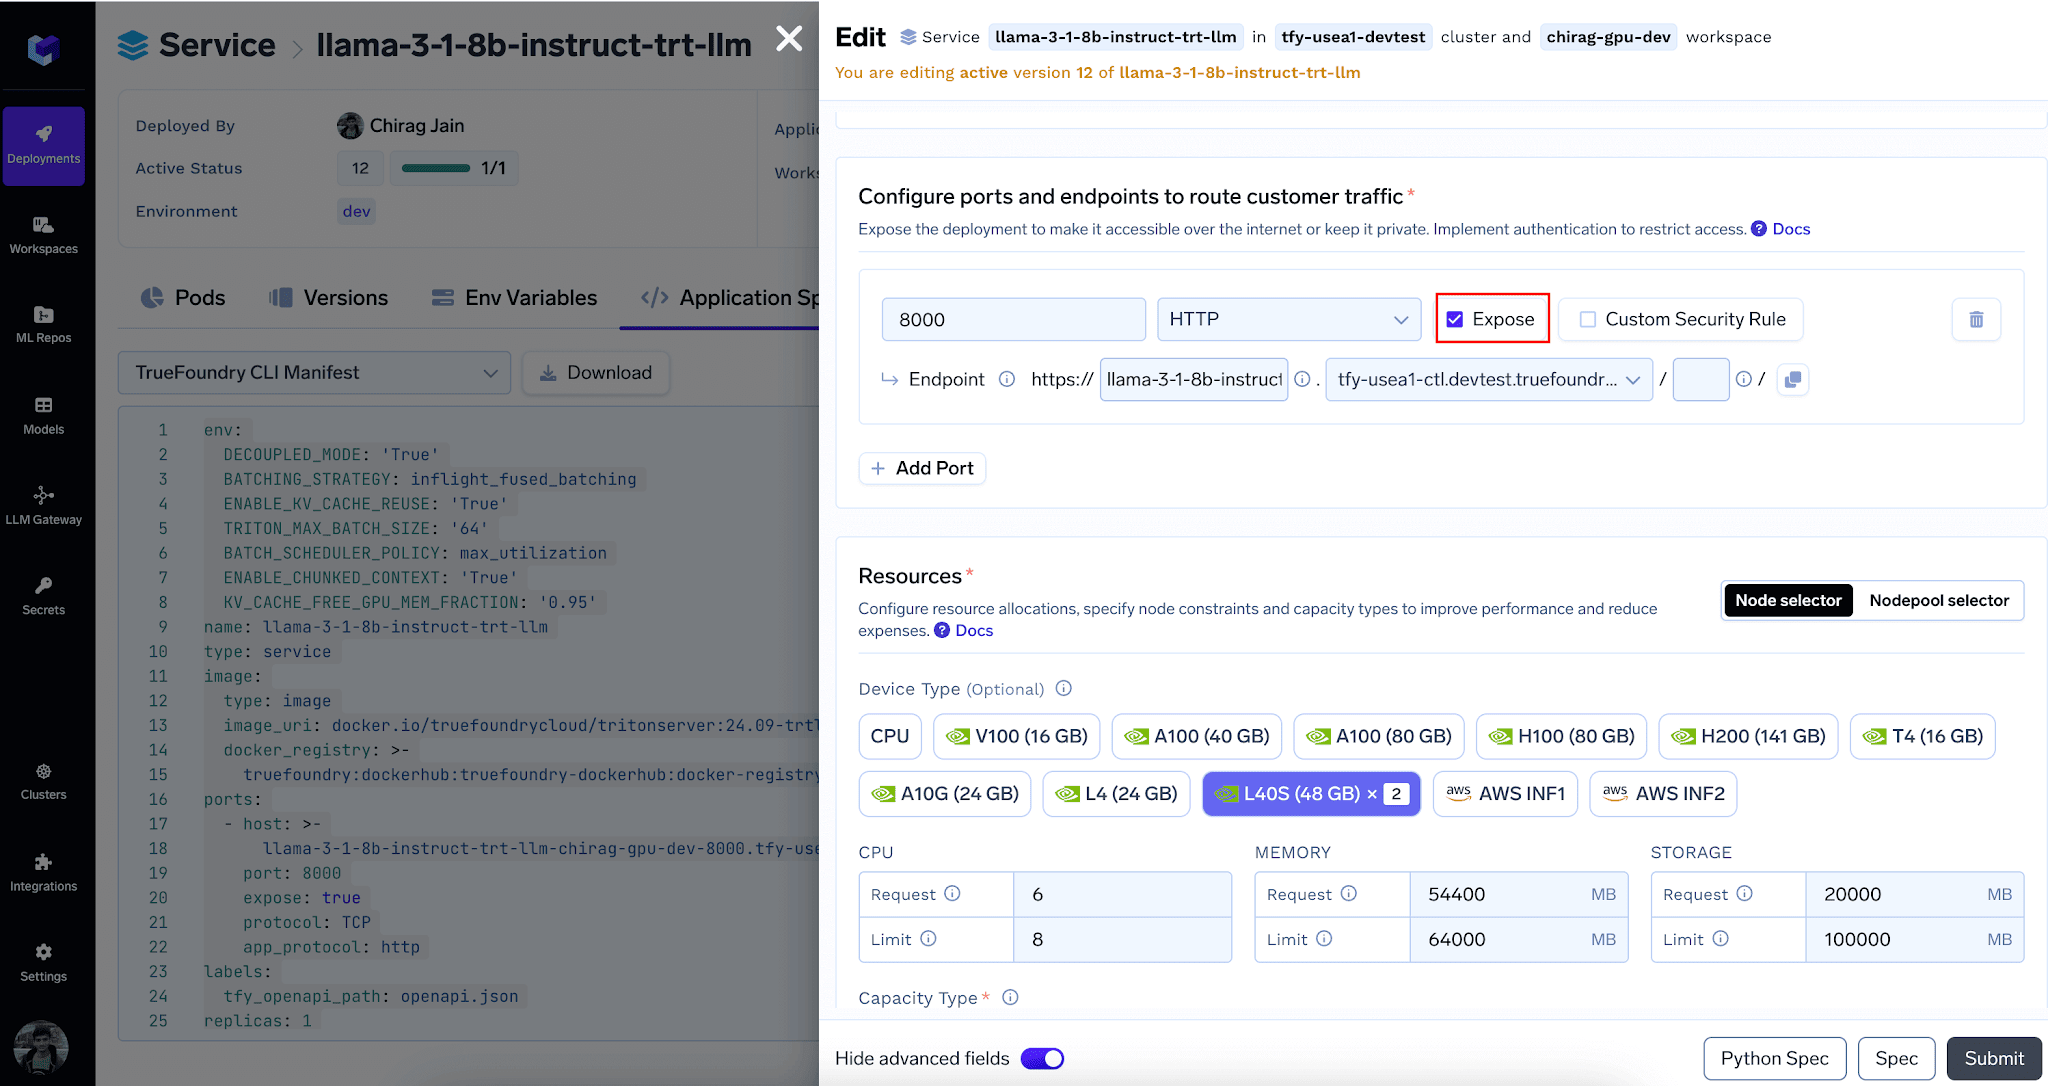
Es zielt typischerweise auf die niedrigste Latenz und beste Effizienz pro GPU auf NVIDIA-GPUs ab – erkauft durch einen expliziten Build-Schritt und Engines, die exakt an den GPU-Typ und die GPU-Anzahl gebunden sind, für die sie gebaut wurden. Wie in der Dokumentation angemerkt: Da TRT-LLM das Modell für den Ziel-GPU-Typ und die Anzahl optimiert, ist es wichtig, dass GPU-Typ und -Anzahl beim Deployment übereinstimmen.
| Engine | Kernidee | Ideal für | Tradeoff |
| --- | --- | --- | --- |
| vLLM | PagedAttention KV Cache | Allgemeiner hoher Durchsatz, breite Modellunterstützung | Hervorragender Standard, nicht immer die niedrigste Latenz |
| SGLang | RadixAttention Prefix Reuse | Gemeinsame Prompts, Agenten, strukturierte Ausgaben | Größte Vorteile erfordern Prefix Reuse |
| TensorRT-LLM | Compilierte NVIDIA-Engines | Niedrigste Latenz auf NVIDIA-GPUs | Build-Schritt, Engine an GPU gebunden |
Alle Leistungszahlen sind workload-spezifisch. Benchmarken Sie mit Ihrem eigenen Traffic, bevor Sie sich festlegen. TrueFoundry unterstützt alle drei, sodass die Engine optimal an den Workload angepasst werden kann.
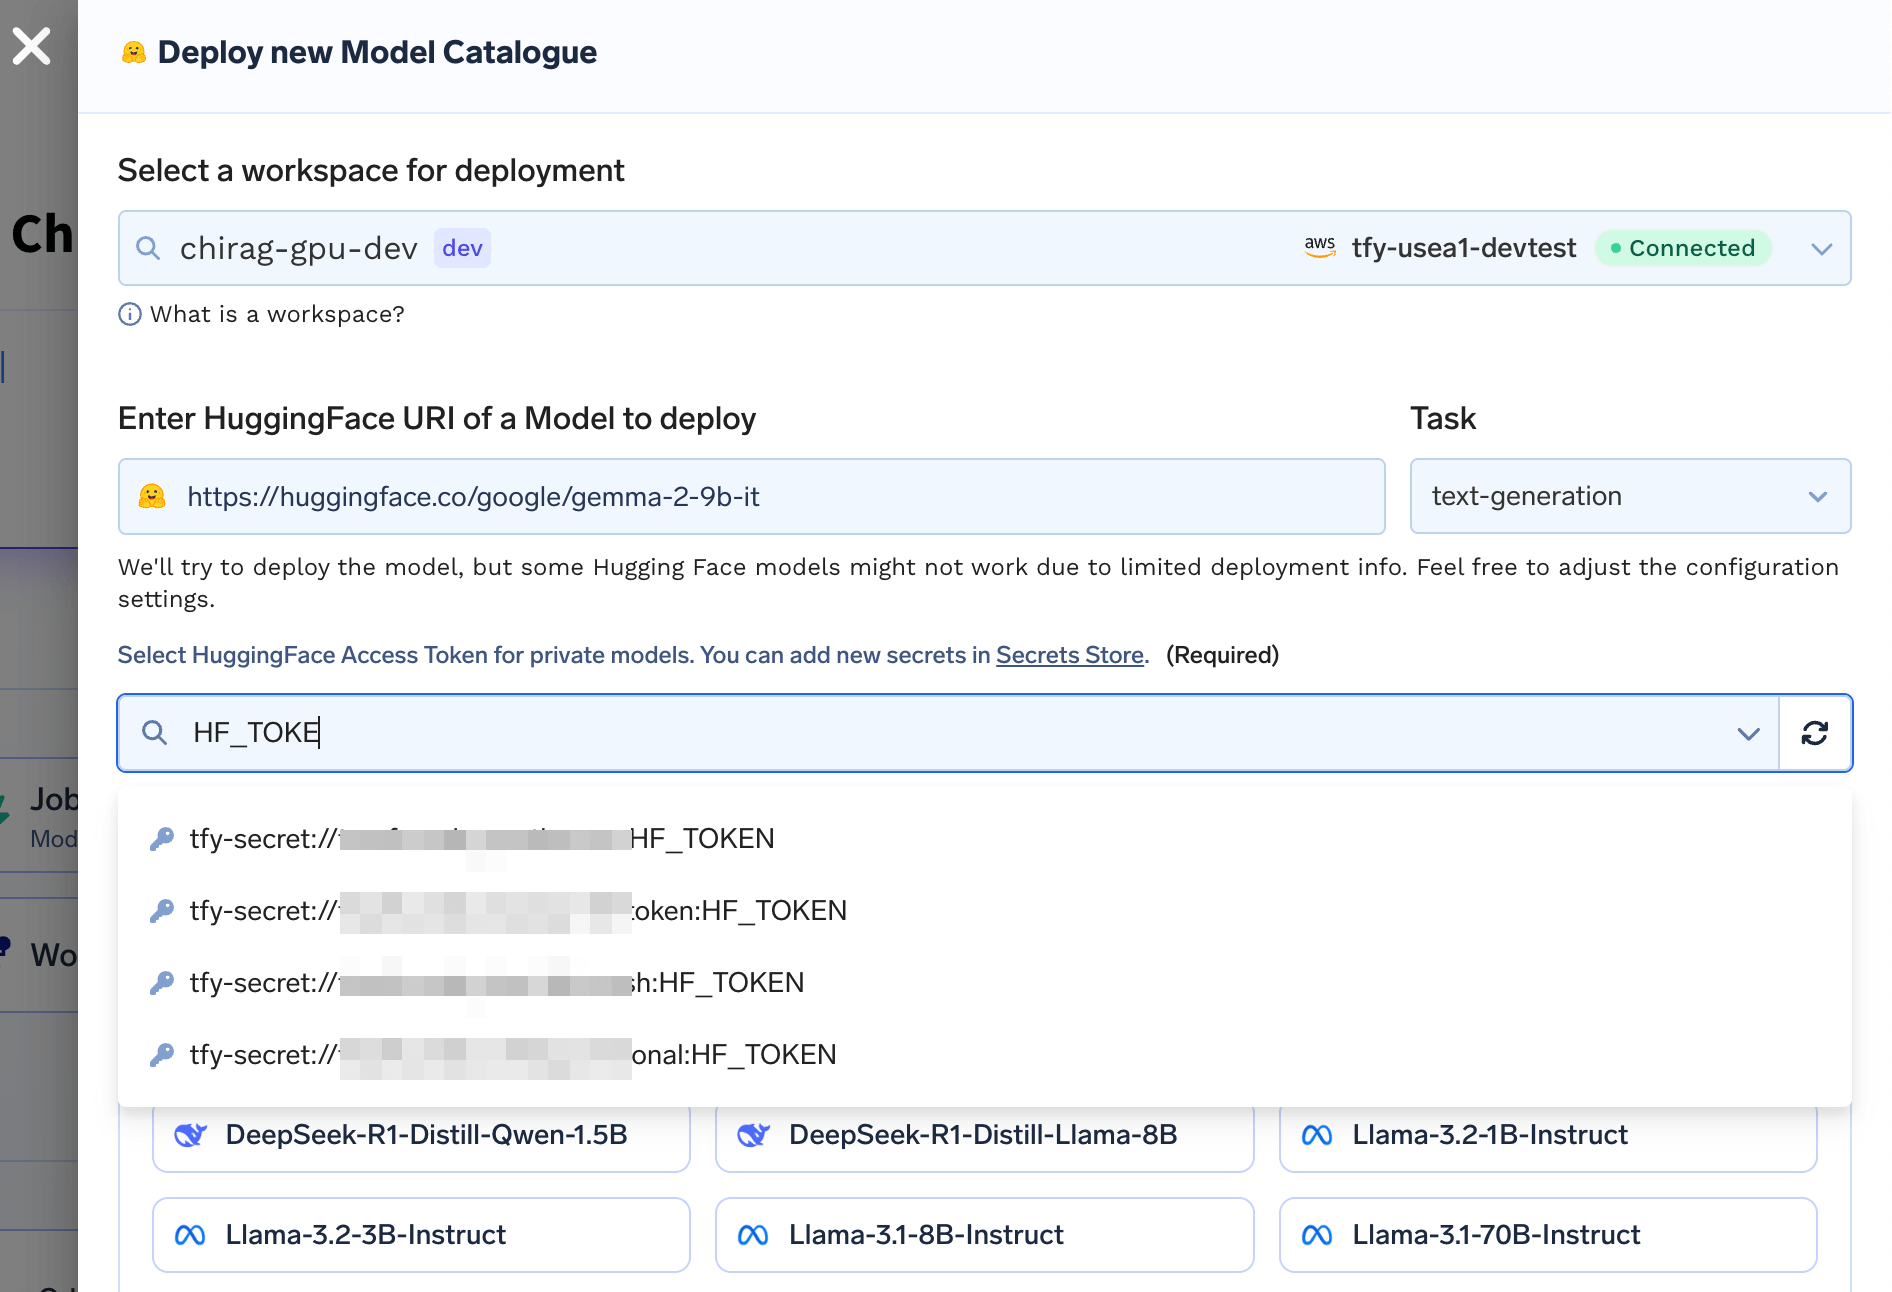
Für vLLM und SGLang führt der Weg über den Modellkatalog. Wie in den Docs beschrieben, vereinfacht TrueFoundry das Deployment eines LLM, indem es automatisch den optimalen Weg für das Deployment ermittelt und die richtige Zusammenstellung von GPUs konfiguriert.
Sie können entweder eines der Modelle im LLM-Katalog auswählen oder eine Hugging Face Modell-URL einfügen. TrueFoundry analysiert die Modell-Tags und -Dateien, um das Deployment-Framework zu verstehen, und generiert die Deployment-Manifeste. Sie behalten die volle Flexibilität bei der Wahl des optimalen Modellservers, was eine schnellere Inference garantiert. Die Plattform nutzt außerdem Image-Streaming und -Caching, was 3-mal schnellere Download-Zeiten für vLLM- und SGLang-Images ermöglicht.
TensorRT-LLM ist kein Ein-Klick-Schalter, da Engines für die Ziel-GPU compiliert werden müssen. Die dedizierte Anleitung nutzt einen Build-then-Serve-Ablauf.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




It depends on the model, GPU, and workload. TensorRT-LLM often reaches lower latency on NVIDIA GPUs because it compiles a model specific engine, while vLLM offers excellent throughput and broader model coverage with no build step. Benchmark both on your own traffic.
Choose SGLang when your prompts share long prefixes, such as shared system prompts or agentic multi turn flows, or when you need fast, reliable structured outputs like JSON or grammar constrained decoding. Its RadixAttention is designed for prefix reuse.
Yes. TrueFoundry supports vLLM, SGLang, and TRT-LLM as model servers. vLLM and SGLang are selectable in the catalogue flow, and TensorRT-LLM has a dedicated build and serve guide. Any OpenAI compatible endpoint can be added to the AI Gateway.
Because TensorRT-LLM compiles the engine for a specific GPU type and count, the serving deployment must use the same GPU type and count as the builder job. This is what lets it reach its latency and efficiency targets.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet














