


November 21, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Unser Test-Harness zeigte an, dass OpenRouter Prompt-Caching bei Anthropic-Modellen funktionierte. Unser Verfassungsbericht einige Tage später besagte das Gegenteil. Beide lagen falsch.
Der Test sendete einen langen Referenztextblock an Claude Haiku 4.5 mit cache_control darin – genau dort, wo es laut OpenRouter-Dokumentation stehen sollte. Der Harness sah Cache-Felder in der Antwort und markierte die Funktion als funktionsfähig. Als wir uns die Zahlen später ansahen, war cache_write_tokens null, also gingen wir davon aus, dass es verworfen wurde. Die Antwort stand die ganze Zeit in der Dokumentation: Haiku 4.5 cacht keine Prompts unter 4.096 Tokens, und unserer umfasste etwa 3.600 Tokens.
Die meisten Prompt-Caching-Probleme bei OpenRouter zeigen sich auf dieselbe Weise. Die Anfrage ist erfolgreich und die Funktion ist aktiviert. Die Antwort verrät Ihnen nur nicht eindeutig, wann kein Caching stattfand oder wann es stattfand und mehr kostete, als es einsparte.
OpenRouter verwendet das Wort für zwei Funktionen, die fast nichts gemeinsam haben.
Provider-Prompt-Caching liegt beim Provider. Es speichert den verarbeiteten Präfix Ihres Prompts, sodass die nächste Anfrage mit demselben Präfix das erneute Einlesen überspringt und diese Tokens mit einem Rabatt berechnet. Das Modell läuft weiterhin und verfasst eine neue Antwort. Response-Caching liegt bei OpenRouter. Es speichert die gesamte Antwort und gibt sie bei einer identischen Anfrage zurück, ohne dass das Modell überhaupt ausgeführt wird.
Die folgenden Preise, Untergrenzen und TTLs beziehen sich auf das Provider-Prompt-Caching. Wenn Sie sich zwischen Exakt-Match- und semantischem Response-Caching entscheiden möchten, deckt dies unser Leitfaden dazu ab, wann ähnliche Fragen dieselbe Antwort teilen sollten. OpenRouters Response-Cache hat einen eigenen Abschnitt weiter unten.
OpenRouter reicht die Cache-Preise der einzelnen Provider ohne Aufschlag pro Token durch. Die Gebühren fallen stattdessen auf Guthabenkäufe an, was unsere OpenRouter-Preisaufschlüsselung behandelt. Die folgenden Multiplikatoren beziehen sich auf den normalen Input-Preis des Modells.
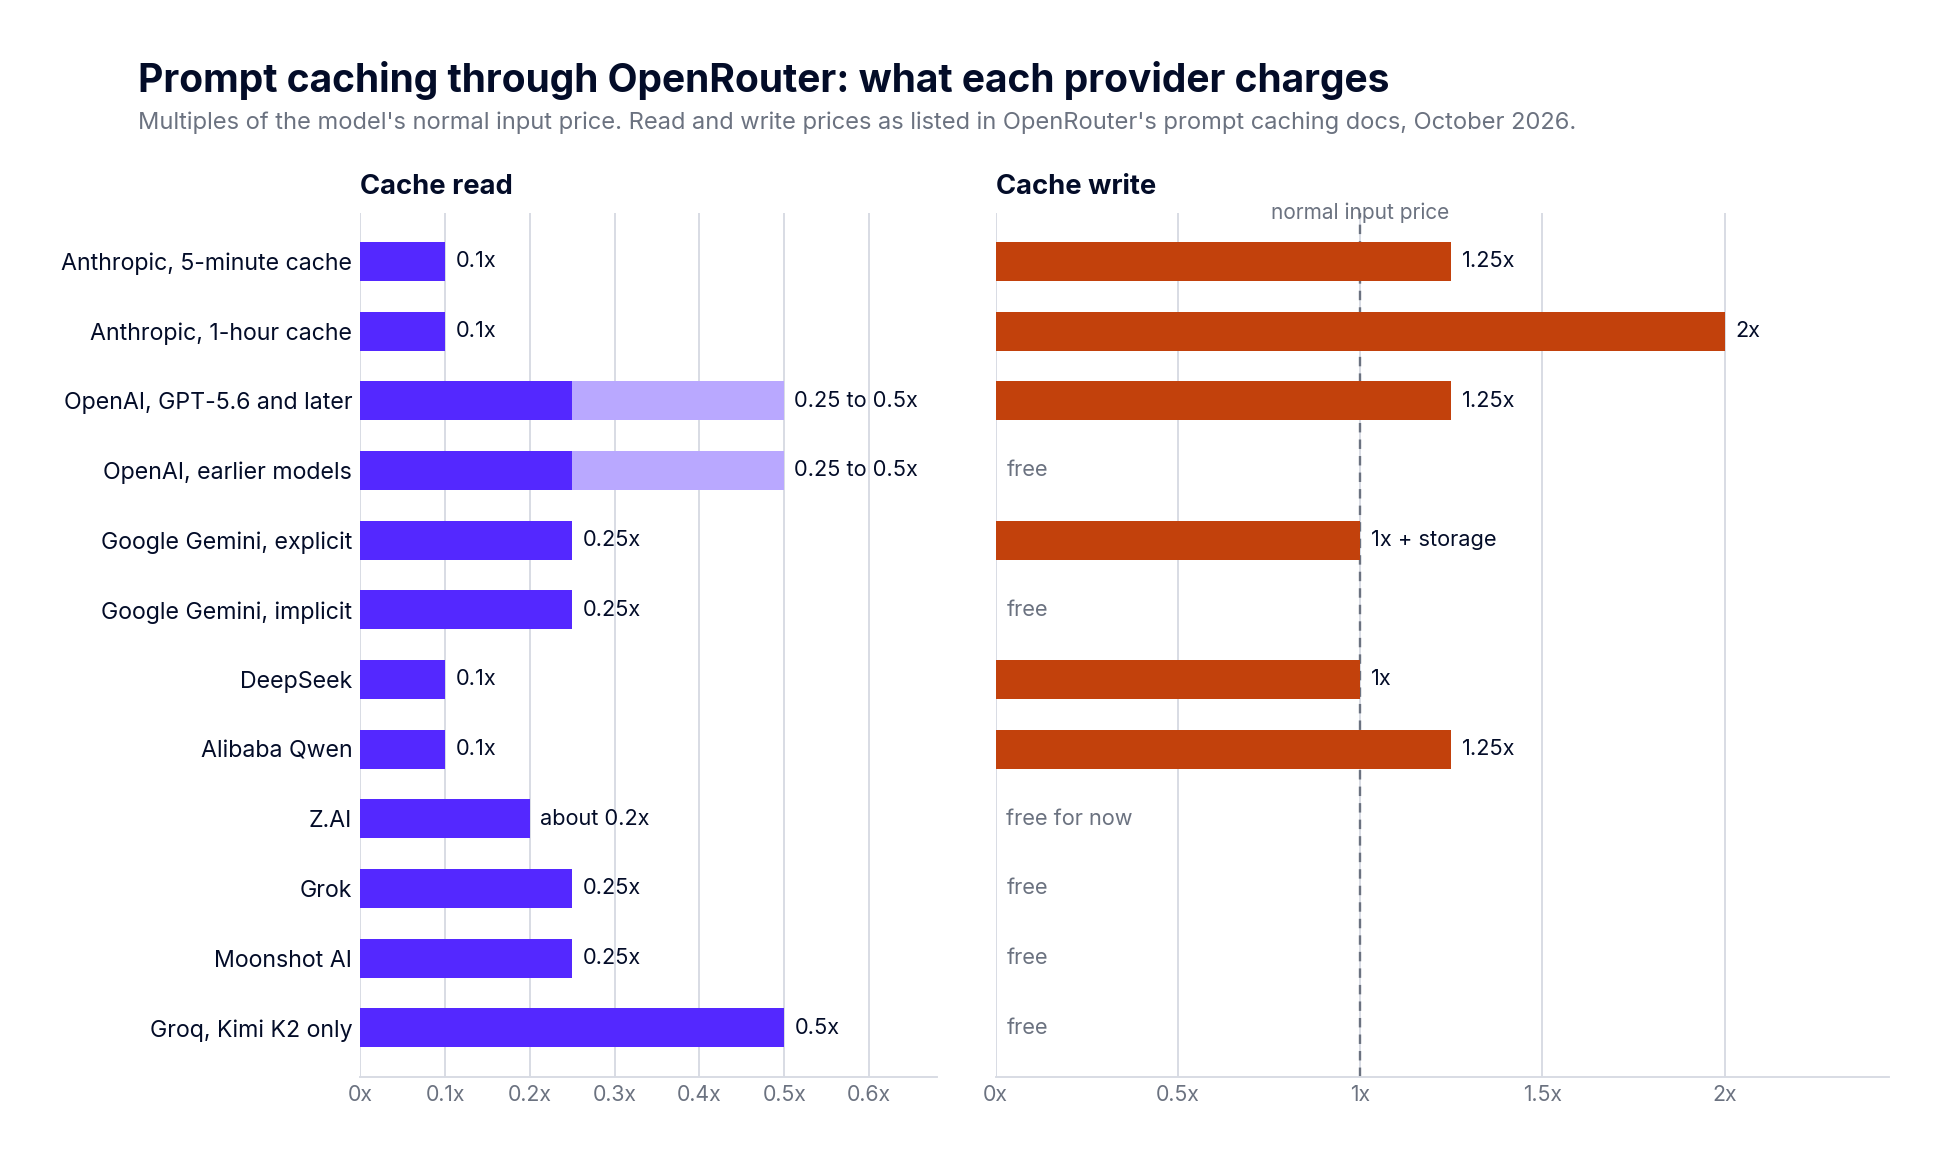
Read-Zugriffe liegen zwischen einem Zehntel und der Hälfte des Input-Preises, und Write-Zugriffe reichen von kostenlos bis zum Doppelten. Fünf der neun Provider haben in den Docs von OpenRouter keine minimale Prompt-Länge aufgeführt. Und bei Modell-Fallbacks oder dem Auto Router kann eine Anfrage mit einem kalten Cache in einer anderen Zeile landen als die vorherige.
Ob Caching Geld spart, hängt davon ab, wie oft derselbe Präfix gesendet wird, während der Cache noch warm ist. Unter Verwendung der obigen Multiplikatoren und unter Berücksichtigung nur des gecachten Teils des Prompts gilt:
Der Rest jeder Anfrage – die Frage des Benutzers und alles nach dem letzten gecachten Block – wird in beiden Fällen gleich abgerechnet, sodass diese Verhältnisse nur für den Präfix gelten.
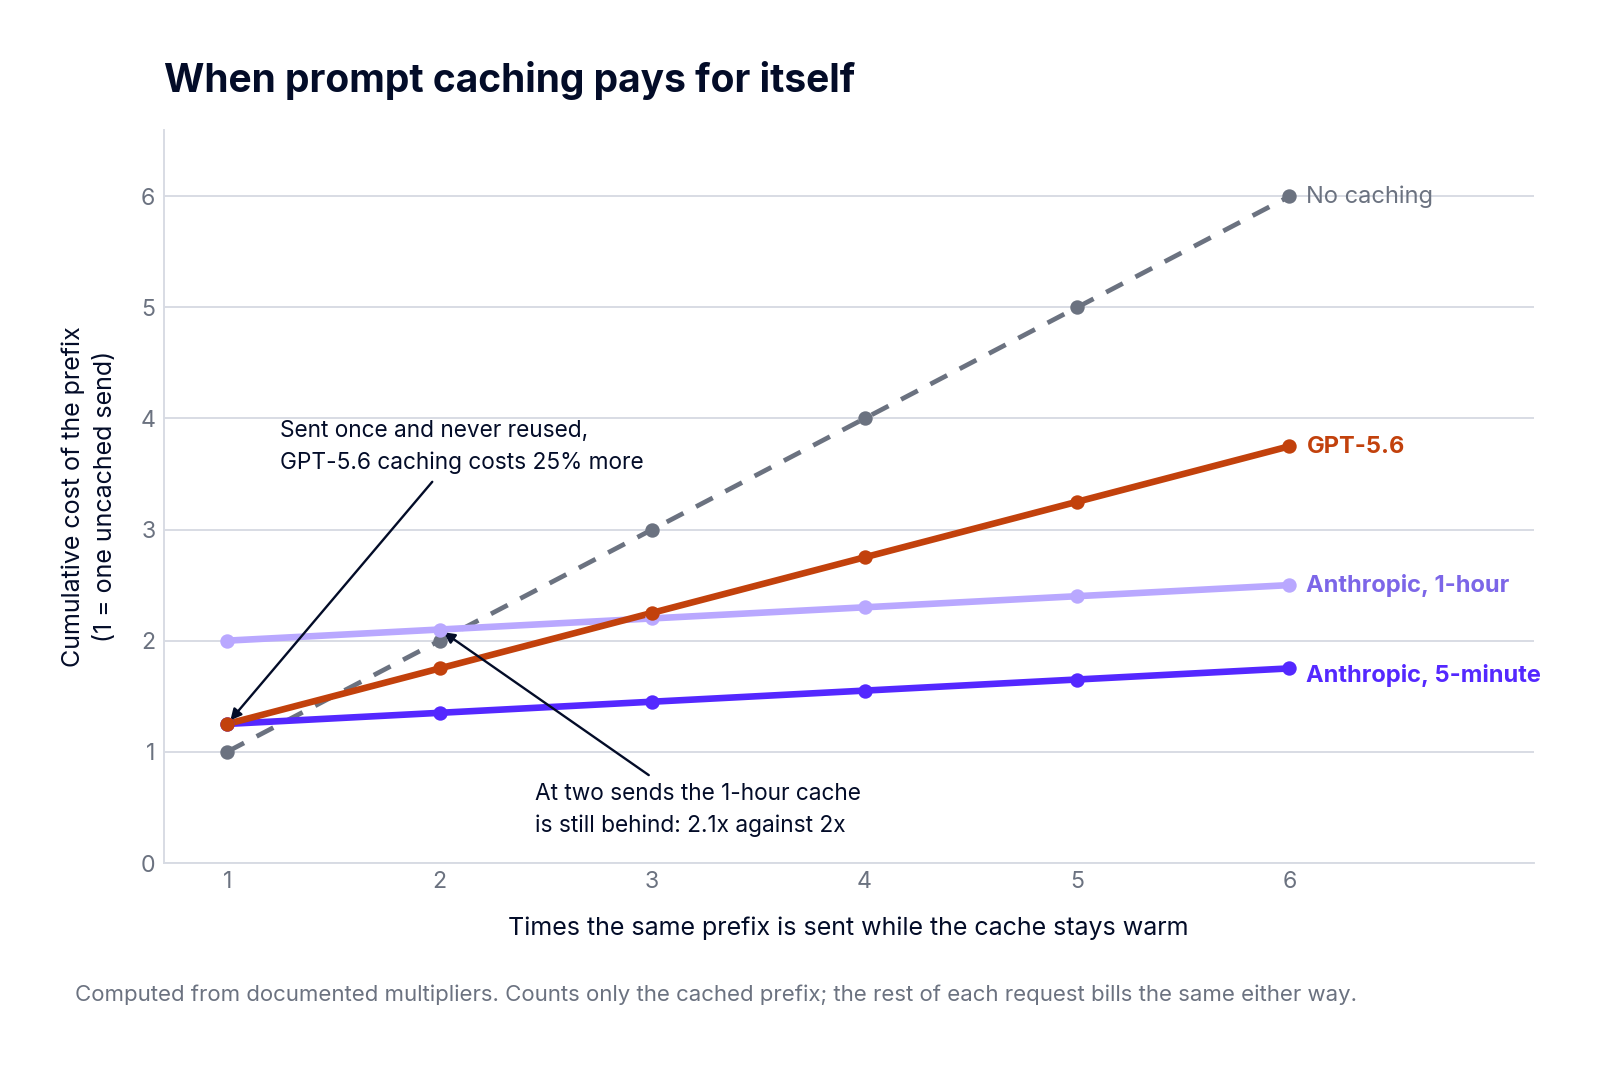
Für den Großteil der Tabelle ist ein Cache-Schreibzugriff kostenlos oder nahezu kostenlos, sodass Caching eine kostenlose Option darstellt. GPT-5.6 hat das für OpenAI geändert. Ab dieser Familie werden Cache-Schreibzugriffe auch unter automatischem Caching mit dem 1,25-fachen des Input-Preises abgerechnet, und automatisches Caching ist aktiviert, unabhängig davon, ob Sie es angefordert haben oder nicht. Jeder Prompt von 1.024 Tokens oder mehr, den Sie einmal senden, zahlt für den Schreibzugriff und profitiert nie vom Lesezugriff.
Nehmen wir einen einmalig gesendeten Prompt mit 2.000 Tokens. Ohne Caching wird er als 2.000 Tokens Input abgerechnet. Bei aktiviertem Caching zahlen Sie fast so viel, wie ein Prompt mit 2.500 Tokens kosten würde. Bei einem nächtlichen Job, der eine Million langer, eindeutiger Dokumente zusammenfasst, bei denen das Dokument an erster Stelle steht und sich zu Beginn nichts wiederholt, ist das ein Zuschlag von 25 % auf den Großteil Ihres Inputs.
Die Lösung funktioniert rückwärts. Setzen Sie prompt_cache_options.mode auf "explicit" und markieren Sie keinen Inhaltsblock mit prompt_cache_breakpoint. Der explizite Modus schaltet die automatischen Breakpoints von OpenAI aus, und ohne explizite gibt es keinen cachtbaren Präfix, sodass nichts geschrieben wird. cache_write_tokens wird als Null zurückgegeben, was die einzige Stelle in diesem Beitrag ist, an der eine Null das bedeutet, was Sie möchten.
Nun die andere Seite. Claude Sonnet 4.6 mit einem System-Prompt von 5.000 Tokens, 100 Anfragen über einen Arbeitstag verteilt, die in 20 Bursts von jeweils fünf Anfragen mit einem Abstand von etwa 20 Minuten eingehen. Wenn man nur den System-Prompt in Tokens zählt, die zum normalen Input-Preis abgerechnet werden:
Der 5-Minuten-Cache spart zwei Drittel. Der 1-Stunden-Cache spart 88 %, da ein 20-minütiger Abstand den kurzen Cache jedes Mal löscht und den langen nie erreicht. Anthropic verlängert die Lebensdauer des Caches bei jedem Lesezugriff, sodass der 1-Stunden-Eintrag den ganzen Tag warm bleibt.
Ändern Sie den Traffic, ändert sich die Antwort. Wenn diese 100 Anfragen gleichmäßig eingegangen wären, etwa alle vier Minuten eine, würde der 5-Minuten-Cache ebenfalls nie ablaufen, und die 1-Stunden-Option würde bedeuten, 10.000 für einen Schreibzugriff zu zahlen, den der kurze Cache mit 6.250 verarbeitet. Wählen Sie die TTL anhand der Abstände zwischen Ihren Anfragen, nicht danach, wie viele Sie senden.
Jeder Provider legt eine minimale Prompt-Länge fest, unterhalb derer nichts gecacht wird. Für Claude gilt laut OpenRouter-Dokumentation:
Die Untergrenze von OpenAI liegt bei 1.024. Die von Gemini liegt bei 1.024 für 2.5 Flash und 4.096 für 2.5 Pro. Unterhalb der Untergrenze ist die Anfrage erfolgreich, wird zum vollen Input-Preis abgerechnet und wird mit auf Null gesetzten Cache-Feldern zurückgegeben. Kein Fehler, keine Warnung.
Zwei Konsequenzen daraus werden leicht übersehen.
Neuere Modelle haben höhere Untergrenzen. Ein System-Prompt mit 3.000 Tokens wird auf Sonnet 4.6 gecacht und stoppt das Caching an dem Tag, an dem Sie ihn auf Opus 4.7 verschieben – ohne Code-Änderung und ohne Hinweise in der Antwort. Der Wechsel von Haiku 3.5 zu Haiku 4.5 bewirkt dasselbe für alles zwischen 2.048 und 4.096 Tokens. Ein Modell-Upgrade ist eine Caching-Änderung, überprüfen Sie daher nach einem Upgrade Ihre Cache-Hit-Rate.
Und Sie können Caching nicht verifizieren, indem Sie nach Cache-Feldern suchen. Das ist es, was unseren eigenen Test verwirrt hat. OpenRouter gibt cached_tokens und cache_write_tokens bei Antworten von jedem Provider zurück, auch bei solchen, bei denen Caching nicht nativ ist, sodass das Vorhandensein der Felder nichts beweist. Nullen beweisen auch nicht viel. Sie bedeuten, dass der Marker ignoriert wurde oder der Prompt unter der Untergrenze lag – und bei Haiku 4.5 mit 3.600 Tokens war es die Untergrenze.
Ein Test, der Ihnen Aufschluss gibt:
cache_write_tokens über Null. Erwarten Sie beim zweiten Aufruf cached_tokens über Null.cache_discount im Antwort-Body. Es ist bei einem Anthropic-Schreibzugriff negativ und bei einem Lesezugriff positiv.OpenRouter übersetzt Cache-Marker zwischen Providern, was nützlich ist. Ein Textblock mit cache_control im Anthropic-Stil wird zu einem prompt_cache_breakpoint, wenn er an ein GPT-5.6-Modell geroutet wird, und ein prompt_cache_breakpoint wird zu einem Standard-cache_control bei Anthropic oder Google.
Die TTL wird jedoch nicht mitübertragen. Ein ttl auf cache_control wird auf dem Weg zu OpenAI verworfen. prompt_cache_options, wo die TTL von OpenAI liegt, gilt nur für OpenAI. prompt_cache_breakpoint hat kein TTL-Feld, sodass alles, wozu es auf Anthropic-Seite wird, den 5-Minuten-Standardwert erhält.
Lebensdauern verhalten sich nach dem Festlegen ebenfalls unterschiedlich. Die von Anthropic wird bei jedem Lesezugriff aktualisiert. Der explizite Cache von Gemini hält ab dem Schreibzugriff fünf Minuten und wird nicht aktualisiert. Der implizite Cache von Gemini ist mit durchschnittlich drei bis fünf Minuten dokumentiert, variiert jedoch. Eine Anfrage, die eine Stunde anfordert, kann also eine Stunde, fünf feste Minuten oder was auch immer OpenAI anwendet erhalten, je nachdem, wo sie landet. Die Responses API fügt eine weitere Lücke hinzu: Sie legt blöckspezifische Anthropic-cache_control nicht offen. Verwenden Sie daher Chat Completions oder den Messages-Endpunkt, wenn Sie eine TTL für einen bestimmten Block benötigen.
Ein Cache hilft nur, wenn Ihre nächste Anfrage den Provider erreicht, der ihn hält. OpenRouter handhabt dies mit Provider Sticky Routing: Nach einer Anfrage, die Caching nutzt, gehen Folgeanfragen für dasselbe Modell an denselben Provider-Endpunkt.
Stickiness wird pro Account, pro Modell und pro Konversation nachverfolgt, wobei eine Konversation durch Hashing Ihrer ersten System-Nachricht und Ihrer ersten Nicht-System-Nachricht identifiziert wird. Sie läuft nach 10 Minuten ohne Anfrage ab.
Agenten neigen dazu, diesen Standardwert zu unterbrechen, da sich ihre Eröffnungsnachrichten zwischen den Zügen ändern. Übergeben Sie einen session_id im Body oder einen x-session-id-Header, und OpenRouter verwendet diesen stattdessen als Sticky-Key, beginnend mit der ersten erfolgreichen Anfrage, anstatt auf einen Cache-Hit zu warten. OpenAIs prompt_cache_key funktioniert als Fallback-Key, falls Sie ihn bereits senden.
Das Setzen von provider.order schaltet das Sticky Routing aus und Ihre Liste erhält Priorität. Solange Ihre erste Wahl verfügbar ist, kostet das wenig, da ein Pin Sie ohnehin bei einem Provider hält. Der Unterschied zeigt sich nach einem Failover, wenn Sticky Routing dem Provider folgen würde, der Sie bedient hat, und ein Pin wieder ganz oben auf Ihrer Liste beginnt. Pinning ist weiterhin richtig, wenn Sie vorhersagbare Kapazitäten benötigen, wie wir in unserem Beitrag über OpenRouter Rate Limits dargelegt haben. Der Auto Router hat einen ähnlichen Effekt: Wenn das von ihm ausgewählte Modell bei einem späteren Zug aus seinen Kandidaten herausfällt, geht der Cache mit ihm verloren.
Unabhängig von all dem oben Genannten cacht OpenRouter ganze Antworten, wenn Sie X-OpenRouter-Cache: true senden. Ein Treffer gibt die gespeicherte Antwort zurück, ohne einen Provider aufzurufen, wird nicht berechnet und wird nicht auf die Provider-Rate-Limits angerechnet.
Wir haben dies über drei Durchläufe von jeweils 100 identischen erneuten Anfragen auf GPT-4o mini und Claude Haiku 4.5 gemessen. Jede erneute Anfrage war ein Treffer. Die mediane Latenz betrug 2.867 ms bei einem Miss und 59 ms bei einem Hit, wobei Haiku-Hits mit 39 ms schneller waren im Vergleich zu 64 bis 69 ms bei GPT-4o mini. Bei dem Durchlauf, der über Guthaben abgerechnet wurde, kosteten 100 Misses $0,0174 und 100 Hits kosteten nichts.
Einträge werden nach dem API-Key plus Modell, Endpunkttyp, Streaming-Modus und vollständigem Anfrage-Body geschlüsselt. Dienste mit separaten Keys teilen sich also nichts, und jede Parameteränderung ist ein Miss. Unsere TTL-Prüfung (eine Stichprobe pro Intervall) ergab, dass Einträge nach 120 Sekunden noch aktiv und nach 300 Sekunden verschwunden waren. Es gibt keine veröffentlichte TTL, kein semantisches Matching und keine dokumentierte Bereinigung. Es fängt Retries und doppelte Übermittlungen ab. Eine stündliche Wiederholung führt zu einem Miss.
Unser Gateway cacht auf der Response-Ebene in zwei Modi. Exact-Match gibt eine gespeicherte Antwort für eine identische Anfrage zurück. Der semantische Modus embedded die letzte Nachricht und gibt eine gespeicherte Antwort zurück, wenn eine frühere Anfrage nah genug beieinander lag, und bedient auch Exact-Match-Hits, sodass Sie nur einen Modus ausführen, nicht beide. Er wird über einen Request-Header aktiviert, von Redis unterstützt und lässt sich mit dem Provider-Prompt-Caching kombinieren: Bei einem Gateway-Miss greift weiterhin der eigene Präfix-Cache des Providers.
Bei SaaS ist das Embedding-Modell text-embedding-3-small mit 1.536 Dimensionen fest vorgegeben und nicht konfigurierbar; On-Premises wählen Sie es gateway-weit aus. Semantisches Matching hat einen Fehlermodus, den Exact-Match nicht hat. Unser Leitfaden zum semantischen Caching beginnt damit: Zwei Kunden fragen im Abstand von wenigen Minuten nach ihrer Lieferung, die Fragen werden in nahezu denselben Vektor eingebettet, und der zweite Kunde erhält eine Antwort zum Auftrag des ersten Kunden. Das ist ein Scope-Bug. Das Verschieben des Ähnlichkeitsschwellenwerts ändert, wie oft dies passiert, stoppt jedoch keinen Cache, der über Kunden hinweg geteilt wird.
Der Cache-Lookup dauert etwa 3 bis 4 ms, und das Gateway verarbeitet 350+ RPS auf einer einzelnen vCPU.
session_id für Agenten-Sitzungen, damit das Routing auf dem Provider verbleibt, der Ihren Cache hält.cached_tokens, niemals nur durch das Vorhandensein des Feldes.OpenRouter Prompt-Caching funktioniert, und die Dokumentation ist hier klarer als bei vielen umliegenden Funktionen. Dennoch haben Sie neun Preisschemata, Untergrenzen, die bei neueren Modellen steigen, Lebensdauern, die sich bei der Übersetzung ändern, und eine Antwort, die gleich aussieht, unabhängig davon, ob Caching stattgefunden hat oder nicht. Überprüfen Sie die Untergrenze, platzieren Sie den stabilen Text zuerst und verifizieren Sie mit Zahlen statt mit Feldern.
Um Caching einmalig für jeden Provider zu konfigurieren, mit semantischem Matching zusätzlich zum eigenen Präfix-Cache des Providers, sehen Sie sich an, wie das TrueFoundry AI Gateway Caching handhabt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




It's OpenRouter passing through each provider's prompt caching, where a repeated prompt prefix is stored and billed at a discount on later requests. Some providers cache automatically, while Anthropic and Alibaba need cache_control markers on the content you want cached. Prices differ by provider, from free writes and 0.1x reads to 2x writes on Anthropic's 1-hour cache.
Yes, as long as the prompt clears the model's minimum length. Claude Haiku 4.5 and Opus 4.5 and later need 4,096 tokens, and Sonnet 4.x needs 1,024. Below that floor the request succeeds at full price with cache fields at zero, which looks exactly like the marker being ignored.
Most likely you're paying for cache writes on prompts that never get reused. GPT-5.6 and later bill writes at 1.25x even under automatic caching, and Anthropic's 1-hour cache bills writes at 2x. If the prefix doesn't repeat while the cache is warm, you pay for the write and never get the discount.
Roughly 3–4 ms of overhead, handling 350+ RPS on a single vCPU. That matters more as model calls get faster: a routing layer that adds hundreds of milliseconds would erase the advantage of a sub-second decision model.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet














