



October 9, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: October 9, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Ein ungeschützter Modell-Endpunkt gibt bereitwillig personenbezogene Daten preis, akzeptiert Prompt-Injection-Payloads oder liefert unsichere Antworten. Guardrails beheben dies, indem sie den Datenverkehr prüfen und bei Bedarf umschreiben, bevor er das Modell erreicht oder die Antwort beim Benutzer ankommt.
Durch den Einsatz von Guardrails auf dem AI Gateway erhält jede Anwendung automatisch denselben Schutz, ohne dass jedes Team Sicherheitsmaßnahmen neu implementieren muss. TrueFoundry bietet integrierte Guardrails für die PII-Schwärzung und die Erkennung von Prompt-Injection, die vollständig verwaltet werden und keine Drittanbieter-Schlüssel erfordern.
Wie in der Guardrails-Dokumentation beschrieben, ist die Anwendung von Guardrails auf dem AI Gateway ein zweistufiger Prozess.
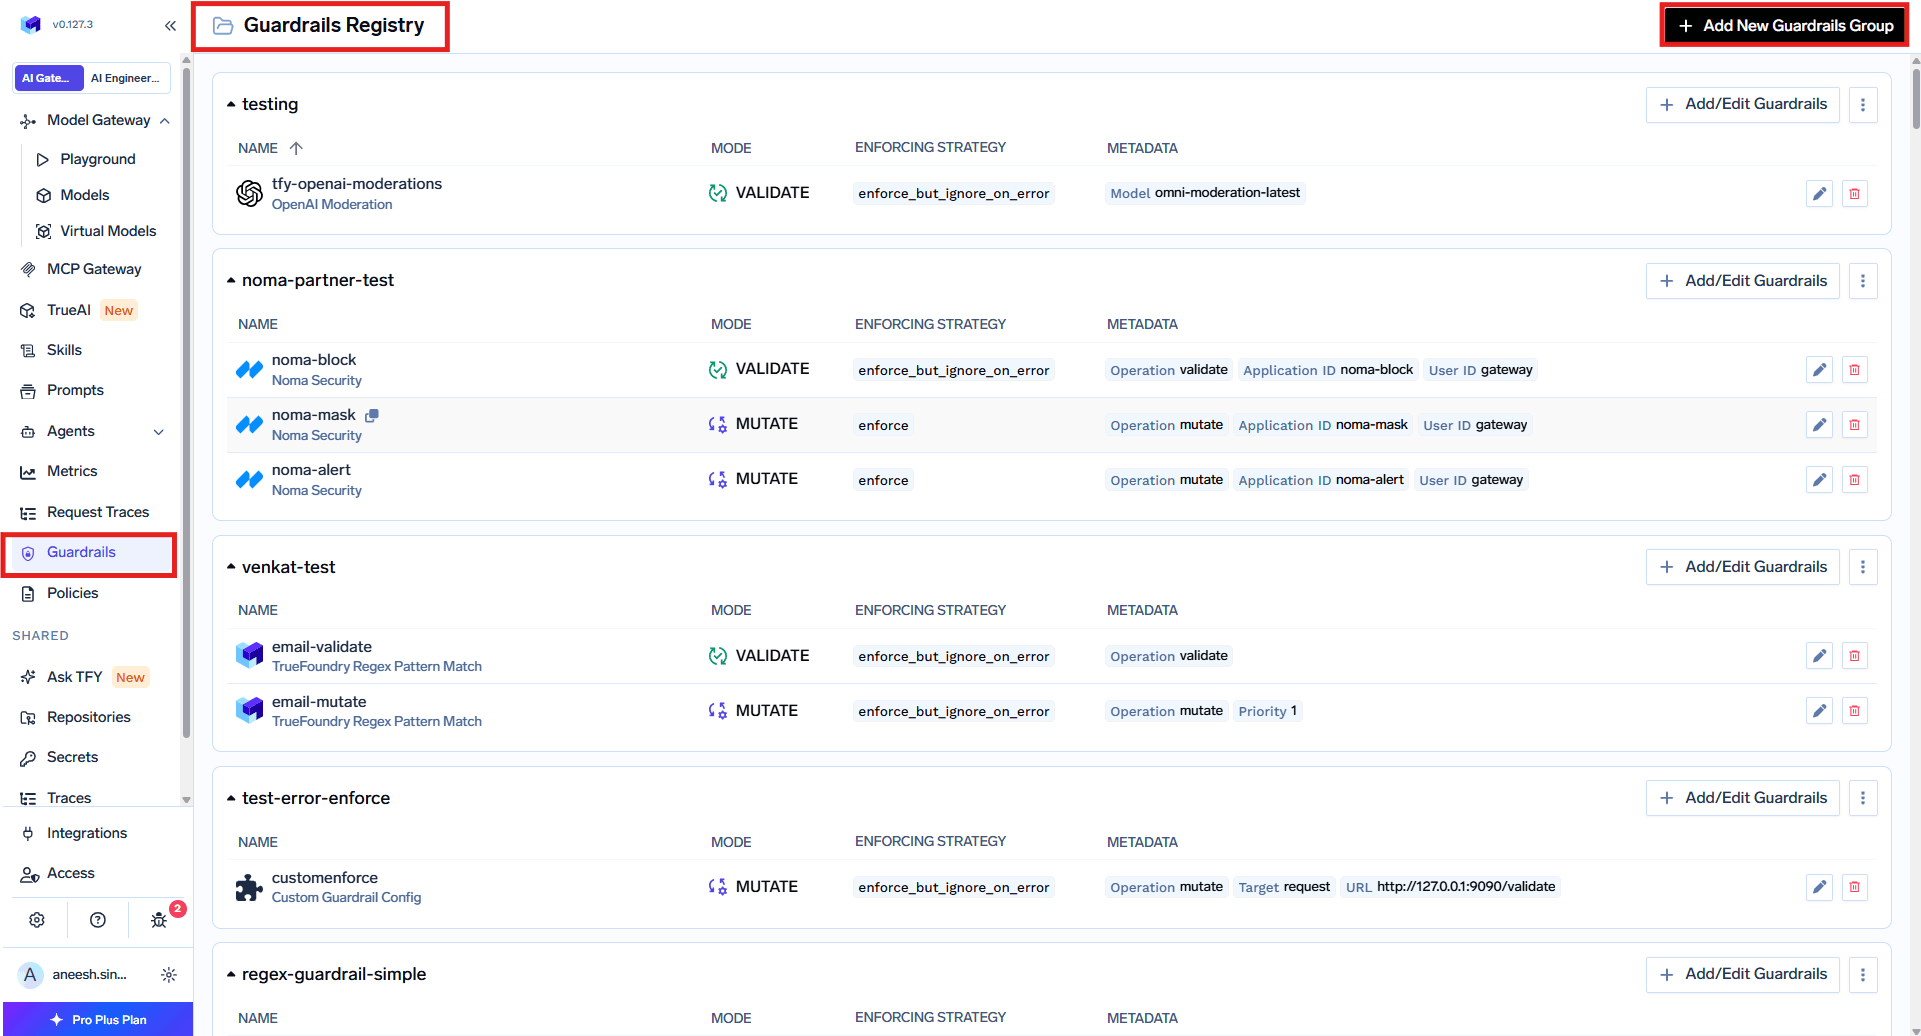
Klicken Sie unter Policies und Guardrails auf „Add Rule“. Jede Regel hat eine eindeutige Regel-ID sowie verschiedene Abschnitte, die festlegen, für wen sie gilt und wo sie ausgeführt wird.
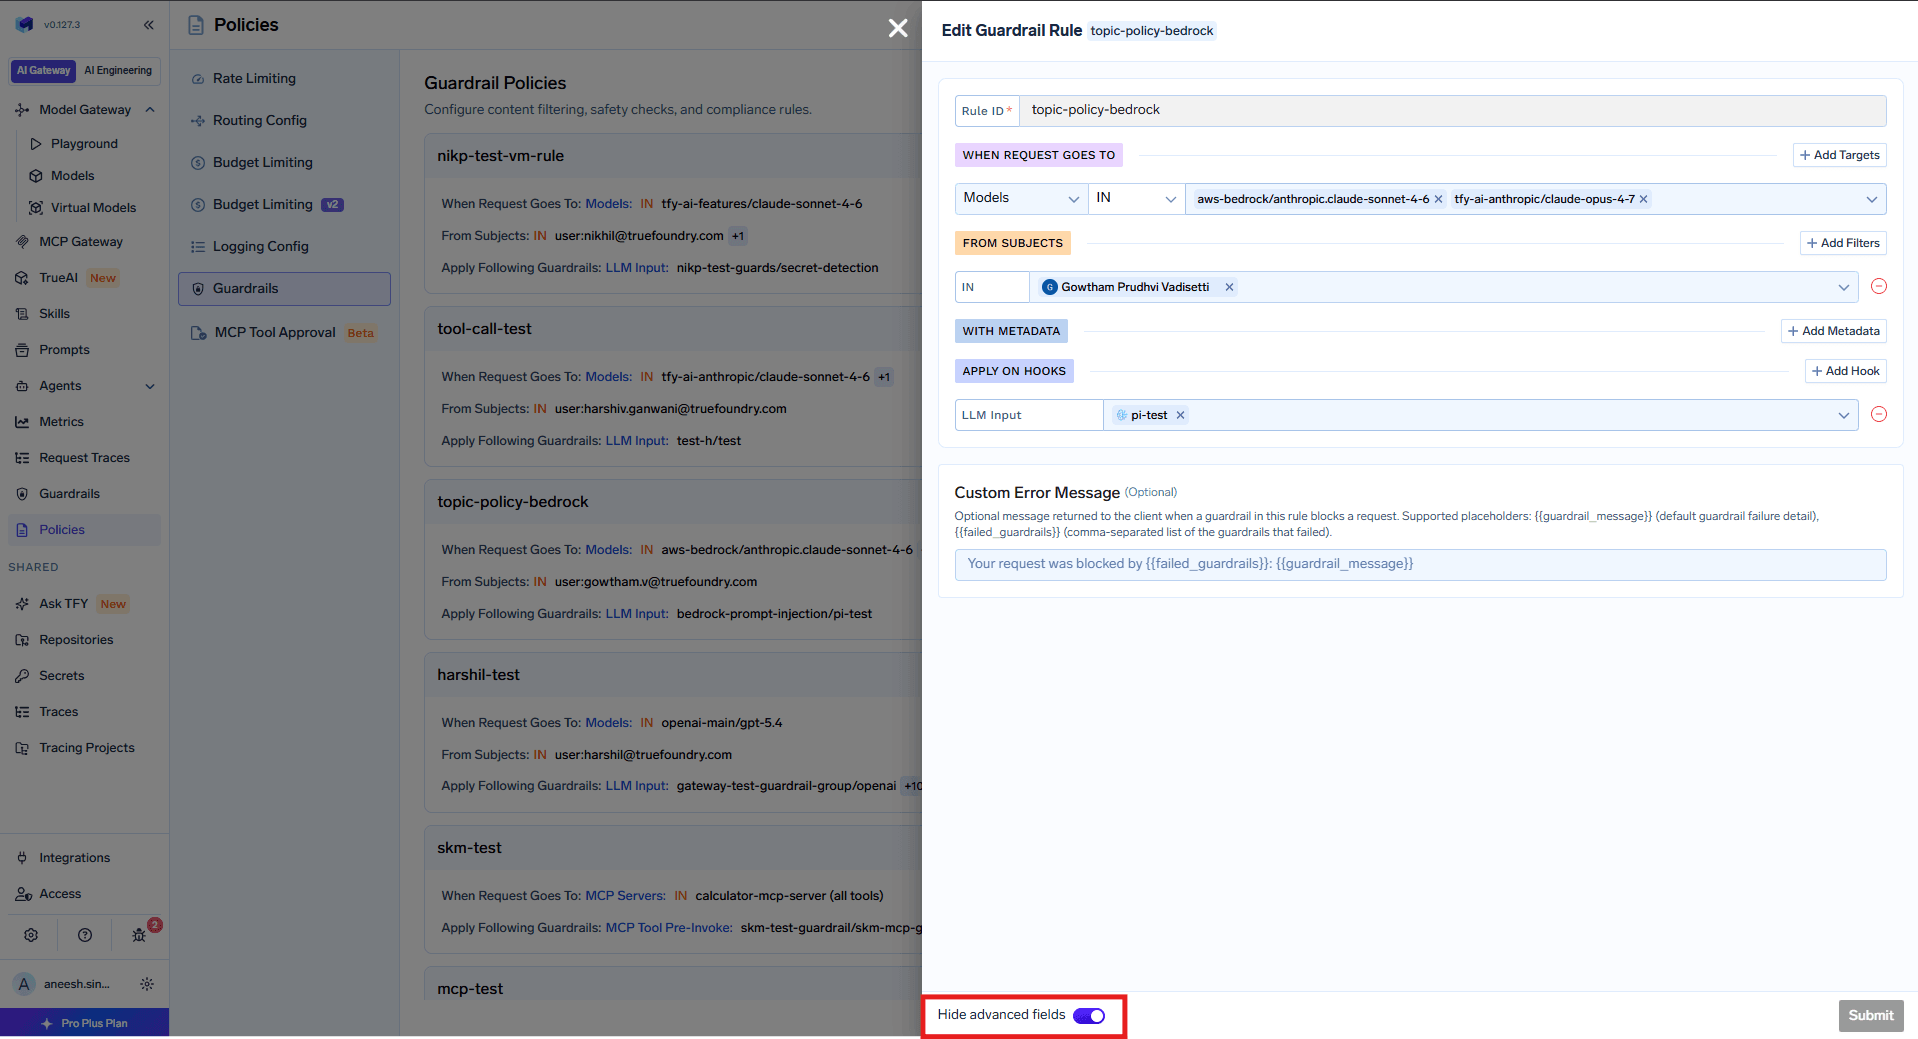
Alle Regeln werden für jede Anfrage ausgewertet, und die Guardrails aller übereinstimmenden Regeln werden kombiniert und gemeinsam angewendet. Wenn eine Regel die PII-Erkennung auf die LLM-Eingabe anwendet und eine andere die Erkennung von Prompt-Injection auf die LLM-Eingabe anwendet, werden beide ausgeführt.
DiePII- und PHI-Erkennungs-Guardrail ist ein integrierter TrueFoundry-Guardrail, der personenbezogene Daten (PII) sowie geschützte Gesundheitsinformationen (PHI) identifiziert und schwärzt. Er basiert im Hintergrund auf der Azure AI Language PII-Erkennung und ist vollständig verwaltet, sodass keine API-Schlüssel von Drittanbietern erforderlich sind.
Es wird ausschließlich der Mutate-Modus unterstützt, was bedeutet, dass erkannte Entitäten immer geschwärzt werden. Im Konfigurationsformular vergeben Sie einen Namen, wählen PII-Kategorien aus (oder behalten die Standardeinstellung „Alle Kategorien“ bei) und legen eine Durchsetzungsstrategie fest. Erkannte Werte werden durch Sternchen ersetzt, sodass beispielsweise Telefonnummern und E-Mail-Adressen in einer Nachricht maskiert werden, bevor das Modell sie überhaupt sieht.
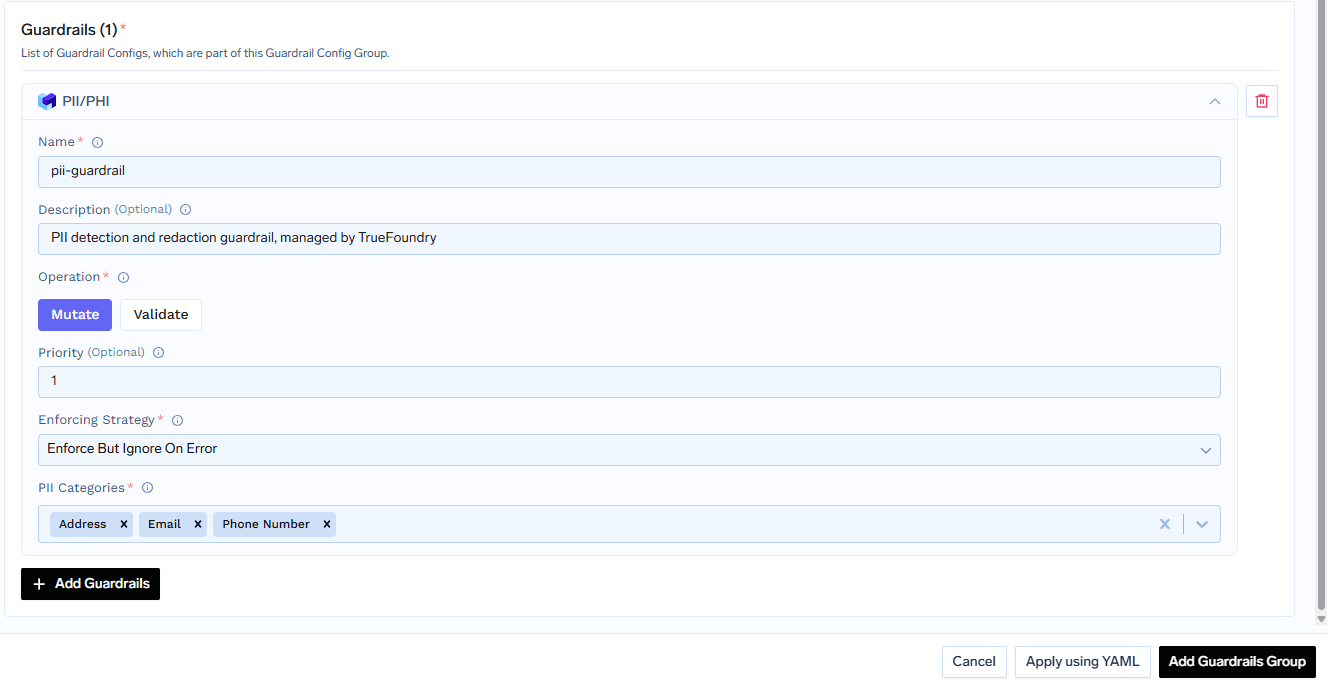
Ein gängiges Setup wendet die PII-Schwärzung auf LLM-Eingaben an, um Benutzernachrichten zu bereinigen, auf LLM-Ausgaben, um Antworten zu filtern, sowie auf MCP-Hooks, um PII aus Tool-Parametern und Tool-Ergebnissen, wie etwa Datenbankzeilen, zu entfernen.
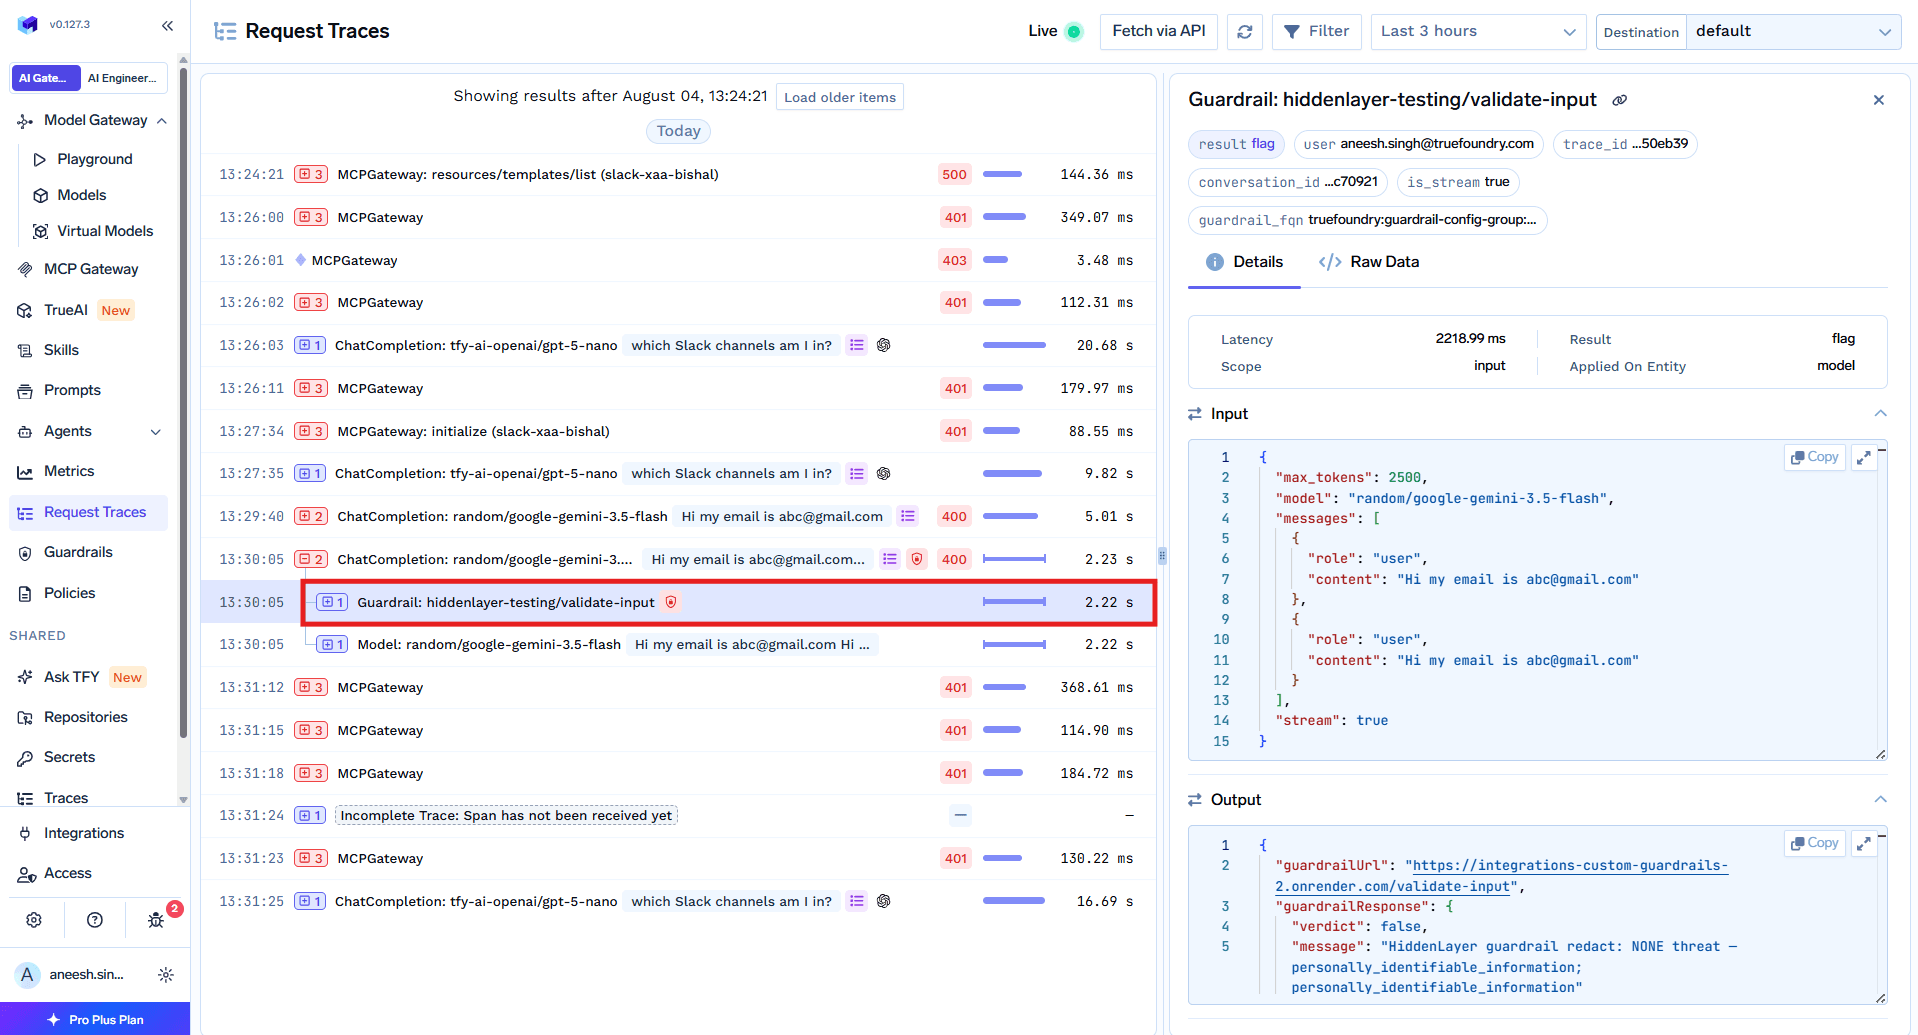
DiePrompt-Injection-Guardrail ist ein integrierter Guardrail, der auf Azure Prompt Shield basiert. Er erkennt direkte Prompt-Injection, Jailbreak-Angriffe wie das „Do Anything Now“-Muster sowie indirekte Injections, die in Dokumenten oder Kontextinhalten verborgen sind. Dabei werden der Benutzer-Prompt und der Dokumentinhalt separat analysiert.
Es wird ausschließlich der Validierungsmodus unterstützt, was bedeutet, dass Angriffe erkannt und blockiert, aber keine Inhalte verändert werden. Die Konfiguration erfordert lediglich einen Namen und eine Durchsetzungsstrategie. Die Dokumentation empfiehlt, mit der Audit-Strategie zu beginnen, um Erkennungen in Anforderungs-Traces zu überwachen, und erst auf „Enforce“ umzustellen, sobald Sie dem System vertrauen.
Bei einer LLM-Anfrage werden zuerst die Input-Mutation-Guardrails ausgeführt; sie blockieren den Prozess, bis sie abgeschlossen sind, beispielsweise um PII aus dem Prompt zu schwärzen. Die Eingabevalidierung, wie etwa die Prüfung auf Prompt-Injection, läuft anschließend im Hintergrund, während die Modellanfrage bereits verarbeitet wird. Sollte die Eingabevalidierung fehlschlagen, während das Modell noch arbeitet, bricht das Gateway die Modellanfrage sofort ab, damit keine Kosten entstehen.
Nachdem das Modell geantwortet hat, kann die Output-Mutation Geheimnisse entfernen, und die Output-Validierung prüft das Endergebnis, bevor es den Client erreicht. Bei MCP-Tools werden alle „Pre-Tool“-Guardrails vor dem Aufruf des Tools ausgeführt; schlägt einer davon fehl, wird das Tool nicht ausgeführt. Guardrails werden für jeden Tool-Aufruf separat ausgeführt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




TrueFoundry ships built in PII and PHI detection, powered by Azure AI Language, and prompt injection detection, powered by Azure Prompt Shield. Both are fully managed, with no external credentials required. You can also add external providers or custom guardrails.
On four hooks: LLM Input, LLM Output, MCP Tool Pre-Invoke, and MCP Tool Post-Invoke. You attach guardrails to the hooks you want in a policy rule, and multiple guardrails can run on the same hook.
If input validation fails while the model request is in flight, the gateway cancels that model request so you do not pay for it. Output validation runs after the model responds, so in that case the model cost is already incurred.
Start with the audit enforcing strategy so detections are recorded in request traces without blocking traffic. Once you are confident in the results, switch the strategy to enforce.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet
















