Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.
9,9
Kartierung des On-Prem-AI-Marktes: Von Chips bis zu Control Planes
Da Unternehmen GenAI zunehmend in die Produktion überführen, entdecken viele die Vorteile von On-Premise-Bereitstellungen neu – sei es zur Eindämmung von Cloud-Kosten, zur Erfüllung strenger Compliance-Anforderungen oder zur Bereitstellung extrem geringer Latenzzeiten. Ein On-Premise-AI-Stack ist jedoch kein einzelnes Gerät, das man einfach ins Rack schraubt und vergisst. Es handelt sich um ein vielschichtiges Ökosystem aus Hardware, Orchestrierung, Datenplattformen und Serving-Frameworks, die perfekt zusammenspielen müssen.
Dieser Leitfaden führt durch jede Schicht des modernen On-Prem-AI-Stacks und zeigt das Wertversprechen jeder einzelnen Komponente auf.
Warum On-Premise-AI an Fahrt gewinnt
Unternehmen in den Bereichen Finanzen, Gesundheitswesen, Fertigung und Behörden stehen vor strengeren Vorschriften zur Datensouveränität, steigenden Cloud-Rechnungen und Performance-SLAs, die die Public Cloud nicht immer erfüllen kann. Zusammen bilden diese Schichten das Fundament einer On-Premise-AI-Plattform, die Unternehmen unabhängig von den Einschränkungen der Public Cloud skalieren, steuern und betreiben können.
Datenkontrolle & Compliance: Halten Sie sensible Daten vollständig hinter Ihrer Firewall. Wenn Daten an eine Public Cloud gesendet werden, können deren genauer physischer Standort und die geltende Rechtsprechung unklar werden. Dies birgt erhebliche Compliance-Risiken und erschwert Audits. Eine On-Premise-Einrichtung ermöglicht es einem Unternehmen, seinen gesamten AI-Stack an diese Vorschriften anzupassen. So entsteht ein vertretbares Framework, das rechtliche Standards einhält und die Komplexität grenzüberschreitender Datenübertragungen vermeidet.
Performance & Latenz: Platzieren Sie Compute und Storage am selben Ort für Echtzeit-Inferenz. Durch die lokale Verarbeitung von Daten kann On-Premise-AI eine deutlich geringere und vor allem vorhersagbarere Latenz bieten. Diese konsistente, leistungsstarke Performance ist essenziell für Anwendungen, die sofortige, kreuzmodale Entscheidungen erfordern – wie die Analyse eines Sensordatenstroms beim Abgleich mit historischen Datensätzen. Dieser Performance-Vorteil erstreckt sich auch auf die Integration in bestehende Unternehmenssysteme. On-Premise-Lösungen lassen sich aufgrund ihrer Flexibilität und Anpassbarkeit oft einfacher und zuverlässiger in Legacy-Datenbanken, ERP-Systeme und andere Betriebstechnologien integrieren, die möglicherweise nicht mit standardisierten Cloud-Umgebungen kompatibel sind.
Kostenplanbarkeit: Wechseln Sie von variablen Pay-as-you-go-Tarifen zu festen Infrastrukturinvestitionen. Versteckte Gebühren für Daten-Egress, API-Aufrufe, Storage-Tiering und schwankende Compute-Preise können die anfänglichen Vorteile niedriger CapEx schnell zunichtemachen. Dies führt zu dem, was manche Analysen als „reine Verschwendung“ bei Cloud-Ausgaben bezeichnen. Im Gegensatz dazu bietet eine On-Premise-Bereitstellung trotz hoher Anfangskosten eine planbare, steuerbare langfristige OpEx. Für Unternehmen mit dauerhafter AI-Nutzung erweist sich eine On-Premise-Infrastruktur über einen Horizont von drei bis fünf Jahren oft als die kosteneffizientere Option.
Individuelle Integration: Binden Sie Legacy-Systeme, Edge-Geräte oder proprietäre Hardware nahtlos an.
Der eigenständige Aufbau und Betrieb dieses Stacks im eigenen Haus bringt jedoch Investitionskosten (CapEx), den Bedarf an spezialisierten Fachkräften und laufenden Wartungsaufwand mit sich.
Was ist ein moderner On-Premise-AI-Stack?
Ein moderner On-Premise-AI-Stack ist ein komplexes, mehrschichtiges System, bei dem jede Komponente eine entscheidende Rolle spielt. Es handelt sich nicht um eine monolithische Einheit, sondern um ein voneinander abhängiges Ökosystem aus Hardware und Software, das entwickelte AI-Funktionen robust, skalierbar und effizient bereitstellt. Das Verständnis dieses Stacks erfordert eine Dekonstruktion Schicht für Schicht – von der physischen Infrastruktur, die die reine Leistung liefert, bis hin zu den übergeordneten Plattformen, die den AI-Workflow ermöglichen.
Im Kern kombiniert ein On-Premise-AI-Stack Folgendes:
Jede Schicht muss so architekturiert sein, dass sie die Auslastung maximiert, Zuverlässigkeit gewährleistet und eine nahtlose Skalierung ermöglicht – ohne Sie an einen einzelnen Anbieter zu binden.
Hardware & Physische Infrastruktur
Dies ist das Fundament des gesamten AI-Stacks, die physische Manifestation von Rechenleistung. Sie umfasst die Compute-Engines, die die Berechnungen durchführen, die Speichersysteme, die die riesigen Datensätze aufnehmen, und das Netzwerk-Fabric, das alles miteinander verbindet. Die Performance und die Grenzen dieser Schicht bestimmen das Potenzial aller nachfolgenden Schichten.
Compute-Engines
GPUs: Ursprünglich für das Rendering von 3D-Grafiken entwickelt, haben sich GPUs aufgrund ihrer massiv parallelen Architektur zum Arbeitspferd der AI-Revolution entwickelt. NVIDIA hat sich mit seinen Rechenzentrums-GPUs wie der A100, H100 und der kommenden B200-Serie eine dominante Position in diesem Markt erarbeitet. Diese Chips, die mit Tausenden von spezialisierten Kernen (z. B. Tensor Cores) ausgestattet sind, können bei der AI-Training-Performance bis zu 20-mal schneller sein als traditionelle CPUs. Sie sind der derzeitige De-facto-Standard für den Aufbau hochperformanter On-Premise-AI-Trainingscluster.
CPUs: Während GPUs die Hauptlast der parallelen Verarbeitung übernehmen, bleiben CPUs essenzielle Komponenten des AI-Servers. Sie verwalten die gesamten Systemoperationen, verarbeiten sequentielle Aufgaben und orchestrieren den Datenfluss zu und von den GPUs. Die neueste Generation von Multi-Core-CPUs von Intel und AMD bietet die notwendige Allzweck-Rechenleistung zur Unterstützung der spezialisierten Beschleuniger.
ASICs/TPUs: Der aufstrebende und disruptive Trend beim AI-Computing ist der Vormarsch anwendungsspezifischer integrierter Schaltungen (ASICs). Dabei handelt es sich um Chips, die von Grund auf für einen einzigen Zweck entwickelt wurden: die Ausführung von AI-Workloads. Googles Tensor Processing Units (TPUs) sind ein Paradebeispiel dafür, optimiert für die Matrixoperationen im Herzen neuronaler Netze. Auf dem On-Premise-Markt fordert eine neue Klasse von Start-ups das GPU-Monopol mit spezialisierten ASICs heraus. Unternehmen wie Groq entwickeln Chips für Inferenz mit extrem geringer Latenz, während SambaNova Systems und Cerebras neuartige Architekturen (Reconfigurable Dataflow Units bzw. Wafer-Scale Engines) entwickeln, die eine bessere TCO und Energieeffizienz für großflächiges Training und Inferenz versprechen. Diese spezialisierten Beschleuniger repräsentieren die Zukunft der AI-Hardware und bieten einen Weg über die Energie- und Kostengrenzen universeller GPUs hinaus.
Enterprise-Server & Storage
High-Performance-Server: Führende Enterprise-Hardware-Anbieter wie Hewlett Packard Enterprise (HPE) mit seinen ProLiant- und Apollo-Linien, Dell Technologies mit seinen PowerEdge-Servern, Supermicro und IBM mit seinen Power Systems stellen das Server-Chassis für On-Premise-AI bereit. Dies sind keine Standard-Server; sie sind speziell dafür ausgelegt, mehrere Hochleistungs-GPUs aufzunehmen, massive Mengen an Hochgeschwindigkeitsspeicher (RAM) bereitzustellen und fortschrittliche Kühlungslösungen zu integrieren, um die Wärmeabgabe der Beschleuniger zu bewältigen.
High-Performance-Storage: AI wird durch Daten angetrieben, und die Speicherschicht muss einen schnellen, parallelen Zugriff auf riesige Datensätze bieten, ohne einen Engpass zu erzeugen. Dies erfordert einen Schritt über traditionelle Speicher hinaus. Hochleistungsfähige Storage-Lösungen mit geringer Latenz wie NVMe (Non-Volatile Memory Express) SSDs und verteilte Dateisysteme sind unerlässlich. Die Daten selbst werden typischerweise in Data Lakes zur Speicherung riesiger Mengen unstrukturierter Rohdaten (Bilder, Text, Logs) und in Data Warehouses für strukturierte, analysebereite Daten organisiert. Eine kritische, neue Komponente – insbesondere für generative AI – ist die Vektordatenbank, die für das Speichern und Abfragen hochdimensionaler Vektor-Embeddings optimiert ist, die unstrukturierte Daten repräsentieren.
High-Speed-Networking
InfiniBand & RDMA Fabrics liefern bis zu 400 Gbps Durchsatz mit geringer Latenz und stellen sicher, dass GPUs während des distributed Trainings oder der parallelen Inferenz kontinuierlich mit Daten versorgt werden. Die Netzwerk-Schicht ist das „Nervensystem“ des AI-Rechenzentrums, verantwortlich für den nahtlosen Datentransfer zwischen den Speichersystemen und den Compute-Knoten. Für großskalierte AI – insbesondere verteiltes Training, bei dem ein einzelnes Modell über Hunderte oder Tausende von GPUs hinweg trainiert wird – ist Standard-Ethernet-Networking unzureichend und kann zu einem enormen Performance-Engpass werden. Um zu verhindern, dass die leistungsstarken GPUs ungenutzt auf Daten warten, setzen On-Premise-AI-Cluster auf Netzwerke mit hoher Bandbreite und geringer Latenz. Technologien wie InfiniBand und RDMA (Remote Direct Memory Access) sind entscheidend. InfiniBand beispielsweise kann einen Durchsatz von bis zu 400 Gigabit pro Sekunde unterstützen. So wird sichergestellt, dass Daten zwischen Servern und Speichern mit der Geschwindigkeit bewegt werden können, die erforderlich ist, um die Compute-Engines voll auszulasten. Dieses High-Speed-Interconnect ist eine unverzichtbare Komponente jeder ernsthaften On-Premise-AI-Infrastruktur.
Die Orchestrierungs- und Verwaltungsschicht
Oberhalb der physischen Hardware besteht die Orchestrierungs- und Verwaltungsschicht aus der Software, die die zugrunde liegenden Ressourcen abstrahiert, partitioniert und verwaltet. Diese Schicht verwandelt eine starre Ansammlung physischer Server in eine flexible, skalierbare und effiziente Plattform für die Entwicklung und den Betrieb von AI-Anwendungen.
Die Rolle von Virtualisierung und Containerisierung
Die grundlegenden Technologien für das Ressourcenmanagement sind Virtualisierung und Containerisierung. Sie ermöglichen die effiziente Partitionierung und Isolierung von Workloads.
Virtuelle Maschinen (VMs): Virtualisierung ist seit Jahrzehnten ein Hauptbestandteil von Rechenzentren. Ein Hypervisor erzeugt mehrere virtuelle Maschinen auf einem einzelnen physischen Server, jede mit ihrem eigenen vollständigen Betriebssystem. Obwohl robust und bewährt, haben VMs im Vergleich zu Containern einen größeren Ressourcen-Fußabdruck und langsamere Startzeiten. Sie bleiben jedoch relevant, insbesondere für die Modernisierung von Legacy-Anwendungen neben neuen AI-Workloads. Plattformen wie IBM Fusion und Vates VMS wurden speziell entwickelt, um eine einheitliche On-Premise-Plattform bereitzustellen, die sowohl VMs als auch Container verwalten kann, oft mit Funktionen wie direktem GPU-Zugriff.
Container (z. B. Docker): Containerisierung ist der moderne, leichtgewichtige Ansatz zur Isolierung von Workloads. Ein Container verpackt eine Anwendung und all ihre Abhängigkeiten (Bibliotheken, Konfigurationsdateien) in eine einzige, portable Einheit, die sich den Kernel des Host-Betriebssystems teilt. Dies führt zu einem deutlich kleineren Fußabdruck, schnelleren Startzeiten und einer höheren Ressourceneffizienz als bei VMs. Für AI bedeutet dies, dass ein Modell und seine spezifische Umgebung in einem unveränderlichen Container-Image gekapselt werden können. Dieses Image kann dann konsistent auf dem Laptop eines Entwicklers, einem Testserver und dem Produktionscluster bereitgestellt werden. Das eliminiert das Problem „Auf meinem Rechner hat es funktioniert“ und stellt die Reproduzierbarkeit sicher.
Kubernetes: Das Betriebssystem für das AI-Rechenzentrum
Während Docker das Container-Format bereitstellt, liefert Kubernetes das Management auf Skalierungsebene. Kubernetes ist eine Open-Source-Plattform, die die Bereitstellung, Skalierung, Vernetzung und Verwaltung containerisierter Anwendungen über einen Cluster von Maschinen hinweg automatisiert. Es hat sich zum unangefochtenen Standard für die Container-Orchestrierung entwickelt und ist die Engine hinter den meisten modernen cloud-nativen Anwendungen – egal ob in der Public Cloud oder On-Premise.
Für On-Premise-AI ist Kubernetes das entscheidende Bindeglied zwischen der Anwendungsschicht und der Hardware. Enterprise-Kubernetes-Distributionen wie Red Hat OpenShift wurden speziell für On-Premise- und Hybrid-Cloud-Bereitstellungen entwickelt und bieten die Sicherheit, das Management und den Support, die Unternehmen benötigen.
Die Vorteile der Nutzung von Kubernetes für AI-Workloads sind tiefgreifend:
Automatisierte Skalierung und Load Balancing: Kubernetes kann die Anzahl der Container-Replikate je nach Rechenbedarf automatisch hoch- oder herunterskalieren und Inferenz-Anfragen auf diese verteilen, was eine hohe Verfügbarkeit und Performance gewährleistet.
Ressourcenmanagement und Scheduling: Kubernetes verfügt über GPU-aware Scheduling-Funktionen. Dadurch kann es AI-Workloads intelligent auf Knoten platzieren, die über die erforderliche Beschleuniger-Hardware verfügen, was die Auslastung dieser teuren Ressourcen maximiert.
Resilienz und Self-Healing: Fällt ein Container oder ein Knoten aus, kann Kubernetes ihn automatisch neu starten oder auf einem gesunden Knoten neu einplanen. Das bietet die notwendige Resilienz für lang laufende Modell-Trainingsjobs und geschäftskritische Inferenz-Dienste.
Im Wesentlichen bietet Kubernetes das dynamische, automatisierte und resiliente Betriebssystem für das On-Premise-AI-Rechenzentrum.
Daten & ML Enablement
Datenplattformen & Governance
Dies ist die höchste Software-Schicht des Stacks. Sie enthält die spezialisierten Tools und Plattformen, die Data Scientists und Machine Learning Engineers nutzen, um den gesamten AI-Lebenszyklus auszuführen. Diese Schicht nutzt die zugrunde liegende Hardware und Orchestrierung, um Daten zu verwalten sowie AI-Modelle zu bauen, zu trainieren, bereitzustellen und zu überwachen.
Das Data Fabric (Datenplattformen)
Bevor ein Modell gebaut werden kann, müssen Daten verwaltet werden. Datenplattformen bieten eine einheitliche Umgebung für den gesamten Datenlebenszyklus – von der Erfassung und Verarbeitung bis hin zur Speicherung und Governance.
Cloudera Data Platform (CDP): Als dominierender Akteur in der On-Premise- und Hybrid-Datenlandschaft hat sich Cloudera von seinen Wurzeln im Hadoop-Ökosystem zu einer umfassenden Enterprise-Datenplattform entwickelt. Das Angebot CDP Private Cloud ist speziell für den On-Premise-Betrieb konzipiert, typischerweise auf einem Kubernetes-Cluster wie Red Hat OpenShift. Es bietet eine einheitliche, offene Data Lakehouse-Architektur, die sowohl strukturierte als auch unstrukturierte Daten im Petabyte-Bereich verarbeiten kann. Entscheidend für Enterprise-AI ist die Integration robuster, zentralisierter Sicherheit durch Apache Ranger und eines einheitlichen Governance- und Metadaten-Frameworks namens Shared Data Experience (SDX). So wird sichergestellt, dass konsistente Sicherheitsrichtlinien auf alle Daten und Analysen in der hybriden Umgebung angewendet werden.
Databricks und hybride Konnektivität: Obwohl Databricks primär eine cloud-native Plattform ist, führt ihre Bedeutung im AI-Bereich dazu, dass viele Unternehmen Lösungen bauen, um ihre On-Premise-Datenquellen (wie einen Cloudera-Cluster) mit ihrer Databricks-Umgebung zu verbinden. Diese Realität unterstreicht den hybriden Charakter moderner Enterprise-AI, bei dem die Data Gravity es oft erforderlich macht, große Datensätze On-Premise zu halten, während für bestimmte Analysen oder kollaborative Aufgaben cloudbasierte Tools genutzt werden.
MLOps & Experimentierung
MLOps (Machine Learning Operations) ist eine Reihe von Praktiken, die darauf abzielen, Machine-Learning-Modelle zuverlässig und effizient in der Produktion bereitzustellen und zu warten. MLOps-Plattformen sind die Werkzeuge, die diese Praktiken ermöglichen, indem sie den gesamten ML-Lebenszyklus automatisieren und die Lücke zwischen Data Science (Modellbau) und IT-Operations (Produktionsbetrieb) schließen.
Zu den Kernfunktionen einer MLOps-Plattform gehören: Experiment-Tracking (Protokollierung aller Parameter, Metriken und Artefakte), Modell-Versionierung und -Registrierung, der Aufbau automatisierter CI/CD-Pipelines (Continuous Integration/Continuous Deployment) für Modelle, das Management von Modell-Deployments und das Monitoring der Modell-Performance auf Probleme wie Data Drift.
Der On-Premise-MLOps-Markt bietet eine Mischung aus leistungsstarken Open-Source- und kommerziellen Plattformen:
Open-Source:MLflow ist eine führende Open-Source-MLOps-Plattform, die weit verbreitet ist aufgrund ihrer Flexibilität, ihres Framework-agnostischen Ansatzes und ihrer umfassenden Funktionen für Experiment-Tracking und Modellmanagement. Sie ermöglicht es Teams, robuste MLOps-Workflows ohne Vendor-Lock-in aufzubauen.
Kommerzielle Plattformen: Verwaltete End-to-End-Plattformen wie DataRobot oder Iguazio (von McKinsey übernommne) bieten umfassende Lösungen, die den gesamten Lebenszyklus abdecken – oft mit Fokus auf Benutzerfreundlichkeit, Automatisierung und Enterprise-Grade-Support.
Ergänzen Sie Ihre Plattformwahl mit dem AI Gateway von TrueFoundry für RBAC, Guardrails und Budgets, um sicherzustellen, dass Richtlinien nahtlos über Teams und Modelle hinweg durchgesetzt werden.
Serving & Skalierung von AI in der Produktion
Sobald ein Modell trainiert und validiert ist, muss es in einer Produktionsumgebung bereitgestellt werden, in der es Eingabedaten empfangen und Vorhersagen zurückgeben kann – ein Prozess namens Inferenz. Modell-Serving ist eine spezialisierte Aufgabe, die Software erfordert, die für hohen Durchsatz und geringe Latenz optimiert ist.
NVIDIA Triton Inference Server: Ein hochperformanter Open-Source-Inferenz-Server von NVIDIA. Seine Hauptstärken sind die Fähigkeit, Modelle aus fast jedem Framework (TensorFlow, PyTorch, ONNX etc.) auszuführen, und seine Kapazität für die parallele Modellausführung. Letztere ermöglicht es, mehrere Modelle oder mehrere Instanzen desselben Modells auf einer einzigen GPU auszuführen, was die Hardwareauslastung maximiert.
KServe: Ein Standard für Modell-Serving auf Kubernetes. KServe bietet eine skalierbare und erweiterbare Plattform zur Bereitstellung von Modellen. Zu den herausragenden Funktionen gehören Serverless-Inferenz-Funktionen (mit Autoscaling, das Pods bei Nichtgebrauch auf null herunterskalieren kann, um Ressourcen zu sparen) und ein „InferenceGraph“, der fortschrittliche Bereitstellungsstrategien wie Canary-Rollouts, A/B-Testing und Modell-Ensembles unterstützt.
Seldon Core: Eine weitere leistungsstarke Open-Source-Plattform für Modell-Serving auf Kubernetes. Seldon Core ist ebenfalls bekannt für seine robuste Unterstützung fortgeschrittener Bereitstellungsmuster, einschließlich A/B-Tests, Canary-Deployments und Multi-Armed Bandits (MABs). Das macht es zu einer starken Wahl für Unternehmen, die Modelle in der Produktion streng testen und optimieren müssen.
Weitere Frameworks: Das Ökosystem umfasst auch andere leistungsstarke Open-Source-Tools wie Haystack, ein Framework zum Aufbau komplexer Agenten- und RAG-Pipelines, und Ray, eine verteilte Compute-Engine, die oft als Rückgrat für das Training und Serving großskalierter AI-Anwendungen dient.
TrueFoundry agiert als Gateway/Control Plane oberhalb dieser Server. So können Sie flexibel kombinieren (Triton für CV-Modelle, vLLM für LLMs, KServe für Serverless Edges) und gleichzeitig eine konsistente Schnittstelle, Richtlinien- und Telemetrieschicht beibehalten.
Die Anwendungs- und Steuerungsschicht: AI Gateway und MCP
Die bisher beschriebenen Schichten bieten das Fundament für den Aufbau und Betrieb von AI-Modellen. Um diese Modelle jedoch für Endbenutzer-Anwendungen sicher und effizient zugänglich zu machen und komplexe, agentische Workflows zu ermöglichen, ist eine finale Software-Schicht erforderlich: die Anwendungs- und Steuerungsschicht. Diese Schicht fungiert als zentrales Nervensystem für alle AI-Interaktionen und bietet Governance, Sicherheit sowie eine standardisierte Schnittstelle für die Kommunikation. Sie besteht aus zwei kritischen, aufstrebenden Komponenten: dem AI Gateway und dem Model Context Protocol (MCP).
Das AI Gateway: Eine zentrale Control Plane
Ein AI Gateway ist eine spezialisierte Middleware, die als einziger, zentraler Steuerungspunkt für den gesamten AI-bezogenen Datenverkehr zwischen Anwendungen und den zugrunde liegenden AI-Modellen dient. Innerhalb der On-Premise-Umgebung (oft auf Kubernetes) bereitgestellt, bietet es eine Reihe kritischer Funktionen zur Verwaltung von AI im Unternehmensmaßstab.
Einheitlicher Zugriff und intelligentes Routing: Das Gateway bietet Entwicklern einen einzigen, konsistenten API-Endpunkt und abstrahiert die Komplexität der Interaktion mit mehreren verschiedenen Modellen (z. B. einer Mischung aus feingetunten Open-Source-Modellen und spezialisierten kommerziellen Modellen). Es kann kontextbasiertes Routing durchführen und Anfragen basierend auf Faktoren wie Kosten, Performance-Anforderungen oder dem spezifischen Anwendungsfall an das am besten geeignete Modell leiten, was sowohl die Effizienz als auch die Ergebnisse optimiert.
Robuste Sicherheit und Governance: Bei On-Premise-AI ist Sicherheit von größter Bedeutung. Das AI Gateway fungiert als Durchsetzungspunkt für Richtlinien (Policy Enforcement Point) und lässt sich in die Enterprise-Sicherheitsarchitektur integrieren, um Authentifizierung, Autorisierung und rollenbasierte Zugriffskontrolle (RBAC) zu verwalten. Es prüft sowohl eingehende Prompts als auch ausgehende Antworten in Echtzeit, um Prompt-Injection-Angriffe und das Durchsickern sensibler Informationen wie personenbezogener Daten (PII) zu verhindern. So wird die Einhaltung von Vorschriften wie DSGVO und HIPAA sichergestellt.
Umfassende Observability und Kostenkontrolle: Das Gateway bietet ein einheitliches Dashboard zur Überwachung aller AI-Interaktionen und verfolgt Schlüsselmetriken wie Latenz, Fehlerraten und Token-Nutzung. Diese zentralisierte Observability ist entscheidend für die Fehlersuche und Performance-Optimierung. Darüber hinaus ermöglicht sie eine feingranulare Kostenkontrolle durch die Durchsetzung von Token-basierten Rate-Limits und Nutzungsbudgets, was unkontrollierte Kosten verhindert und eine genaue Leistungsverrechnung (Chargeback) an verschiedene Geschäftsbereiche ermöglicht.
Das Model Context Protocol (MCP): Die universelle Sprache für AI-Agenten
Während das AI Gateway den Fluss der Anfragen verwaltet, ist das Model Context Protocol (MCP) ein offener Standard, der revolutioniert, was diese Anfragen tun können. MCP bietet eine standardisierte Möglichkeit für AI-Modelle, externe Tools, Daten und Dienste zu entdecken und mit ihnen zu interagieren. So werden aus isolierten „Gehirnen“ fähige, integrierte Agenten.
Eine standardisierte Schnittstelle für Tools: Anstatt anfälligen, benutzerdefinierten Code für jede Integration zu schreiben, ermöglicht MCP Unternehmenssystemen (wie Datenbanken, CRMs oder internen APIs), ihre Funktionen über einen leichtgewichtigen "MCP server" bereitzustellen. Die AI-Anwendung, die als "MCP host" fungiert, kann diese Server dann abfragen, um zu verstehen, welche Tools verfügbar sind und wie sie verwendet werden. Dadurch entsteht effektiv ein Plug-and-Play-Ökosystem für AI Agents.
Ermöglichung von On-Premise Agentic AI: Ein entscheidender Vorteil von MCP ist, dass es sich um ein offenes, auditierbares Protokoll handelt, das vollständig innerhalb der Firewall eines Unternehmens bereitgestellt werden kann. Dies ermöglicht es Unternehmen, leistungsstarke, autonome AI Agents zu entwickeln, die sicher mit proprietären internen Systemen interagieren können, ohne sensible Daten an externe Dienste preiszugeben.
Vermeidung von Vendor Lock-in: Da MCP ein modellagnostischer Standard ist, der von führenden Akteuren wie Anthropic, OpenAI und Microsoft unterstützt wird, entkoppelt es das AI-Modell von den Tool-Integrationen. Dies gibt Unternehmen die Flexibilität, das zugrunde liegende LLM auszutauschen – beispielsweise von einer kommerziellen API zu einem selbst gehosteten, feineingestellten Modell –, ohne den gesamten Integrations-Stack neu aufbauen zu müssen, und wahrt so die technologische Souveränität.
Zusammen bilden das AI Gateway und MCP eine leistungsstarke Steuerungs- und Anwendungsschicht, die On-Premise AI nicht nur möglich, sondern auch sicher, verwaltbar und genuin in das Gefüge des Unternehmens integriert macht.
Das MCP Gateway von TrueFoundry kombiniert beides: Governance und Observability für jede Anfrage sowie sichere, auditierte Tool-Aufrufe über MCP, damit Agents auf Ihren internen Systemen agieren können, ohne dass Daten Ihr Netzwerk verlassen.
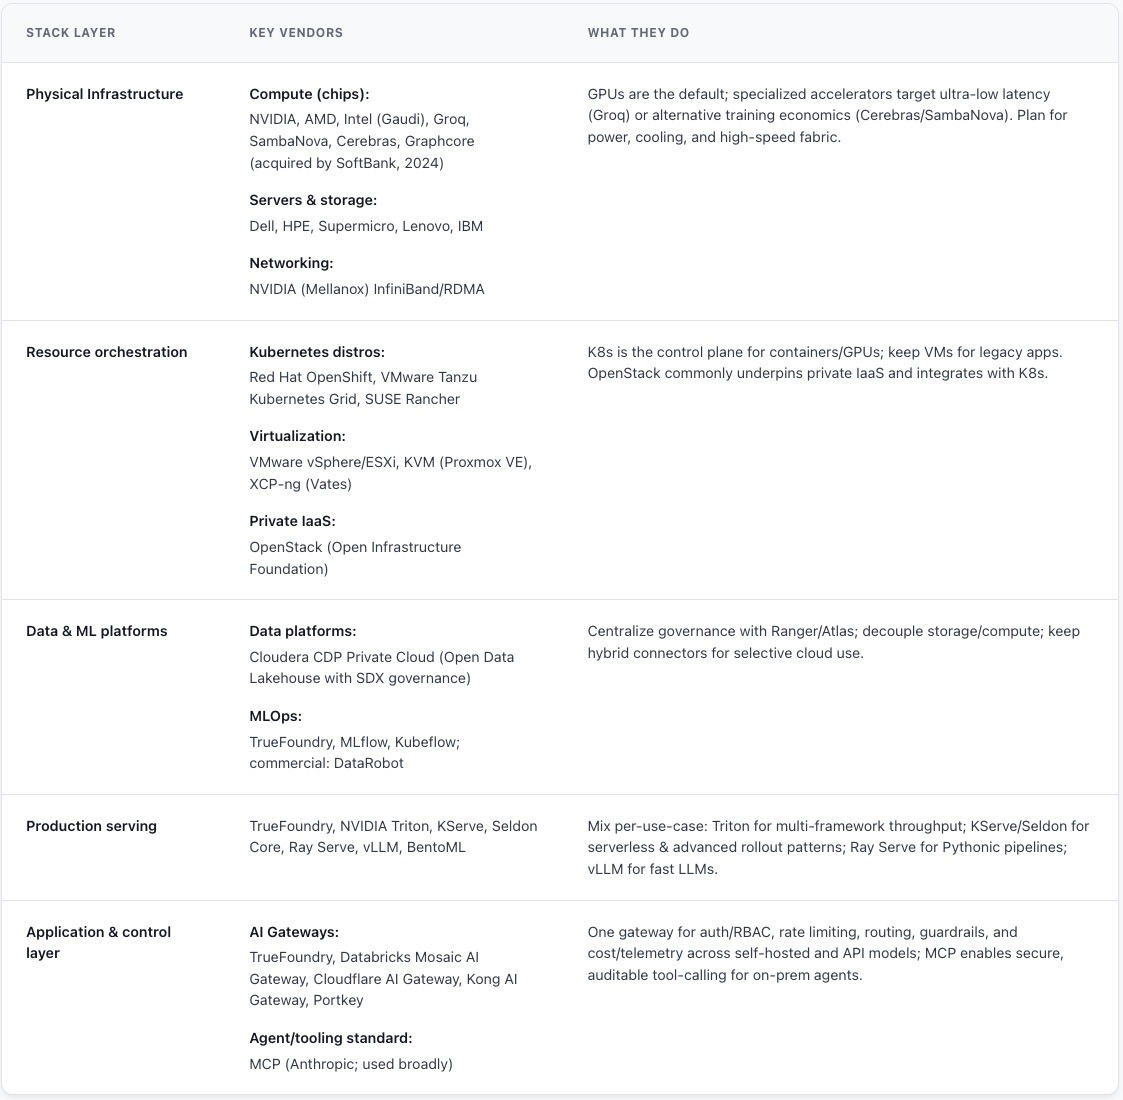
Anbieter-Zuordnung über den gesamten On-Premise AI Stack
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.
Auf Geschwindigkeit ausgelegt: ~ 10 ms Latenz, auch unter Last