



October 9, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 9, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Auf der Startseite von OpenRouter hieß es früher, dass etwa 25 ms zwischen den Nutzern und der Inferenz liegen, und viele Anleitungen wiederholen diesen Wert bis heute. Die Startseite selbst spricht mittlerweile nur noch von „minimaler Latenz“. Bei Claude haben wir mehrfach gemessen, dass diese Zeit vor dem Eintreffen des ersten Tokens anfällt, während die größeren Kosten erst danach entstehen.
Die Messungen beziehen sich auf Anthropic: Wie viel OpenRouter hinzufügt, wo die Zeit verloren geht und warum unser eigener Anthropic-Schlüssel den Großteil davon eliminiert hat. Ein Durchlauf verwendete kurze Prompts. Der andere nutzte Prompts mit bis zu 20.000 Token. Die Grenzen beider Durchläufe finden sich im Abschnitt über das, was wir nicht getestet haben; sie begrenzen die Zahlen ebenso wie die Mediane.
Jede Anfrage wurde auf drei Wegen gestellt: direkt an die API von Anthropic, über OpenRouter mit Abrechnung über OpenRouter-Guthaben und über OpenRouter mit unserem eigenen Anthropic-Schlüssel (BYOK). Die gleichen Prompts wurden auf jedem Weg ausgeführt, verschachtelt und mit abwechselnder Reihenfolge pro Prompt, sodass sich Netzwerk-Schwankungen auf alle drei Wege gleichermaßen auswirkten. Jeder Vergleich ist gepaart: Jeder Prompt wird mit sich selbst auf einem anderen Weg verglichen, sodass sich der Inhalt des Prompts bei der Differenzberechnung aufhebt.
Die OpenRouter-Anfragen waren auf den eigenen Endpunkt von Anthropic festgelegt, nicht auf Bedrock oder Vertex, wobei Fallbacks deaktiviert waren. Wir haben bei jeder Antwort überprüft, welcher Endpunkt sie bereitgestellt hat und ob unser Schlüssel verwendet wurde. Die Temperatur war auf 0 eingestellt und Verbindungen wurden wiederverwendet.
Es gab zwei Durchläufe. Am 7. September zwei separate Sitzungen mit jeweils 100 kurzen Prompts (4 bis 37 Token lang), die aus öffentlichen Datensätzen stammten. Am 14. September 99 Prompts, die auf drei Größen aufgefüllt wurden: 200 Eingabe-Token mit 100 Ausgabe-Token, 2.000 mit 500 und 20.000 mit 1.000. Alles wurde von einem Laptop über WLAN in einem Privathaushalt über den Los Angeles Edge von OpenRouter ausgeführt. Das erhöht die absolute Latenz, daher berichten wir nur über die Unterschiede zwischen den Routen, was durch die Paarung valide ist.
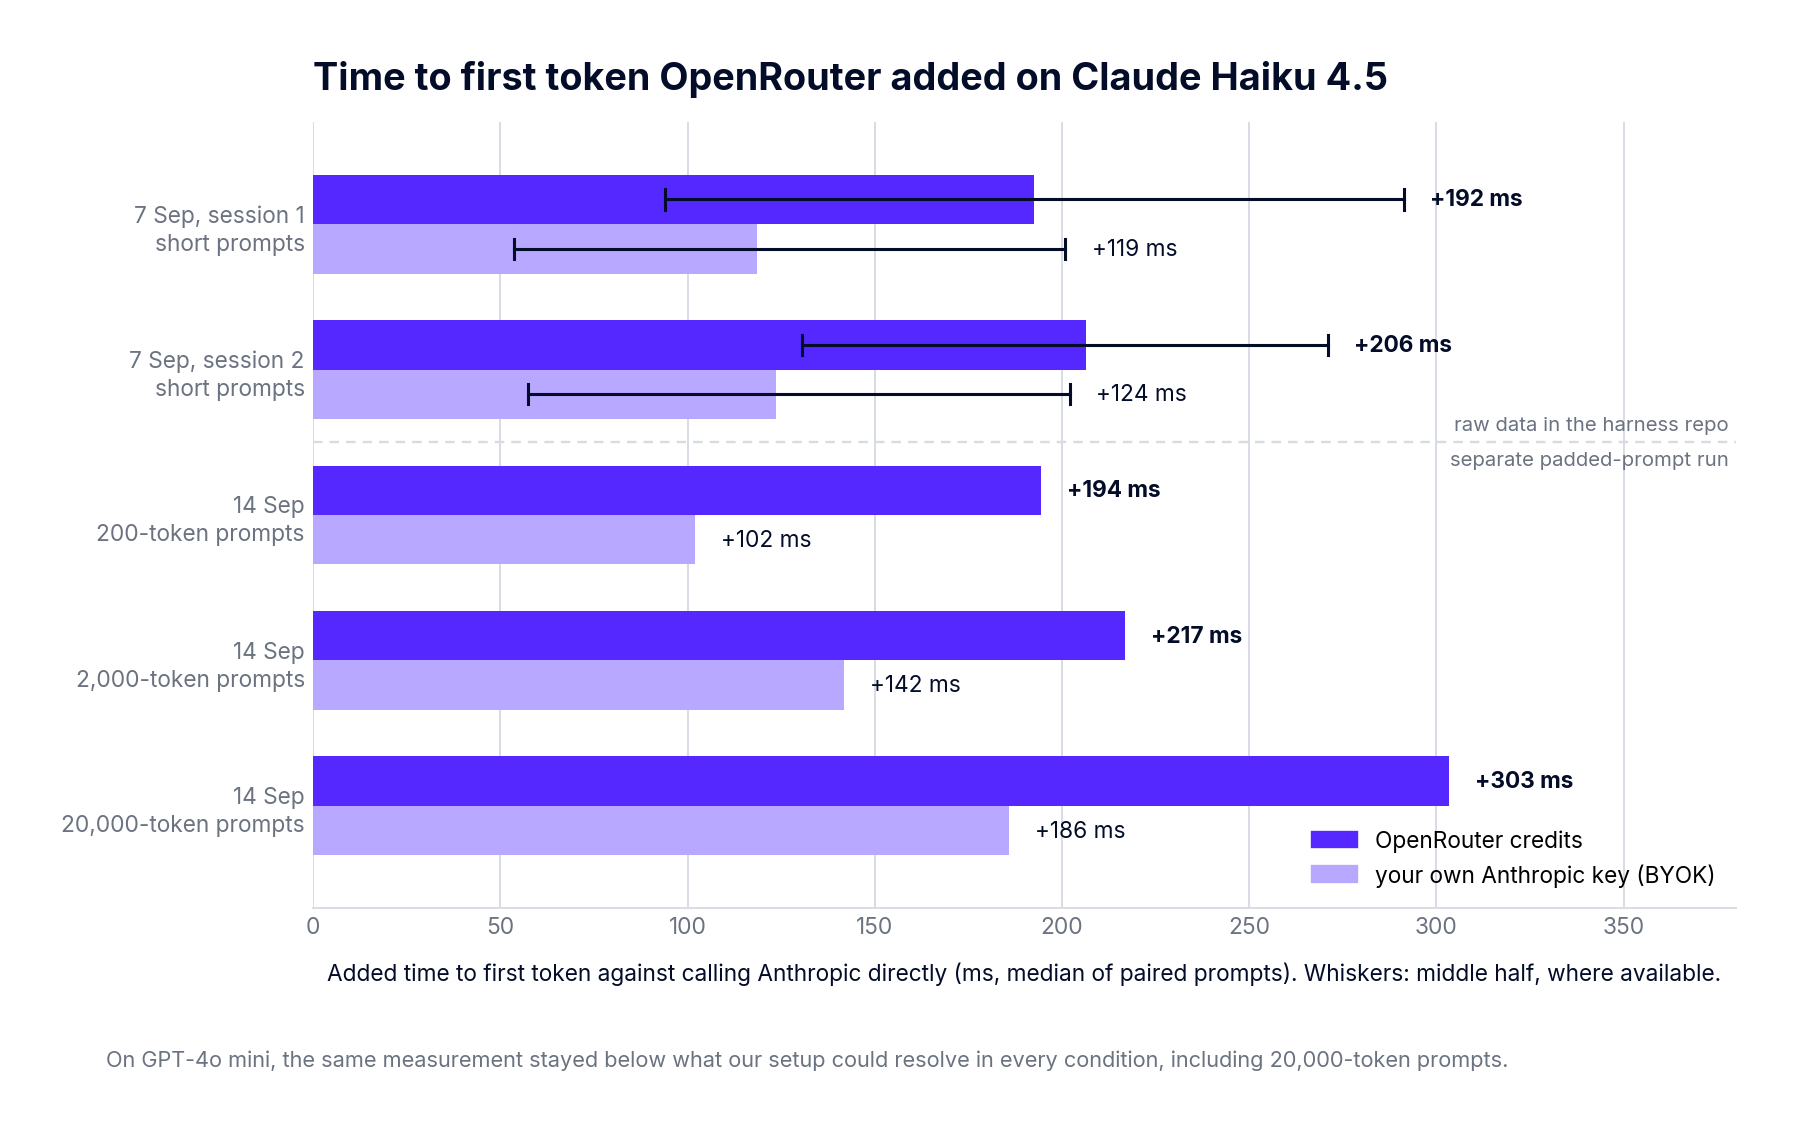
Die Kosten für das erste Token waren stabil. Bei Guthaben lagen sie in der ersten Sitzung bei 192 ms und in der zweiten bei 206 ms, sowie eine Woche später bei 200 Token bei 194 ms. Mit unserem eigenen Schlüssel waren es 119, 124 und 102 ms. Zwei Durchläufe im Abstand von einer Woche mit unterschiedlichen Prompt-Sets, die innerhalb von etwa 20 ms voneinander liegen, sind so viel Replikation, wie ein clientseitiger Test bieten kann. Über vier Sitzungen hinweg, in denen Guthaben und unser eigener Schlüssel nebeneinander liefen, war die Guthaben-Variante jedes Mal langsamer bis zum ersten Token, mit einem Median von 50 bis 115 ms.
Sie wächst auch mit der Prompt-Größe. Von 200 auf 20.000 Eingabe-Token stieg die zusätzliche Zeit bis zum ersten Token bei Guthaben von 194 auf 303 ms und mit unserem eigenen Schlüssel von 102 auf 186 ms. Das Wachstum ist sublinear, etwa das 1,6- bis 1,8-Fache bei hundertfacher Eingabe, und wurde erst bei 20.000 Token sichtbar; ein früherer Durchlauf, der bei 5.000 endete, ergab nichts. Bei den Durchläufen mit kurzen Prompts, bei denen die Eingaben nur zwischen 4 und 37 Token lagen, gab es überhaupt keinen Zusammenhang.
Bei GPT-4o mini blieb dieselbe Messung unter allen Bedingungen, einschließlich 20.000-Token-Prompts, innerhalb des Rauschens. Die mediane zusätzliche Zeit bis zum ersten Token betrug bei Guthaben 19,7 ms, aber die mittlere Hälfte der Ergebnisse reichte von 85 ms schneller bis 157 ms langsamer als der direkte Weg, sodass der tatsächliche Wert kleiner ist, als unser Setup auflösen kann.
Die Zeit bis zum ersten Token ist nur ein Teil einer gestreamten Antwort. Die Aufteilung jeder Antwort in die Wartezeit auf das erste Token und die Zeit für das Streamen des Rests zeigt zwei separate Kostenfaktoren.
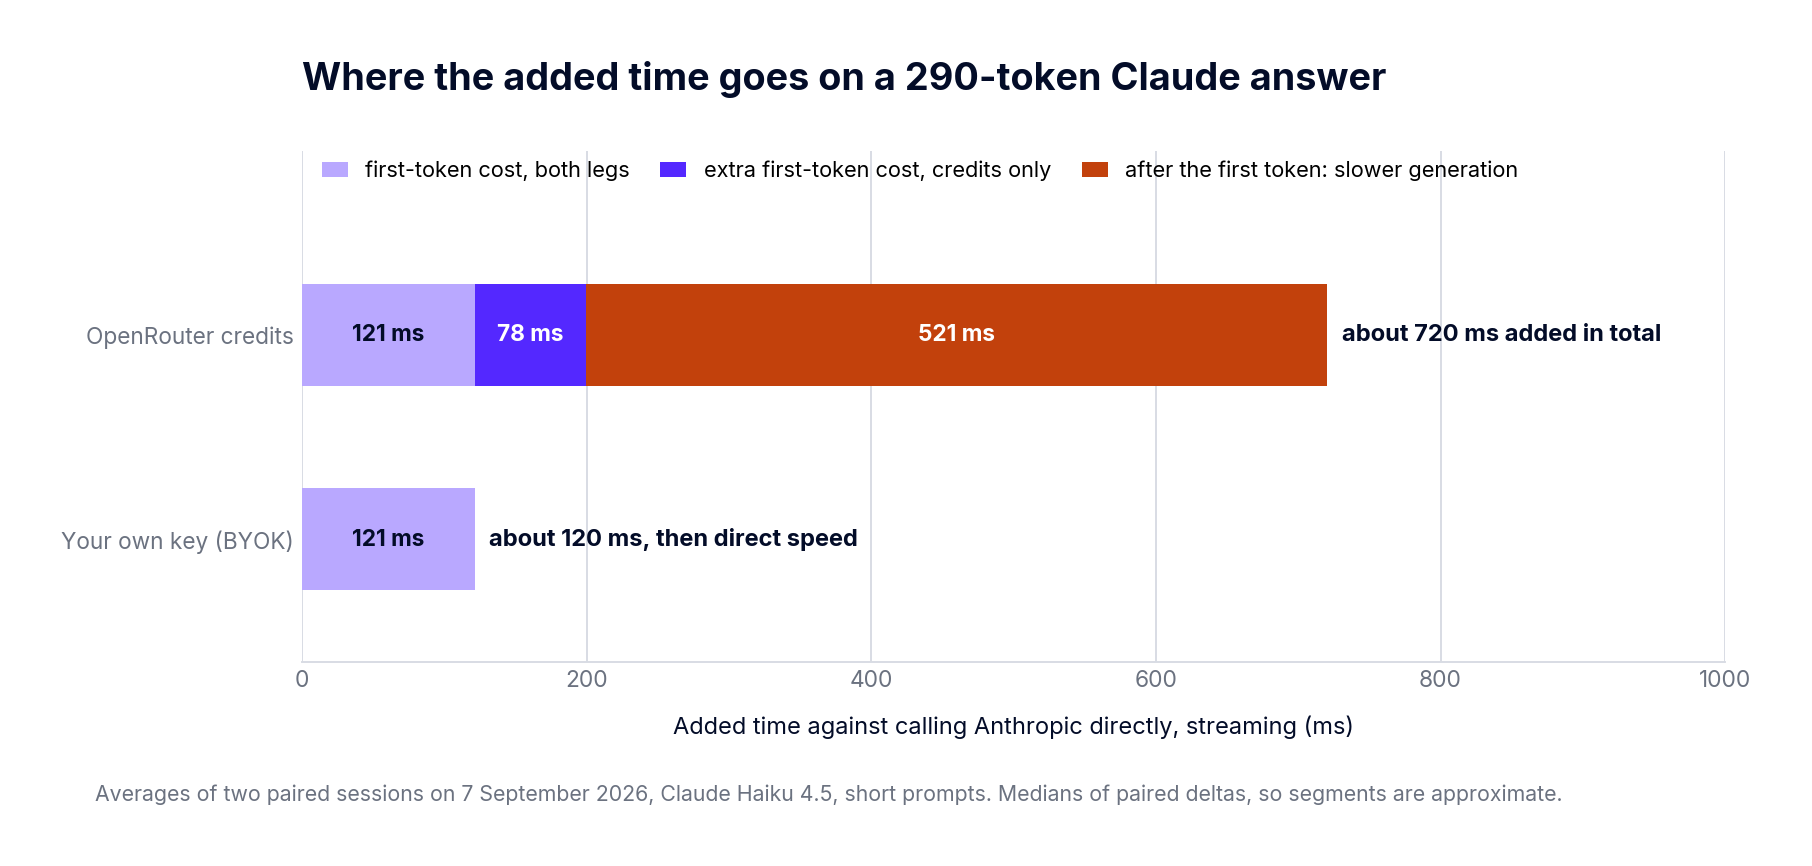
Mit unserem eigenen Schlüssel fügte OpenRouter etwa 120 ms vor dem ersten Token hinzu und danach nichts mehr. Unser Schlüssel streamte in den beiden Sitzungen mit 115 bzw. 116 Token pro Sekunde, verglichen mit 115 und 113 beim direkten Weg. Was auch immer diese Kosten sind, sie werden einmalig im Voraus bezahlt.
Bei Guthaben streamten dieselben Antworten langsamer, mit 94 und 95 Token pro Sekunde, also etwa 17 % langsamer. Die Antworten waren nicht länger: Der Median der Ausgabe lag auf jeder Route bei etwa 290 Token. Bei einer 290-Token-Antwort fügt dieser langsamere Stream zusätzlich zu den Kosten für das erste Token etwa 520 ms hinzu. Die Rechnung geht auf: 290 Token bei 94 statt 114 Token pro Sekunde ergeben etwa 540 ms, plus etwa 200 ms bis zum ersten Token, gegenüber den 711 und 730 ms, die wir für die vollständige Antwort gemessen haben.
Dieser Generierungs-Malus war in beiden Durchläufen real, aber nicht gleich groß. Am 14. September betrug die zusätzliche Zeit nach dem ersten Token etwa 130, 215 und 280 ms für 100-, 500- und 1.000-Token-Antworten, was deutlich weniger war als am 7. September. Diese Zahlen stammen aus Medianen und nicht aus gepaarten Differenzen, betrachten Sie sie also als Näherungswerte, aber die Richtung ist klar: Die Kosten für das erste Token blieben über Tage und Prompt-Größen hinweg stabil, während der Generierungs-Malus variierte.
Die beiden Kostenpunkte deuten auf zwei verschiedene Ursachen hin.
Die Kosten für das erste Token treten sowohl bei unserem eigenen Schlüssel als auch bei Credits auf; sie gehören also eher zum Pfad von OpenRouter zu Anthropic als zu dem Konto, über das bezahlt wird. Die wahrscheinlichsten Kandidaten sind die Übersetzung einer Anfrage im OpenAI-Format in das Messages-Format von Anthropic sowie die Rückübersetzung des Streams und der Netzwerkpfad vom OpenRouter-Edge zu Anthropic. Das Wachstum mit der Prompt-Größe spricht für Ersteres, da der Übersetzungsaufwand mit der Anfrage skaliert. Unsere Daten können die beiden Faktoren nicht trennen, und das Fehlen messbarer Kosten bei GPT-4o mini, das keine Formatübersetzung benötigt, ist mit beidem vereinbar. Das Senden derselben Anfragen über den nativen Anthropic-Endpunkt von OpenRouter, /api/v1/messages, ist das Experiment, das hier Klarheit schaffen würde, und wir haben es noch nicht durchgeführt.
Der Generierungsaufschlag ist anders gelagert. Credits und unser eigener Schlüssel nutzen dasselbe Gateway, dieselbe Übersetzung und denselben Anthropic-Endpunkt. Was sich unterscheidet, ist das Anthropic-Konto hinter der Anfrage: das von OpenRouter, das sich alle Kunden teilen, oder unser eigenes. Unsere beste Erklärung ist, dass Anfragen über das OpenRouter-Konto mit weniger Kapazität bedient wurden als Anfragen über unser Konto und dass dieser Betrag je nach Auslastung variiert, was auch erklären würde, warum der Aufschlag zwischen unseren beiden Testläufen abnahm. Das ist eine Schlussfolgerung. Weder OpenRouter noch Anthropic veröffentlichen Informationen darüber, wie Konten in Tiers eingestuft werden.
Bei OpenAI kehrte sich das Muster um. Bei GPT-4o mini erreichten Credits das erste Token in allen drei Sitzungen, in denen beide liefen, 23 bis 50 ms schneller als unser eigener Schlüssel. In der Sitzung, in der wir die Streaming-Geschwindigkeit verglichen, generierten beide mit der gleichen Rate. Das Konto, das Ihre Anfrage bedient, beeinflusst die Geschwindigkeit, und welches Konto schneller ist, hängt vom Anbieter ab. Sie können von außen nicht sehen, in welchem Tier Sie sich befinden. Sie können es nur messen.
Die Mitte der Verteilung repräsentiert die typische Anfrage. Ausreißer sind für benutzerorientierte Anwendungen wichtig. In den beiden Sitzungen mit kurzen Prompts lag die Zeit bis zum ersten Token beim 95. Perzentil bei etwa 700 ms bei direkter Verbindung, 950 bis 985 ms bei Credits und 885 bis 905 ms mit unserem eigenen Schlüssel. Das 99. Perzentil weitete sich auf beiden OpenRouter-Routen deutlich stärker aus, von etwa 750 bis 765 ms direkt auf 1,2 bis 2,6 Sekunden bei Credits. Da es sich jedoch um 100 Anfragen pro Sitzung handelt, entspricht das 99. Perzentil effektiv der zweitlangsamsten Anfrage; betrachten Sie dies also eher als Anzeichen für einen schwereren Ausläufer der Verteilung denn als präzisen Wert.
Ohne Streaming ergibt sich das gleiche Bild. Im Vergleich zur direkten Verbindung erhöhten Credits die Zeit bis zur vollständigen Antwort in zwei Sitzungen um 548 bzw. 629 ms, während unser eigener Schlüssel 42 bzw. 56 ms hinzufügte.
Diese Ergebnisse decken ein Modell ab, Claude Haiku 4.5, auf dem eigenen Endpunkt von Anthropic. Wir haben weder Sonnet oder Opus, noch Claude auf Bedrock oder Vertex über OpenRouter, andere OpenRouter-Edges oder verschiedene Tageszeiten getestet. Die Läufe mit kurzen Prompts sind mit unserem veröffentlichten Test-Framework reproduzierbar. Der Lauf mit aufgefüllten Prompts war eine separate Sitzung. Wir haben keinen Concurrency-Sweep für Anthropic-Credits durchgeführt, was der direkteste Test für die Erklärung der geteilten Kapazität wäre, ebenso wenig wie den /api/v1/messages Vergleich, der oben beschrieben wurde. Zudem lief alles von einem einzigen Client aus, was für Unterschiede zwischen den Routen in Ordnung ist, aber nichts über die absolute Latenz Ihrer Infrastruktur aussagt.
X-OpenRouter-Experimental-Metadata: enabled und lesen Sie openrouter_metadata in der Antwort aus. Dies verrät Ihnen den bedienenden Endpunkt und ob Ihr eigener Schlüssel verwendet wurde. Ohne dies verlassen Sie sich blind auf die Zuweisung.Ratenbegrenzungen sind der andere häufige Grund, warum sich Claude über OpenRouter langsam anfühlt. Unser Beitrag zu OpenRouter-Ratenbegrenzungen erklärt, wie man eine langsame Antwort von einer gedrosselten unterscheidet.
Das TrueFoundry AI Gateway läuft in Ihrer eigenen VPC oder Ihrem Rechenzentrum und ruft Anthropic direkt mit Ihrem eigenen Schlüssel und Vertrag auf. Anfragen teilen sich also kein Upstream-Konto mit anderen Kunden, und es gibt keinen Drittanbieter-Hop zwischen Ihrem Netzwerk und dem Anbieter. Unser veröffentlichter Wert liegt bei etwa 3 bis 4 ms Gateway-Overhead bei einer Verarbeitung von über 350 RPS auf einer einzelnen vCPU.
Dieser Wert von 3 bis 4 ms ist der von TrueFoundry veröffentlichte Benchmark. Wir haben ihn nicht mit dem in diesem Beitrag beschriebenen Testaufbau gemessen. Wenn Sie Gateways vergleichen möchten, ist die oben genannte Paarungsmethode der Weg, den wir wählen würden; sie funktioniert mit jedem OpenAI-kompatiblen Endpunkt, einschließlich unserem.
Die OpenRouter-Latenz bei Anthropic besteht aus zwei Teilen. Einem First-Token-Kostenfaktor von etwa 100 bis 300 ms, der mit der Prompt-Größe wächst und unabhängig vom verwendeten Konto auftritt, sowie – bei Nutzung von OpenRouter-Credits – einer langsameren Generierung, die in einem Testlauf mehr als eine halbe Sekunde und in einem anderen weniger zu einer typischen Antwort hinzufügte. Die Verwendung eines eigenen Schlüssels eliminierte in unseren Tests die langsamere Generierung, während der First-Token-Kostenfaktor bestehen blieb. Der einzige Weg, um herauszufinden, was diese zusätzliche Wartezeit bei Ihren Prompts bedeutet, ist die Messung auf die von uns beschriebene Weise: gepaart.
Um Anthropic mit Ihrem eigenen Schlüssel aus Ihrem eigenen Netzwerk heraus aufzurufen, ohne ein geteiltes Upstream-Konto, sehen Sie sich an, wie das TrueFoundry AI Gateway eine direkte Verbindung zu Anthropic herstellthandelt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




It depends on the provider. In our paired testing, the added time to first token on GPT-4o mini was too small to measure, while Claude Haiku 4.5 on OpenRouter credits added about 206 ms, or about 124 ms with our own Anthropic key. OpenRouter itself no longer publishes an overhead figure.
Ja. Das Gateway ist OpenTelemetry-kompatibel und lässt sich in Grafana, Datadog, Prometheus oder Ihren bevorzugten Stack integrieren. Es verfolgt jede Anfrage vom Prompt bis zur Ausführung von Tools und Modellen, sodass Sie eine einheitliche Protokollierung erhalten, ohne Ihre bestehenden Systeme entfernen zu müssen.
On Anthropic it did in our tests: our own key added about 120 ms to the first token against about 200 ms on credits, and then streamed at direct speed. On OpenAI, credits was slightly faster. Which route is faster depends on the provider and the account behind it.
Ja. Das Gateway ist OpenTelemetry-konform und exportiert Traces an externe Backends; auf diesem Weg gelangen Gateway-Daten zu Plattformen wie Braintrust, Langfuse oder Arize. TrueFoundry selbst führt keine Offline-Scoring-Jobs aus.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet
















