



October 9, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: October 9, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Wenn ein LLM-Aufruf langsam, teuer oder fehlerhaft ist, müssen Sie nachvollziehen können, was tatsächlich passiert ist. Hat ein Guardrail den Prompt redigiert? Wie lange hat das Modell im Vergleich zum Netzwerk benötigt? Was hat das Gateway an den Provider gesendet? Request-Logging und Tracing auf dem AI Gateway beantworten diese Fragen für jeden Aufruf.
Da jeder Request ohnehin über das Gateway läuft, erhalten Sie diese Transparenz, ohne jede Anwendung manuell instrumentieren zu müssen.
DieDokumentation zum Request-Logging ermöglicht es Ihnen zu steuern, welche Requests protokolliert werden. Die einfachste Methode ist die Steuerung pro Request über den Header X-TFY-LOGGING-CONFIG mit einem stringifizierten JSON-Wert. Setzen Sie „enabled“ auf „true“, um den Request zu protokollieren, oder auf „false“, um ihn zu überspringen.
Ein wichtiger Hinweis: Der Wert dieses Headers ist ein stringifiziertes JSON und kein rohes JSON-Objekt, da die meisten SDKs Header als Strings serialisieren. Die älteren globalen Logging-Modi werden durch eine regelbasierte Logging-Konfigurationersetzt, mit der Sie das Logging pro Subjekt, Modell oder Metadaten steuern und sensible Werte redigieren können.
Um protokollierte Requests in der Benutzeroberfläche zu sehen, gehen Sie zu „AI Gateway“, dann zu „Monitor“ und schließlich zu „Requests“. Dort finden Sie eine Liste aller protokollierten Aufrufe, die Sie öffnen können, um einen einzelnen Request im Detail zu untersuchen.
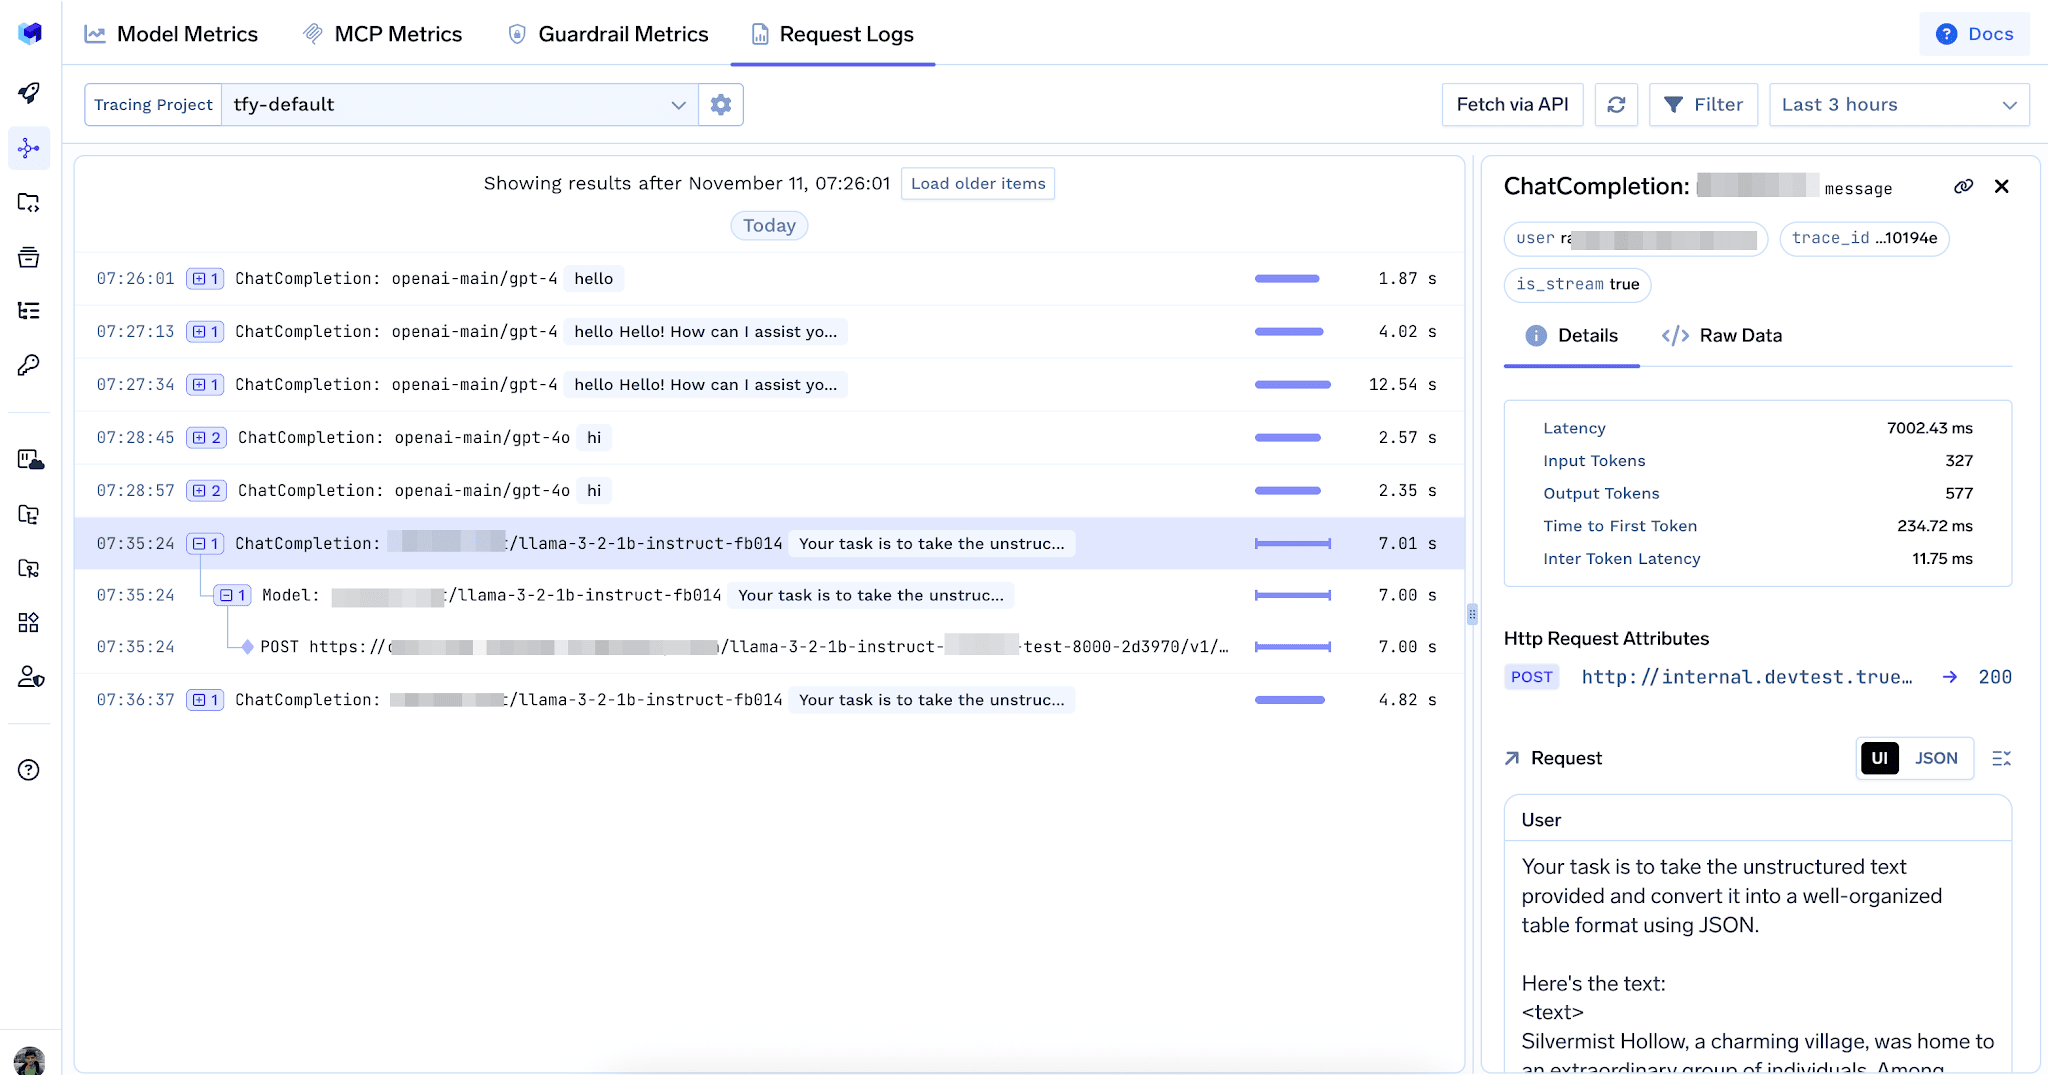
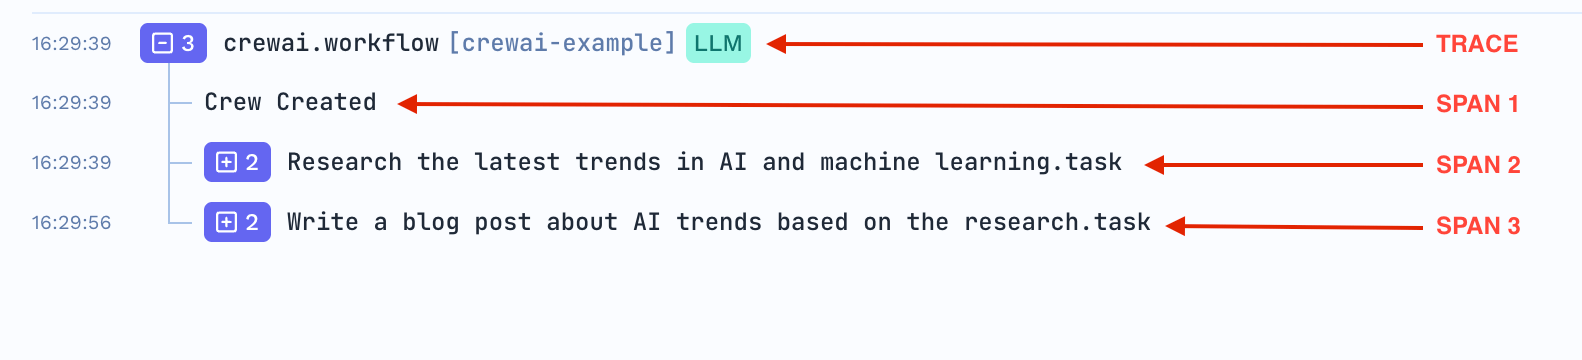
DieTracing-Dokumentation beschreibt ein Trace als den vollständigen Lebenszyklus eines Requests, während er die Dienste durchläuft, die mit dem LLM interagieren. Normalerweise entspricht ein Trace einem einzelnen API-Aufruf einer Anwendung.
Ein Span ist eine einzelne Arbeitseinheit innerhalb dieses Traces, wie etwa ein Funktionsaufruf, ein HTTP-Request oder eine Modell-Inferenz. Ein Trace ist ein Baum aus Spans mit Eltern-Kind-Beziehungen, wobei ein Kind-Span normalerweise durch seinen Eltern-Span ausgelöst wird. TrueFoundry stellt ein OpenTelemetry-Collector-Backend bereit, das diese Traces speichert, sowie eine Benutzeroberfläche zum Abfragen und Analysieren. Es kann Traces von jedem OpenTelemetry-kompatiblen SDK empfangen.
DieDokumentation zur Trace-Inspektion Gehen wir ein reales Beispiel durch: eine Chat-Vervollständigung mit einem Guardrail zur PII-Schwärzung, erfasst als fünf Spans, die eine Hierarchie bilden.
Im selben Beispiel ist die Eingabe sichtbar von einem Namen in einen Platzhalter geschwärzt, was zeigt, dass der PII-Guardrail innerhalb des Traces durchgängig funktioniert.
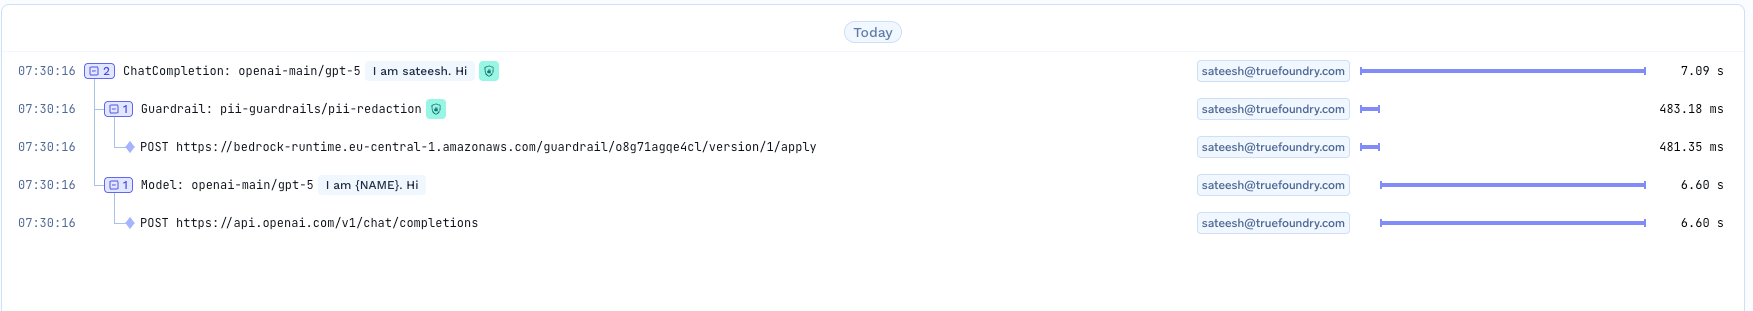
Ein Chat-Completions-Trace, der die Guardrail-, Modell- und ausgehenden Netzwerk-Spans zeigt.
Einzelne Traces dienen dem Debugging. Für Trends aggregiert das Analytics-Dashboard dieselben Daten. Die Reiter umfassen Übersicht, Modell-Metriken, MCP-Metriken, Guardrail-Metriken, Routing-Metriken und Cache-Metriken.
Modellmetriken können nach Modellen, virtuellen Modellen, Benutzern, virtuellen Konten, Teams oder Metadaten gruppiert werden. Die Latenzansichten schlüsseln die Anfragelatenz, die Zeit bis zum ersten Token, die Latenz zwischen den Token sowie die Zeit pro ausgegebenem Token auf. Zusammen mit den Traces pro Anfrage erhalten Sie so sowohl das Mikroskop als auch das Dashboard.
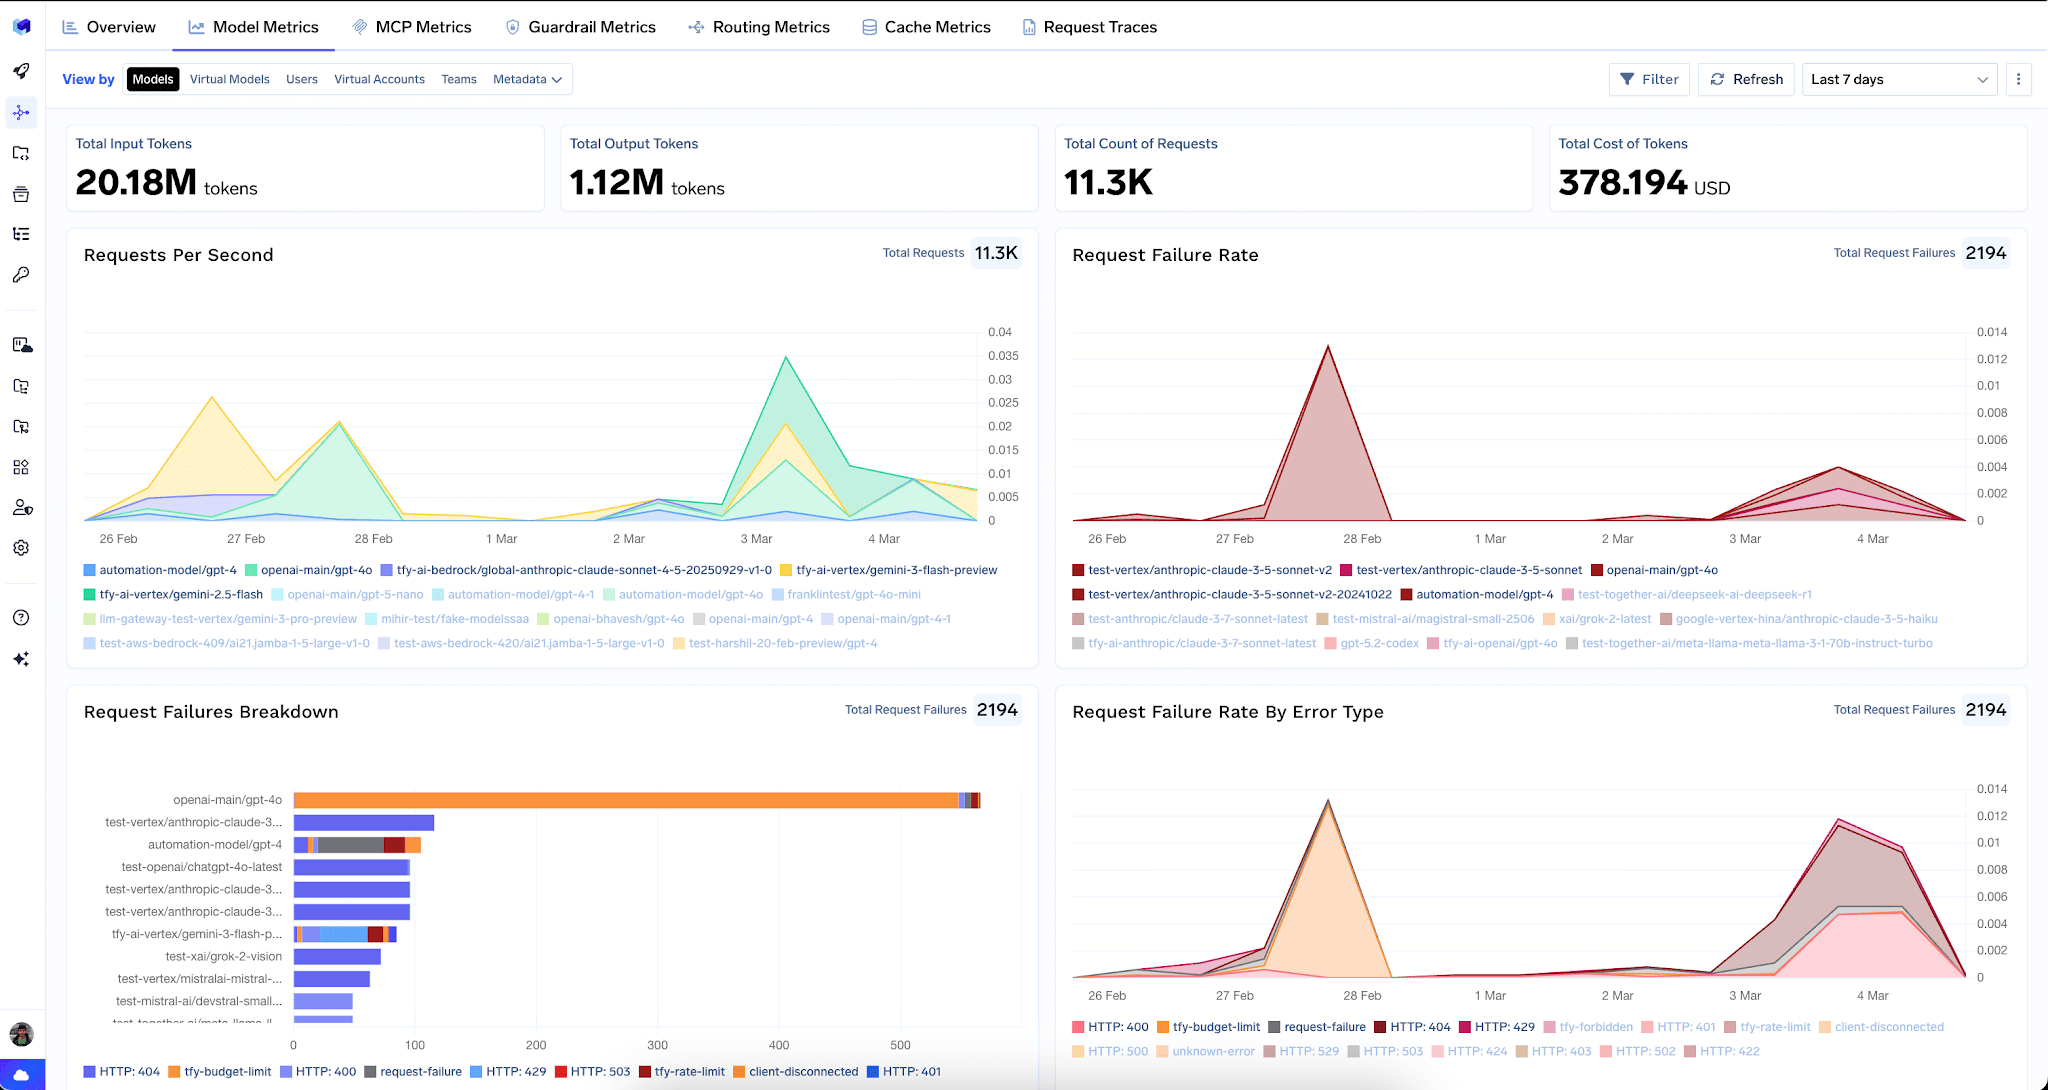
Modellmetriken im Analytics-Dashboard, gruppierbar nach Team, Benutzer, Modell und mehr.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Send the X-TFY-LOGGING-CONFIG header with a stringified JSON value and set enabled to true or false. Remember that the value is stringified JSON, not a raw object, because most SDKs serialize headers as strings.
Logged requests appear under AI Gateway, then Monitor, then Requests. Opening a request shows its trace, which is the tree of spans covering guardrails, the model, and the outbound provider calls.
A trace is the full lifecycle of a single request. A span is one unit of work inside that trace, such as a guardrail check or a model inference. Spans form a parent and child tree within the trace
Yes. TrueFoundry runs an OpenTelemetry collector backend and can receive traces from any OpenTelemetry compatible SDK. For LLM use cases the docs recommend an LLM focused SDK that captures model specific traces and metrics.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet
















