


November 21, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Fünf Modellanbieter bedeuten fünf SDKs, fünf API-Schlüssel, fünf Rechnungen und fünf verschiedene Ratenbegrenzungen. OpenRouter fasst dies in einem einzigen Endpunkt zusammen. Ändern Sie einfach die Basis-URL im OpenAI-SDK und den Modellnamen, und derselbe Client kann Claude, Gemini, Llama oder DeepSeek aufrufen.
So viel steht in jedem Quickstart-Guide. Im Kern ist OpenRouter jedoch ein Marktplatz. Er entscheidet, welches Unternehmen die jeweilige Anfrage bearbeitet, verwaltet Ihr Guthaben und bezahlt die Anbieter. Wir haben den Weg zwischen Ihrem Code und dem Modell nachverfolgt und – wo verfügbar – mit Zahlen aus unseren eigenen Tests belegt.
OpenRouter ist eine gehostete HTTP-API, die Inferenzanfragen über einen einzigen Endpunkt und ein einziges Anmeldeverfahren an Drittanbieter von Modellen weiterleitet und Ihnen die Modellnutzung standardmäßig in Rechnung stellt. Sie akzeptiert drei Anfrageformate: OpenAI Chat Completions, die OpenAI Responses API und die Messages API von Anthropic unter /api/v1/messages. Es gibt Client-SDKs für TypeScript, Python und Go, aber diese bilden lediglich eine typisierte Schicht über derselben REST-API. Daher funktioniert das Standard-OpenAI-SDK mit einer angepassten baseURL genauso gut.
OpenRouter ist zweiseitig. Auf der einen Seite rekrutiert es Anbieter, legt die Integrationsverträge fest und bezahlt sie. Auf der anderen Seite verwaltet es Ihr Prepaid-Guthaben und konsolidiert die Abrechnung für alle Anbieter. Es befindet sich sowohl in Ihrem Zahlungsweg als auch in Ihrem Anfrageweg. Das macht es zwar komfortabel, ist aber auch der Grund, warum ein Wechsel mehr erfordert, als nur eine URL zu ändern.
Sie mieten den Zugriff auf die Modelle anderer Unternehmen. Es gibt keine selbst gehostete oder isolierte (Air-Gapped) Version von OpenRouter, und das Kernprodukt ist Closed Source. Die SDKs und Dokumentationen sind öffentlich zugänglich. Das Projekt begann als „Window“, eine Chrome-Erweiterung zur gleichzeitigen Nutzung mehrerer Modelle, und hat seitdem serverseitige Tools wie Websuche, Web-Fetch und eine Sandbox-Shell-Ausführung hinzugefügt, die Modelle während einer Anfrage aufrufen können.
Eine Anfrage durchläuft diese Schritte:
https://openrouter.ai/api/v1 mit einem API-Schlüssel in einem der drei Formate.vendor/model wird in eine Liste von Anbieter-Endpunkten aufgelöst, die dieses Modell bereitstellen.sort, order, only und data-policy-Einstellungen setzen dies außer Kraft.attempt in der Antwort ist das einzige interne Anzeichen dafür, dass dies geschehen ist.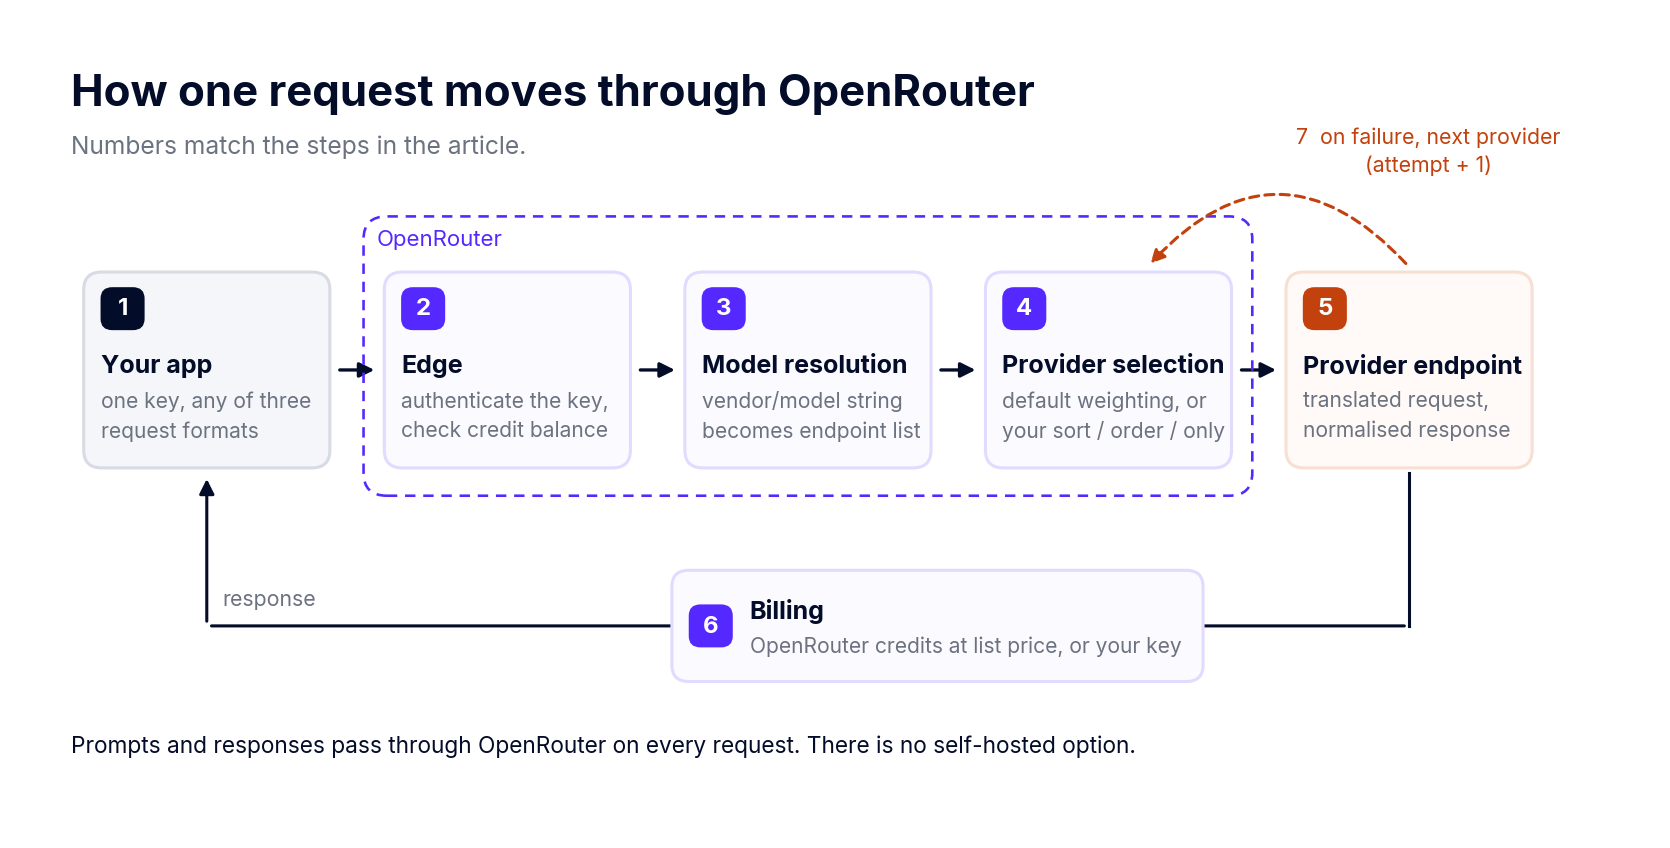
Der Modell-String verrät Ihnen nicht, wer das Modell betreibt. Das Anbieter-Präfix gibt an, wessen Modell es ist, nicht auf wessen Servern es läuft. Als wir anthropic/claude-3-haikugetestet haben, wurde es von Amazon Bedrock bereitgestellt.
Bei Modellen mit offenen Gewichten wird die Lücke noch größer. Am 5. Oktober listete die API von OpenRouter 11 Endpunkte für meta-llama/llama-3.3-70b-instructauf. Über diese 11 hinweg:
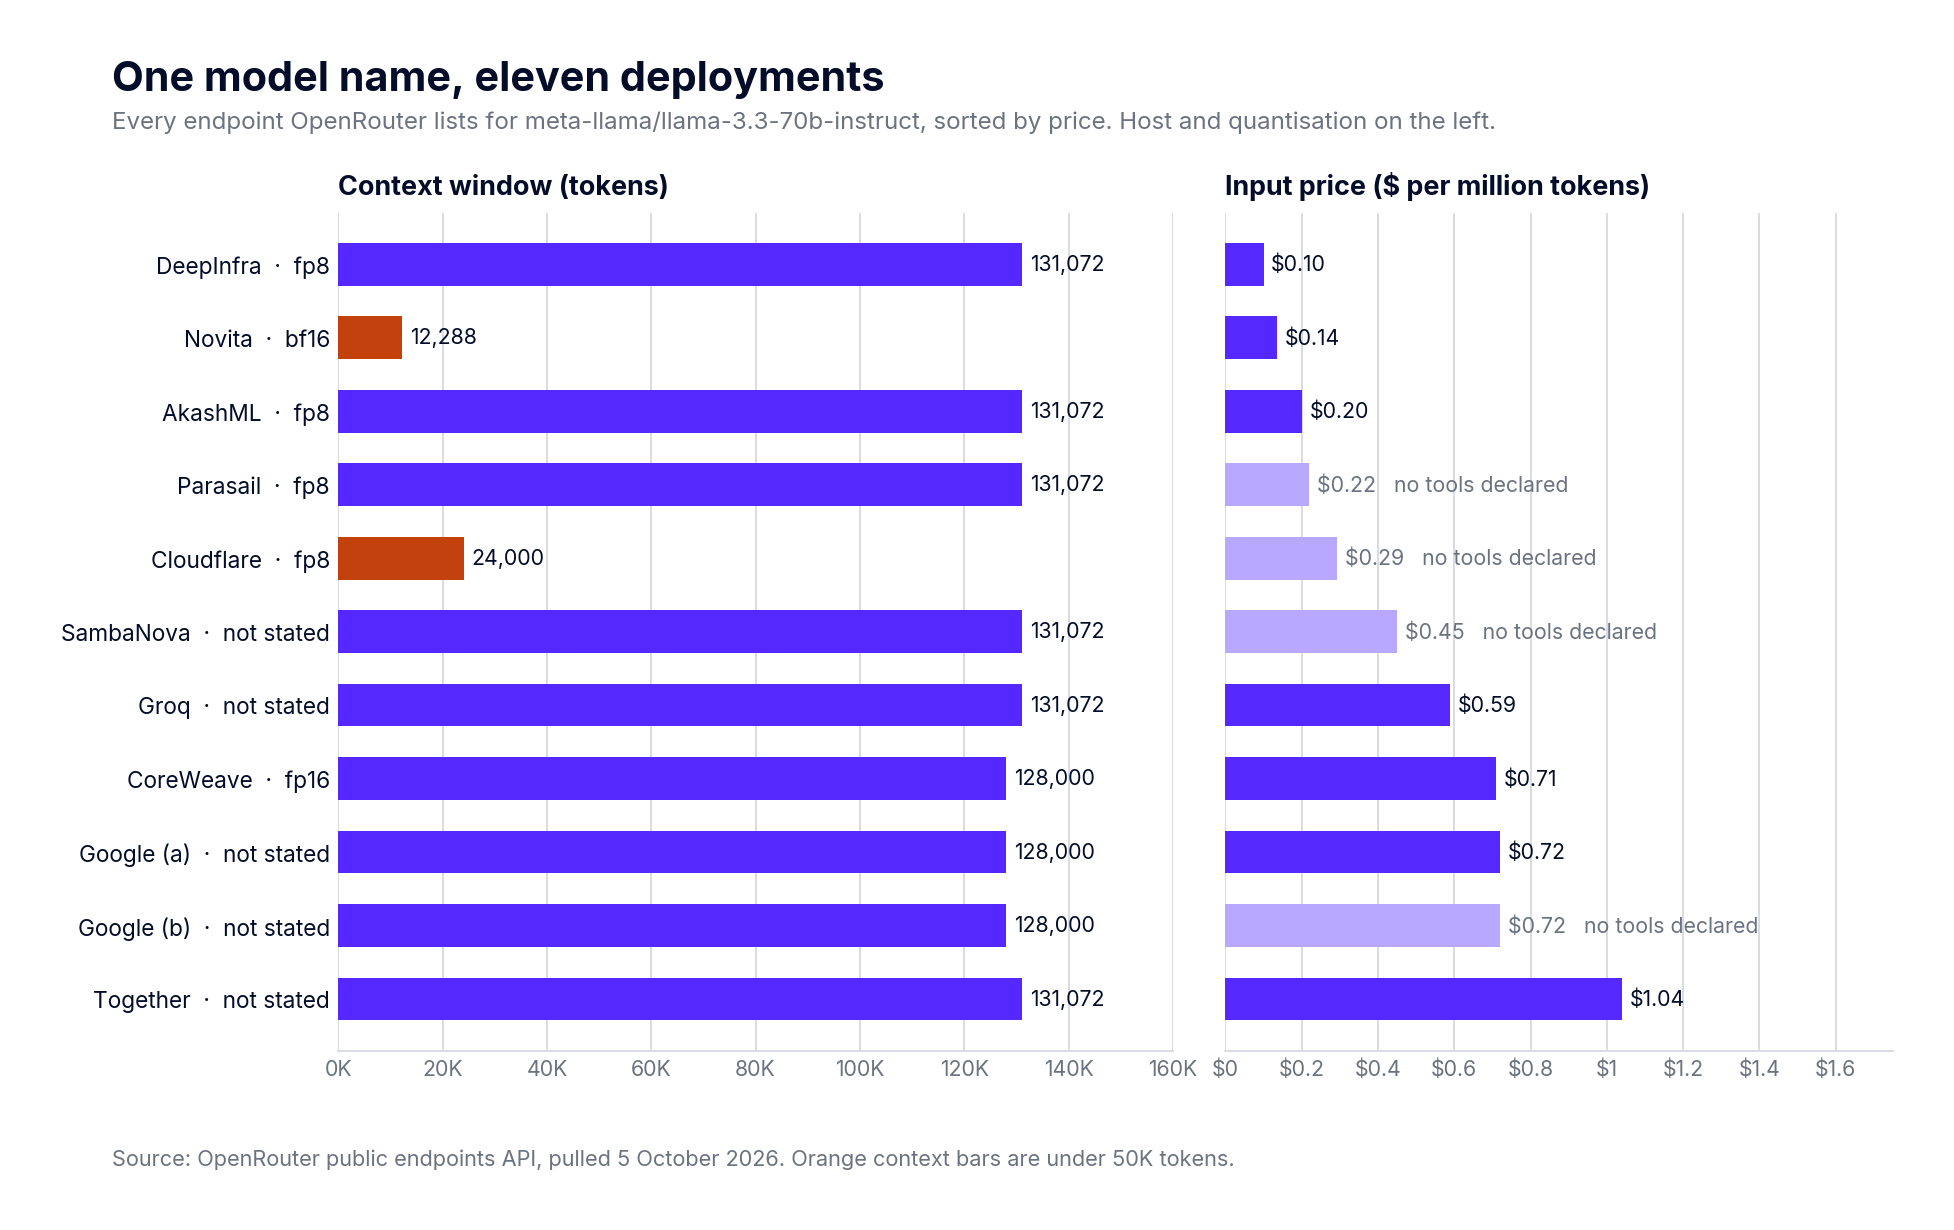
Gleicher Name, materiell unterschiedliche Produkte. Wenn Ihre Prompts lang sind, sind der 12K-Endpunkt und der 131K-Endpunkt nicht austauschbar, und der Standard-Router wählt teilweise nach Preis aus. OpenRouter filtert nach Fähigkeiten, wenn eine Anfrage dies erfordert: Als wir acht Anfragen mit tool_choice: required und ohne Provider-Pin gesendet haben, landete jede bei einem Host, der Tool-Unterstützung deklariert. Aber deklariert ist nicht gleichbedeutend mit funktionierend. Ein Host, der Tool-Unterstützung deklariert, gab gar keinen Tool-Aufruf zurück, als wir ihn festlegten und einen erzwangen.
Lesen Sie/api/v1/models/{model}/endpoints bevor Sie einem Modell-String vertrauen, und legen Sie Provider fest oder filtern Sie diese, wo immer Quantisierung, Kontextlänge oder Tool-Verhalten eine Rolle spielen.
Die API von OpenRouter listete am 5. Oktober 466 Modelle in 65 Anbieter-Namespaces auf, ein Anstieg gegenüber 428, als wir sie erstmals am 8. September abgerufen haben. Embedding-Modelle befinden sich auf einem separaten Endpunkt, /api/v1/embeddings/models, der 33 weitere auflistete. Addieren Sie diese, und Sie kommen den „500+ Modellen“ auf der Preisseite von OpenRouter nahe. Die Anbieterzahlen passen weniger genau zusammen: Der Provider-Endpunkt gab 112 Einträge zurück, einer davon namens FakeProvider, gegenüber „80+“ im Marketing. Fragen Sie die API ab, anstatt einer Zahl in einem Blogbeitrag zu vertrauen, diesen eingeschlossen.
Die Standard-Route verteilt den Datenverkehr. Sie optimiert nicht nach Preis oder Geschwindigkeit. In unserem September-Test zu Llama 3.3 70B mit acht Anfragen pro Strategie war die Standardeinstellung mit einem Median von 935 ms die langsamste Option und kostete doppelt so viel wie sort: price. sort: throughput war mit 289 ms am schnellsten, gefolgt von sort: latency mit 347 ms. Die günstigsten und teuersten Strategien unterschieden sich für denselben Prompt um den Faktor 10. Acht Anfragen reichen aus, um zu zeigen, dass die Anweisungen funktionieren und sich unterscheiden. Es ist jedoch eine zu kleine Stichprobe, um die Anbieter zu bewerten. Wenn Ihnen Kosten oder Geschwindigkeit wichtig sind, legen Sie eine Sortierung fest.
Zwei Details zu Fallbacks. Ein falsch geschriebener Anbieter-Slug in order wird stillschweigend verworfen, anstatt abgelehnt zu werden; ein Tippfehler schränkt also lediglich Ihre Liste ein. Und wie oben erwähnt, ist attempt das einzige Signal dafür, dass ein Fallback ausgelöst wurde.
Das OpenAI-SDK lässt sich nahtlos integrieren, und für den Großteil des Chat-Traffics ist das bereits alles. Die Ausnahmefälle sind Parameter, die eine bestimmte Route nicht unterstützt; diese werden in der Regel mit einem 200-Statuscode akzeptiert, aber nicht angewendet. Wir haben den OpenAI-Parameter prediction an GPT-4o mini gesendet, das Unterstützung dafür angibt, und erhielten eine normale Antwort ohne Anzeichen dafür, dass er wirksam wurde. Wenn ein Parameter Ihre Ausgabe oder Ihre Abrechnung beeinflusst, prüfen Sie die Antwort auf Anzeichen dafür, dass er funktioniert hat.
Sie zahlen den Listenpreis des Anbieters pro Token. OpenRouter schlägt keinen Aufpreis darauf. Die Einnahmen stammen aus einer Gebühr beim Kauf von Credits: 5,5 % im Standard-Tarif mit einem Minimum von 0,80 $, 8 % im Business-Tarif und 5 % bei Kryptozahlungen. Wenn Sie Ihren eigenen Anbieter-Key verwenden, fallen für die ersten 25.000 $ an Listenpreis-Nutzung pro Monat keine Gebühren an, danach 5 %. Credits können ein Jahr nach dem Kauf verfallen. Die Preisgestaltung hat sich in vierzehn Monaten zweimal geändert, prüfen Sie daher die Preisseite von OpenRouter, bevor Sie Kosten kalkulieren. Unser OpenRouter-Preisüberblick geht weiter.
Prompts und Antworten laufen immer über OpenRouter. Sie können den Dienst nicht selbst betreiben oder air-gapped halten. Die verfügbaren Kontrollmöglichkeiten beim gehosteten Dienst sind Routing ohne Datenspeicherung, ein data_collection: "deny" Filter, der Anfragen nur an Anbieter weiterleitet, die Ihre Daten nicht erfassen, sowie regionsbasiertes Routing. Regionsbasiertes Routing erforderte früher einen Enterprise-Vertrag. Seit September ist es im Self-Service-Business-Tarif verfügbar: Senden Sie Anfragen an eu.openrouter.ai oder us.openrouter.ai und werden ausschließlich in dieser Region verarbeitet. Ist kein regionaler Endpunkt verfügbar, schlägt die Anfrage mit einem Fehler fehl. Die dokumentierten Kompromisse: Das eigene Prompt- und Antwort-Logging von OpenRouter wird bei regionalen Endpunkten übersprungen, und Batch-Verarbeitung, Web-Abrufe, die Sandbox-Shell, Datei- und Bild-Tools sowie der Auto-Router stehen dort nicht zur Verfügung.
Beides wird in eigenen Beiträgen behandelt. OpenRouter-Ratenbegrenzungen erklärt, warum Ihr Limit für kostenlose Modelle von Ihren bisherigen Zahlungen abhängt, und OpenRouter Prompt-Caching erläutert, warum dieselbe Caching-Funktion neun verschiedene Preise hat.
Laut der Dokumentation von OpenRouter läuft der Dienst am Edge, um den Overhead minimal zu halten. Auf der Startseite wurde früher ein Wert von etwa 25 ms genannt, was in vielen Anleitungen immer noch wiederholt wird. Seit dem 5. Oktober heißt es auf der Startseite nur noch „minimale Latenz“. Die Dokumentation ergänzt ein Detail: Wenn Ihr Guthaben niedrig ist, leert OpenRouter seine Edge-Caches aggressiver, um eine genaue Abrechnung zu gewährleisten, was die Latenz erhöht, bis Sie Ihr Guthaben aufladen.
Wir haben es gemessen. Dieselben 100 Prompts wurden auf drei Wegen gesendet: direkt an den Anbieter, über OpenRouter mit Guthaben und über OpenRouter mit unserem eigenen Anbieter-Key. Die Anfragen wurden verschachtelt und pro Prompt gepaart, sodass sich der Inhalt des Prompts bei der Differenzberechnung aufhebt. Zudem wurde jeder Request dem Erstanbieter des Modells zugeordnet und einzeln überprüft.
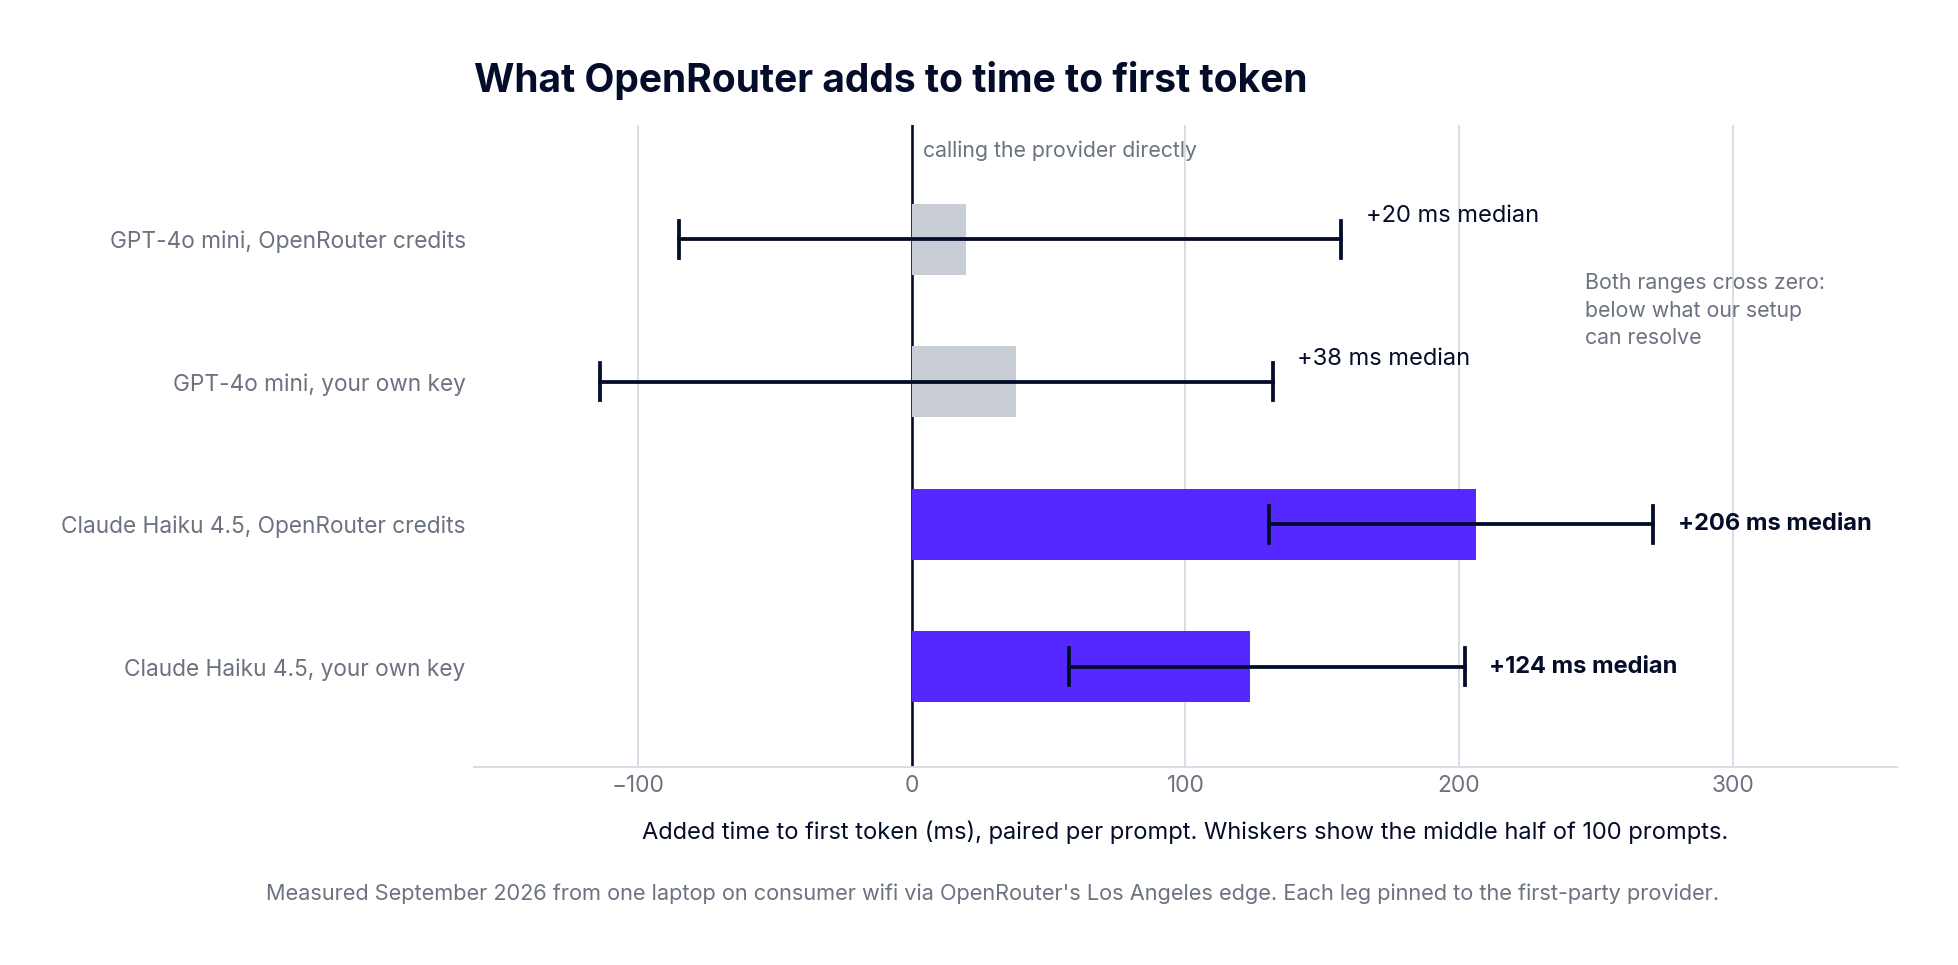
Bei GPT-4o mini konnten wir keinen Overhead messen. Die mediane zusätzliche Zeit bis zum ersten Token lag bei 19,7 ms mit Guthaben, aber die mittlere Hälfte der Ergebnisse schwankte zwischen 85 ms schneller und 157 ms langsamer, sodass der tatsächliche Wert unterhalb der Auflösung unseres Setups liegt. Bei Claude Haiku 4.5 war es eindeutig: 206 ms zusätzlich mit Guthaben und 124 ms mit unserem eigenen Key, wobei der Interquartilsabstand deutlich über null lag. Ohne Streaming kamen bei zwei Testläufen mit Guthaben 837 bzw. 883 ms zur Gesamtlaufzeit hinzu, während unser eigener Key innerhalb von 42 ms gegenüber der Direktverbindung blieb.
Guthaben und der eigene Key nutzen dasselbe Gateway und dieselbe Übersetzung, der Unterschied liegt also im Upstream-Konto. Unsere beste Erklärung – und dies ist eine Schlussfolgerung – ist eine Auslastung der geteilten Anthropic-Kapazitäten von OpenRouter. Bei einem stark frequentierten Anbieter bringt die Nutzung eines eigenen Keys nicht nur Vorteile bei der Abrechnungskontrolle, sondern auch bei der Latenz.
All dies wurde im September 2026 von einem Laptop über ein privates WLAN und den Los-Angeles-Edge-Server von OpenRouter durchgeführt. Betrachten Sie die Unterschiede als real, während die absoluten Zahlen spezifisch für unser Setup sind.
OpenRouter wurde 2023 von Alex Atallah gegründet, einem Mitbegründer von OpenSea. Am 19. August 2026 gab Stripe eine Vereinbarung zur Übernahme bekannt. Anfang Oktober war der Abschluss des Deals noch nicht gemeldet worden, und kein Unternehmen hat einen Preis genannt; Presseberichte schätzen ihn auf über 7 Milliarden US-Dollar. OpenRouter hat erklärt, dass sich an seinem Produkt und seinen Verpflichtungen nichts ändern werde.
Die Einnahmen von OpenRouter basieren auf einer Gebühr für Zahlungen, die Preisgestaltung wird von einem Zahlungsdienstleister festgelegt, und die Neutralität gegenüber Anbietern ist eher eine erklärte Absicht als eine strukturell verankerte Eigenschaft. Ein Team, das plant, zwei Jahre lang darauf aufzubauen, sollte dies neben den Routing- und Latenzzahlen in seine Bewertung einfließen lassen und dann eine Entscheidung treffen.
OpenRouter wird oft mit LLM-Gateways wie LiteLLM oder unserem eigenen verglichen. Beide schalten eine API vor eine Vielzahl von Modellen. Es handelt sich jedoch um unterschiedliche Produkte. Unser Erklärungsartikel zu was ein LLM-Gateway ist deckt das Grundkonzept ab.
Zwei Punkte erfordern jeweils eine Erläuterung. Die Control Plane und die Data Plane von OpenRouter sind dasselbe System; wenn es ausfällt, ist alles dahinter ebenfalls nicht erreichbar. Der eigene Engineering-Blog beschreibt einen etwa 50-minütigen Datenbankausfall im August 2025, der das Routing lahmlegte, argumentiert jedoch, dass die aggregierte Verfügbarkeit dennoch besser sei als bei jedem einzelnen Anbieter. In unseren eigenen Tests mit rund 4.300 Anfragen konnten wir keinen einzigen 4xx- oder 5xx-Fehler feststellen. Zur Identitätsverwaltung: Schlüssel gehören dem Mitglied, das sie erstellt hat. Die Deaktivierung dieser Person über SCIM deaktiviert auch ihre Schlüssel – eine sinnvolle Standardeinstellung für Personen, aber unpraktisch für produktive Workloads.
OpenRouter eignet sich gut für das Prototyping mit vielen verschiedenen Modellen, wenn Sie nur einen Schlüssel und eine Rechnung benötigen und sich nicht mit jedem Anbieter einzeln vertraglich binden möchten. Es ist auch ideal für Open-Weight-Modelle, bei denen die Wahl des Anbieters nach Preis oder Durchsatz echte Kosten spart, sofern Ihre Prompts Ihr Netzwerk verlassen dürfen – unabhängig davon, ob regionale Einschränkungen bestehen oder nicht.
Es ist weniger geeignet, wenn Prompts Ihr Netzwerk nicht verlassen dürfen, wenn Workloads maschinelle Identitäten statt personenbezogener Schlüssel erfordern oder wenn es inakzeptabel ist, dass der Ausfall eines Anbieters alle Modelle offline nimmt. Dasselbe gilt, wenn Latenz bei einem überlasteten Anbieter kritisch ist und Sie keinen eigenen Schlüssel mitbringen können, oder wenn die Einkaufsabteilung ohnehin direkte Verträge mit jedem Anbieter wünscht.
Das TrueFoundry AI Gateway läuft in Ihrer VPC, on-premise oder in einer isolierten Umgebung (Air-Gapped) und spricht Anbieter direkt mit Ihren eigenen Verträgen und Schlüsseln an. Es stellt über 1.000 LLMs über eine OpenAI-kompatible API bereit, fügt etwa 3 bis 4 ms Overhead hinzu und bewältigt über 350 Anfragen pro Sekunde (RPS) auf einer einzelnen vCPU.
Sie können OpenRouter in diesem Setup beibehalten. Es ist als Anbieter in TrueFoundry unterstützt, sodass der Katalog für Experimente verfügbar bleibt, während Ihre eigenen Ratenbegrenzungen, Budgets, Zugriffskontrollen und Protokollierungen davor geschaltet sind. Für Teams, die bereits OpenRouter nutzen, ist dies meist der risikoärmste erste Schritt.
OpenRouter ist eine API, die vor einem Marktplatz geschaltet ist. Sie entscheidet, wer die jeweilige Anfrage bearbeitet, verwaltet Ihre Credits und bezahlt die Anbieter. Bevor Sie einen Modell-String als stabiles Produkt betrachten, sollten Sie die Endpunktliste lesen, eine Routing-Sortierung festlegen und den Overhead der Anbieter messen, die Sie tatsächlich nutzen.
Wenn Sie diese eine API in Ihrer eigenen Infrastruktur nutzen möchten, erfahren Sie hier, wie das TrueFoundry AI Gateway funktionierthandelt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




OpenRouter is a hosted, OpenAI-compatible API that gives you access to hundreds of AI models from many providers through one endpoint and one API key. It picks which provider serves each request, bills you at the provider's list price, and charges a fee when you buy credits. You cannot run it yourself, so prompts always pass through OpenRouter's infrastructure.
Partly. OpenRouter offers free variants of some models, capped at 20 requests per minute and 50 requests per day, rising to 1,000 a day once you've bought at least 10 credits. Paid models are billed at the provider's list price, plus a fee on each credit purchase. Our post on OpenRouter rate limits has the detail.
It depends on the provider. In our paired testing, the added time to first token on GPT-4o mini was too small to measure, while Claude Haiku 4.5 on OpenRouter credits added about 206 ms, or about 124 ms with our own Anthropic key. OpenRouter itself no longer publishes an overhead figure.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet














