



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Eine Woche nach dem Erscheinen von GPT-6 Sol im Katalog hat OpenAI den Nachfolger ausgeliefert. GPT-6.1 Sol wurde am Dienstag, den 29. September, veröffentlicht und ist bereits im Modellkatalog des TrueFoundry AI Gateway verfügbar – inklusive hinterlegter Preise, Kontextlimits und Funktionen.
Sie rufen es über denselben OpenAI-kompatiblen Endpunkt auf, den Sie für alles andere nutzen. Kein neues SDK, keine separate Integration, kein Warten auf ein Gateway-Release. Ändern Sie einfach den Modell-String in Ihrem OpenAI-Konto zu gpt-6.1-sol (openai/gpt-6.1-sol auf OpenRouter), und schon nutzen Sie das neue Modell.
Testen Sie GPT-6.1 Sol auf dem TrueFoundry AI Gateway →
GPT-6.1 Sol ersetzt GPT-6 Sol zum gleichen Listenpreis, bietet jedoch günstigeres Caching bei identischen Limits. Die entscheidenden Zahlen für Ihr Produktionsbudget:
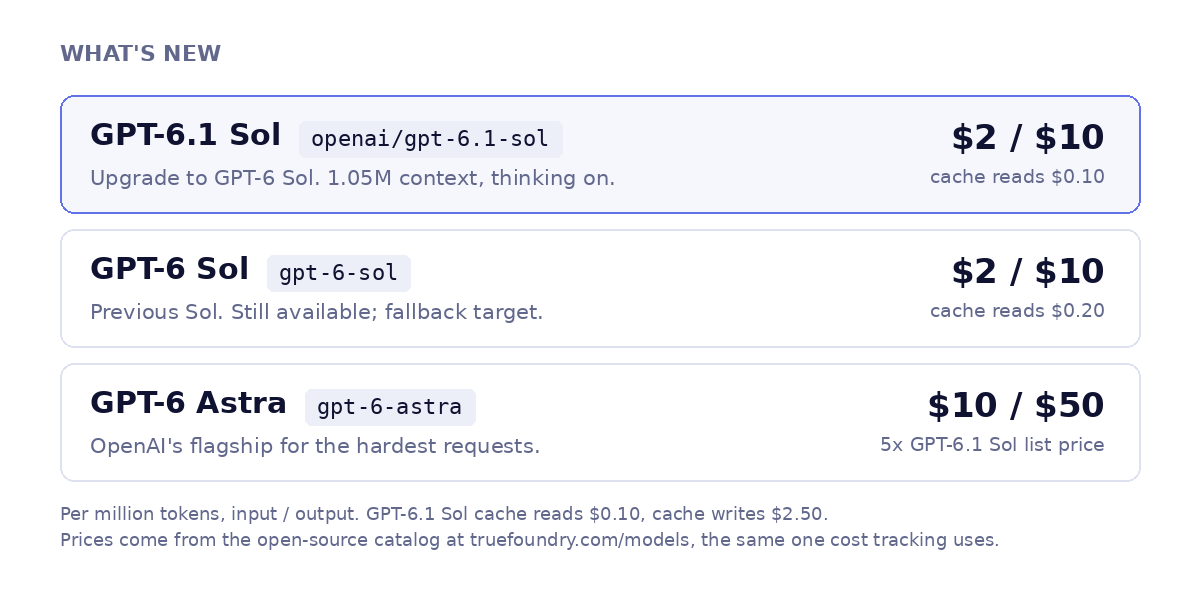
Der Katalog listet GPT-6 Astra mit 10 $ pro Million Input-Tokens und 50 $ pro Million Output-Tokens. GPT-6.1 Sol ist mit 2 $ und 10 $ angesetzt – exakt ein Fünftel auf beiden Seiten. Die Cache-Reads von 0,10 $ entsprechen zudem einem Zehntel der 1 $ von Astra.
Vergleicht man die Veröffentlichungen des Monats nebeneinander: GPT-6 Luna liegt bei 0,10 $ pro Million Input-Tokens, GPT-6 Sol, GPT-6.1 Sol und Claude Sonnet 5.5 bei 2 $, Claude Opus 5.5 bei 4 $, GPT-6 Astra bei 10 $. GPT-6.1 Sol übernimmt den Platz von GPT-6 Sol in der Hierarchie zum gleichen Preis – jedoch mit der niedrigsten Cache-Read-Rate in dieser 2-$-Kategorie.
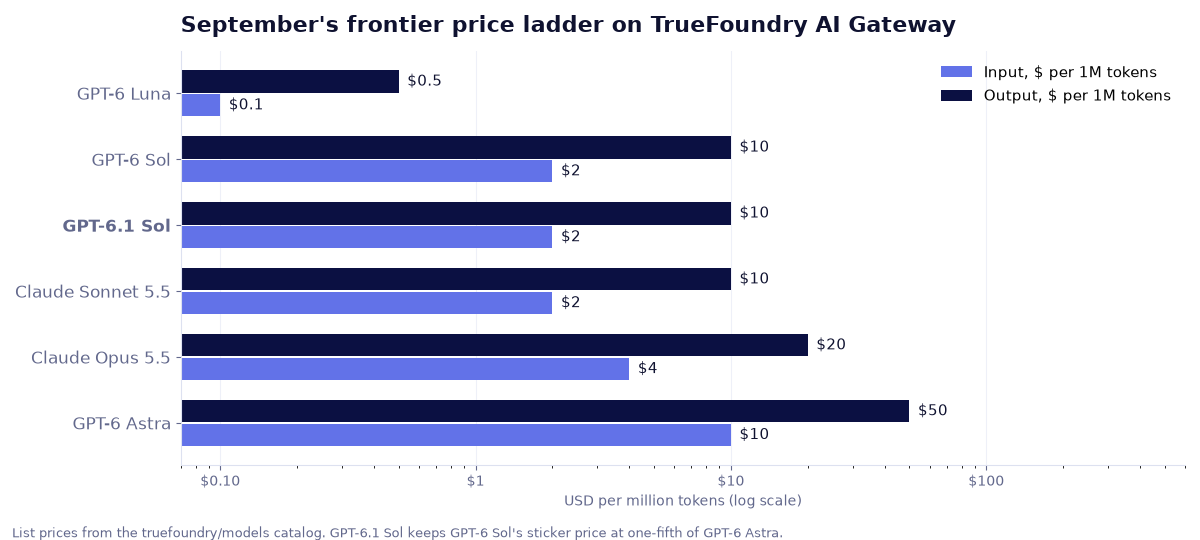
Das ist das beste Argument dafür, die Modellauswahl als Gateway-Konfiguration statt als Anwendungscode zu behandeln. Der Großteil des Produktions-Traffics besteht aus vielen einfachen Anfragen und einer kleinen Anzahl komplexer Aufgaben. Wenn der einfache Hauptteil an Luna geht, der mittlere Teil an GPT-6.1 Sol und nur der schwere Rest an Astra, sieht die Gesamtabrechnung völlig anders aus als bei einer reinen Astra-Nutzung. Das funktioniert jedoch nur, wenn der Wechsel eine reine Konfigurationsänderung ist – genau dafür ist das AI Gateway da.
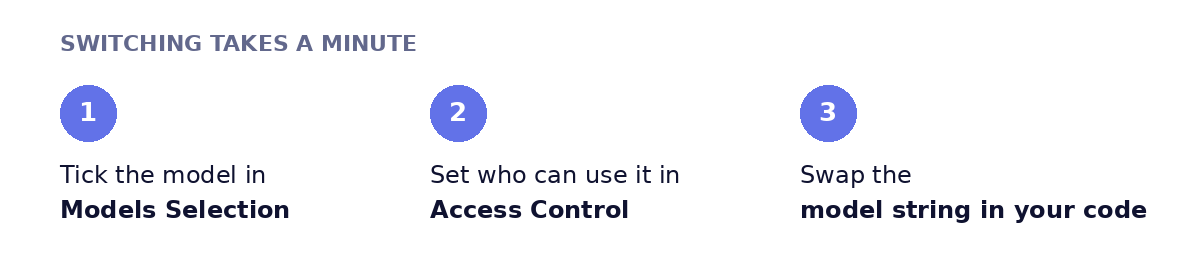
Schritt 1: Aktivieren Sie das Modell in Ihrem Provider-Konto. Öffnen Sie im Gateway Models → Ihr OpenAI-Konto → Models Selection, suchen Sie nach gpt-6.1-sol und wählen Sie es aus. Die Preise werden direkt angezeigt (2 $ Input / 10 $ Output pro 1M Tokens), da sie direkt aus dem Katalog stammen. Richten Sie anschließend die Access Control ein, damit das Modell vom ersten Tag an den richtigen Teams und virtuellen Schlüsseln zugewiesen ist.
OpenAI direkt und OpenRouter (openai/gpt-6.1-sol) sind heute bereits im Katalog enthalten; Eintragsoptionen für Microsoft Foundry und AWS Bedrock folgen in Kürze.
Sie sehen das Modell nicht in Ihrer Liste? Über + Add Model am Ende der Liste können Sie es manuell hinzufügen.
Schritt 2: Rufen Sie es auf. Öffnen Sie den Playground, wählen Sie das Modell aus und kopieren Sie das generierte Code-Snippet für das von Ihnen genutzte SDK. Die OpenAI-Python-Variante:
Modell-IDs sind nach dem Schema <Ihr-Provider-Konto>/<Modell> strukturiert, sodass der Wechsel von openai-main/gpt-6-sol zu openai-main/gpt-6.1-sol nur eine Anpassung in einer Zeile erfordert. Der Header X-TFY-METADATA verschlagwortet jeden Aufruf, sodass die Ausgaben in der Analytics-Ansicht nach Team oder Feature aufgeschlüsselt werden.
Schritt 3 (optional): Schalten Sie ein virtuelles Modell davor. Erstellen Sie ein virtuelles Modell und wählen Sie Auto Routing. Das Gateway klassifiziert jede Anfrage als einfach, mittel oder komplex und leitet sie an das Ziel weiter, das Sie dieser Stufe zugewiesen haben. Eine sinnvolle Startkonfiguration ist GPT-6 Luna für einfache, GPT-6.1 Sol für mittlere und GPT-6 Astra für komplexe Anfragen, mit GPT-6 Sol als Fallback, während sich die Rate Limits der Launch-Woche einpendeln. In unseren Benchmarks konnte ein solches Routing die Kosten um 50–70 % senken – bei etwa 98 % der ursprünglichen Qualität. Ihre Anwendung ruft durchgehend nur einen einzigen Modellnamen auf.
GPT-6.1 Sol ist die beste Wahl, wenn eine Anfrage mehr Kapazität als Luna benötigt, die Preise von Astra jedoch schwer zu rechtfertigen sind – und wenn Agenten lange Kontexte wiederholt senden, die durch die Cache-Rate von 0,10 $ besonders günstig werden. Der Einsatz über TrueFoundry stellt sicher, dass die Entscheidung darüber, welche Anfragen das betrifft, in der Gateway-Konfiguration liegt – wo Sie sie ohne erneutes Deployment anpassen können.
Testen Sie GPT-6.1 Sol auf dem TrueFoundry AI Gateway →
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















