August 26, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Large Language Models (LLMs) sind zum Rückgrat moderner KI-Anwendungen geworden und treiben alles an, von Chatbots und virtuellen Assistenten bis hin zu Recherche-Tools und Unternehmenslösungen. Doch nicht alle LLMs sind gleich – jedes hat seine eigenen Stärken, Einschränkungen und Kostenfaktoren. Einige sind exzellent im logischen Denken, während andere besser für kreatives Schreiben, Programmieren oder die Verarbeitung strukturierter Abfragen geeignet sind. Genau hier kommt ein LLM-Router ins Spiel.
Ein LLM-Router fungiert wie ein intelligenter Verkehrsleiter, der Benutzeranfragen automatisch an das für die jeweilige Aufgabe am besten geeignete Modell weiterleitet. Anstatt sich auf ein einziges Modell zu verlassen, können Unternehmen und Entwickler Leistung, Genauigkeit und Kosten optimieren, indem sie Abfragen in Echtzeit an das richtige LLM senden. Mit der zunehmenden Verbreitung von KI wird LLM-Routing zu einer unverzichtbaren Ebene für den Aufbau skalierbarer, zuverlässiger und effizienter KI-Systeme.
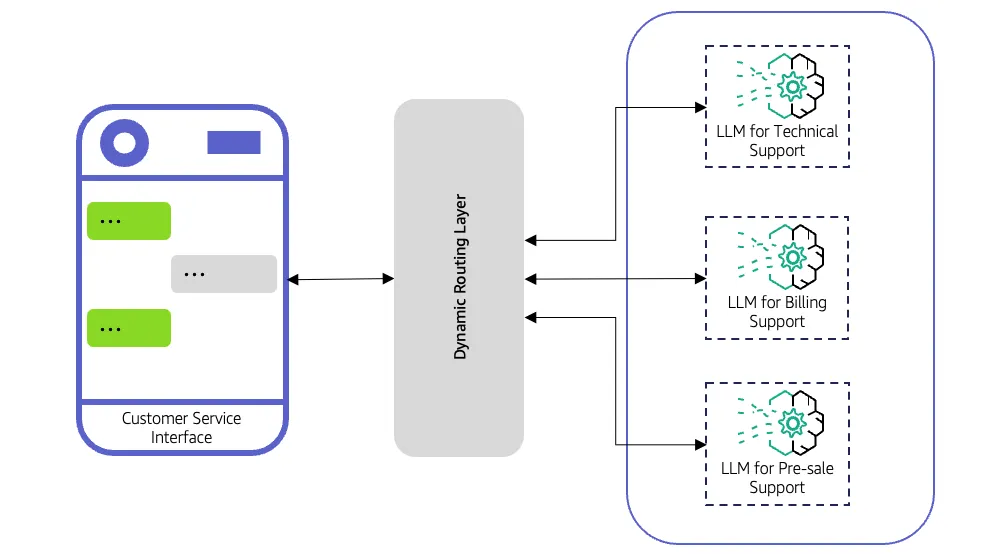
Ein LLM-Router entscheidet, welches Large Language Model jede Anfrage bearbeiten soll. Anstatt jede Abfrage an ein einzelnes Modell zu senden, bewertet er die Eingabe, wendet Routing-Logik an und leitet sie an das am besten geeignete Modell weiter.
Der Router kann einfachen Regeln folgen, wie etwa die Weiterleitung programmierbezogener Anfragen an ein auf Programmierung spezialisiertes Modell, oder er kann fortschrittliche Strategien wie Klassifikatoren, Embeddings oder leichtgewichtige Vorhersagemodelle nutzen, um zu bestimmen, welches LLM die beste Antwort liefert.
Funktionsweise
Dieser Ansatz beseitigt das Problem der „Einheitslösung“. Leichtgewichtige Modelle bearbeiten Routineanfragen effizient, während komplexe oder logikintensive Aufgaben an leistungsfähigere LLMs weitergegeben werden.
In der Praxis fungiert der Router als Schnittstelle zwischen Anwendungen und mehreren LLMs, wodurch die Leistung optimiert, Kosten gesenkt und die Abhängigkeit von einem einzelnen Anbieter minimiert wird. Dieses Setup stellt sicher, dass jede Anfrage das richtige Modell erreicht und KI-Systeme gleichzeitig zuverlässig und flexibel bleiben.

AI governance technologies operationalize an organization’s AI policies by providing oversight, risk management, compliance, observability and security across the AI life cycle. This Hype Cycle identifies the technologies that will help organizations implement AI governance responsibly and drive adoption at scale.
Unternehmen setzen zunehmend auf Large Language Models für Aufgaben, die von Chatbots und virtuellen Assistenten bis hin zur Inhaltserstellung und Datenanalyse reichen.
Die Verwendung eines einzigen LLM für alle Aufgaben bringt jedoch Herausforderungen mit sich. Manche Modelle antworten schnell, lassen aber Tiefe vermissen, während andere präzise Ergebnisse liefern, dies jedoch mit hoher Latenz und zu hohen Kosten. Ohne eine Möglichkeit, diese Unterschiede zu steuern, müssen Teams ständig Kompromisse zwischen Leistung, Genauigkeit und Budget eingehen.
Ein LLM-Router löst dieses Problem, indem er Anfragen intelligent an das für die jeweilige Aufgabe am besten geeignete Modell weiterleitet.
Betrachten wir folgendes Szenario:
Ein Kundensupport-System erhält zwei Arten von Anfragen.
Eine einfache Anfrage wie „Wie sind Ihre Öffnungszeiten?“ benötigt kein hochkomplexes Modell, während eine schwierige technische Frage zur Fehlerbehebung bei einem Produkt dies sehr wohl tut. Ohne einen LLM-Router könnten alle Anfragen an ein leistungsstarkes, teures Modell gehen. Dies erhöht die Kosten und verlangsamt die Antwortzeiten. Mit einem Router wird die einfache Anfrage an ein schnelles, leichtgewichtiges Modell geleitet, während die komplexe Anfrage an ein leistungsfähigeres LLM weitergegeben wird – das optimiert Geschwindigkeit, Kosten und Genauigkeit.
Vorteile für Unternehmen
Durch die intelligente Weiterleitung von Anfragen bieten Unternehmen schnellere, präzisere und kosteneffizientere KI-Dienste. LLM-Router verwandeln den KI-Einsatz von einem „One-Size-Fits-All“-Ansatz in ein flexibles, zuverlässiges und effizientes System, was sie zu einem unverzichtbaren Bestandteil moderner KI-Infrastruktur macht.
Ein LLM-Router ist mehr als nur ein Verkehrsleiter; er bietet mehrere Kernfunktionen, die KI-Systeme intelligenter, schneller und zuverlässiger machen. Das Verständnis dieser Funktionen hilft Unternehmen dabei, KI-Workflows zu entwerfen, die effizient skalieren und gleichzeitig die Qualität wahren.
Bevor ein Routing stattfindet, analysiert der Router die eingehenden Anfragen. Er untersucht Metadaten, Tags, den Abfragetyp, die Komplexität und manchmal auch die Absicht oder Stimmung. Diese Analyse liefert den Kontext, damit der Router entscheiden kann, welches Modell am besten für die Bearbeitung der Anfrage geeignet ist. Beispielsweise kann eine Kundenfrage zur Abrechnung an ein leichtgewichtiges Allzweck-LLM weitergeleitet werden, während eine technische Support-Anfrage an ein fachspezifisches Modell geht.
Der Router wählt das am besten geeignete Modell basierend auf mehreren Kriterien aus, darunter:
Durch die Berücksichtigung dieser Faktoren stellt der Router sicher, dass jede Anfrage das beste Gleichgewicht zwischen Geschwindigkeit, Genauigkeit und Kosten erhält.
Wenn mehrere Modelle dieselbe Aufgabe bewältigen können, verteilt der Router die Anfragen intelligent, um eine Überlastung einzelner Modelle zu vermeiden. Dies verbessert die allgemeine Reaktionsfähigkeit des Systems und sorgt für eine gleichbleibende Leistung bei Spitzenlasten.
Selbst die besten Modelle können ausfallen, Zeitüberschreitungen verursachen oder Antworten mit geringer Konfidenz liefern. Der Router implementiert Fallback-Mechanismen, die Anfragen automatisch an Backup-Modelle umleiten. Dies gewährleistet Kontinuität und Zuverlässigkeit, ohne den Benutzer zu beeinträchtigen.
Fortschrittliche Router verfolgen Nutzungsmuster, Modellleistung und Abfrageergebnisse. Diese Erkenntnisse helfen Teams dabei, Routing-Strategien zu optimieren, bessere Modelle auszuwählen und die Kosten im Laufe der Zeit zu senken.
Ein LLM-Router fungiert als Entscheidungszentrale von Multi-Modell-KI-Systemen. Durch die Analyse von Anfragen, die Auswahl des richtigen Modells, den Lastausgleich, die Fehlerbehandlung und die Bereitstellung von Erkenntnissen stellt er sicher, dass jede Anfrage effizient, präzise und zuverlässig verarbeitet wird. Diese Kombination von Funktionen macht LLM-Router zu einer entscheidenden Komponente beim Aufbau robuster, skalierbarer und kosteneffizienter KI-Lösungen.
LLM-Router und KI-Gateways werden oft zusammen genannt, da beide zwischen KI-Anwendungen und Sprachmodellen angesiedelt sind. Sie lösen jedoch unterschiedliche Probleme und operieren auf verschiedenen Ebenen des KI-Stacks.
Ein LLM-Router konzentriert sich darauf, Anfragen basierend auf Faktoren wie Kosten, Latenz, Leistung, Verfügbarkeit oder spezifischen Aufgabenanforderungen an das am besten geeignete Sprachmodell weiterzuleiten. Das Hauptziel besteht darin, die Modellauslastung zu optimieren und die Anwendungsleistung zu verbessern.
Ein AI Gateway bietet eine umfassendere Steuerungsebene für den KI-Datenverkehr. Neben dem Modell-Routing bieten KI-Gateways Funktionen wie Authentifizierung, Autorisierung, Ratenbegrenzung, Observability, Governance, Kostenverfolgung und Sicherheitskontrollen. Sie unterstützen Unternehmen dabei, KI-Workloads über verschiedene Modelle, Teams und Umgebungen hinweg zu verwalten und abzusichern.
LLM-Router nutzen verschiedene Strategien, um Anfragen effizient an das am besten geeignete Sprachmodell zu leiten. Diese Strategien lassen sich im Allgemeinen in drei Kategorien einteilen: statisch, dynamisch und hybrid, wobei fortschrittliche Systeme manchmal auch Reinforcement Learning integrieren.
Statisches Routing basiert auf vordefinierten Regeln, um zu entscheiden, welches Modell eine Anfrage bearbeitet. Es sorgt für ein konsistentes Routing-Verhalten und ist einfach zu implementieren.
Dynamisches Routing passt sich in Echtzeit an und wählt Modelle basierend auf der aktuellen Systemleistung und dem Kontext der Anfrage aus.
Hybrid-Strategien kombinieren statische und dynamische Ansätze für mehr Flexibilität und Effizienz.
Einige fortschrittliche Systeme nutzen Reinforcement Learning, um Routing-Entscheidungen kontinuierlich zu verbessern. Diese Router lernen aus vergangenen Anfragen und der Modellleistung, wodurch das Routing für komplexe oder sich entwickelnde Arbeitslasten im Laufe der Zeit optimiert wird.
Ein LLM-Router bietet mehrere entscheidende Vorteile, die KI-Systeme effizienter, zuverlässiger und kostengünstiger machen. Einer der Hauptvorteile ist die optimierte Leistung.
Durch die intelligente Weiterleitung jeder Anfrage an das für die jeweilige Aufgabe am besten geeignete Modell stellt der Router sicher, dass leistungsstarke, logisch denkende Modelle komplexe Fragen bearbeiten, während leichtgewichtige, schnellere Modelle einfachere Anfragen verarbeiten. Dieser Ansatz gleicht Geschwindigkeit und Genauigkeit aus und verbessert das allgemeine Nutzererlebnis.
Ein weiterer wesentlicher Vorteil ist die Kosteneffizienz. Ohne einen Router leiten Unternehmen möglicherweise alle Anfragen durch hochleistungsfähige Modelle, was die Betriebskosten unnötig in die Höhe treibt. Der Router stellt sicher, dass teure Modelle für hochwertige oder komplexe Anfragen reserviert bleiben, während Routineaufgaben oder repetitive Anfragen von weniger ressourcenintensiven Modellen übernommen werden. Dies senkt die Rechenkosten und maximiert den ROI.
Auch die Zuverlässigkeit verbessert sich durch einen LLM-Router. Fortschrittliche Router verfügen über Fallback-Mechanismen, die Anfragen automatisch umleiten, falls ein Modell ausfällt, eine Zeitüberschreitung auftritt oder Ergebnisse mit geringer Konfidenz geliefert werden. Dies gewährleistet eine konsistente und verlässliche Leistung und verhindert Unterbrechungen in Echtzeitanwendungen wie dem Kundensupport oder bei virtuellen Assistenten.
Darüber hinaus bieten LLM-Router Flexibilität. Unternehmen können mehrere Modelle verschiedener Anbieter integrieren und für jede Aufgabe das jeweils beste auswählen.
Dies verringert die Abhängigkeit von einem einzelnen Anbieter und ermöglicht es Teams, mit verschiedenen Modellen zu experimentieren, sobald neue Funktionen verfügbar werden.
Schließlich unterstützen Router die Skalierbarkeit. Wenn das Abfragevolumen wächst, verteilt der Router die Anfragen intelligent auf die Modelle, verhindert so eine Überlastung und sorgt für eine reibungslose Systemleistung.
Durch die Kombination von optimiertem Routing, Kosteneinsparungen, Zuverlässigkeit, Flexibilität und Skalierbarkeit verwandelt ein LLM-Router KI-Implementierungen von einem starren Ansatz mit nur einem Modell in ein dynamisches, effizientes und belastbares System.
LLM-Router werden in Unternehmen zunehmend eingesetzt, um die Leistung, Zuverlässigkeit und Effizienz von KI zu optimieren. Sie ermöglichen ein intelligentes Abfrage-Routing und stellen sicher, dass jedes Modell die Aufgabe übernimmt, die seiner Komplexität, seinem Fachbereich und seinem Kontext entspricht.
Automatisierung des Kundensupports
Unternehmen bearbeiten täglich Tausende von Kundenanfragen, von einfachen FAQs bis hin zu komplexen technischen Problemen. LLM-Router leiten Routinefragen an schnelle, leichtgewichtige Modelle weiter, während komplizierte Anliegen an leistungsfähigere Modelle übergeben werden. Dies gewährleistet schnelle, präzise und konsistente Antworten, verbessert die Kundenzufriedenheit und entlastet den operativen Betrieb.
Wissensmanagement und Unternehmenssuche
Unternehmen verwalten große Bestände an internen Dokumenten, Handbüchern und Richtlinien. Router analysieren Abfragen und leiten sie an Modelle weiter, die auf logisches Denken, Zusammenfassungen oder fachspezifisches Wissen optimiert sind. Mitarbeiter erhalten präzise, kontextbezogene Informationen, ohne dass teure Modelle überlastet werden.
Workflow- und Aufgabenautomatisierung
LLMs werden häufig für die Berichterstellung, Datenanalyse und Entscheidungsunterstützung eingesetzt. Router weisen hochkomplexe Abfragen dynamisch leistungsstarken Modellen und Routineaufgaben leichteren Modellen zu, wodurch Geschwindigkeit, Genauigkeit und Rechenkosten in den Unternehmensabläufen in Einklang gebracht werden.
Multi-Modell-Orchestrierung
Unternehmen setzen häufig mehrere LLMs über verschiedene Anbieter oder Fachbereiche hinweg ein. Router verwalten die Modellauswahl, den Lastausgleich und Fallback-Mechanismen und gewährleisten so Zuverlässigkeit, Flexibilität und Skalierbarkeit in großen KI-Systemen.
Produktempfehlungen und Personalisierung
Für E-Commerce- oder SaaS-Plattformen können LLM-Router Personalisierungsaufgaben Modellen zuweisen, die auf Nutzerverhalten und Kontext trainiert wurden, während allgemeine Empfehlungen an einfachere Modelle delegiert werden. Dies verbessert die Genauigkeit und Leistung der Empfehlungen bei gleichzeitiger Kostenkontrolle.
Compliance und Risikoanalyse
In Finanz-, Rechts- oder Gesundheitsunternehmen können Abfragen die strikte Einhaltung von Vorschriften oder fachspezifischen Richtlinien erfordern. Router können sensible oder kritische Anfragen an Modelle mit Fachwissen weiterleiten, um die Compliance sicherzustellen, während allgemeine Aufgaben von Standardmodellen bearbeitet werden.
Content-Erstellung und Zusammenfassung
Für Marketing, Wissensaustausch oder Dokumentation können LLM-Router komplexe Aufgaben zur Inhaltserstellung hochwertigen Modellen und einfachere Aufgaben wie Zusammenfassungen oder Entwürfe schnelleren Modellen zuweisen, um die Effizienz zu optimieren, ohne die Qualität der Ergebnisse zu beeinträchtigen.
Durch den Einsatz von LLM-Routern in diesen vielfältigen Szenarien können Unternehmen ihre KI intelligent skalieren und dabei Leistung, Zuverlässigkeit und Kosteneffizienz über mehrere Workflows und Anwendungen hinweg aufrechterhalten.
Nachdem wir untersucht haben, wie LLM-Router eine breite Palette von Unternehmensanwendungen unterstützen, ist es wichtig zu verstehen, wie sie sich von einer weiteren Schlüsselkomponente in Multi-Modell-KI-Systemen unterscheiden.
Ein LLM-Router konzentriert sich auf intelligentes Request-Routing. Seine Hauptaufgabe besteht darin, eingehende Anfragen zu analysieren, Kontext, Komplexität und Metadaten zu bewerten und jede Anfrage an das am besten geeignete Modell weiterzuleiten. Router nutzen häufig fortschrittliche Strategien wie dynamisches Routing, kontextbezogene Entscheidungsfindung und Fallback-Mechanismen, um Genauigkeit, Geschwindigkeit und Kosten zu optimieren.
Sie sind besonders in Umgebungen entscheidend, in denen Anfragen hinsichtlich Typ, Domäne oder Rechenanforderungen stark variieren, da sie es Unternehmen ermöglichen, die Last auszugleichen und eine hohe Leistung aufrechtzuerhalten.
Ein LLM-Gatewayhingegen fungiert als zentraler Zugangspunkt für die Interaktion mit einem oder mehreren LLMs. Seine Hauptaufgabe besteht darin, die Integration zu vereinfachen, standardisierte APIs bereitzustellen, die Authentifizierung zu verwalten, Ratenbegrenzungen zu handhaben und die Nutzung zu überwachen.
Im Gegensatz zu Routern treffen Gateways in der Regel keine intelligenten Entscheidungen zur Modellauswahl; sie bieten einheitlichen Zugriff und operative Kontrollen, um Multi-Modell-Bereitstellungen zu erleichtern. Gateways konzentrieren sich eher auf das Management auf Infrastrukturebene, Sicherheit und Skalierbarkeit als auf die Optimierung auf Anfrageebene.
Wichtige Unterschiede
Router und Gateways arbeiten oft in geschichteten Architekturen zusammen. Das Gateway bietet einen sicheren, standardisierten Einstiegspunkt für Anwendungen, während der Router dahinter sitzt und intelligente Entscheidungen zur Modellauswahl trifft. Diese Kombination ermöglicht es Unternehmen, sowohl operative Kontrolle als auch eine optimierte Anfragenverarbeitung zu erreichen.
Das Verständnis des Unterschieds zwischen LLM-Routern und LLM-Gateways hilft Unternehmen dabei, Multi-Modell-KI-Systeme effektiv bereitzustellen.
Router sorgen für eine intelligente, kontextbezogene Leistung, während Gateways einen sicheren, skalierbaren und zuverlässigen Zugriff gewährleisten und so ein robustes Fundament für Unternehmens-KI schaffen.
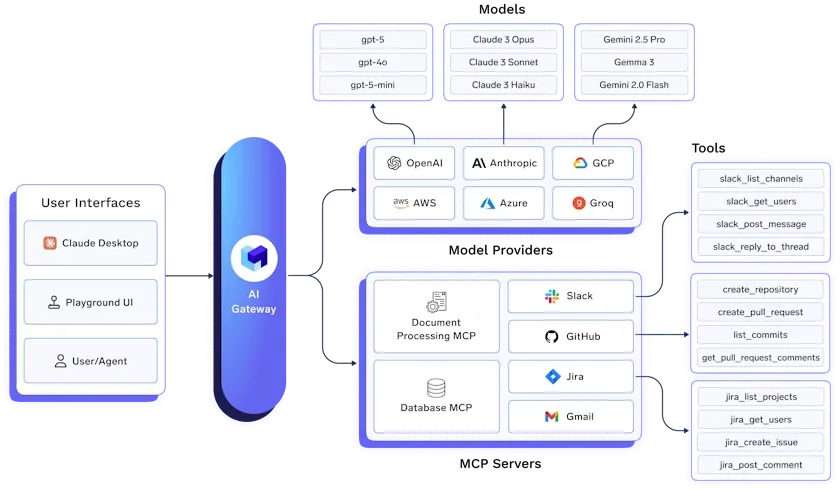
Das TrueFoundry LLM-Gateway ist eine unternehmenstaugliche Plattform, die den Zugriff auf alle wichtigen Large Language Models (LLMs) über eine einzige, sichere und leistungsstarke API vereinheitlicht.
Es vereinfacht die GenAI-Infrastruktur durch die Integration von über 250 Modellen, darunter OpenAI, Anthropic Claude, Gemini, Groq, Mistral und Open-Source-Frameworks, ohne dass Codeänderungen erforderlich sind. Teams können eine konsistente API für Chat-, Completion-, Embedding- und Reranking-Workloads nutzen und gleichzeitig die Authentifizierung sowie das API-Key-Management zentralisieren.
Hauptfunktionen:
Da Unternehmen zunehmend auf mehrere Large Language Models setzen, sind Tools wie LLM-Router und LLM-Gateways für die Skalierung von KI unverzichtbar geworden. LLM-Router bringen Intelligenz in das System, indem sie jede Anfrage analysieren und sicherstellen, dass sie das für die Aufgabe am besten geeignete Modell erreicht. Dies verbessert die Leistung, senkt die Kosten und erhöht die Zuverlässigkeit, insbesondere bei komplexen Workflows mit hohem Volumen.
Gateways hingegen bilden das Rückgrat für einen sicheren, standardisierten Zugriff auf Modelle, vereinfachen die Integration, überwachen die Nutzung und setzen betriebliche Kontrollen durch.
Zusammen bilden diese Komponenten eine geschichtete KI-Architektur, die Intelligenz mit betrieblicher Effizienz in Einklang bringt. Durch die Kombination der Entscheidungsfähigkeit von Routern mit der strukturellen Zuverlässigkeit von Gateways können Unternehmen den Wert mehrerer LLMs maximieren und gleichzeitig Skalierbarkeit und Kontrolle wahren.
Die Einführung von LLM-Routern ist keine Option mehr, sondern eine Notwendigkeit für Unternehmen, die schnelle, präzise und kosteneffiziente KI-Dienste bereitstellen wollen. Das Verständnis ihrer Rolle, zusammen mit der von Gateways, versetzt Teams in die Lage, robuste KI-Infrastrukturen zu entwerfen, die den unterschiedlichsten geschäftlichen Anforderungen gerecht werden.
Da sich KI-Modelle ständig weiterentwickeln und vervielfältigen, wird die Beherrschung von intelligentem Routing und strukturiertem Zugriff entscheidend für Unternehmen sein, die in der sich schnell entwickelnden KI-Landschaft wettbewerbsfähig bleiben wollen.
LLM-Routing funktioniert durch die Bewertung eingehender Anfragen anhand vordefinierter Logik, semantischer Embeddings oder Klassifizierungsregeln. Das System leitet den Datenverkehr basierend auf Kontext, erforderlicher Genauigkeit oder der Latenz des Upstream-Anbieters. Ein zentrales Gateway verwaltet diese komplexen Konfigurationen, um die Modellauswahl und das Failover zu automatisieren, ohne dass für jedes Modell-Update manuelle Codeänderungen erforderlich sind.
Die LLM-Routing-Klassifizierung verwendet ein hocheffizientes Modell, um Prompts vor der Ausführung der Inferenz zu kategorisieren. Dieser Schritt identifiziert die Absicht, wie etwa einfache Begrüßungen gegenüber komplexen Programmieraufgaben. Die automatisierte Klassifizierung verhindert die Überbeanspruchung teurer Frontier-Modelle, indem Anfragen mit geringer Komplexität an kleinere, schnellere und kostengünstigere Alternativen weitergeleitet werden.
TrueFoundry vereint LLM-Routing- und KI-Gateway-Funktionen durch die Zusammenführung von Traffic-Orchestrierung mit Governance und Sicherheit. Die Plattform steuert Modell-Failover, Ratenbegrenzung und kostenbewusstes Routing innerhalb einer einzigen zentralen Steuerungsebene. Diese Infrastruktur stellt sicher, dass KI-Bereitstellungen in Unternehmen hochgradig resilient und kosteneffizient für groß angelegte Produktionsumgebungen sind.
Zu den führenden LLM-Routern gehören TrueFoundry für die Orchestrierung auf Unternehmensebene, LiteLLM für eine einheitliche Proxy-API und Martian für die automatisierte Modellauswahl. Weitere Top-Optionen der Branche sind Portkey für fortschrittliche Guardrails, Helicone für eine extrem schnelle Beobachtbarkeit und OpenRouter für den einfachen Zugriff auf Hunderte von Open- und Closed-Source-Modellen.
LLM-Router analysieren Abfragemetadaten, Typ und Kontext, um ein Modell auszuwählen. Zu den Auswahlfaktoren gehören Fachwissen, Schlussfolgerungsfähigkeit, Latenz und Kosten. Einfache Anfragen werden an leichtgewichtige Modelle weitergeleitet, komplexe Aufgaben an leistungsfähige Modelle. Fortschrittliche Router können Embeddings oder prädiktive Klassifikatoren für ein intelligentes Routing in Echtzeit nutzen.
Zu den Kernfunktionen eines LLM-Routers gehören die Analyse von Anfragen, intelligente Modellauswahl, Lastverteilung, Fallback-Management und Überwachung. Router verteilen Anfragen auf mehrere LLMs, leiten fehlgeschlagene Anfragen um und verfolgen die Leistung. Dies stellt sicher, dass Aufgaben effizient verarbeitet werden, Modelle optimal genutzt werden und das System in KI-Workflows von Unternehmen zuverlässig und skalierbar bleibt.
Zu den gängigen Arten von LLM-Routern gehören regelbasiertes, kostenbasiertes, leistungsbasiertes und aufgabenbasiertes Routing. Regelbasierte Router folgen vordefinierten Bedingungen, kostenbasierte Router wählen günstigere Modelle, leistungsbasierte Router wählen Modelle mit besserer Genauigkeit oder Geschwindigkeit, und aufgabenbasierte Router leiten Anfragen an Modelle weiter, die auf Aufgaben wie Programmierung, Chat oder Zusammenfassungen spezialisiert sind.
LLM-Routing erfolgt durch die Analyse der Benutzeranfrage und deren Weiterleitung an das am besten geeignete Modell. Entwickler definieren Regeln oder verwenden Algorithmen, die Faktoren wie Aufgabentyp, Kosten, Latenz und Modellkapazität berücksichtigen. Eine Routing-Ebene bewertet die Eingabe und sendet die Abfrage automatisch an das entsprechende LLM.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet