October 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 6, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
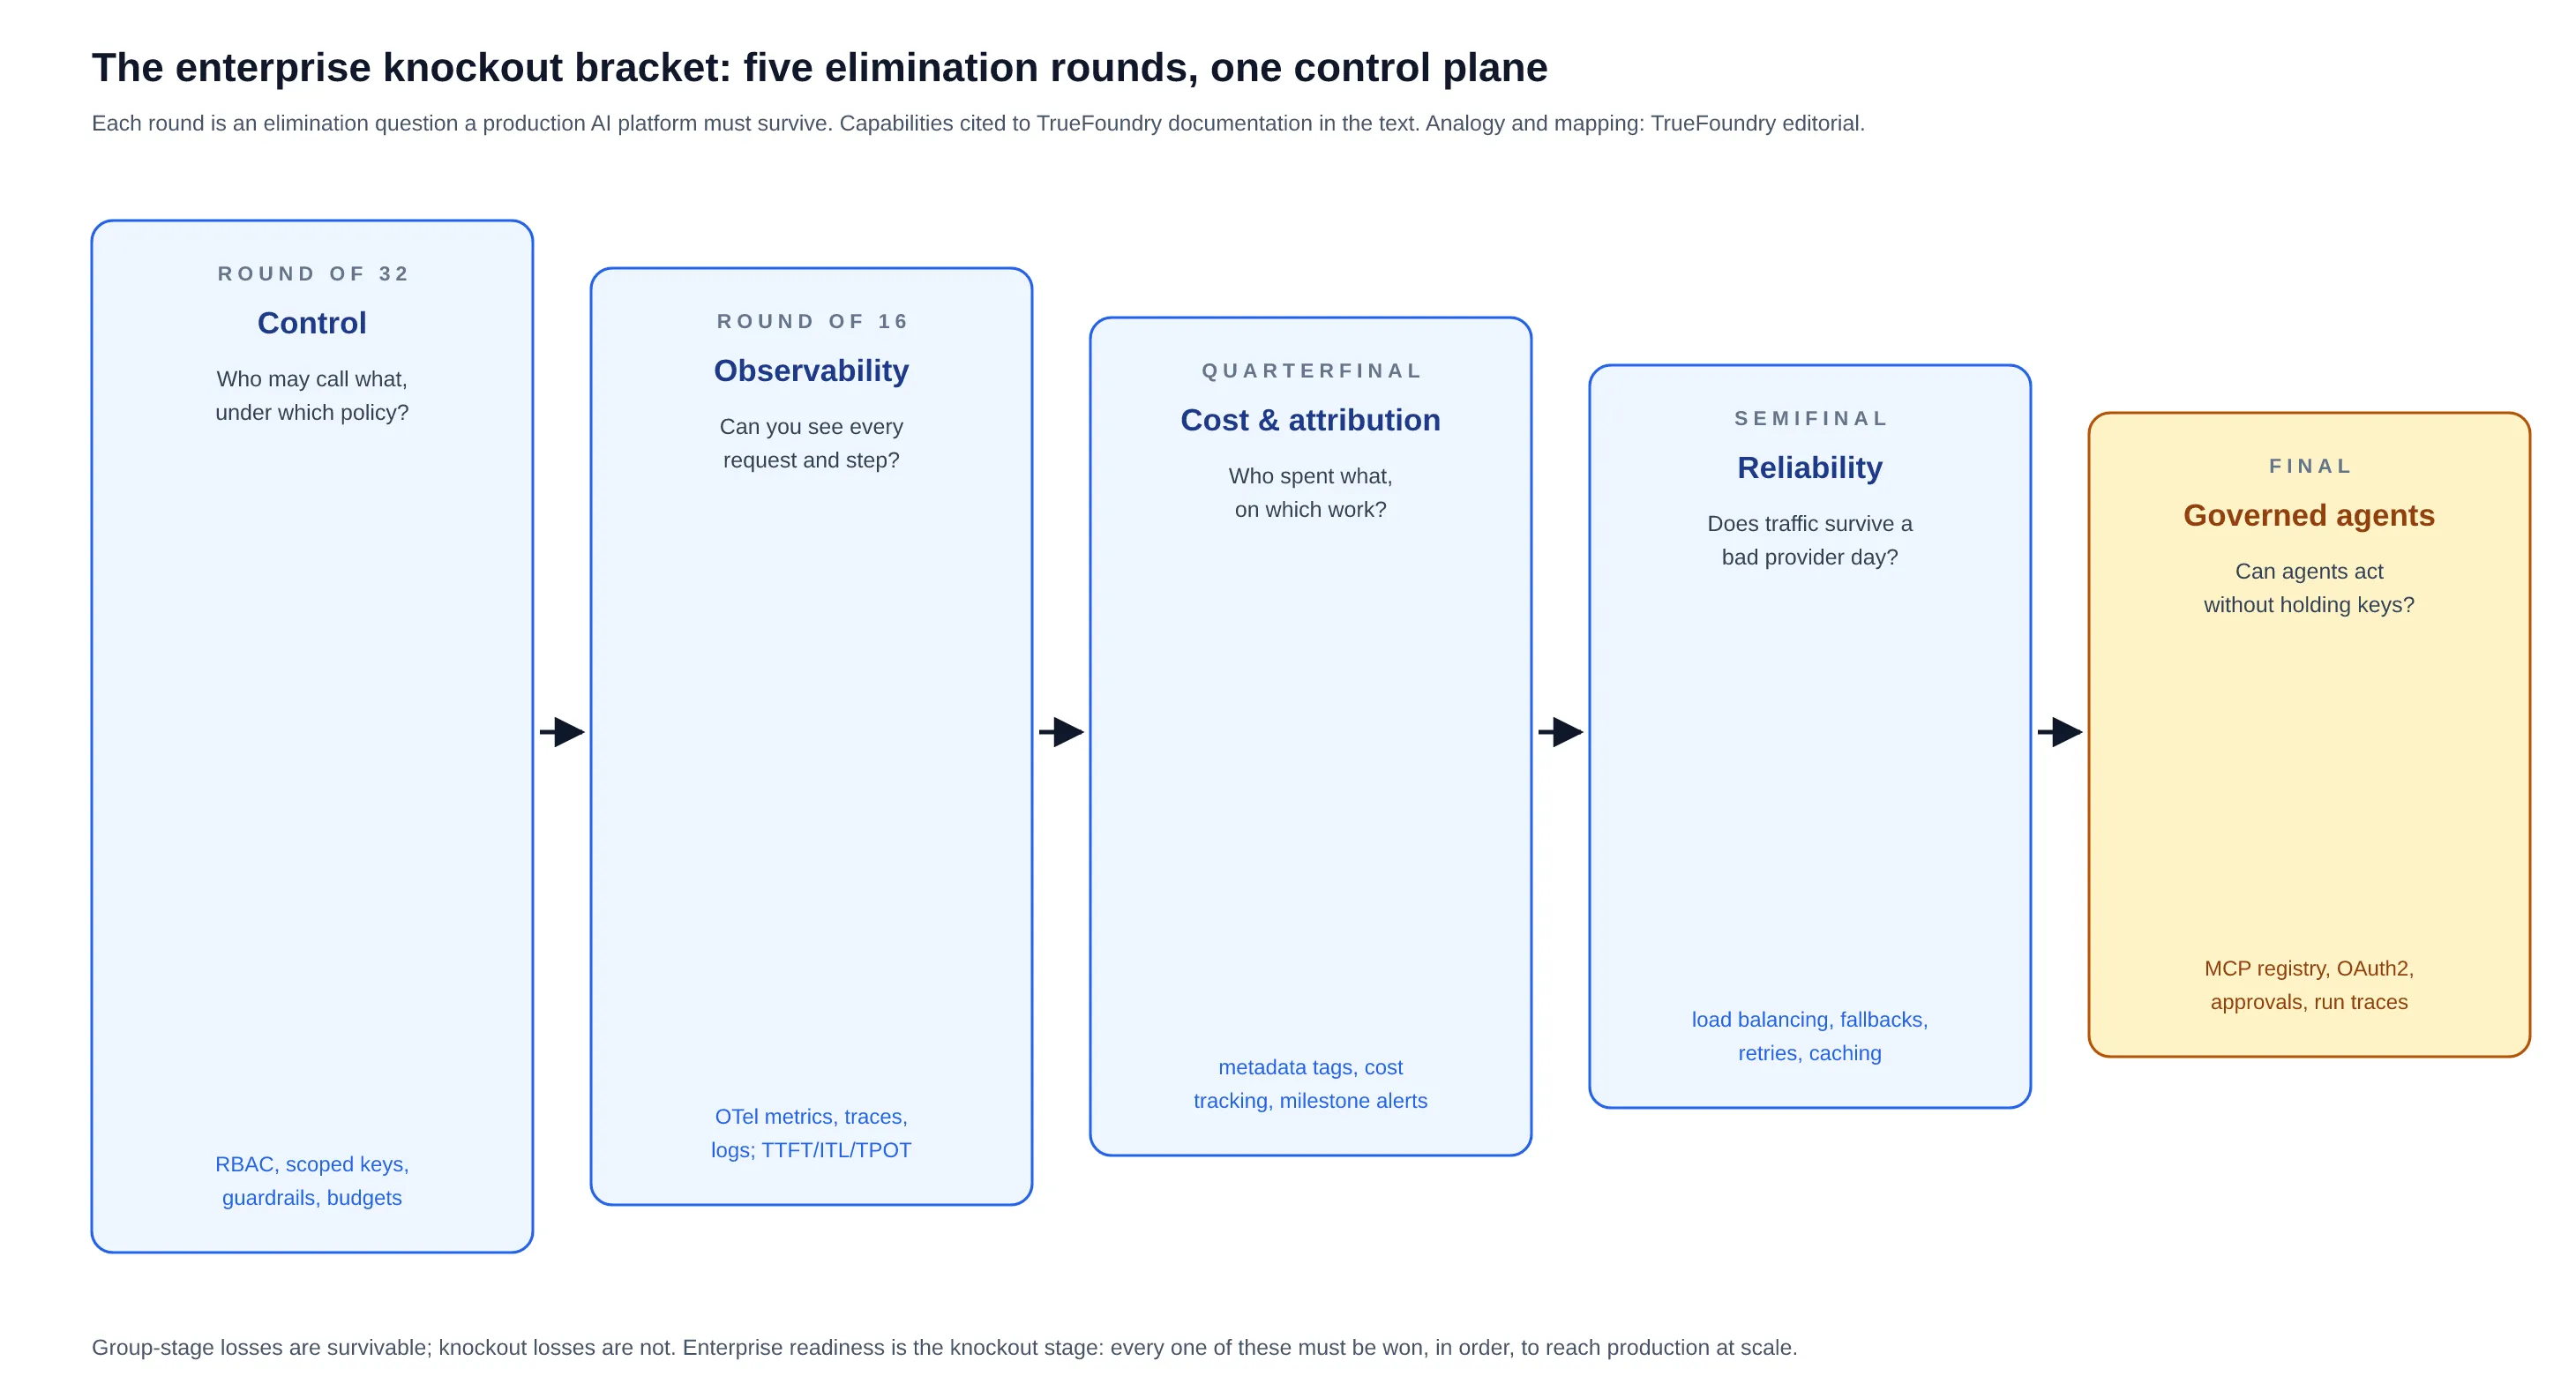
Am Sonntag, den 19. Juli 2026, wird im MetLife Stadium – in FIFA-Unterlagen als New York New Jersey Stadium bezeichnet – ein Team den Pokal in die Höhe stemmen, der die erste FIFA-Weltmeisterschaft™ mit 48 Mannschaften beendet – ein Turnier mit 104 Spielen, dessen entscheidendes Merkmal ein Phasenwechsel ist. Zwei Wochen lang war die Gruppenphase verzeihend: Man konnte ein Spiel verlieren, den Kader rotieren lassen, eine Formation ausprobieren, die nicht funktionierte, und trotzdem weiterkommen. Dann begann die K.-o.-Phase und die Arithmetik kehrte sich um. In den K.-o.-Runden – erstmals mit einer Runde der letzten 32, dann Achtelfinale, Viertelfinale, Halbfinale, Finale – sammelt niemand mehr Punkte. Man gewinnt, oder man fährt nach Hause. Wer am 19. Juli den Pokal in die Höhe stemmt, wird fünf K.-o.-Spiele in Folge überstanden haben. Enterprise-KI hat gerade denselben Phasenwechsel durchlaufen. Die letzten drei Jahre waren die Gruppenphase: Viele Unternehmen haben etwas auf den Markt gebracht – einen Piloten, einen Copiloten oder einen internen Chatbot – und Verluste waren verkraftbar, weil es sich um Experimente handelte. Diese Phase ist vorbei. Was darüber entscheidet, wer die Produktion im großen Maßstab erreicht, ist eine K.-o.-Runde der anderen Art: Enterprise-Bereitschaft, die in fünf K.-o.-Runden ausgetragen wird – Kontrolle, Beobachtbarkeit, Kostenzuordnung, Zuverlässigkeit und gesteuerte Agenten –, bei denen eine einzige unbeantwortete Frage das Aus bedeutet. Dieser Beitrag geht jede Runde der Reihe nach durch, wobei die technischen Details aus der Dokumentation von TrueFoundry stammen, denn das Muster, das alle fünf Runden gewinnt, ist dasselbe, das jede einzelne gewinnt: eine Steuerungsebene im Datenverkehr. Die Analogie stammt von uns; die Funktionen sind dokumentiert.
Die Gruppenphase ist dazu da, Fehler zu verzeihen. Drei Spiele, Punkte sammeln, eine Niederlage ist Datenmaterial. Teams nutzen sie so, wie Unternehmen die Jahre 2023–2025 genutzt haben: um Kader, Formationen und Ideen auszuprobieren, deren Scheitern wenig kostet. Diese Ära brachte echte Erkenntnisse hervor – viele Organisationen haben heute irgendwo im Unternehmen KI-Systeme aktiv im Einsatz –, aber sie brachte auch Gewohnheiten hervor, die in der nächsten Phase bestraft werden. API-Schlüssel, die in Anwendungskonfigurationen kopiert wurden, weil es schneller ging. Ausgaben, die erst auf der monatlichen Rechnung entdeckt wurden, weil niemand pro Anfrage kontrollierte. Eine Anbieterintegration pro Team, weil jedes Team alleine anfing. Keine Spur davon, was der Agent tatsächlich getan hat, weil der Agent nur eine Demo war. Nichts davon führte zum Ausscheiden in der Gruppenphase. Alles davon führt zum Ausscheiden in der K.-o.-Phase, weil sich in der K.-o.-Phase die Kosten für eine Lücke ändern. Die folgende Tabelle zeigt den Phasenwechsel auf einen Blick; der Rest dieses Beitrags spielt den Turnierbaum durch.
Eine weitere Eigenschaft von Turnieren lässt sich unangenehm gut übertragen: Das Team, das seine Gruppe anführt, ist nicht unbedingt das Team, das den Pokal gewinnt. Die Dominanz in der Gruppenphase misst die Leistung unter Bedingungen mit geringem Risiko – und genau das hat die Gruppenphase der Enterprise-KI gemessen. Der Pilot, der bei der Demo begeisterte, der Copilot mit den besten internen Nutzungszahlen, der Chatbot, der den Hackathon gewann: Das sind Ergebnisse der Gruppenphase. Und Siege in der Gruppenphase sind echte Siege – es lohnt sich, sie zu feiern und aus ihnen zu lernen. Eine brillante Demo, die eine Gruppe von Führungskräften beeindruckt; eine schicke KI-App der Version 1, von der jeder erwartet, dass sie durchstartet; das interne Tool, das einen festen Platz bei der Mitarbeiterversammlung bekommt – jedes davon ist das Enterprise-Äquivalent zum Gruppensieg aufgrund der Tordifferenz: ein Beweis für die Angriffsqualität, gemessen unter Bedingungen, in denen ein schlechtes Spiel nichts als den Stolz kostete. Die Lieblinge der Gruppenphase in der Geschichte sind ebenso eine Warnung wie eine Inspiration – die Turniergeschichte ist voll von Mannschaften, die in drei Spielen munter trafen und in der ersten K.-o.-Runde gegen Gegner nach Hause fuhren, die verteidigen konnten. K.-o.-Runden stellen eine andere Frage – nicht „Wer sah am besten aus, als Verlieren noch erlaubt war?“, sondern „Wer hält stand, wenn ein einziger Fehler das Aus bedeutet?“
Fergusons Satz ist die K.-o.-These in acht Worten, und Vogels’ Satz ist die Übersetzung für Unternehmen: Fähigkeiten gewinnen Demos; die Disziplin, Fehler zu überstehen, gewinnt die Produktion. Jede der folgenden Runden ist eine defensive Frage.
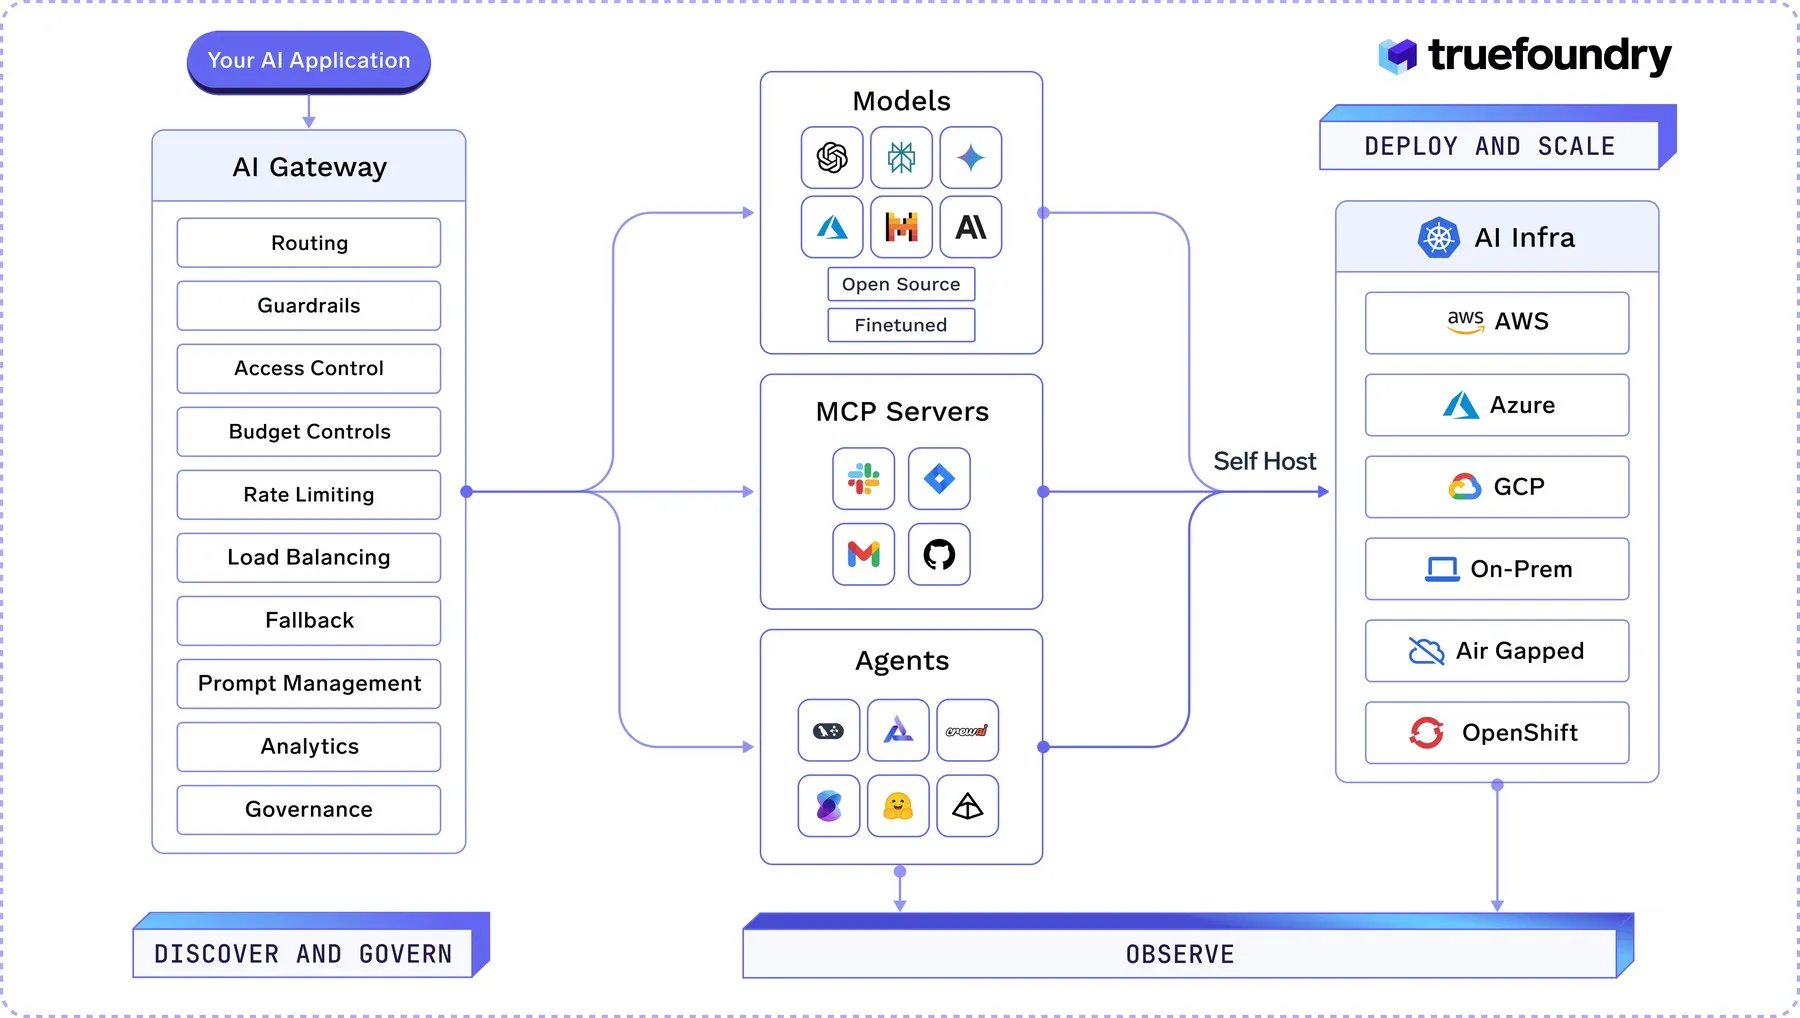
Die erste K.-o.-Runde eliminiert die meisten Teams, und zwar aufgrund von Grundlagen. Für eine KI-Plattform ist die Grundlage der Zugriff: In dem Moment, in dem mehr als ein Team mehr als ein Modell aufruft, hört „Wer darf was aufrufen?“ auf, eine Frage für die Tabelle zu sein, und wird zu einer Frage des Anforderungspfads. Die dokumentierte Antwort des Gateways umfasst vier Ebenen, die alle eher Konfiguration als Anwendungscode sind. Identität und Autorisierung: rollenbasierte Zugriffskontrolle und bereichsbezogene API-Schlüssel für Benutzer, Teams und Anwendungen, damit der Schlüssel eines Data-Science-Teams nicht die produktive Route für Kunden aufrufen kann (Dokumentation zur Zugriffskontrolle). Drosselung: Ratenbegrenzungen, die pro Benutzer, pro Modell und pro Anwendung definierbar sind (Dokumentation zur Ratenbegrenzung). Geld: Budgets für Mandanten und Teams, deren Regeln mit Benutzern, Modellen und Metadaten übereinstimmen, mit Warn- und strikten Durchsetzungsmodi sowie Budget-Meilenstein-Warnungen – der Mechanismus, der die Erkundung frei laufen lässt, während die Produktion strikt bleibt (Dokumentation zum Budget). Und Inhalt: Leitplanken für die Erkennung personenbezogener Daten (PII), Überprüfung auf Prompt-Injection, Inhaltsmoderation und benutzerdefinierte Richtlinien, die auf Anfragen und Antworten im Bereitstellungspfad angewendet werden (Dokumentation zu Leitplanken. Teams, die diese Runde meistern, bemerken sie kaum – und genau das ist der Punkt. Kontrolle ist die Runde, die man gewinnt, indem man die Frage bereits beantwortet hat, bevor sie in einer Incident-Analyse überhaupt gestellt wurde.
Bevor wir uns die einzelnen Runden ansehen, hier die Plattform auf einen Blick: eine zentrale Gateway-Ebene zwischen jeder Anwendung und jedem Modell, Tool und Agent – dieselbe Ebene, die in den fünf folgenden Runden aus unterschiedlichen Blickwinkeln beleuchtet wird.
In einem K.-o.-Spiel verliert der Trainer, der das Spielfeld nicht überblicken kann, gegen den, der es kann. Observability ist diese Runde, und hier geht dieser Beitrag am tiefsten ins Detail, weil es die Dokumentation auch tut. (Wo wir gerade von Auszeichnungen sprechen: TrueFoundry erhielt 2026 zwei Branchenpreise – AI Breakthrough’s LLM Platform of the Year und AIBoomi’s DevTools & Infrastructure Startup of the Year – und wurde als Representative Vendor im Gartner Market Guide 2025 für AI Gatewaysgeführt.) Das Metrics Dashboard von TrueFoundry bietet laut Dokumentation – um es mit ihren eigenen Worten zu sagen – „ein vollständiges Bild der Gesundheit und Effizienz Ihres AI Gateways“. Dies ist das einzige direkte Zitat aus der Dokumentation in diesem Beitrag, und das Kleingedruckte unter diesem Satz hat es in sich (Observability-Dokumentation). Der Reiter „Overview“ fasst den LLM- und MCP-Traffic auf einem Bildschirm zusammen: Gesamtkosten mit Periodenvergleich, Anzahl der LLM-Aufrufe, Anzahl der MCP-Aufrufe, Aufschlüsselung der eingehenden Anfragen nach Endpunkttyp, separate Fehleranalysen für Modell- und MCP-Traffic, eine Zusammenfassung der Guardrails mit Bewertungsanzahl und Ergebnissen – blockiert, markiert oder verändert – sowie Ranglisten bis hinunter auf die Ebene des am häufigsten aufgerufenen MCP-Tools.
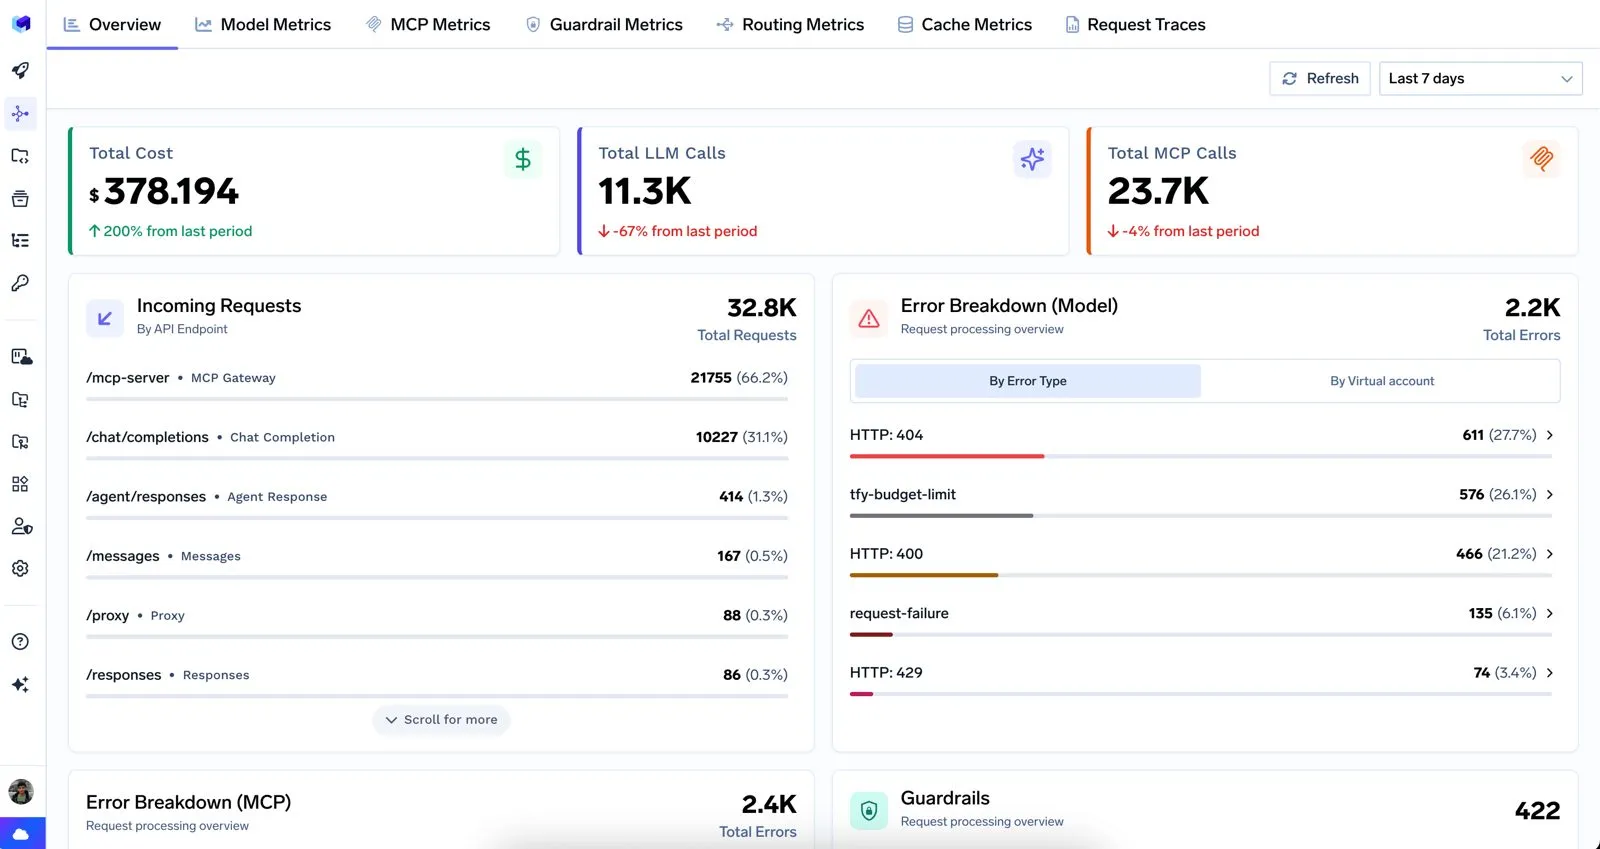
Der Tab „Modell-Metriken“ ist das Herzstück der Performance-Analyse am Spieltag. Seine Latenz-Terminologie ist exakt auf die Anforderungen von Streaming-KI-Produkten zugeschnitten. Vier dokumentierte Signale, jeweils mit P50/P75/P90/P99-Perzentil-Auswahl: Anfrage-Latenz (End-to-End, vom Gateway-Eingang bis zur vollständigen Antwort), Zeit bis zum ersten Token (die wahrgenommene Geschwindigkeit für den Streaming-Nutzer), Inter-Token-Latenz (die Flüssigkeit des Streams) und Zeit pro Ausgabe-Token (Generierungsdurchsatz). Daneben: Anfragen pro Sekunde, Fehlerrate im Zeitverlauf sowie Fehleraufschlüsselungen nach Fehlertyp und HTTP-Statusklasse. Für agentischen Traffic beschreibt die Dokumentation Traces auf Schritt-Ebene – welche Tools ein Agent aufgerufen hat, wie Zwischenergebnisse flossen – sowie eine Ansicht auf Anfrage-Ebene, die für protokollierte Anfragen Prompt- und Antwortdaten zeigt und wie Routing, Fallbacks und Guardrails auf diesen spezifischen Aufruf angewendet wurden (Plattform-Übersicht). Und da kein Unternehmen ein weiteres Monitoring-Silo möchte, ist die Telemetrie OpenTelemetry-kompatibel und kann an externe Observability-Backends exportiert werden, einschließlich des von TrueFoundry dokumentierten Prometheus- und Grafana-Setups (Gateway-Dokumentation). Die folgende Tabelle betrachtet die dokumentierten Signale als K.o.-Kriterien.
Im Viertelfinale verlieren gute Teams gegen organisierte, und bei den Kosten verlieren gute KI-Programme gegen solche mit klarer Zuordnung. Der Mechanismus, der diese Runde entscheidet, ist ein Selektor. Das dokumentierte Metriken-Dashboard lässt jedes Diagramm nach einer „Ansicht nach“-Dimension filtern: Modelle, virtuelle Modelle, Nutzer, virtuelle Konten, Teams – oder benutzerdefinierte Metadaten-Schlüssel, die in Anfrage-Headern gesendet werden. Die Dokumentation beschreibt dies als den Weg, Ansichten nach Mandant, Umgebung oder Funktion zu erstellen (Observability-Dokumentation). Letztere Option ist der heimliche Gewinner dieser Runde. Metadaten-Tagging bei der Anfrage plus Kostenberechnung bei der Antwort bedeutet: Diagramme zu Inferenzkosten im Zeitverlauf nach der Dimension, nach der das Unternehmen budgetiert – Team für interne Leistungsverrechnung, virtuelles Konto für anwendungsbezogenes Tracking, Metadaten für jede Struktur, die das Unternehmen tatsächlich nutzt. Die Zuordnung speist dann die Durchsetzung: Derselbe Budget-Mechanismus aus der Runde der 32 eskaliert von Meilenstein-Warnungen bis hin zum harten Stopp, wenn ein Team sein Limit erreicht (Budget-Dokumentation). Und zwei dokumentierte Funktionen senken die Rechnung, bevor die Zuordnung überhaupt greift: semantisches Caching, das Kosten und Latenz bei wiederholten Anfragen reduziert, sowie Batch-APIs für asynchrone Workloads zu Batch-Preisen (Caching-Dokumentation; Gateway-Dokumentation). Teams, die diese Runde mit geteilten Schlüsseln und einer einzigen Rechnungsposition erreichen, stellen fest: Das Problem ist nicht, dass sie zu viel ausgegeben haben, sondern dass sie nicht sagen können, wofür – und eine nicht zuordenbare Rechnung lässt sich weder rechtfertigen noch reduzieren.
Im Halbfinale sind nur noch die Besten dabei; was sie unterscheidet, ist das Verhalten bei Störungen während des laufenden Betriebs. Modellanbieter haben schlechte Tage – Rate-Limit-Stürme, erhöhte Fehlerraten, regionale Verlangsamungen – und die entscheidende Frage ist, ob deren schlechter Tag zum schlechten Tag Ihres Produkts wird. Die dokumentierte Antwort ist die Routing-Richtlinie am Gateway: Lastverteilung über Modelle hinweg nach Gewichtung, Latenz oder Priorität, mit automatischen Wiederholungsversuchen und Fallback-Ketten, konfiguriert als virtuelle Modelle statt fest in Anwendungen programmiert (Dokumentation zu Lastverteilung und Fallbacks). Die Observability-Runde speist diese direkt: Diagramme zur Fehlerrate nach Fehlertyp und Aufschlüsselungen der Fehler pro Anbieter ermöglichen es einem Team, die Verschlechterung eines Anbieters früh genug zu erkennen, damit die Fallback-Kette greifen kann. Die dokumentierte Ansicht auf Request-Ebene zeigt für jeden einzelnen Aufruf, ob Routing oder Fallbacks angewendet wurden. Der Gesamteffekt ist das, was Unternehmen tatsächlich kaufen: Eine Anwendung behält ihren einzelnen Endpunkt und ihr OpenAI-kompatibles Schema bei, während das Gateway im Hintergrund das Routing anpasst. So kann ein Vorfall bei einem Anbieter – bei entsprechender Fallback-Kapazität und -Richtlinie – als Routing-Ereignis eingedämmt werden, anstatt automatisch zum Problem für das gesamte Produkt zu werden. Sportlich ausgedrückt: Das Halbfinale wird bei der Mannschaftsaufstellung gewonnen, noch vor dem Anpfiff – durch die Konfiguration, die im Voraus festlegt, was passiert, wenn die erste Wahl ausfällt.
Das Finale ist das neueste und operativ anspruchsvollste Spiel in diesem Framework: Agenten, die agieren – Tools aufrufen, auf Systeme zugreifen, Konsequenzen herbeiführen können – und das unter einer Governance, die einer Sicherheitsüberprüfung standhält. Die dokumentierte Architektur bestreitet dieses Finale mit einer spezifischen Struktur. Tools befinden sich in einer MCP-Registry, in der Server gehostet, veröffentlicht und zentral entdeckt werden (MCP-Registry-Dokumentation). Die Authentifizierung erfolgt zentral am MCP-Gateway mittels OAuth2, RBAC, nutzerspezifischer Delegation und Beschränkungen auf Tool-Ebene. So können Agenten auf registrierte MCP-Server und Tools zugreifen, ohne Anmeldedaten für nachgelagerte Dienste im Agenten-Code hinterlegen zu müssen (MCP-Authentifizierungs- & Sicherheitsdokumentation; MCP-Server im Agent Harness). Virtuelle MCP-Server kombinieren Tools von mehreren Servern zu einer einzigen, kontrollierten Oberfläche (Dokumentation zu virtuellen MCPs). Und die Ausführung selbst findet im Agent Harness statt – Orchestrierung, Sandbox-Ausführung, manuelle Freigabeschritte für sensible oder destruktive Tool-Aufrufe sowie Traces auf Schritt-Ebene mit Kosten pro Schritt (Agent-Harness-Dokumentation). Beachten Sie, was das Finale von allen vorangegangenen Runden erbt: Die Modellaufrufe des Agenten durchlaufen die Kontrollen der Runde der 32, seine Schritte erscheinen in den Traces der Runde der 16 und den MCP-Tool-Metriken, seine Ausgaben fließen in die Kostenstellenrechnung des Viertelfinals ein und sein Modell-Traffic nutzt das Routing des Halbfinals. Das ist die eigentliche These hinter der Analogie – das Finale ist kein separater Wettbewerb. Es ist dieselbe Steuerungsebene, erweitert auf Systeme, die aktiv handeln.
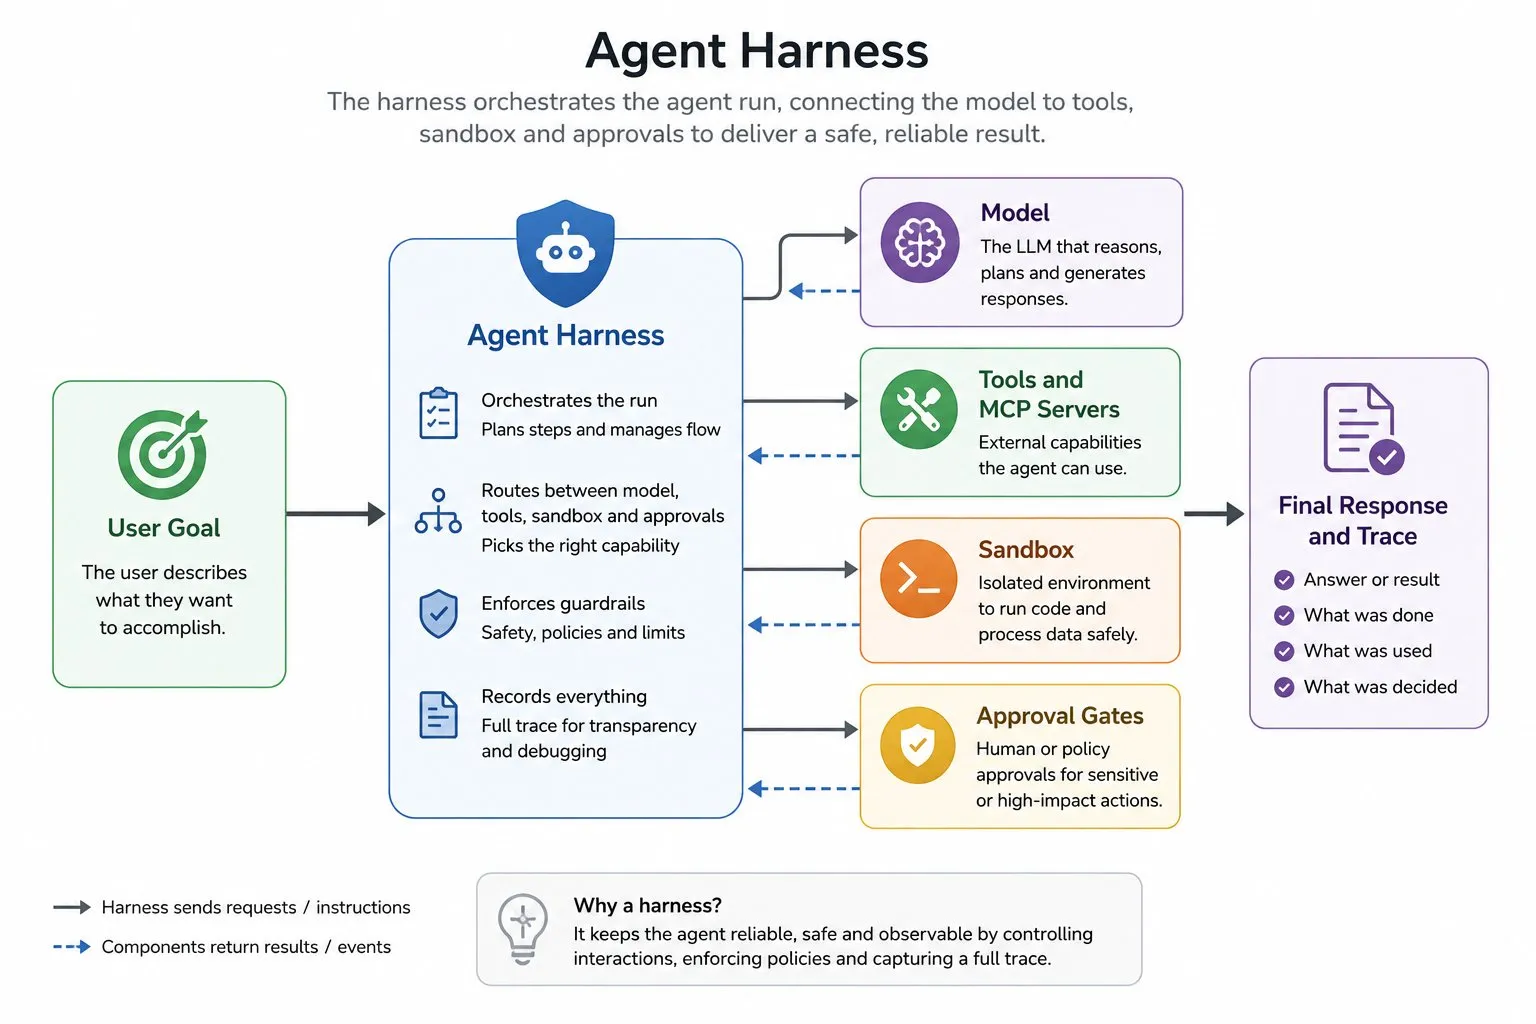
Eine Disziplin jenseits der fünf Runden dieses Beitrags verdient Erwähnung: Loop Engineering – das Design der Systeme, die Ihre Agenten Lauf für Lauf steuern. Es ist kein natives TrueFoundry-Feature, sondern eine Praxis, die Sie aufbauen, wobei der Agent Harness die vorausgesetzte Laufzeitumgebung bildet. Unser Beitrag Loop Engineering auf Enterprise-Niveau untermauert dies – hier trifft Handwerk auf Freigabeprozesse, Budgets, Traces und verwaltete Anmeldedaten – und sein Fortsetzung im Flottenmaßstab weitet dies auf viele Schleifen gleichzeitig aus. Wenn das Finale auf diesem Spielfeld gewonnen wird, ist Loop-Engineering das Trainingsprogramm der nächsten Saison.
Analogien sind Linsen, keine Beweise, daher verzerren sie an dieser Stelle. Erstens ist Produktion eine Saison, kein Finale: Es gibt keinen Schlusspfiff, nach dem eine KI-Plattform endgültig gewonnen hat, sondern nur Standards, die jeden Tag Bestand haben müssen – das Turnierraster beschreibt den Standard, nicht den Kalender. Zweitens ist K.-o.-Fußball ein Ausscheidungswettbewerb, während Enterprise-Engineering glücklicherweise keiner ist; eine gescheiterte Bereitschaftsprüfung kostet Zeit und Glaubwürdigkeit, nicht die Existenz. Drittens gewinnt keine Steuerungsebene das Turnier allein. Die wiederkehrende Erkenntnis der diesjährigen Enterprise-KI-Forschung – einschließlich der von BCG, über die dieser Blog berichtet hat – ist, dass der Großteil der Skalierungsarbeit aus Menschen, Prozessen und Strategie besteht – der Schwerpunkt von BCGs publizierter Arbeit zur KI-Skalierung, mit ihrer wiederkehrenden 10-20-70-Gewichtung, die Menschen und Prozesse über Algorithmen stellt; ein Gateway ist die Technologie- und Tooling-Seite dieser Gleichung, und die Zuordnung von Runden zu Fähigkeiten in diesem Beitrag ist die redaktionelle Einordnung von TrueFoundry, kein Industriestandard. Was wirklich übertragbar ist, ist die Kerneigenschaft des Rasters: In der K.-o.-Phase gleichen Stärken keine Lücken aus. Ein Team mit dem begabtesten Stürmer des Turniers fährt trotzdem nach Hause, wenn es einen Standard nicht verteidigen kann. Eine Plattform mit einem Spitzenmodell scheitert trotzdem an ihrer Bereitschaftsprüfung, wenn sie nicht sagen kann, wer was zu welchen Kosten mit welchen Tools aufgerufen hat. Ausscheidungsfragen werden nacheinander beantwortet, und jede muss beantwortet werden.
Am Abend des 19. Juli wird eine Mannschaft etwas mathematisch Brutales vollbracht haben: fünf aufeinanderfolgende K.-o.-Spiele überstanden, bei denen eine einzige Niederlage das Aus bedeutete – 32 Teams gingen in dieses Raster; eines beendet es mit der Trophäe. Am Montagmorgen spielt Ihre KI-Plattform ihre nächste K.-o.-Runde, denn im Unternehmen hört das Raster nie auf: eine neue Sicherheitsüberprüfung, ein neuer Budgetzyklus, eine neue Agenten-Workload, die Tool-Zugriff anfordert. Die Teams, die Raster überstehen, sind nicht die, die in jeder Runde improvisieren; es sind die, deren Rückgrat – Torwart, Abwehr, Mittelfeld – in allen Runden hält. Für Enterprise-KI ist dieses Rückgrat die Steuerungsebene: Kontrolle, Beobachtbarkeit, Attribution, Zuverlässigkeit und Agenten-Governance, eine Gateway-Ebene, deren Fähigkeiten oben dokumentiert sind. Die Gruppenphase hat Spaß gemacht. In den K.-o.-Runden zählt es.
Shanklys Weisheit, im Vergleich zu Ngs, ist das Schlussplädoyer: Modell-Bestenlisten sind Form – sie ändern sich vierteljährlich. Die verwaltete Ebene darunter – Identität, Budgets, Traces, kontrollierte Tools – ist Klasse: die Infrastruktur, die unabhängig davon wertvoll bleibt, welches Modell den nächsten Zyklus anführt.
Die Analogie zur Weltmeisterschaft und die Zuordnung der Runden zu den Fähigkeiten sind redaktionelle Gestaltungsmittel von TrueFoundry. Die Fähigkeiten von TrueFoundry sind Paraphrasen der zum Zeitpunkt der Erstellung verlinkten öffentlichen Dokumentation; ein einziges direktes Zitat von unter fünfzehn Wörtern stammt aus der Dokumentation des Metrics Dashboard; die beiden Produktbilder sind eigene Dokumentationsmaterialien von TrueFoundry und werden mit Quellenangabe wiedergegeben. FIFA World Cup™ und zugehörige Marken sind Warenzeichen der FIFA (Fédération Internationale de Football Association); die Fakten zum Turnier stammen aus den offiziellen Materialien der FIFA unter fifa.com. Dieser Beitrag ist ein unabhängiger Kommentar, steht in keiner Verbindung zur FIFA, wird von dieser weder gesponsert noch unterstützt, verwendet das Turnier lediglich als redaktionelle Analogie und nennt keine teilnehmenden Mannschaften, Spieler oder Spielergebnisse.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet