


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
プレフィックスキャッシュは同一のプロンプトを再利用します。セマンティックキャッシュは類似したプロンプトを再利用します。受信したリクエストをベクター埋め込み(Embedding)し、ほぼ同一の質問が最近回答されていた場合、モデルを呼び出す代わりに保存された回答を返します。これはゲートウェイが実行できる最も効果的なコスト削減およびレイテンシ短縮の施策の1つですが、「デモで動作する」ことと「本番環境で安全である」ことには大きな差があります。本記事では、その仕組み、動作を制御する単一の調整ノブ、静かに誤った回答を返してしまうケース、そしてキャッシュを配置すべき場所について解説します。
バックエンドエンジニアのKabirは、最高の1週間を過ごした直後に最悪の1週間を経験しました。最高の1週間:彼はNorthwindのサポートアシスタントの前にセマンティックキャッシュを導入しました。受信した質問をベクター埋め込みし、ほぼ同一の質問が最近回答されていた場合、モデルを呼び出す代わりに保存された回答を返却するようにしたのです。モデル呼び出しのボリュームは35%減少しました。キャッシュヒット時のレイテンシは約900ミリ秒から40ミリ秒未満に短縮されました。最悪の1週間:ある顧客が「配送状況はどうなっていますか?」と質問したところ、自信満々で詳細な回答が返ってきました。しかしそれは、別の人物の注文に関するものでした。2人の顧客が数分差でセマンティックに同一の質問をしており、キャッシュは両方をほぼ同じベクターとして埋め込み、ヒットと判定して、最初の顧客の回答を2人目の顧客に返してしまったのです。
キャッシュは設計どおり正確に機能していました。ただ、「配送状況はどうなっていますか?」という言葉が、誰が質問しているかによって異なる意味を持つということを理解していなかっただけです。セマンティックキャッシュはモデル呼び出しを類似度マッチングとトレードオフするものであり、その取引の安全性のすべては2つの要素にかかっています。マッチングを判定するしきい値と、最初にキャッシュへの格納を許可するデータの内容です。本記事ではその両方について説明します。
本記事で扱うすべての要素 — 完全一致およびセマンティックキャッシュ、ルートごとのノブとしての類似度しきい値設定、冒頭のKabirのバグを再発させないためのテナントごとのスコープ分離、そしてキャッシュが実際に成果を上げているかを示すヒット率/コスト削減のテレメトリ — は、TrueFoundryのAI Gatewayのキャッシュ機能によってゲートウェイ設定として実現できます。リクエストに単一のヘッダーを追加するだけで有効化されます。ゲートウェイはリクエストをハッシュ化(またはセマンティック検索用に最後のメッセージを埋め込み)し、Redisベースのストアと比較して、ヒット時にはキャッシュされたレスポンスを返します。ミス時にはリクエストがプロバイダーに送られ、新しいレスポンスとベクター埋め込みが次回の利用のためにキャッシュされます。
正当性の確保 — 異なるユーザーからのセマンティックに類似した2つのリクエストが決してお互いの回答を返さないようにすること — は、2段階のネームスペース分離によって組み込まれています。レベル1は自動です:すべてのキャッシュエントリは呼び出し元のユーザーまたはバーチャルアカウントにスコープ指定されるため、ユーザーAのリクエストがユーザーBのエントリにヒットすることは絶対にありません。レベル2は任意です:キャッシュ設定のnamespaceフィールドでさらに細分化できます(テナントごと、環境ごと、システムプロンプトのバージョンごと)。これにより、本記事で後述するネームスペースの設計が実践可能になります。これらが組み合わさることで、各サービスで分離ロジックを再実装することなく、ゲートウェイレベルのセマンティックキャッシュをサービス間で安全に共有できるようになります。
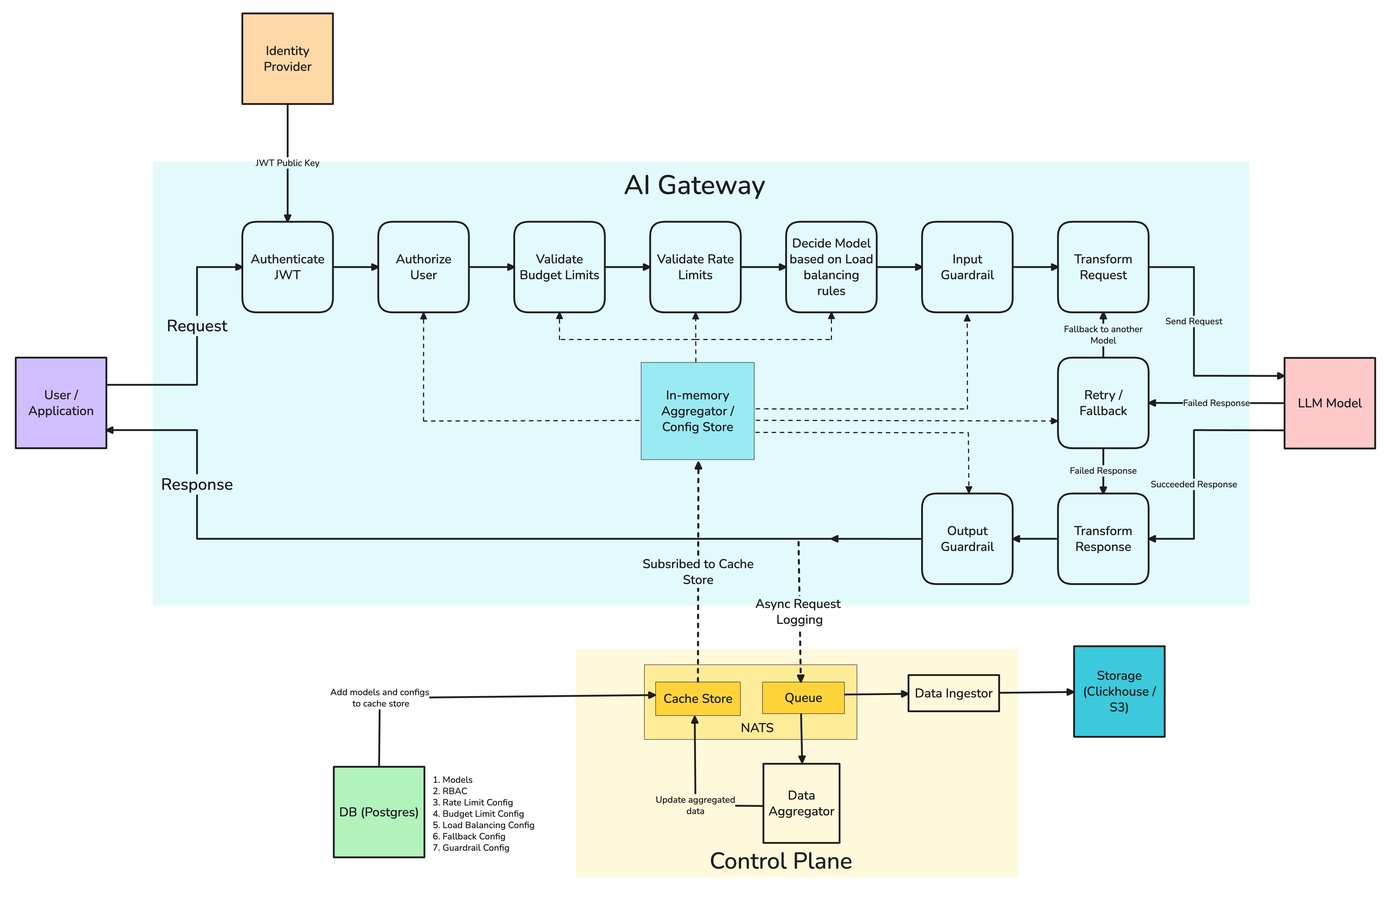
アプリケーションコードは変更不要です。キャッシュはリクエストごとに単一のヘッダーでオプトインできます。以下の例では、完全一致のスーパーセットであるsemanticを使用しており(同一テキストのヒットも処理します)、控えめな初期しきい値0.9とカスタムネームスペースを設定することで、自動のユーザーごとのスコープ分離に加えて、マルチテナントアプリが各テナントのキャッシュを隔離できるようにしています:
セマンティックキャッシュを有効にしてゲートウェイを呼び出す(Python、OpenAI互換)
「キャッシュ」には、適用範囲とリスクが大きく異なる3つのメカニズムが存在します。自分がどれを導入しようとしているのかを正確に把握することが重要です。
プロバイダーのプレフィックスキャッシュは、呼び出し間で変更されずに繰り返し使用されるシステムプロンプトやツール定義など、完全かつ同一のプロンプトプレフィックスを再利用します。プロバイダーは完全一致するプレフィックスを検出すると、繰り返される部分を大幅な割引価格で課金します。これは自動的かつ安全であり、当社のコンテキストエンジニアリングに関する記事でも解説しています。完全に一致するテキストのみを対象とするため、誤った回答を返すことはありません。
完全一致レスポンスキャッシュは、正規化されたリクエスト全体をハッシュ化し、同一のハッシュに対して保存されたレスポンスを返します。これも安全(同一の入力に対して同一の出力)ですが、ユーザーがまったく同じ表現を使用することはまれであるため、ヒット率は低くなります。
セマンティックキャッシュが本記事のテーマです。リクエストをベクター埋め込みし、類似した過去のリクエストが存在する場合にキャッシュされたレスポンスを返します。これにより、「荷物はどこにありますか?」と「注文商品は発送されましたか?」でキャッシュされた回答を共有できるようになるため、ヒット率は飛躍的に向上します。しかし、「類似している」という判断は完全一致ではなく類似度しきい値によって行われるため、リスクが発生するのもこのレイヤーです。
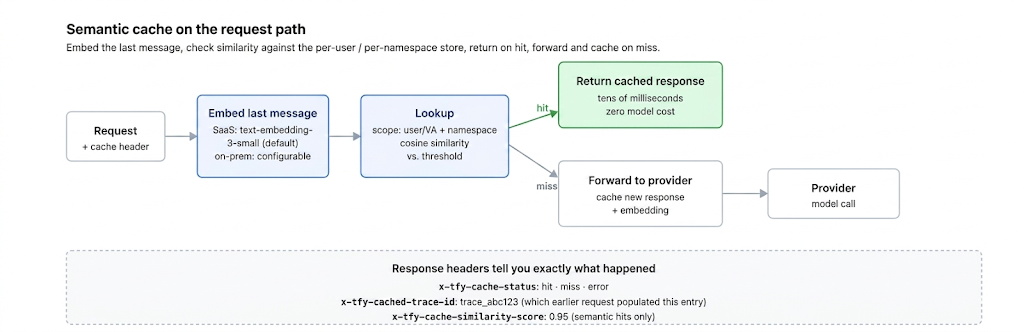
メカニズムは3つのステップで構成されます。まず、受信したリクエストをベクター空間に埋め込みます。次に、適切なスコープ内で最も近い過去のリクエストをベクターストアから検索します。最も近い近傍の類似度がしきい値を超えている場合は、保存されているレスポンスを返します。超えていない場合はモデルを呼び出し、次回の利用のために新しいリクエストとレスポンスのペアを保存します。
セマンティックキャッシュ検索 — 埋め込み、スコープ内検索、確実なヒット時のレスポンス返却
ヒットした場合、通常数百ミリ秒とトークンごとの課金がかかるモデル呼び出しを、数十ミリ秒とわずかなコストで済むベクター埋め込み呼び出しとベクター検索に置き換えることができます。ミスした場合、通常のモデル呼び出しに対して埋め込みと検索のレイテンシが上乗せされます。これが、ヒットの可能性を得るために支払うわずかなコストです。そのトレードオフの経済性はヒット率に完全に依存し(セクション7)、安全性はしきい値に完全に依存します(次節)。
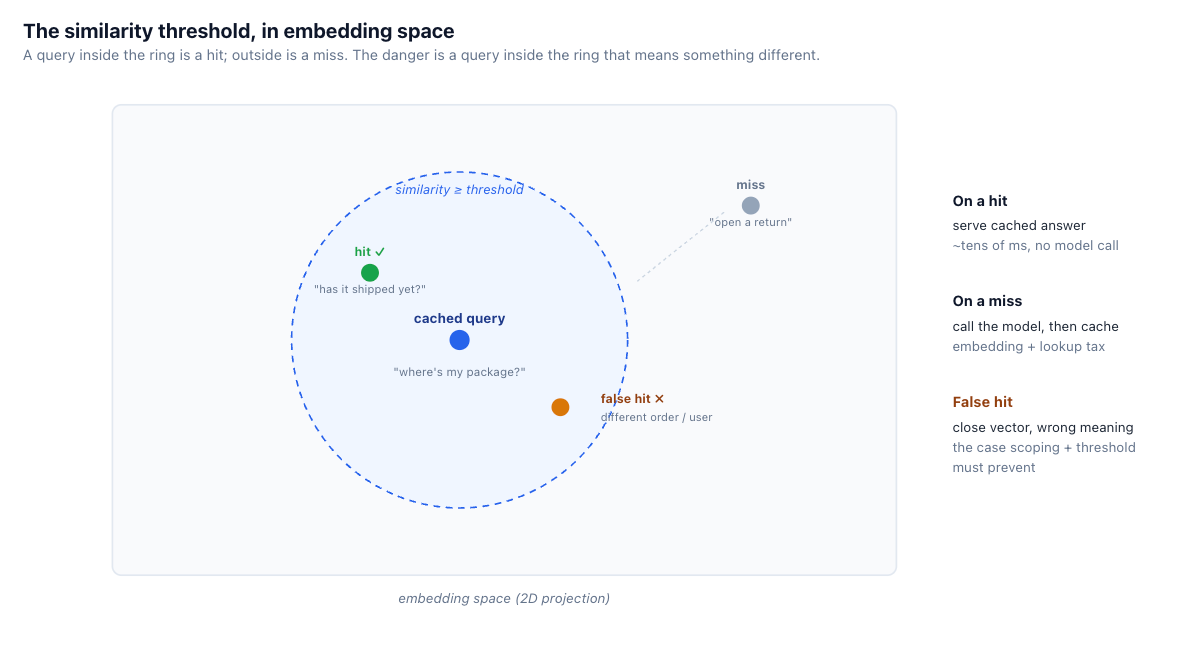
しきい値は、新しいリクエストがキャッシュヒットとみなされるために、キャッシュされたリクエストにどれだけ近づく必要があるかを決定するものであり、適合率(Precision)と再現率(Recall)の直接的なトレードオフとなります。しきい値を低く設定しすぎて曖昧なマッチングを許容すると、ヒット率は高くなりますが、聞かれていない質問に対する回答を返してしまうリスクが高まります(偽陽性ヒット)。高すぎる設定にしてほぼ同一の表現を要求すると、キャッシュは安全になりますがめったに実行されず、余計なステップを踏む完全一致キャッシュへと退化してしまいます。
万人に適した絶対的な数値は存在しません。使用するEmbeddingモデル、ドメイン、および誤答によって生じるコストによって異なるためです。適切な設定方法は経験的なアプローチです。回答を共有すべきリクエストとすべきでないリクエストのラベル付きペアを作成し、しきい値をスイープして、対象のルートにおける偽陽性ヒット率が許容範囲内に収まるポイントを選択します。重要なルート(金銭、健康、個人情報に関わるもの)では保守的なしきい値を設定するか、セマンティックキャッシュを完全に無効化すべきです。リスクの低い情報ルート(ドキュメントのQ&A、一般的な説明など)は、より緩やかな設定で運用できます。グローバルに単一の数値を適用するのではなく、ルートごとにしきい値を設定するのが本番環境のパターンです。そして、すべてのルートに位置するTrueFoundryのAI Gatewayのようなゲートウェイは、各サービスにポリシーを分散させることなく、ルートごとに設定を行って偽陽性率を監視するのに最適な場所です。
核心となる危険性はシンプルに表現できますが、過小評価されがちです。「ベクター埋め込みが近い」ことは「意味が同じ」であることを意味しません。ベクター埋め込みは論理的な同等性ではなく、トピック上の類似性を捉えます。「フランスの首都は何ですか?」と「ドイツの首都は何ですか?」は、ベクター空間において極めて近い場所に位置します。同じ構造、同じドメインで、単語が1つ違うだけだからです。しかし、必要な回答は異なります。再現率(Recall)を重視して調整されたしきい値は、これらを同じ質問として処理してしまいます。
緩和策を組み合わせる必要がありますが、単独で完全なものはありません。控えめなしきい値設定により、曖昧なマッチングを減らすことができます。エンティティおよびキーワードガードを追加すると、ヒットを返却する前に重要なエンティティ(国名、注文番号、製品名など)の一致を検証できるため、純粋なコサイン類似度では見逃してしまう「フランス/ドイツ」のようなケースを検知できます。ネームスペースごとのキャッシュにより、異なるコンテキスト間での衝突を防ぐことができます。そして最も確実な緩和策はアップストリーム(上流)にあります。それは、わずかなズレが危険をもたらすような種類のリクエストを最初からキャッシュしないことです(次節で説明)。セマンティックキャッシュは、既知の失敗モードに対応するよう設計して運用すべきツールであり、どこにでも適用できる透過的な高速化手段と考えてはいけません。
一部のレスポンスは、しきい値の精度がどれほど優れていても、類似度マッチングから返却するのは危険です。2つのリクエストの違いが、ベクター埋め込みが参照するテキストデータ内に存在しないためです。
セマンティックキャッシュエントリは、テキスト単体でキー設定されるわけではありません。ネームスペース内の埋め込みによってキー設定され、そのネームスペースにおいて正確性が強制されます。ネームスペースには、テキスト上は類似している2つのリクエストを本質的に区別するすべての要素を符号化する必要があります。具体的には、テナントまたはユーザー(ユーザー固有のあらゆる処理用)、モデル、システムプロンプトのバージョン、アクティブなツールセットなどです。システムプロンプトのバージョンが異なる2つの同一な質問は、回答を形成する指示が変更されているため、異なる質問として扱われます。
キャッシュエントリのネームスペース設定(図解)
無効化には2つのトリガーがあります。1つは時間であり、基本的な事実が変化する速度に合わせて選択されたTTLを介して行われます。変動しやすいものには短く、安定した参照用の回答には長く設定します。もう1つはバージョンであり、ネームスペースを介して行われます。システムプロンプトのバージョンを上げたりツールセットを変更したりすると、キャッシュが前に進められるため、古い構成からの古い回答が提供されることはなくなります。プロンプト変更時の無効化の失敗は、よくある分かりにくいバグです。プロンプトを改善したにもかかわらず、TTLが切れるまでキャッシュされた回答が古いプロンプトを反映し続けてしまいます。
TrueFoundryのキャッシュ機能では、これらすべてがx-tfy-cache-configヘッダー(または同じフィールドを設定する集中管理されたポリシー)となります。スキーマはシンプルで、制御方法は本セクションで説明した内容と一致しています。
マルチテナントアシスタントのルートごとのキャッシュ設定 — 3つのパターン、同一のスキーマ
ドキュメントの閾値ガイドラインは本記事の内容と一致しています。誤検出の代償が大きい厳格なユースケースでは0.95〜1.0、バランスの取れた会話型アシスタントでは0.85〜0.95、探索的または低リスクなルートでは0.85未満とします。0.9から開始し、観測された誤検出率に基づいて調整することが推奨されています。レスポンスヘッダーx-tfy-cache-similarity-scoreによってそれが測定可能になります。すべてのヒットでクリアしたスコアが通知されるため、ラベル付けされたペアの確認はカスタム評価ハーネスではなく、少数のクエリで済むようになります。
知っておくべき実装上の詳細が2つあります。埋め込みモデルは、SaaSではデフォルトでOpenAIのtext-embedding-3-smallとなっており、そのモードでは構成できません。セルフホスト環境のデプロイメントでは、Controls → Settings → Semantic Cacheから選択可能で、選択されたモデルはゲートウェイ全体のすべてのセマンティックキャッシュ操作に適用されます。
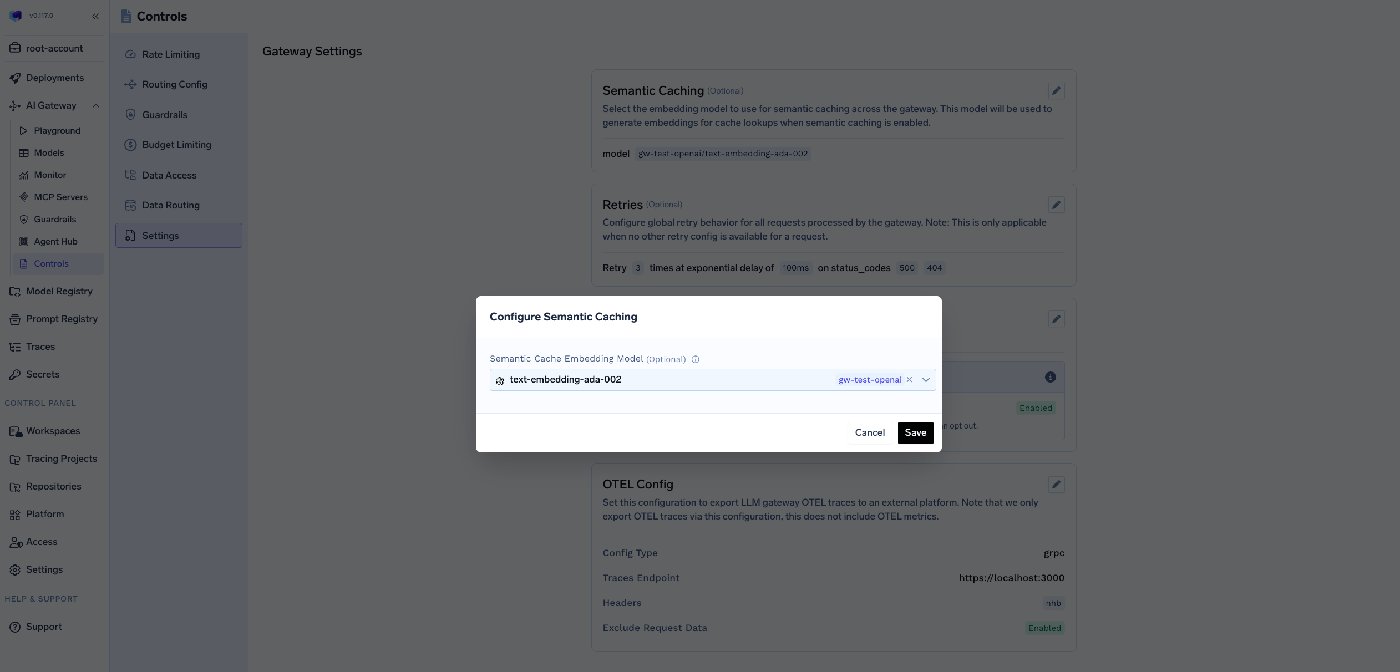
セルフホストでのストレージはRedisです。tfy-llm-gateway HelmチャートにバンドルされているRedisか、環境変数を経由した独自のRedis(またはValkeyのようなRedis互換モデル)のいずれかになります。埋め込み+検索が、回避しようとしているモデル呼び出しよりも真に高速かつ低コストである場合にのみキャッシュが価値を発揮するため、どちらの選択も重要です。
本記事におけるネームスペースに関する議論のもう一方の側面は、ゲートウェイが自動化する部分、つまりレベル1の隔離です。すべてのエントリは、それを作成したユーザーまたは仮想アカウントに暗黙的にスコープ設定されるため、namespaceの設定を忘れた場合でも、ユーザーAのリクエストがユーザーBのキャッシュされた回答を返すことはありません。カスタムのnamespaceは、本記事で説明したケース(1つの仮想アカウントを共有するマルチテナントアプリ、システムプロンプトのバージョン、環境)に対する追加のパーティションであり、2者の呼び出し元の回答を隔てる唯一の防壁というわけではありません。このレイヤリングにより、「サービス間で1つのキャッシュを共有する」ことが、危険な罠ではなく防御可能なデフォルト設定となります。
セマンティックキャッシュの価値は、ヒット率という1つの数値によって左右されます。説明用のモデルとして、あるルートが呼び出しごとの一定のモデルコストで実行され、キャッシュが安全な閾値で30%のヒット率を達成していると仮定します。リクエストの約30%でモデル呼び出しがスキップされるため、そのルートのコストは30%近く削減されます(生成と比較してわずかである埋め込みおよび検索コストを差し引いた額)。レイテンシはその30%のリクエストで正確に改善され、数百ミリ秒の生成から数十ミリ秒の検索へと短縮されるため、平均レイテンシとテールレイテンシの両方が引き下げられます。
この計算における2つの誠実な注意点。ヒット率はワークロードに依存します。絞り込まれたFAQスタイルのアシスタントでは30%を大幅に超える可能性がありますが、ロングテールのクリエイティブなワークロードではほとんど効果がない可能性があります。したがって、信頼できる唯一の数値は独自のトラフィックで測定した数値のみです。また、削減額はすべてのキャッシュミスにかかる埋め込みのコストを差し引いた純額です。ヒット率が非常に低い場合、節約できる額よりも埋め込みに費やす額の方が大きくなる可能性があります。公表されている数値を鵜呑みにするのではなく、導入前にキャッシュ可能な割合を測定してください。TrueFoundryのAI Gatewayの背面でキャッシュを実行することで、そもそもそれが測定可能になります。ヒット率と回避された支出はコスト帰属機能による呼び出しごとのコストの横に表示されるため、削減額は予測値ではなく観測値となります。
セマンティックキャッシュはアプリケーション内に存在することもできますが、ルーティングと信頼性に適用されるのと同じ理由から、ゲートウェイがより強力なデフォルトとなります。ゲートウェイはすでにすべてのリクエスト上に位置しているため、各サービスで再実装するのではなくサービス間でキャッシュが共有されます。また、キャッシュが実際に成果を上げているかを測定するために必要な、呼び出しごとのコストとレイテンシのテレメトリをすでに保持しています。
TrueFoundryのAI Gatewayでキャッシュを実行することは、テナントごとのスコープ設定を適用する場所(コールドオープンを防止)、ヒット率、削減コスト、削減レイテンシを確認する場所、そしてコスト帰属に関する記事で紹介した、チームおよびルートごとのキャッシュあり/なしの分割を示す同じコスト帰属ビューを一箇所に集約することを意味します。本シリーズ全体で繰り返し登場する役割分担は次のとおりです。ゲートウェイは共有され、スコープ設定され、観察可能なキャッシュを提供します。アプリケーションは、「私の配送先はどこか?」がパーソナライズされており、「返品期間はいくつか?」はそうではないことを認識している唯一の存在であるため、どのルートがキャッシュしても安全でどの閾値にするかというポリシー決定を所有します。
コンテキストエンジニアリングの記事にあるプロンプトキャッシュとはどのように異なりますか?
その記事では、プロバイダーのプレフィックスキャッシュを扱いました。これは、同一のシステムプロンプトプレフィックスを再利用して請求割引を受けるもので、正確なテキストに一致するため誤答を返すことはありません。セマンティックキャッシュは、リクエストを埋め込むことで類似したリクエストを再利用します。これにより、高いヒット率が得られる一方で誤検出のリスクも発生します。これらは組み合わせることができます。すべての呼び出しで静的なプレフィックスをキャッシュし、安全なルートでのみ応答全体をセマンティックにキャッシュします。
類似度の閾値はどのように選べばよいですか?
ルートごとに実証的に設定します。回答を共有すべきリクエストと共有すべきでないリクエストのラベル付きペアセットを作成し、閾値をスイープして、そのルートでの誤答のコストを考慮した許容可能な率まで誤検出が低下するポイントを選択します。ハイリスクなルートには保守的な閾値を設定するかセマンティックキャッシュを行いません。リスクの低い情報提供用ルートは緩めに運用できます。単一のグローバル閾値は、ほぼ確実に一部のルートで不適切となります。
パーソナライズされたものを安全にキャッシュすることはできますか?
キャッシュネームスペースに明示的なユーザーごと(またはテナントごと)のスコープがある場合のみ可能であり、検索によって別のユーザーの応答が返されることはありません。ただし、その場合でも時間に対する感度に注意してください。パーソナライズされたもの、時間的感度の高いもの、ステートフルなもの、またはハイリスクな応答に対する安全なデフォルトは、セマンティックキャッシュを行わないことです。コールドオープンは、パーソナライズされた回答がユーザーのスコープなしでキャッシュされたときに発生します。
システムプロンプトを変更するとキャッシュはどうなりますか?
無効化を行う必要があります。そうしないと、TTLが切れるまで古いプロンプトによって形成された回答が提供され続けます。スマートな方法は、キャッシュネームスペースにシステムプロンプトのバージョンを含めることです。これにより、プロンプトの変更によってキャッシュが自動的に繰り越され、古いエントリがマッチすることは二度となくなります。
ゲートウェイとアプリケーションのどちらに配置すべきですか?
メカニクス(共有キャッシュ、テナントごとのスコープ設定、機能しているかを示すヒット率/コスト/レイテンシの可視性)にはゲートウェイを使用します。ポリシー(どのルートがキャッシュ可能でどの閾値にするか)にはアプリケーションを使用します。その判断にはゲートウェイが持たないドメイン知識が必要となるためです。
Kabirのキャッシュは悪いアイデアだったわけではなく、スコープが設定されていなかっただけです。セマンティックキャッシュは、類似した質問が真に回答を共有しているルートにおいて、確実なコストとレイテンシのメリットをもたらします。そして、それを安全にする規律とは、どの質問がそれに該当するかをルートごとに把握することです。
TrueFoundryのAI Gatewayは、アプリケーションと1,600以上のモデル(OpenAI、Anthropic、Google、AWS Bedrock、Azure OpenAI、および独自のセルフホストモデル)の間に位置する、単一のOpenAI互換APIの背後にあるエンタープライズグレードのコントロールプレーンです。本記事のキャッシュ戦略を、サービスごとのコードではなく構成へと変更します。単一のx-tfy-cache-configヘッダーによる完全一致およびセマンティックキャッシュ、ルートごとの類似度閾値とTTL、自動のユーザーごと / 仮想アカウントごとの隔離、マルチテナントアプリやプロンプトバージョンのためのオプションのネームスペース分割、そしてSaaSとセルフホストで同様に機能するRedisバックのストレージ(オンプレミスでは埋め込みモデルを構成可能)を提供します。
ゲートウェイはすでにすべてのリクエスト上に位置し、すべての呼び出しに対して完全なトレースを出力するため、キャッシュは他のすべての要素と同じビューで測定可能になります。x-tfy-cache-status、キャッシュされたトレースID、および実際の類似度スコアが各レスポンスに付与され、削減コストおよび削減レイテンシのダッシュボードに集計されます。同じゲートウェイがRBAC、仮想アカウント、バジェットとレート制限、フォールバックとリトライ、ガードレール、および可視性ダッシュボードを追加します。SaaS、お客様のVPC内、オンプレミス、またはSOC 2、HIPAA、ITARコンプライアンスを備えたエアギャップ環境としてデプロイ可能であり、GartnerのAI Gateway向けMarket Guideで高く評価されています。詳細については、キャッシュに関するドキュメントまたはAI Gatewayの概要をご覧ください。
NorthwindとKabirは例示用です。埋め込みベースのキャッシングの仕組み、類似度閾値の適合率/再現率の動作、および「埋め込みが近いことは意味が等しいことを意味しない」失敗モードは、この手法の一般的な特性です。特定の数値(35%の呼び出し削減、ヒット時の900 msから40 msへのレイテンシ短縮、30%のヒット率の例、10〜30 msの埋め込みコスト)はトレードオフを説明するための代表的な桁数の仮定であり、測定値ではありません。本番環境でセマンティックキャッシングを有効にする前に、自身のキャッシュ可能な割合と誤検出率を測定してください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























