



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
大規模言語モデル (LLM) は強力な機能を提供しますが、同時に高額なインフラコスト、予測不能な利用パターン、悪用のリスクももたらします。企業が LLM を顧客向けツール、社内コパイロット、API プラットフォームに統合するにつれて、制御可能で信頼性の高いアクセスが極めて重要になります。ここでレート制限が重要な役割を果たします。
LLM 推論の文脈では、従来の秒あたりリクエスト数 (RPS) によるレート制限だけでは不十分です。LLM はリソースを極めて多く消費し、トークンベースであり、計算負荷が大幅に変動します。70B パラメータモデルに対する1つのプロンプトが数千トークンを消費し、GPU のレイテンシに大きな影響を与えることがあります。適切な制御がなければ、共有インフラストラクチャは急速に不安定化したりコストが過大になったりする可能性があります。
この記事では、AI Gateway でレート制限がどのように機能するのか、なぜそれがスケーラブルな AI インフラに不可欠なのか、そして TrueFoundry がマルチテナントデプロイメント全体で公平な利用、コスト効率、プロダクションレベルのパフォーマンスを確保するためにデフォルトでどのようにレート制限を有効にしているかを説明します。
レート制限とは、特定の時間ウィンドウ内にクライアントがシステムに送信できるリクエスト数を制御するために使用されるメカニズムであり、LLM トラフィックを管理する現代の AI gateway の中核機能です。特にマルチユーザー環境において、公平性を確保し、過負荷を防ぎ、可用性を維持します。従来の API では、ユーザーあたり毎分100リクエストといった単純な制限を適用することが多く、これは標準的な REST サービスでよく機能します。
しかし、LLM の機能は大きく異なります。入力サイズ、モデルタイプ、期待される出力に基づいて、各リクエストはインフラストラクチャに対して劇的に異なる負荷をかけます。たとえば、7B モデルへの20トークンのプロンプトは迅速に完了するかもしれませんが、65B モデルへの2000トークンのリクエストは GPU を数秒間占有する可能性があります。異なるモデルに対する2つの同一リクエストであっても、計算コストに5倍以上の開きが生じることがあります。
このため、リクエストベースの制限では不十分になります。現代の LLM ゲートウェイは、サーブするすべての LLM ツール に対してトークン対応のレート制限を採用し、処理された実際のトークン数とコールごとの計算負荷を考慮しなければなりません。
トークン対応レート制限で考慮される主な要因:
固定のリクエスト制限と比較したトークン対応制限の特長:
生成 AI ワークフローでは、レート制限はさらに重要になります。単一のユーザーが、長文プロンプト、ドキュメントの取り込み、またはマルチステップエージェントを介して、大規模なバックエンド処理を引き起こす可能性があります。制御がなければ、GPU の混雑、高いレイテンシ、または予想外のコストにつながる恐れがあります。
実際の利用は、フロントエンドアプリ、テストループ、または自動化によって推進されるため、予測不能であることがよくあります。レート制限は、インフラストラクチャがユーザーやテナント間で共有されている場合でも、これらのインタラクションが安定し効率的であることを保証します。
プロダクションレベルのデプロイメントにおいて、最高の LLM gateway は、拡張性、信頼性、コスト管理のための基本要件としてインテリジェントなレート制限を提供する必要があります。
Gateway 評価のための主な指標
| 基準 | 何を評価すべきか? | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | 最初のトークンまでの時間 (TTFT) に 10ms 未満の p95 オーバーヘッドを抑えられているか? | 必須 (Must Have) | ✅ サポート済み |
| データ居住性 | ログをお使いの地域 (EU/米国) 内に維持できるか? | ユースケースによる | ✅ サポート済み |
| レイテンシベースのルーティング | リアルタイムのレイテンシ/障害に基づいて自動的に再ルーティングされるか? | 必須 (Must Have) | ✅ サポート済み |
| キーのローテーションと破棄 | ダウンタイムなしでキーをローテーションまたは破棄できるか? | 必須 (Must Have) | ✅ サポート済み |
| キーのローテーションと破棄 | ダウンタイムなしでキーをローテーションまたは破棄できるか? | 必須 (Must Have) | ✅ サポート済み |
| キーのローテーションと破棄 | ダウンタイムなしでキーをローテーションまたは破棄できるか? | 必須 (Must Have) | ✅ サポート済み |
| キーのローテーションと破棄 | ダウンタイムなしでキーをローテーションまたは破棄できるか? | 必須 (Must Have) | ✅ サポート済み |
| キーのローテーションと破棄 | ダウンタイムなしでキーをローテーションまたは破棄できるか? | 必須 (Must Have) | ✅ サポート済み |

レート制限は、単なるバックエンドの保護策ではありません。LLM を提供するプラットフォーム (特にパブリック API やマルチテナント API を提供するプラットフォーム) にとって、安定性、ガバナンス、ビジネス目標とのアライメントのための戦略的レイヤーとして機能します。OpenAI、Anthropic、または TrueFoundry で構築されたプラットフォームであっても、レート制限はいくつかの重要な目的に寄与します。
悪用からインフラストラクチャを保護する
生成 AI 推論はリソースを劇的に消費します。長いプロンプトや同時リクエストが急激にバーストすると、GPU キューが圧迫され、レイテンシが増大し、サービスがダウンすることさえあります。レート制限により、トラフィックが制御され優先順位付けされた方法で処理され、リソースの枯渇を防ぎます。
ユーザーまたはテナント間での公平性を徹底する
マルチユーザーシステムにおいて、特定のクライアントの利用が他のクライアントのパフォーマンスを低下させてはなりません。レート制限は、ユーザー、チーム、または API キー間の分離を徹底するのに役立ちます。これにより、同時にアクティブなユーザー数に関係なく、一貫したサービスレベルが保証されます。
利用状況を料金プランに合わせる
多くの生成 AI プラットフォームは、トークンや利用ティアに基づいて収益化しています。レート制限は、それらの境界を適用するのに役立ちます。例:
コストの急増や超過を防ぐ
LLM の利用は静かに、かつ急速に拡大することがあります。適切な制限がない場合、トークン消費と GPU 利用率が肥大化する可能性があります。レート制限は、プラットフォームが予期せぬインフラコストを防ぎ、予算制御を維持するのに役立ちます。
信頼性とユーザーエクスペリエンスを向上させる
利用が制御されていれば、システムキューは安定した状態を保ちます。これにより、レイテンシの短縮、成功率の向上、より一貫したユーザーエクスペリエンスにつながり、SLA を伴う本番環境では特に重要となります。
LLM ベースのシステムでは、すべてのリクエストが同じ影響を与えるわけではありません。小さなモデルへの短いプロンプトは最小限のリソースしか使用しないかもしれませんが、大きなモデルへの長いクエリは相当な GPU 時間を消費する可能性があります。この変動性のため、最新のプラットフォームはリクエスト数だけに依存するのではなく、複数の次元にわたってレート制限を適用します。
効果的なレート制限に使用される最も一般的な次元は以下の通りです。
これらの次元を使用することで、プラットフォームチームは、インフラストラクチャの制約、ユーザーのニーズ、およびサービスレベルの期待に沿ってリソース利用を柔軟調整できるようになります。
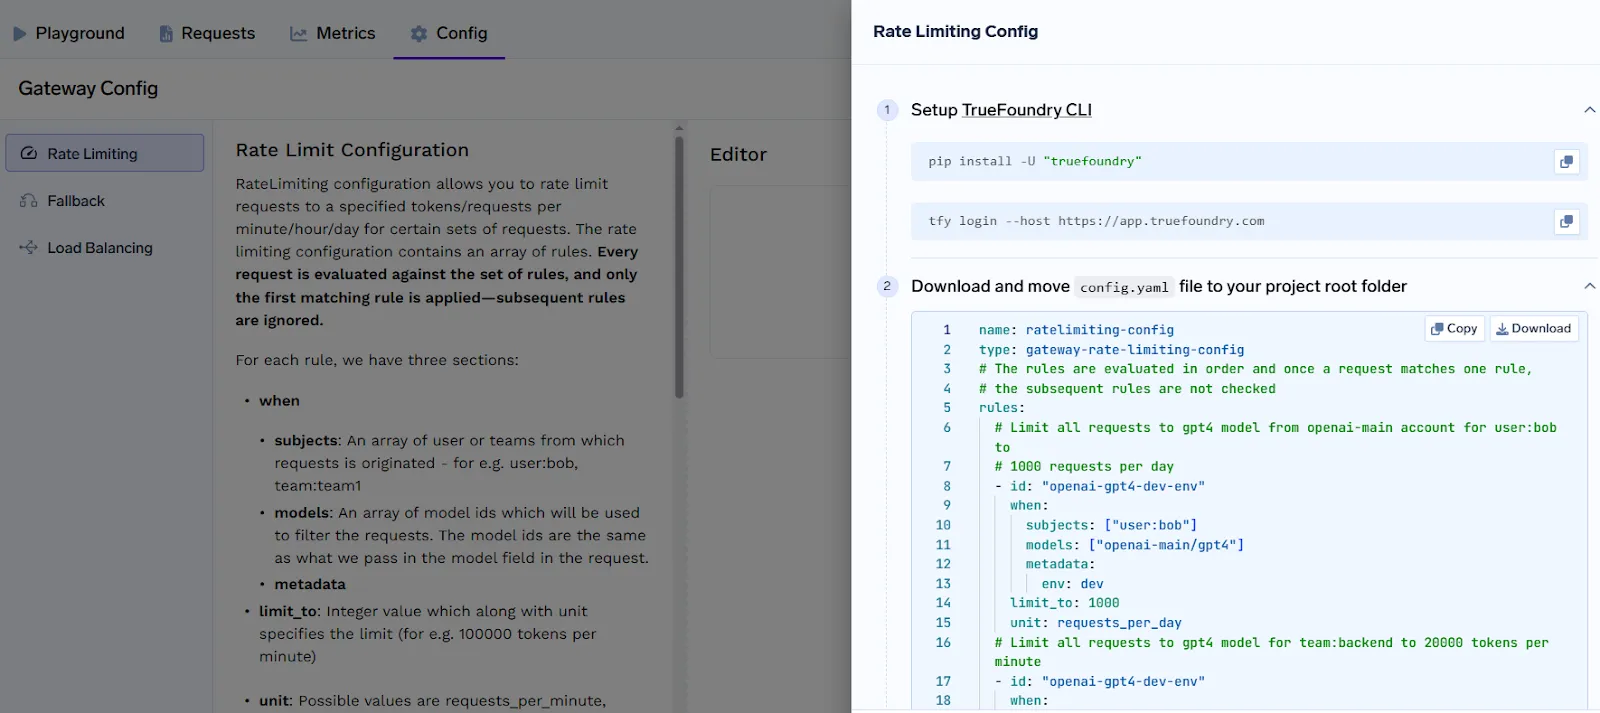
TrueFoundry は、プラットフォームチームがリクエストまたはトークン使用量に基づいて LLM エンドポイントへのアクセスを制御できるようにする、堅牢で柔軟なレート制限システムを提供します。これにより、計算リソースの公平な割り当てが確保され、悪用が防止され、組織のポリシーや課金プランと利用状況が整合されます。
TrueFoundry のレート制限メカニズムの中核にあるのは、ルールベースの設定システムです。これにより、チームはユーザー、チーム、仮想アカウント、モデル、およびリクエストメタデータにわたって正確なポリシーを定義できます。
ルールベースの設定
TrueFoundry におけるレート制限はルールのリストを通じて定義され、各ルールは以下を指定します。
ルールは順番に評価されるため、正しくマッチングされるように、より具体的なルールをより広範なルールの上に配置する必要があります。
サポートされている制限タイプ
TrueFoundry は、さまざまな時間間隔でリクエストベースとトークンベースの両方の制限をサポートしています。
これにより、実際の計算使用量を反映したポリシーの強制適用が可能になります。これは、異なるサイズのモデルに変動する長さのプロンプトをサーブする場合に特に重要です。
一般的なユースケース
設定システムの柔軟性により、幅広いユースケースがサポートされます。
設定例
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  - id: "specific-rule"
    when:
      subjects: ["user:bob@email.com"]
      models: ["openai-main/gpt4"]
    limit_to: 1000
    unit: requests_per_day
この例では、特定のユーザーによる GPT-4 の使用を 1 日あたり 1,000 リクエストに制限しています。TrueFoundry のレート制限システムは、強力でありながら管理しやすいように設計されています。トークン対応の制御、粒度の細かいターゲット設定、および明確な YAML ベースのポリシーにより、チームはインフラストラクチャとコストの制御を維持しながら、自信を持って LLM の利用を拡張できます。
設定を適用する方法
1. TrueFoundry CLI をインストールします:
pip install -U "truefoundry"
tfy login --host https://app.truefoundry.com
2. config.yaml をプロジェクトディレクトリに配置します。
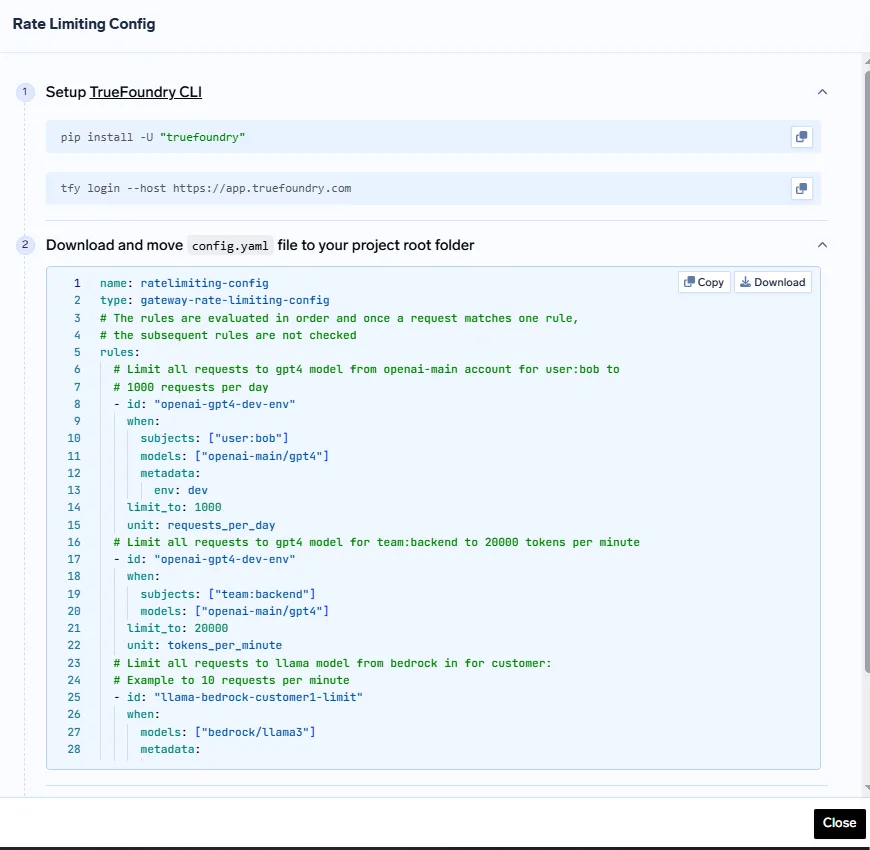
3. 以下を使用して設定を適用します:
tfy apply -f config.yaml
この宣言的アプローチにより、レート制限がバージョン管理され、再現可能であり、GitOps のベストプラクティスと整合していることが保証されます。
レート制限に関するリアルタイムフィードバック
TrueFoundry のレート制限システムは、制限が違反されたか上限に近づいたときに、クライアントに対して即座かつ透明性の高いフィードバックを提供するように設計されています。これにより、デベロッパーは使用制限の境界を理解し、アプリケーション内でスロットリングを適切に処理できます。
リクエストが定義されたレート制限を超えた場合:
このフィードバックメカニズムにより、クライアントの動作が向上し、自動再試行ロジックが可能になり、推測に頼ることなく使用量をクォータ境界内に収めることができます。
ダッシュボードとアラート
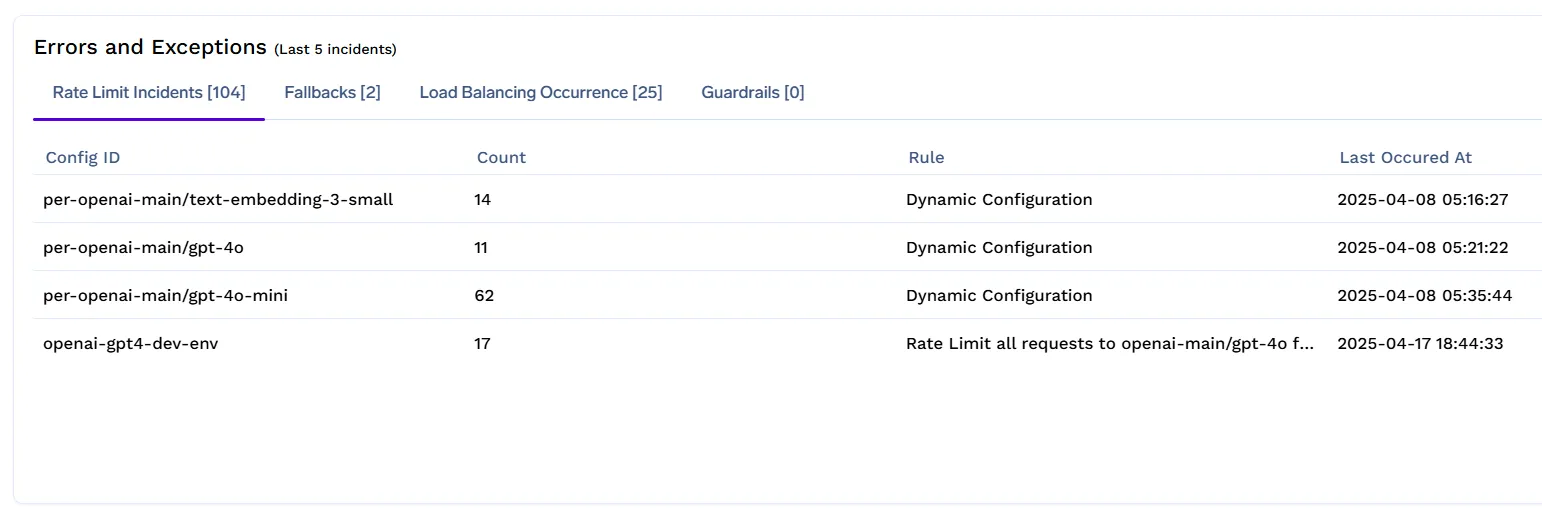
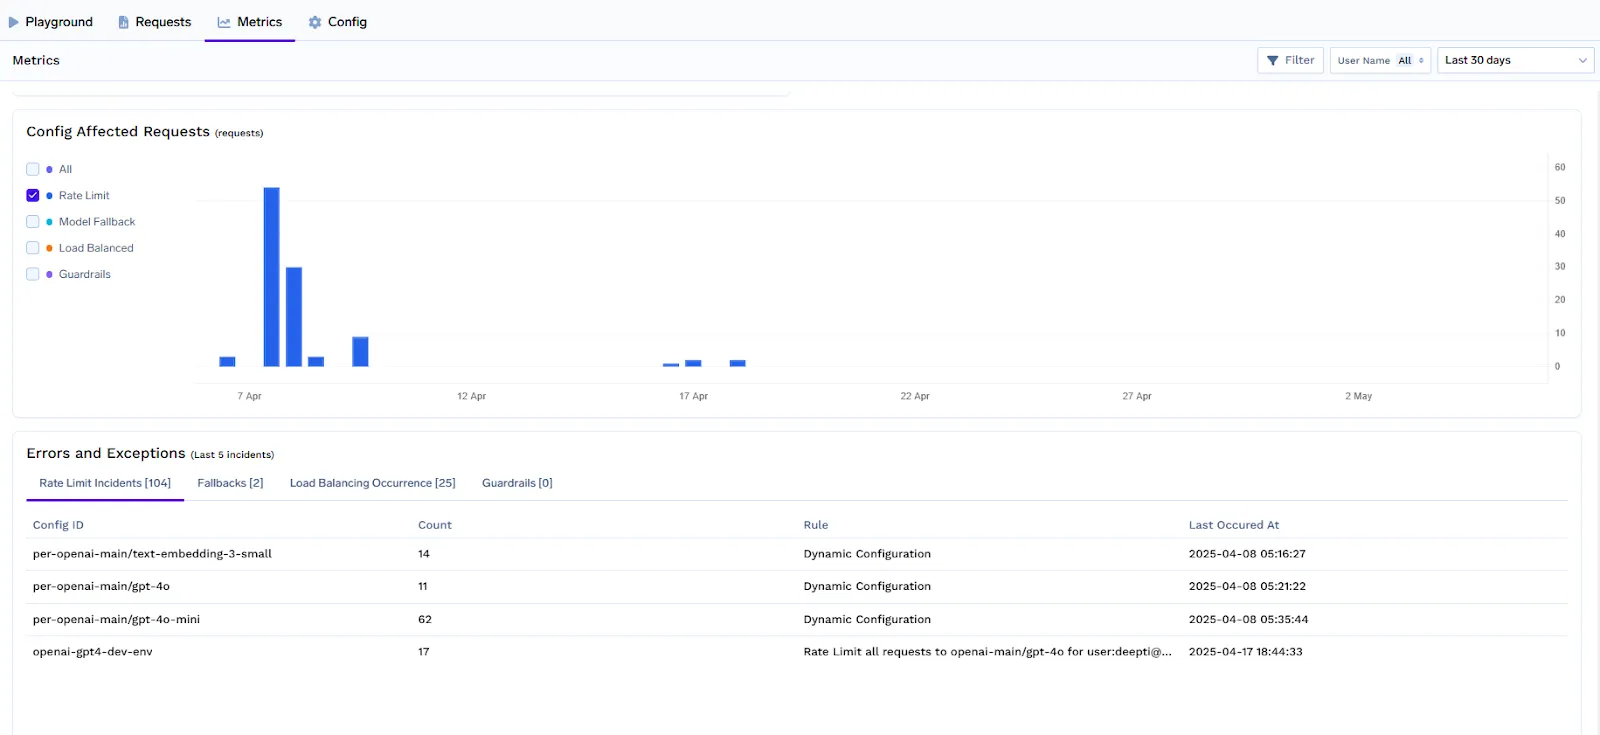
TrueFoundry は組み込みの可観測性を提供し、プラットフォームチームがレート制限ポリシーをリアルタイムで監視および最適化できるようにします。
LLM Gateway ダッシュボードを使用すると、以下を追跡できます:
これらのインサイトにより、悪用を検知し、事前に対策して制限を調整し、価値の高いユーザーが一貫したサービスを受けられるように調整できます。
レート制限、内部エラー、一時的な障害などによって LLM API が失敗した場合でも、フォールバックメカニズムによりアプリケーションはスムーズに動作し続けます。TrueFoundry は、エンドユーザーにエラーを返す代わりに、リクエストをバックアップモデルまたはプロバイダーに自動的にルーティングし、最小限の影響で可用性を維持できます。
フォールバックルールは、モデル ID、リクエストを行っているユーザーまたはチーム、429 や 500 などのレスポンスコードといった特定条件に基づいてトリガーされます。リクエストがこれらの条件を満たすと、フォールバック設定で指定された 1 つ以上の代替モデルにルーティングされます。これらのフォールバックターゲットには、必要に応じて temperature や max tokens などのパラメーターのオーバーライドを含めることができ、モデルプロバイダーに応じて動作を微調整できます。評価中に最初に一致したルールのみが適用されるため、障害に対する予測可能で決定論的な処理が確保されます。
TrueFoundry における一般的なフォールバックルールには、次のコンポーネントが含まれます。
フォールバック設定例:
name: model-fallback-config
type: gateway-fallback-config
# The rules are evaluated in order. Once a request matches one rule, the subsequent rules are not checked.
rules:
  # Fallback to gpt-4 on Azure or AWS if openai-main/gpt-4 fails with 500 or 503.
  # The openai-main target also overrides some request parameters like temperature and max_tokens.
  - id: "openai-gpt4-fallback"
    when:
      models: ["openai-main/gpt4"]
      response_status_codes: [500, 503]
    fallback_models:
      - target: openai-main/gpt-4
        override_params:
          temperature: 0.9
          max_tokens: 800
  # Fallback to LLaMA3 on Azure or AWS if bedrock/llama3 fails with 500 or 429 for customer1.
  - id: "llama-bedrock-customer1-fallback"
    when:
      models: ["bedrock/llama3"]
      metadata:
        customer-id: customer1
      response_status_codes: [500, 429]
    fallback_models:
      - target: aws/llama3
      - target: azure/llama3
TrueFoundry の LLM Gateway は、設定システムの一部として宣言的なフォールバックセットアップをネイティブにサポートしています。これにより、チームは手動の介入なしで、特に複数のプロバイダーを扱う場合に障害耐性のあるルーティングポリシーを定義し、稼働時間を維持できます。スマートなレート制限と自動フォールバックが組み合わさることで、高可用性な生成 AI サービスの基盤が構築されます。
マルチテナント AI プラットフォームにおいて、レート制限は安定性、公平性、コストガバナンスを確保するために不可欠です。これにより、カスタムロジックを必要とせずに、個々のユーザーだけでなく、チーム、仮想アカウント、および特定のモデルにわたってアクセス境界を定義できます。
TrueFoundry の Gateway は、YAML 設定による宣言的なレート制限をサポートしており、ルールは順番に評価されます。最初にマッチしたルールが適用されるため、より具体的なルールを上部に、より一般的なルールを配置設定の下部に配置する必要があります。この構造により、クリーンで読みやすい設定を維持しながら、階層的な制御が確保されます。
各ルールには次のコンポーネントを含めることができます。
マルチテナントレート制限の例
特定のユーザーリクエストを制限する: ユーザー bob@email.com および jack@email.com に対して、openai-main アカウントからの gpt4 モデルへのすべてのリクエストを 1 日あたり 1,000 リクエストに制限したい場合:
- id: "user-gpt4-limit"
  when:
    subjects: ["user:bob@email.com", "user:jack@email.com"]
    models: ["openai-main/gpt4"]
  limit_to: 1000
  unit: requests_per_day
チーム全体での制限を適用する: 'frontend' チームの合計リクエスト数を 1 日あたり 5,000 リクエストに制限したい場合:
- id: "team-frontend-limit"
  when:
    subjects: ["team:frontend"]
  limit_to: 5000
  unit: requests_per_day
仮想アカウントを制限する: 仮想アカウント 'va-james' のリクエスト数を 1 日あたり 1,500 リクエストに上限設定したい場合:
- id: "va-james-limit"
  when:
    subjects: ["virtualaccount:va-james"]
  limit_to: 1500
  unit: requests_per_day
すべてのユーザーおよびモデルにわたってグローバル上限を設定する:
- id: "{user}-{model}-daily-limit"
  when: {}
  limit_to: 1000000
  unit: tokens_per_day
このセットアップにより、プラットフォームチームはビジネスユニット間で利用をセグメント化し、環境ごとのクォータを適用し、高価なモデルエンドポイントを保護しながら、スケーラブルで信頼性の高い AI ワークロードをサポートできます。
レート制限は単なるバックエンドの制御ではありません。大規模な LLM インフラストラクチャを信頼性が高く、コスト効率が良く、公平に利用するための重要なイネブラーです。マルチテナントプラットフォームを運営している場合でも、顧客にティアアクセスを提供している場合でも、チーム間で社内 AI ワークロードを実行している場合でも、トークンを認識するスマートなレート制限を実装することで、負荷がかかってもシステムが予測通りに動作することを保証します。
レート制限に加えて、フォールバックルーティング、リアルタイムフィードバック、粒度の細かい設定などの機能により、エンジニアリングチームはパフォーマンスとコントロールのバランスを取るツールを手に入れることができます。TrueFoundry の LLM Gateway は、これらの機能を宣言的インターフェースでまとめ、プラットフォームチームが透明で監査可能であり、組織の目標に沿ったポリシーを定義できるようにします。
生成 AI の導入が加速する中、ユーザーエクスペリエンスや稼働時間を損なうことなくインテリジェントなアクセス制御を強制適用するシステムが、次世代のインフラストラクチャにおけるレジリエンスを定義することになります。AI ゲートウェイを構築または拡張する場合、レート制限は単に検討すべき事項ではなく、初日から正しく設定すべき重要な要素です。
LLM Gateway におけるレート制限とは、ユーザー、チーム、またはアプリケーションが特定の時間ウィンドウ内に処理できる受信用リクエストの頻度やトークンのボリュームを制御するために使用されるメカニズムを指します。従来の API スロットリングとは異なり、トークンを認識し、異なるモデルアーキテクチャの実際の計算負荷を考慮するため、リソース消費の大きいクエリがシステムをダウンさせるのを防ぎます。
LLM Gateway 環境にレート制限を導入すると、予期せぬトークン消費の急増やコードの誤動作によるスクリプトの暴走を防ぎ、コストの制御に役立ちます。日別または時間別のきめ細かなクォータを設定することで、特定のユーザーや本番以外の環境での支出を無制限に増やさず上限を設定でき、AI 実験を予測可能な予算内に収めながら、予期せぬ請求の発生を防ぎます。
LLM Gateway のセットアップにおけるレート制限は、悪用からインフラストラクチャを保護し、すべてのユーザーに高い可用性を確保するために不可欠です。特定の「ノイジーネイバー」がプロバイダーのクォータや GPU 容量を使い果たすのを防ぎ、結果として生じるレイテンシの増大や頻繁な 429 「Too Many Requests」エラーの発生を抑止します。この管理レイヤーは、本番環境で安定した SLA を維持するために非常に重要です。
LLM Gateway におけるレート制限の一般的な戦略には、1分あたりのリクエスト数 (RPM) や 1分あたりのトークン数 (TPM) の制限があり、これらはリソース利用の正確な測定を提供します。高度なゲートウェイは、ユーザーロールやモデルタイプに基づく階層型制限もサポートしており、混雑時には優先度の低い開発ワークロードをスロットリングしつつ、ミッションクリティカルなタスクに高い優先順位を割り当てることができます。
わずかな処理ステップが追加されるものの、LLM gatewayにおけるレート制限によるオーバーヘッドは通常4ミリ秒未満であり、モデル生成に必要な数秒間と比較すると無視できるレベルです。実際、バックエンドキューの飽和を防ぎ、タイムアウトやサービス障害を起こすことなくリクエストをスムーズに処理できるようにすることで、体感レイテンシーを改善することがよくあります。
はい、TrueFoundryは宣言型のルールベース構成を通じて、LLM gatewayにおける本番環境グレードのレート制限実装を提供しています。シンプルなYAMLファイルを使用して、チームが複数のモデルプロバイダーやテナントにわたってトークンを意識した制限を強制できるようにします。このシステムはリアルタイムのフィードバックと詳細なダッシュボードを提供し、プラットフォームチームが厳格なコストおよびリソースガバナンスを維持しながらAIワークロードを拡張できるようにします。
AIレート制限は、ユーザーがAI APIにリクエストを送信する頻度を追跡することで機能します。システムは時間ウィンドウ内のリクエスト数またはトークン数をカウントします。ユーザーが許可された制限を超えた場合、APIは制限がリセットされるまで新しいリクエストを一時的にブロックするか、エラーを返します。これにより、サーバーを過負荷から保護します。
もちろんです。トークン使用量とリクエストレートを制限することで、gatewayは予期しないGPUの過剰使用やクラウド支出を防ぎます。組織は使用量を予算に合わせ、階層型アクセスを計画し、重要なワークロードに対して一貫したサービスを維持しながら、コストのかかる過剰なプロビジョニングを削減できます。
はい。TrueFoundryのような最新のAI gatewayを使用すると、チームはリアルタイムまたは自動スクリプト経由でレート制限ルールを更新できるため、ダウンタイムやパフォーマンスの低下を引き起こすことなく、インフラが予期しないサージに対応できるようになります。動的な調整により、テナント間での公平な使用を維持しながら、サービスのレスポンスを高く保ちます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























