



October 10, 2026
|
5 min read


Published: October 10, 2026
Blazingly fast way to build, track and deploy your models!
プロンプトエンジニアリングの手法は、チームが言語モデルに対してより適切な指示を記述し、出力品質を向上させ、回避可能なエラーを減らすのに役立ちます。OpenAIはプロンプトエンジニアリングを、モデルが要件を満たすコンテンツを生成できるように効果的な指示を書くことと定義しています。Anthropicは、プロンプトを通じて成功基準を制御できる場合に、プロンプトエンジニアリングが最も効果を発揮すると指摘しています。
エンタープライズチームにとって、プロンプトエンジニアリングはもはや個人の生産性スキルではありません。それは現在、モデルのコスト、レイテンシ、信頼性、コンプライアンス、そしてユーザーエクスペリエンスに影響を及ぼします。推論の文章を3つ追加するプロンプトは、100万リクエストの月間トークン消費量を倍増させる可能性があります。エージェントにツールへの安全でないアクセスを許可するプロンプトは、アクセス制御上のインシデントとなり得ます。
本ガイドでは、最も有用なプロンプトエンジニアリング手法、それぞれの適用時期、そしてプロンプトレベルの規律をAIゲートウェイのガバナンスとどのように結びつけるべきかを解説します。また、TrueFoundryがどのようにしてチームの本番環境におけるプロンプト、モデル、MCPツール、予算、エージェントのガバナンスを支援するのかについても説明します。
プロンプトエンジニアリング とは、信頼性が高く、正確で、適切にフォーマットされたAI出力を生成するためにLLMプロンプトを設計する手法です。これは、人間の意図とAIモデルの挙動を結ぶ主要なインターフェースです。そのインターフェースの品質は、アプリケーションの信頼性、コスト、安全性、そしてさまざまなタスクにおける有用性に直接影響します。
この分野は、単純な質問に対する簡潔な指示を書くことから、エージェントワークフローのためのプロンプトアーキテクチャを構築することへと拡大しました。現代のプロンプトには、入力変数、構造化された出力ルール、追加のコンテキスト、モデル設定、ガードレール、そして本番利用のためのポリシー要件が含まれる場合があります。
その実用的な意味は明らかです。プロンプトを使い捨てのテキストとして扱うチームは、品質の低いAIアプリケーションをリリースしがちです。バージョン管理、評価、ガバナンスを伴う体系的なプロンプトエンジニアリング手法を適用するチームは、正確な回答とより良い成果を得るための確実な道を歩んでいます。
TrueFoundryの プロンプト管理 は、その変化を反映しています。保存されたプロンプトは、システムメッセージ、ユーザーメッセージ、入力変数、ガードレール、および構造化された出力設定を1つのバージョン管理されたオブジェクトとして保持します。アプリケーションは、プロンプトテキストを埋め込む代わりに、完全修飾名でそれを参照できます。
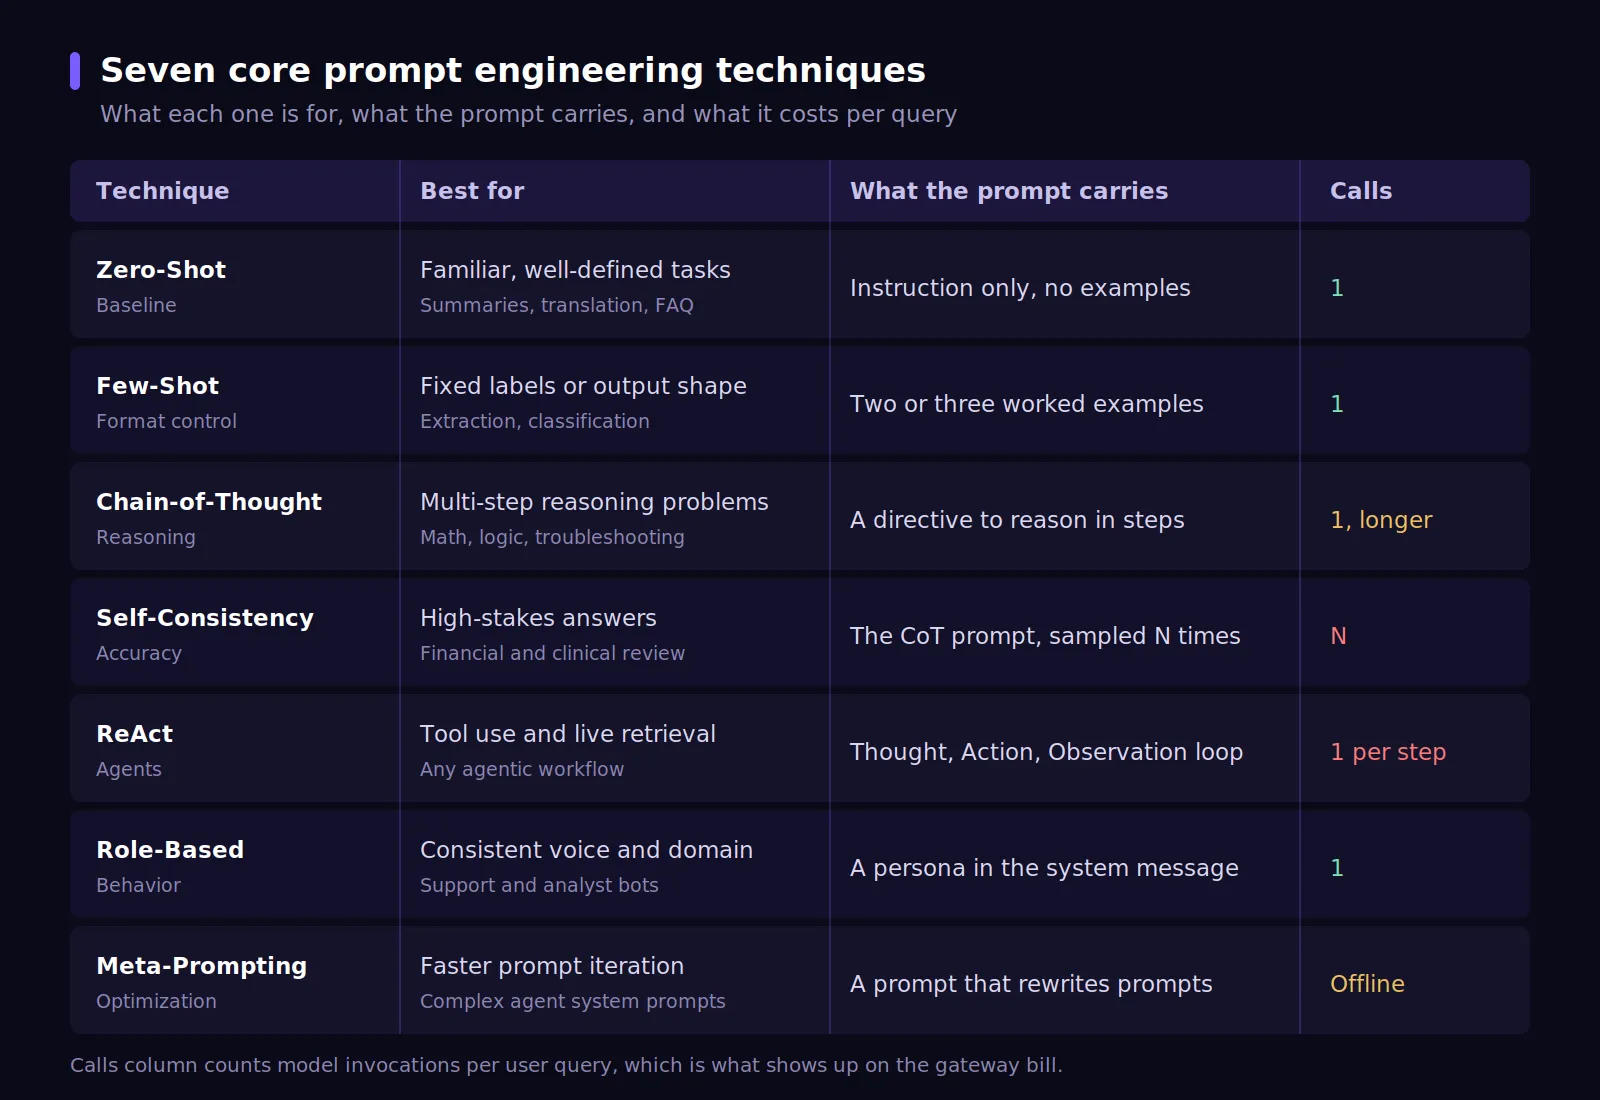
7つの主要なプロンプトエンジニアリング手法は、ほとんどの本番業務をカバーしています。これらを段階的なものとして読み進めてください。それぞれの手法は、精度、構造、または制御をもたらします。同時に、それぞれの手法はトークン、レイテンシ、メンテナンスの手間、またはガバナンスの複雑さというコストをチームに課します。
ゼロショットプロンプトは、大規模言語モデルに対して例示なしで特定のタスクを完了するよう求める手法です。モデルは、トレーニングデータと常識を頼りに、指示のみから正しい回答形式、内容、トーンを推論します。
最適な用途: モデルがすでにパターンを理解している明確に定義されたタスク。例として、要約、翻訳、単純な分類、FAQへの回答、短い入力からの関連事実の抽出などが挙げられます。
制限事項: ゼロショットの信頼性は、厳密なフォーマットやドメイン固有の動作が求められるタスクにおいて低下します。この失敗は往々にして静かに進行します。ゼロショット分類器はエラーではなくもっともらしいラベルを返すため、不具合は後になって分析結果の悪化やユーザー満足度の低下として現れます。
フューショット・プロンプティングでは、実際の要求の前に1つ以上の入出力例を提示します。これらの詳細な例は、特に望ましい出力に特定のトーン、スキーマ、ラベルセット、または記述構造が必要な場合に、モデルが従うべき具体的なパターンを提供します。
適した用途: 出力形式が重要なタスク。固定ラベルによる分類、構造化データの抽出、スタイルの統一、ドメイン固有のトーン、再現性のあるフォーマットが求められる場合に適しています。
例の数: 多くの本番タスクでは、2〜3個の例で十分なパフォーマンスが得られます。例を増やすとプロンプトの品質は向上しますが、リクエストごとにトークンコストが発生します。高トラフィックのエンドポイントで長いプロンプトを使用する前に、チームはトレードオフを評価する必要があります。
Chain-of-Thoughtプロンプティングは、最終的な回答を出す前に、中間ステップを経て推論するようモデルに促します。数学の問題、論理タスク、トラブルシューティングのワークフロー、あるいは中間的な推論が結果を左右するコーディング問題において、パフォーマンスを向上させることができます。
適した用途: 複雑な推論、決定木、技術診断、財務分析、および複雑な推論を要するタスク。短い回答ではなく、慎重な問題解決が求められるプロンプトで最も効果を発揮します。
ゼロショットCoT: 「ステップバイステップで考えてください」といった推論の指示を加えることで、推論の例を提示しなくてもChain-of-Thoughtの動作を誘発できます。これは、複雑なタスクの推論能力を低コストで向上させる手法です。
フューショットとの組み合わせ: 推論プロセスを含めたフューショットの例は、ドメイン固有のワークフローにおいてパフォーマンスを向上させます。ユーザーが最終的な回答のみを必要とする場合は、表示される回答を簡潔に保つよう工夫してください。
ここで重要な運用上の注意点があります。Chain-of-Thoughtの出力は長くなる傾向があり、体感遅延を抑えるためにストリーミングを行うのが一般的です。TrueFoundryの ガードレールに関するドキュメント によると、`stream: true`が設定されている場合、完全なレスポンスが揃わないため、出力ガードレールはスキップされます。つまり、ストリーミングされる推論内容は、出力ポリシーによるチェックの対象外となります。
自己整合性は、同じ質問に対して複数の独立した推論チェーンを生成することで、Chain-of-Thoughtプロンプティングを拡張する手法です。システムは、生成されたサンプル全体の中で最も整合性の高い最終回答を選択します。
適した用途: 推論コストよりも回答の正確性が重視される、高いリスクを伴う推論。例として、リスクレビュー、法的な推論サポート、財務分析、ケーススタディ、安全性が求められる推奨事項などが挙げられます。
コストのトレードオフ: 自己整合性(Self-consistency)には、クエリごとにモデルを複数回呼び出す必要があります。5つのサンプリングチェーンを実行すると、1回の課金対象リクエストが5回分になります。チーム単位での予算管理には、 AI Gateway の導入が不可欠です。
ReActプロンプトは、推論と行動を組み合わせた手法です。モデルは「思考(Thought)」「行動(Action)」「観察(Observation)」のステップを繰り返します。このパターンにより、モデルは推論を行い、外部ツールを呼び出し、その結果を読み取って、タスクが完了するまで継続的に処理を進めることができます。
適した用途: 情報検索、ツール実行、リアルタイムのコンテキスト、または複数ステップのタスク完了を必要とするエージェント型ワークフロー。ReActは、AIアシスタントがデータベース、API、SaaSツール、または社内システムと連携する必要がある場合に有効です。
ReActではセキュリティの考え方が変わります。プロンプトは単にテキストを生成するだけでなく、ツールの選択や行動の順序にも影響を与えるためです。ツールがビジネスシステムとやり取りする際、 MCP Gateway が権限管理、バリデーション、監査ログの強制レイヤーとして機能します。
ロールベースプロンプトは、システムプロンプトのレベルでモデルに特定のペルソナ、専門分野、または行動コンテキストを割り当てる手法です。「あなたはクライアントのポートフォリオをレビューするシニア財務アナリストです」と指示することで、役割を指定しない場合とは異なる推論パターンや出力スタイルが生成されます。
適した用途: ドメイン特化型のアプリケーション、特定のペルソナを持つカスタマーサービスエージェント、テクニカルサポートボット、およびすべての対話において一貫したトーンや行動コンテキストが求められるあらゆるアプリケーション。
エンタープライズでの適用: ロールベースのシステムプロンプトは、インフラ層で出力フィルタリングが適用される前に、アプリケーション層で行動のガードレールを強制するための主要なメカニズムとなります。
多くのチームが驚く境界線について注意が必要です。TrueFoundryのガードレールに関するドキュメントでは、システムプロンプトはデフォルトでガードレールの評価対象から除外されていることが明記されています。つまり、役割の定義自体が検査、ブロック、または編集されることはありません。ペルソナの指示は行動を形成するものであり、インフラ側が検証するポリシーとしては機能しない点に留意してください。
メタプロンプティングとは、LLMを直接的なタスク実行ではなく、プロンプトの分析、批評、改善に活用する手法です。プロンプトエンジニアはこれを利用することで、プロンプト案の生成、一般的なパターンの比較、指示の洗練を短時間で行うことができます。
適した用途: プロンプト設計の反復が多く、最適化を加速させたいチーム。複雑なアクティビティ、戦略立案、および多くの重要な要素を含むエージェントシステムのプロンプト作成に役立ちます。
本番環境への導入に関する注意点: メタプロンプティングで生成されたプロンプト案は、本番環境へ適用する前に、必ずテストセットを用いた評価が必要です。この手法は候補生成のステップを加速させるものであり、検証ステップを省略するものではありません。
A 体系的なプロンプト改善ワークフロー は、レビュー担当者の主観ではなく、固定された評価セットに対して候補をスコアリングすることで、その区別を確実に維持します。
以下の高度な技術は、単純な手法では対応が難しい問題に対して、計算リソースや設計工数を投じることで成果を得るものです。評価セットを用いて単純な手法では改善が見込めなくなった段階で導入してください。
Tree-of-Thoughtは、線形的なChain-of-Thought(思考の連鎖)プロンプトを分岐構造へと拡張したものです。モデルは複数の推論パスを探索し、潜在的な解決策を評価した上で、最も有望な分岐を選択して推論を継続します。
適した用途: 初期の指示から解決への道筋が明確ではない問題。研究の統合、短編小説などの創作活動、戦略策定、複雑なデバッグ、オープンエンドな計画立案などが挙げられます。
Tree-of-Thoughtは困難な推論タスクにおいて結果を向上させることができますが、分岐の数や深さに応じてコストも増大します。そのため、顧客向けのシステムに導入する前には、予算上限の設定が重要となります。
Constitutional(憲法)プロンプティングは、一連の原則をシステムプロンプトに組み込む手法です。モデルは回答を返す前に、それらの原則を用いて自身の回答を自己評価し、修正を行います。
適した用途: 組織の価値観、安全規則、コンプライアンス基準との一貫した整合性が求められるAIアプリケーション。生成後のフィルタリング処理が実行される前に、モデルの挙動をガイドするのに役立ちます。
憲法は監査の対象ではなく、品質管理の指針として扱ってください。原則はシステムプロンプトの中に組み込むべきものです。コンプライアンスの証跡は、モデルが操作できないガードレール、トレース、ポリシーの実行結果、およびログから取得する必要があります。
指向性刺激プロンプティングとは、短いヒントやキーワード、あるいは誘導信号を加え、モデルを最も関連性の高い情報へと導く手法です。ベースとなるプロンプトは明確であっても、モデルに対して何が重要かというより強い合図が必要な場合に有効です。
適した用途: 分類、要約、抽出タスクなど、小さな指向性の合図によって焦点を絞り込める場合に適しています。例えば、気候変動に関する要約であれば、「政策的影響」といった刺激を与えることで、モデルの注意を誘導できます。
これは高度な手法です。わずかな合図でも回答が予期せぬ方向に変わる可能性があるためです。チームはベースラインと比較してパフォーマンスを検証し、その刺激が他のケースに悪影響を及ぼすことなく、目的の出力を向上させていることを確認する必要があります。
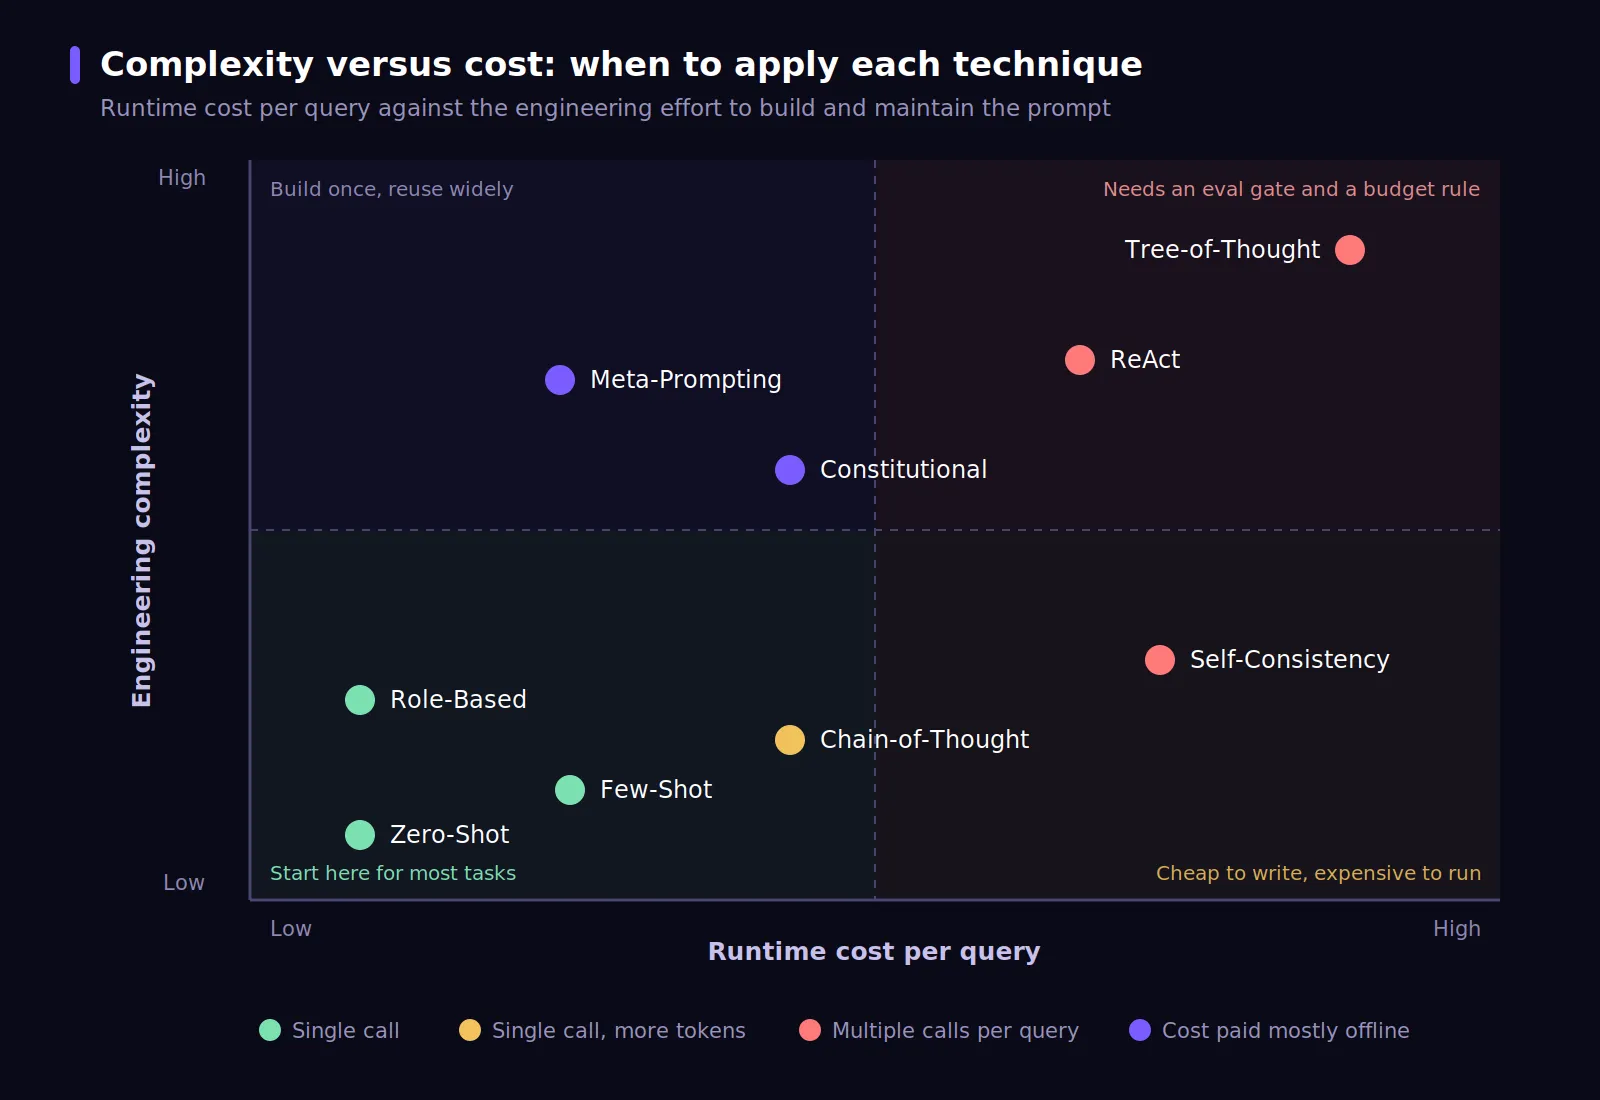
個別のプロンプトエンジニアリング手法は、管理されたテスト環境と、実際のユーザーが利用する本番環境とでは機能の仕方が異なります。トラフィック、コスト、リスク、ガバナンスが増大するにつれ、どの手法が有効であり続けるかを左右する運用上の現実がいくつか存在します。
TrueFoundryの組み込み型 プロンプトインジェクションガードレール は検証モードでのみ実行され、ユーザープロンプトとドキュメントやコンテキストの内容を2つの別々の領域として分析します。分析を分離することは重要です。なぜなら、間接的なインジェクションはユーザー自身のメッセージ内ではなく、取得されたドキュメント内で発生する可能性があるからです。
プロンプトエンジニアリング技術は、LLMがタスクをどの程度理解し実行できるかを決定します。一方、ガバナンス層は、その実行が安全かつコスト制限の範囲内で行われ、エンタープライズ環境の運用に必要なアクセス制御と監査証跡が確保されているかを決定します。
TrueFoundryのAI Gatewayは、プロンプトがモデルに到達する前にフィルタリングを適用し、システム側のプロンプトエンジニアリング手法の高度さに関わらず、プロンプトインジェクションの試みを遮断します。出力ガードレールは、応答がアプリケーションに戻る前にコンテンツポリシーを適用し、モデルレベルでのコンスティチューショナル・プロンプティング(憲法プロンプティング)を補完します。
実行モデルを詳しく見ると、その利点がわかります。入力検証ガードレールはモデルへのリクエストと並行して実行され、検証が途中で失敗した場合はゲートウェイがリクエストをキャンセルするため、ブロックされたプロンプトに対して課金されることはありません。PII(個人識別情報)の削除といった入力変換ガードレールは、モデルが受け取るペイロードを書き換えるため、リクエストの前に実行されます。
すべてのガードレールは、レイテンシ、判定結果、スコープ、適用対象のエンティティとともに、リクエストトレースに個別のスパンとして記録されます。ロールアウトは証拠に基づいて行います。まずは「監査(Audit)」モードでルールを開始し、「強制(Enforce)」へ昇格させます。その際、「エラー時は無視(But Ignore On Error)」設定を活用し、結果が適切であることを確認してから本格的な強制運用に移行します。
ガードレールは、`X-TFY-GUARDRAILS`ヘッダーを使用してリクエストごとに適用することも、組織全体で強制するために「AI Gateway → Controls → Guardrails」からポリシーとして一元的に設定することも可能です。
{
  "llm_input_guardrails": ["my-group/prompt-injection"],
  "llm_output_guardrails": ["my-group/secrets-detection"],
  "mcp_tool_pre_invoke_guardrails": ["my-group/sql-sanitizer"],
  "mcp_tool_post_invoke_guardrails": ["my-group/code-safety"]
}
チームごとのトークン予算は、以下の機能を通じて強制されます。 LLMゲートウェイ これにより、コストガバナンスがない場合にセルフコンシステンシーや思考の木(Tree-of-Thought)技術が大規模な運用で引き起こすコスト超過を防ぎます。 レート制限ルール は、トークン単位およびリクエスト単位の両方を受け付けます。また、`rate_limit_applies_per`を使用することで、ユーザーごと、モデルごと、あるいはメタデータキーごとに独立したカウンターを作成できます。
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  # Cap the reasoning-heavy service that runs self-consistency
  - id: "reasoning-service-hourly"
    when:
      metadata:
        service: "risk-analysis"
    limit_to: 200000
    unit: tokens_per_hour

  # Give every user an independent daily token ceiling
  - id: "user-daily-limit"
    when: {}
    limit_to: 1000000
    unit: tokens_per_day
    rate_limit_applies_per: ['user']
予算ルールでは、ユーザー、チーム、モデル、仮想アカウント、またはメタデータキーごとに金額の上限を設定できます。マイルストーンアラートと監査モードを活用することで、強制的にトラフィックをブロックする前に、チームは適切な閾値を調整できます。
アプリケーションは、テキストを直接組み込む代わりに、バージョンFQN(完全修飾名)を指定して管理されたプロンプトを呼び出すことができます。これにより、プロンプトの編集をリリースサイクルから切り離すことが可能です。ゲートウェイがテンプレートをレンダリングし、呼び出しを実行します。
from openai import OpenAI

client = OpenAI(
    api_key="your-tfy-api-key",
    base_url="{GATEWAY_BASE_URL}"
)

response = client.chat.completions.create(
    messages=[],
    model="",
    extra_headers={
        "X-TFY-METADATA": '{"service":"risk-analysis","env":"production"}',
    },
    extra_body={
        "prompt_version_fqn": "chat_prompt:truefoundry/default/cot-risk-review:3",
        "prompt_variables": {
            "portfolio_id": "PF-4471",
            "review_window": "Q3"
        }
    },
)

print(response.choices[0].message.content)
この呼び出しにおける2つの詳細が重要です。バージョン固定により、プロンプトのロールバックに再デプロイが不要になります。また、`X-TFY-METADATA`ヘッダーを使用することで、サービスごとの予算、レート制限、および コスト配分 を、実際の所有者に紐付けることができます。
この Agent Gateway は、ReActベースのエージェントが行うすべてのツール呼び出しを管理します。そのため、推論と実行のステップは個別にガバナンスが維持され、すべてのツール呼び出しのログにはユーザーの識別コンテキストが含まれます。
MCP Gatewayは、呼び出し前および呼び出し後のフックを提供してこれを強制します。また、ガードレールは会話ごとではなく、ツール呼び出しごとに個別に評価を行います。エージェントが5つのツールを連続して呼び出す場合、5回分のチェックが実行されます。
呼び出し前フックは、アクションが実行される前にそれを停止させ、パラメータの検証、SQLサニタイズ、およびCedarやOPAポリシーとして記述された権限チェックを行います。呼び出し後フックはツールの出力を検査し、Observationステップでモデルのコンテキストにフィードバックされる前に、間接的なインジェクションや漏洩したシークレットを捕捉します。
本番環境でガバナンスが効いたプロンプトワークフローを構築しましょう。 デモを予約する TrueFoundryがどのようにプロンプトレジストリ、ガードレール、予算管理、監査ログをAIゲートウェイ内で統合しているかをご確認いただけます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























