Built for Speed: ~10ms Latency, Even Under Load Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed Production-ready with full enterprise support 現代の Generative AI システムにおいて、AI Gateway はアプリケーションと大規模言語モデル(LLM)プロバイダーとの間をつなぐ重要なプロキシ層 として機能します。本番環境に流入するすべてのリクエストに対して、信頼性、可観測性(Observability)、アクセス制御、およびコスト効率を管理する中心的な役割を果たします。
Gateway は本番トラフィックのクリティカルパス上に位置する ため、次のようなコア原則を念頭に置いて設計する必要があります。
主要なアーキテクチャ上の優先事項: 高可用性(High Availability): Gateway が単一障害点(Single Point of Failure)になってはなりません。依存関係にあるシステム(データベースやキューの障害など)で問題が発生した場合でも、正常にトラフィックを処理し続ける必要があります。低レイテンシー: すべての推論リクエストに対してインラインで配置されるため、快適なユーザー体験を保証するために Gateway によるオーバーヘッドを最小限に抑える 必要があります。高スループットと拡張性: システムは クラウドのスケーラビリティ をサポートし、負荷に応じて線形にスケールし、効率的なリソース使用によって数千の並列リクエストを処理できる必要があります。ホットパスに外部依存関係を持たせない: パフォーマンスのボトルネックを防ぐため、ネットワークやディスクに負荷がかかる操作はすべて非同期システムにオフロードする必要があります。インメモリでの意思決定: レート制限、ロードバランシング、認証、認可などのクリティカルなチェックは、速度と信頼性を最大化するためにすべてインメモリで実行する必要があります。コントロールプレーンとプロキシプレーンの分離: 設定の変更やシステム管理をライブトラフィックのルーティングから切り離すことで、リージョンごとの障害隔離を備えたグローバル展開が可能になります。TrueFoundry の AI Gateway アーキテクチャ TrueFoundry の AI Gateway は、上記のすべての設計原則を具現化しており、低レイテンシー、高信頼性、およびシームレスな拡張性を実現するために専用設計されています。
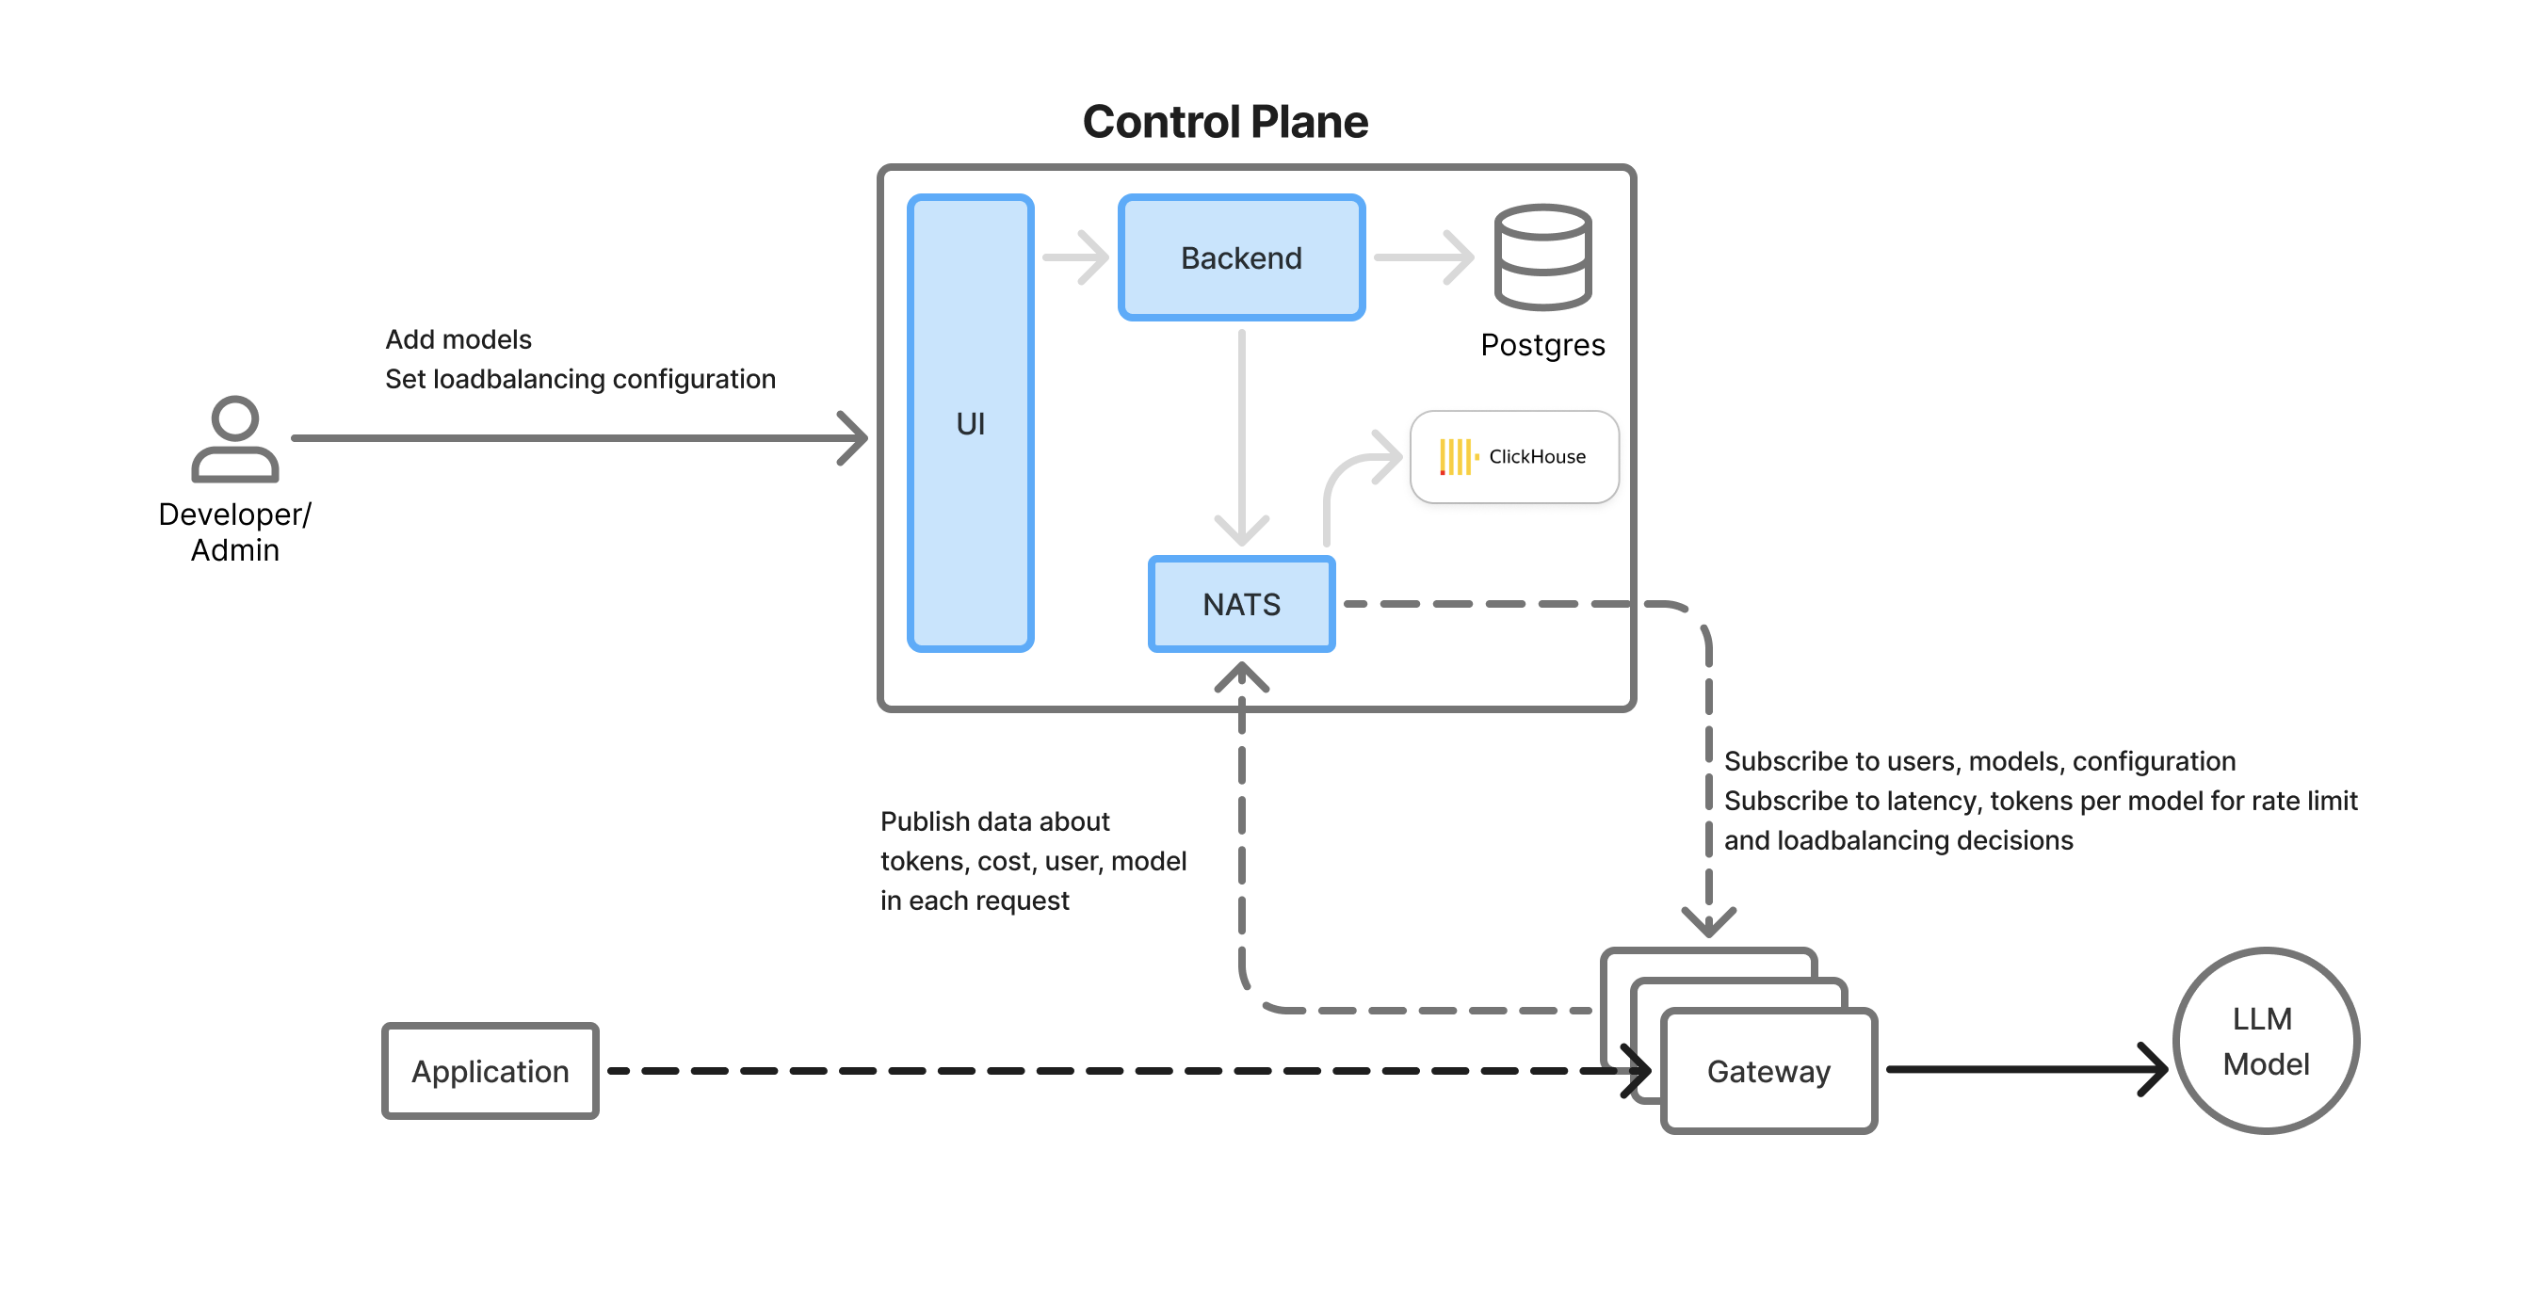
TrueFoundry の Gateway アーキテクチャ AI Gateway アーキテクチャの主な特徴 Hono フレームワーク上に構築: Gateway は、エッジ環境向けに最適化された最小限で超高速なフレームワークである Hono を活用しています。これにより、ランタイムオーバーヘッドを最小限に抑え、非常に高速なリクエスト処理を実現します。リクエストパス上での外部呼び出しゼロ: リクエストが Gateway に到達すると、外部呼び出しは一切発生しません(セマンティックキャッシュが有効になっている場合を除く)。すべての操作ロジックは内部で処理されるため、リスクが低減し信頼性が向上します。インメモリによる制御の適用: すべての認証、認可、レート制限、およびロードバランシングの意思決定はインメモリ設定 を使用して行われるため、ミリ秒未満の応答時間を実現します。非同期ロギング: ログとリクエストメトリクスはメッセージキューに非同期で送信されるため、データの可観測性処理がリクエストパスをブロックしたり低速化させたりすることがありません。フェイルセーフ動作: 外部のロギングキューが停止している場合でも、Gateway はリクエストを失敗させません 。これにより、一部のシステム障害下でも稼働時間とレジリエンスが保証されます。水平スケーラビリティ: Gateway は CPU に依存するステートレスな構成であるため、スケールアウトが容易です。高並列かつ低メモリ消費で効率的に動作します。コントロールプレーンとデータフロー TrueFoundry は、拡張性と柔軟性を高めるために、コントロールプレーン (管理)とデータプレーン (リアルタイムトラフィックルーティング)を分離しています。
AI Gateway のコンポーネント概要: UI: LLM プレイグラウンド、モニタリングダッシュボード、およびモデル、チーム、レート制限などの設定パネルを備えた Web インターフェース。Postgres DB: 永続的な設定データ(ユーザー、チーム、キー、モデル、仮想アカウントなど)を保存します。ClickHouse: ログ、メトリクス、および使用状況アナリティクスの保存に使用される高性能カラム型データベース。NATS Queue: コントロールプレーンと分散 Gateway ポッド間のリアルタイム同期バスとして機能します。すべての設定/状態の更新は NATS を介して配信され、すべてのリージョンで即座に利用可能になります。Backend Service: 設定の同期、データベースの更新、およびアナリティクスの取り込みをオーケストレーションします。Gateway Pods: 実際の LLM トラフィックを処理する、リージョン内のステートレスで軽量なプロキシ。NATS メッセージを消費し、外部依存関係なしですべてのロジックをインメモリで実行します。TrueFoundry の AI Gateway のパフォーマンスベンチマーク TrueFoundry の Gateway は、本番環境に近い負荷の下でパフォーマンスが徹底的にベンチマークされています。
1 CPU / 1GB RAM で 250 RPS を処理し、追加レイテンシーはわずか 3 ms 。CPU が飽和する前に、ポッドあたり最大 350 RPS まで効率的に拡張 可能(これを超過した場合はレプリカを追加可能)。 複数リージョン間での水平スケーリングにより、数万 RPS をサポート。 複数のレート制限、認証、ロードバランシングのルールが有効になっていても、追加のレイテンシーは発生しません 。 これが重要な理由 Generative AI ワークロードを大規模に展開している場合、あるいは複数の LLM(OpenAI、Claude、オープンソースなど)の統合を計画している場合、Gateway はスタックの基盤となります。
TrueFoundry の設計により、以下が可能になります。
複数のプロバイダー間での安全なルーティングとスケーリング 。 ユーザー/チームレベルでのきめ細かな制御の適用 。 Generative AI のコスト を管理しながら、システム全体の可観測性とガバナンスを維持。これらすべてをレイテンシーや信頼性に影響を与えることなく 実現。 AI Gateway の導入をご検討の際は、今すぐデモを予約 してください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.
Built for Speed: ~10ms Latency, Even Under Load