


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
ほとんどのチームが評価プラットフォームの必要性に気づくきっかけは同じです。ノートブック上では問題なく見えたプロンプトの変更が本番環境で静かに退化し、顧客がハルシネーションを起こした回答のスクリーンショットを送り、新しいモデルバージョンが古いものより実際に優れているのか単に異なるだけなのか誰も答えられないという状況です。「このLLMアプリは良い出来か?」という問いは、それを測定するための仕組みを構築するまで答えが出ません。
その仕組みを提供するのがLLM評価プラットフォームです。しかし、このカテゴリーにはノイズが多く存在します。評価がメインでトレーシングが後付けのツールもあれば、可視性がメインで評価が後付けのツールもあります。自分でホストするオープンソースライブラリもあれば、マネージドSaaSもあります。そして最新の複雑な要素がエージェントです。単一のプロンプトと完了を評価するのはひとつの問題ですが、ツールを呼び出し、ドキュメントを検索し、ループ処理を行う10ステップのエージェントを評価するのははるかに困難な課題です。
このガイドでは3つのことを行います。まず、実際に必要な機能を把握できるように評価ライフサイクルを定義します。次に、主要なプラットフォーム(Langfuse、Arize Phoenix、Braintrust、LangSmith、Comet Opik、Maxim、Helicone)を巡り、それぞれの長所と短所を具体的に解説します。そして、AI gatewayがどこに当てはまるかを説明します。なぜなら、gatewayが生成するトレースやコストデータこそが、ほとんどの評価プラットフォームが消費する生のデータだからです。
評価とともにリクエストごとのトレース、コスト、インライン guardrails を活用したいですか? デモを予約する。
評価とは、ローンチ前に1度だけ実行するステップではありません。4つのステージからなるループであり、本格的なプラットフォームはそのすべてをサポートします。
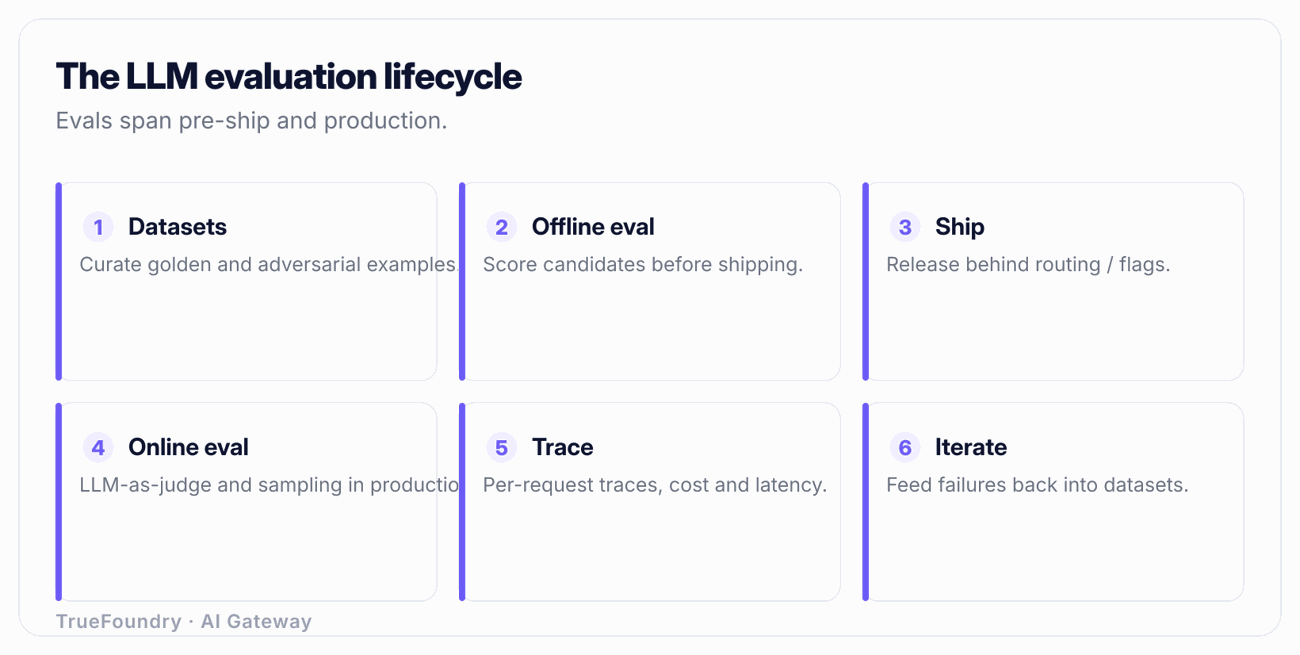
1. データセット。 すべては例から始まります。データセットとは、入力のセット(オプションで期待される出力や参照解答を含む)であり、アプリケーションが行う作業を表します。最高のデータセットとは合成されたものではなく、本番環境から収集されたものです。つまり、ユーザーが尋ねた質問の実例、特に問題が発生した質問です。成熟したチームは、失敗した本番トレースやスコアの低い本番トレースを継続的にデータセットに引き戻すため、評価スイートはローンチ時の難易度に固執することなく、時間とともに高度になっていきます。
2. オフライン評価。 プロンプト、モデル、または検索の変更を本番環境に適用する前に、データセットに対して実行し、出力をスコア評価します。スコアリング手法には、決定論的なもの(完全一致、正規表現、JSON-schemaの妥当性、SQLが実行されるか)から、モデルによる格付け(正確性、関連性、トーンに関するLLM-as-judge)まであります。オフライン評価はマージ前のゲートです。「この変更によって、既知のケースにおける結果が良くなったか悪くなったか?」という疑問に答えます。
3. オンライン評価。 オフラインデータセットが、本番環境で発生するすべての事象をカバーすることは決してありません。オンライン評価では、通常サンプリングを用いてライブトラフィックに対してスコアラーを実行し、データセットが見落としていた退化や新たな失敗モードを捉えます。ここでは、本番環境におけるハルシネーション率、回答の関連性、実際のユーザーセッションでの guardrail 違反などを測定します。
4. トレーシングと観測。 この両方を支えるのがトレーシングです。つまり、実行のすべてのステップを構造化されたスパンとしてキャプチャすることです。シンプルなチャットボットの場合、プロンプトの入力と完了の出力、さらにトークン数とレイテンシーが対象となります。エージェントの場合、それはツリー構造になります。計画ステップ、引数と結果を伴う各ツール呼び出し、返されたチャンクを伴う各検索、プロンプトと出力を伴う各モデル呼び出しです。このツリーがなければ、エージェントの最終的な回答をスコア評価することはできても、なぜ間違っていたのか、検索が失敗したのか、ツールがエラーを起こしたのか、モデルが良いコンテキストを無視したのかを判断することはできません。
ステージ3とステージ4からの発見がステージ1へフィードバックされることで、ループが閉じます。優れたプラットフォームでは、それが1クリックで行えます。悪い本番トレースを見つけたら、それをデータセットに追加し、今後ずっとそれに対してオフライン評価を再実行することができます。
エージェントの評価には2つの問題が加わります。第一に、最終的な回答だけでなく、軌跡(トラジェクトリ)が重要である点です。エージェントは、壊れた経路(3回の冗長なツール呼び出し、運よくモデルに無視されたゴミを返した検索)を通っても正しい回答に達することがあり、その脆弱性は後々問題となります。結果だけでなく、途中のステップもスコア評価する必要があります。第二に、非決定性が複合化する点です。各ステップに何らかの分散がある10ステップのエージェントは、同じ入力から大きく異なる実行結果を生み出すため、ケースあたり複数の実行と集計スコアリングが必要であり、単一の合否判定では不十分です。
要約、チャットの回答、曖昧な正確性を伴う抽出フィールドなど、オープンエンドなものに対して正規表現を書くことはできません。実用的なスコアラーは、出力を採点するようにプロンプトが与えられた別のLLM、すなわち「LLM-as-judge」です。
これは有効に機能しますが、評価を信頼しているチームと不利益を被るチームを分ける注意点が存在します。
以下で紹介するすべてのプラットフォームがLLM-as-judgeを提供しています。違いは、キャリブレーション、ルーブリック定義、およびジャッジのバージョン管理の容易さにあります。
万人に適した単一のツールは存在しません。以下に誠実な概要を示します。
Langfuse。 オープンソース(セルフホストまたはマネージドクラウド)であり、最も完全なOSSの選択肢です。トレーシング、評価、プロンプト管理、データセットを1つのシステムに統合しています。データレジデンシーの理由でセルフホストを希望し、3つのツールをつぎはぎすることなく可視性と評価を手に入れたいチームに最適です。トレーシングモデルは柔軟で、フレームワークに依存しません。ライフサイクルの大部分をカバーする1つのオープンソースプラットフォームを求める場合、通常これが最初に試すべき選択肢となります。より広範な可視性の環境における位置づけについては、LLM observabilityツールの概要をご覧ください。
Arize Phoenix。 オープンソースであり、OpenTelemetryネイティブであることが決定的な特徴です。PhoenixはLLMスパンに対してOTelセマンティックコンベンションをサポートしているため、トレースはすでに運用中のインフラストラクチャに収まり、独自のトレースフォーマットへのロックインを回避できます。検索およびRAGのデバッグ(組み込みとチャンクのインスペクション)に強みがあります。組織がOpenTelemetryに標準化されている場合、Phoenixが自然な選択となります。Arizeは、OSSコアの上にマネージドエンタープライズ製品も販売しています。
Braintrust。 マネージドで、評価ファーストのツールです。その命題は「CIとしての評価」です。開発ループに評価を組み込むことで、すべてのプロンプトやコードの変更がデータセットに対して自動的に実行され、テスト結果のようにスコアの差分が表示されます。プロンプトやモデルのバリエーションを並べて比較するための強力な実験UXを備えています。主な課題が「プロンプトを常に変更しているが退化をチェックするゲートがない」というチームに最適です。Langfuseと比較すると、セルフホストや完全な可視性の側面はやや控えめです。
LangSmith。 マネージドで、LangChainチームによって構築され、LangChainおよびLangGraphと深く統合されています。スタックがすでにLangChainベースである場合、トレーシングはほぼ無料で行え、計測も自ずとついてきて、エージェントの軌跡ビューも強力です。トレードオフは、最も緊密な体験がLangChainエコシステムを前提としている点であり、それ以外では利用可能ではあるものの、明確な強みは薄れます。
Comet Opik。 オープンソースで、Comet(ML実験トラッキング)の系譜を引き継いでいます。トレーシング、評価をカバーし、特に評価と並行して guardrail スタイルのチェックを出荷しています。クラシックなML実験トラッキングにすでにCometを使用しており、LLMの作業も同じ場所で行いたいチームや、モデレーション タイプのチェックが組み込まれたOSS評価ツールを求めるチームに適しています。
Maxim AI。 評価および可視性プラットフォームであり、オープンソースのAI gatewayであるBifrostも提供しています。統合されたアピールポイントは「評価、観測、ルーティングを1つのベンダーで」という点です。買い手が直面するギャップは、評価とgatewayが単一のコントロールプレーンというよりは事実上別の製品であること、gatewayの価格が非公開(アクセスリクエスト制)であること、そしてベンチマークの多くが自己報告による若いベンダーである点です。MaximまたはそのBifrost gatewayを特に検討している場合は、評価の深さとgateway・ガバナンスの深さを個別に評価してください。両方でベストインクラスであるツールは滅多にありません。
Helicone。 オープンソースで、可視性とプロキシに重点を置いています。モデル呼び出しの前に軽量なプロキシとして配置され、最小限の統合(ベースURLの変更)でログ、レイテンシー、コストをキャプチャします。評価機能も存在しますが、専用の評価プラットフォームよりは軽量です。セットアップコストを抑えて高速かつ低コストな可視性を得ることを優先し、深い評価は二次的なものとして扱う場合に最適です。
以下は、比較を要約したものです。
TrueFoundryがどのように評価スタックへ可視性とガバナンスを追加するかご覧ください。デモを予約する。
上記のリストからの選択は、いくつかの軸に集約されます。機能数のマーケティング文句ではなく、以下の基準で候補をスコア評価してください。
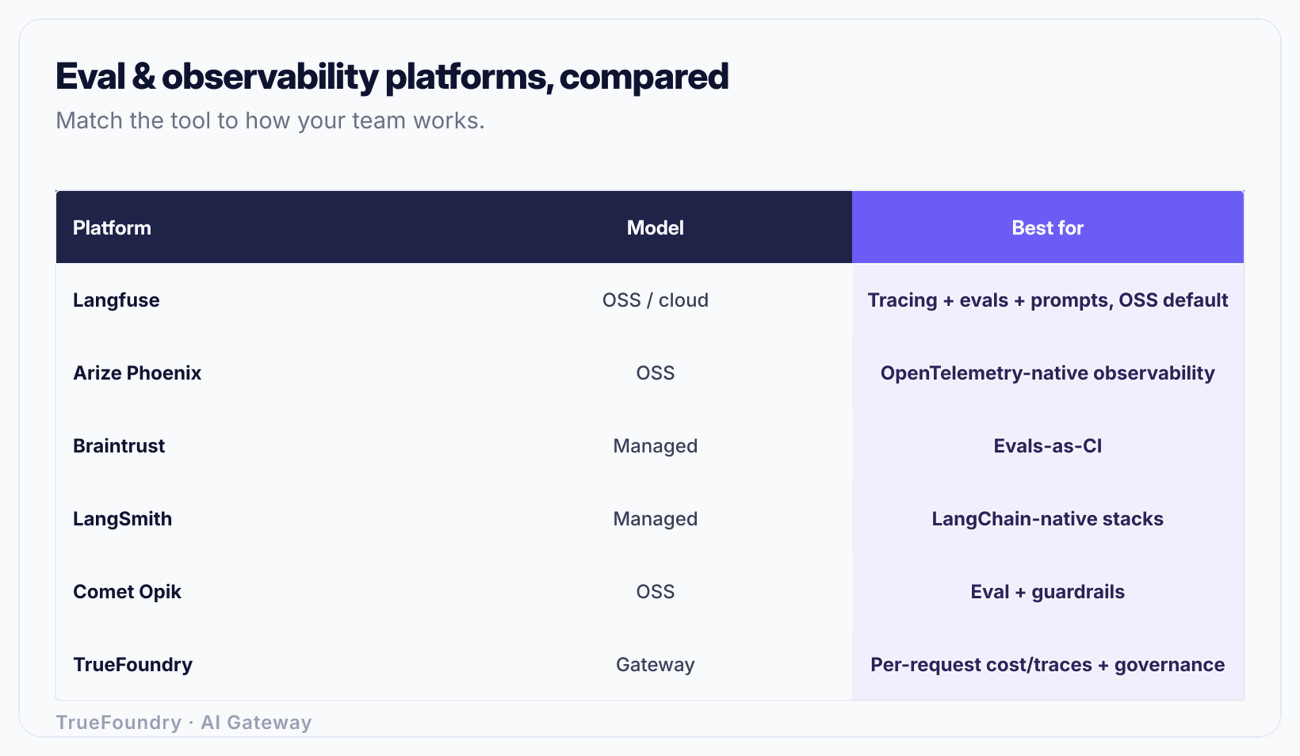
このグリッドの具体的な使用例:「顧客データをVPC外に出すことはできない」というハード制約がある場合、即座にセルフホスト可能なOSSの選択肢(Langfuse、Phoenix、Opik)またはVPC内デプロイが可能なエンタープライズプランに絞り込まれ、マネージド専用ツールはUXがどれほど良くても候補から外れます。譲れない条件から始めて、残りの範囲内で最適化を行ってください。
評価プラットフォームには、評価するためのデータ(トレース、プロンプト、完了、トークン数、レイテンシー、呼び出しあたりのコスト)が必要です。それはどこから来るのでしょうか?単一のアプリケーションの場合、直接計測を埋め込みます。多数のモデルプロバイダーに対して数十のアプリやエージェントを実行している組織全体では、よりクリーンなソースは、すべての呼び出しがすでに通過しているレイヤー、つまりAI gatewayです。
TrueFoundryのようなgatewayは、統一されたOpenAI互換APIの裏で、すべてのモデルおよびプロバイダーのトラフィックの前に位置します。すべてのリクエストがここを通過するため、リクエストごとの可視性データ(入出力トークン、レイテンシー、使用されたモデルとプロバイダー、コスト)を排出し、これらすべてにユーザー、チーム、アプリケーションのタグが付けられます。これこそが評価プラットフォームが取り込みたいストリームであり、gatewayが集中して生成するため、アプリごとの計測作業なしで手に入ります。
また、gatewayは呼び出し時にインラインで guardrails(PII検知、プロンプトインジェクションのチェック、シークレットスキャン)を実行します。これはオフライン評価とは異なる役割です。Guardrails は問題のあるリクエストやレスポンスを発生したその場でブロックまたは警告し、評価はデータセットや本番サンプルに対して事後的に品質をスコア評価します。両方が必要なのです。Guardrail はリクエストパスでの明白な害を阻止し、評価プラットフォームは回答品質が数週間で向上しているか低下しているかを教えてくれます。
役割分担は明確です。Gatewayはリクエストパス(ルーティング、フォールバック、キャッシュ、予算、インライン guardrails、トレース排出)を担当し、評価プラットフォームは測定ループ(データセット、オフライン/オンラインスコアリング、LLM-as-judge、実験の比較)を担当します。TrueFoundryはgateway側と可視性フィードを提供し、上記のリストにある専用の評価プラットフォームがそれを消費します。多くのモデルにわたってコストとガバナンスを標準化するチームにとって、この2つを組み合わせることは、どちらかのツールにもう一方の役割を無理やりやらせるよりも優れています。2026年におけるLLM向け最適なAI observabilityプラットフォームに関するガイドでは、特に可視性の半球についてより深く解説しています。
LLM-as-judgeを絶対的な正解として扱う。 ジャッジも独自のバイアスや失敗モードを持つモデルです。人間のラベルに対してキャリブレーションを行わずにジャッジを導入したチームは、不正確な採点者を満足させるためだけにアプリを最適化することになり、これは厳密であるかのように見えて間違っているため、評価を行わないことよりも悪影響を及ぼします。必ず最初にジャッジと人間の合意率を測定してください。
エージェントの最終回答のみを評価する。 壊れた軌跡からの正しい回答は、潜在的なバグです。中間のステップをスコア評価しないと、エージェントが3回の無駄なツール呼び出しと無視された検索を経て正解に達していることに気づけず、わずかな変更で失敗に転じたときに理由がわからなくなります。
ローンチ時にデータセットを固定化する。 静的な評価セットはローンチ時の難易度を永遠に測定し続け、その間で本番環境は変化していきます。失敗した本番トレースを継続的にデータセットに引き戻すループがなければ、グリーンの評価ダッシュボードは徐々に意味をなさなくなります。
Guardrail が解決すべき問題のために評価ツールを購入する。 本当のニーズが「リクエストパスでPIIやプロンプトインジェクションをブロックすること」である場合、必要なのはgatewayでのインライン guardrails であり、オフライン評価スイートではありません。逆に、リアルタイムの攻撃を捕捉するためにオフラインデータセットを実行するのは遅すぎます。チェックがパス内で行われるか事後に行われるかに合わせてツールを選択してください。
調達段階になるまでデータレジデンシーを無視する。 チームがUXに基づいてマネージド評価ツールを選び、セキュリティレビューになって顧客データを含む本番プロンプトがVPCから外に出せないことに気づくケースがあります。OSSかマネージドか、およびデプロイ方法の問題を最初に決定してください。それはどの機能よりも早く選択肢を絞り込みます。
評価とは、「AIが良くなった気がする」という感覚を、確証の持てる数値に変換する規律です。プラットフォーム間の差は、評価を行うかどうか(どのツールも行います)よりも、データセットの選定、オフラインのゲート構築、オンラインモニタリング、エージェント軌跡のトレーシング、キャリブレーションされたLLM-as-judgeといったライフサイクル全体をどのように扱うかにあります。ハード制約(データレジデンシー、既存のフレームワーク、OSSかマネージドか)から始めて、選定グリッドに対して候補をスコア評価し、単発のテストハーネスではなく完全なループを重視してください。
そして、評価が単独で存在するわけではないことを覚えておいてください。モデルの前に配置されたgatewayは、評価プラットフォームが必要とするトレースやコストデータをすでに生成しており、オフライン評価では不可能なリクエストパスでの guardrails を強制します。強力な評価プラットフォームと、クリーンなリクエストごとの可視性とインライン制御を提供するgatewayを組み合わせることで、LLMプロダクトの品質を維持するためのリアルタイムのセーフティネットと長期的な品質シグナルの両方を手に入れることができます。
ガバナンスの効いたgatewayと評価を組み合わせましょう。 デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












