


11月 20, 2026
|
5 min read


Published: 11月 20, 2026

Blazingly fast way to build, track and deploy your models!
AI Gateway を評価するほとんどのチームは、同じ不安からスタートします。「すべてのモデル呼び出しの前にプロキシを配置すると、ホップが増えてレイテンシーが加算されてしまうのではないか」という懸念です。これはもっともな直感ですが、Gateway の導入を見送る理由としては不適切です。この直感は、影響のスケール感において誤っています。フロンティア LLM へのモデル呼び出しには、短い補完処理で 300 ミリ秒、長い推論レスポンスでは 20 秒以上の時間がかかります。適切に構築された Gateway が自身の処理として追加するレイテンシーは、一桁から数十ミリ秒程度に過ぎません。問題は「Gateway がレイテンシーを追加するかどうか」(微量ながら確実に追加されます)ではなく、「そのオーバーヘッドを正確に測定でき、テール時や高負荷時にも小さく抑えられるか」です。
問題は、これを正しくベンチマークしているチームがほとんど存在しないことです。多くのチームは Gateway 経由で 100 件のリクエストをループ実行し、平均の経過時間を調べて直接呼び出した 100 件の結果と比較し、「パフォーマンス」について結論づけていますが、その数値はプロバイダーのばらつきやネットワークのジッターに支配されています。彼らが真に気にするべきシグナル、すなわち Gateway 自体のオーバーヘッドは、数秒にも及ぶモデルの処理時間に埋もれてしまい、分離されることがありません。
本記事では、ベンダーに依存しない方法で AI Gateway を正しくベンチマークする手法を解説します。どのメトリクスが重要か、Gateway のオーバーヘッドをプロバイダーのレイテンシーからどのように分離するか、テールや負荷状態でのテスト方法、ストリーミングやキャッシュの扱い方、そして「優れた状態」とはどのようなものかについて説明します。本記事の数値例はすべて説明用のテンプレートであり、実際の測定結果ではありません。これらのテーブルには、ご自身の実行結果の数値を入力してご活用ください。
実際のトラフィックに対してリアルな Gateway のオーバーヘッドを測定してみませんか? デモを予約する。
AI Gateway は、アプリケーションと 1 つ以上のモデルプロバイダーとの間のリクエストパス上に位置します。TrueFoundry の場合、ルーティング、フォールバックとリトライ、完全一致・セマンティックキャッシュ、予算とレート制限、ガードレール、リクエストごとの可観測性を処理する、統合された OpenAI 互換 API として機能します。各機能はそれぞれ内部処理を行っており、処理には時間がかかります。ベンチマークとは、各処理時間を正しい場所に帰属させるための手法です。
単一の非ストリーミングリクエストのレイテンシーの内訳は、以下のようになります。
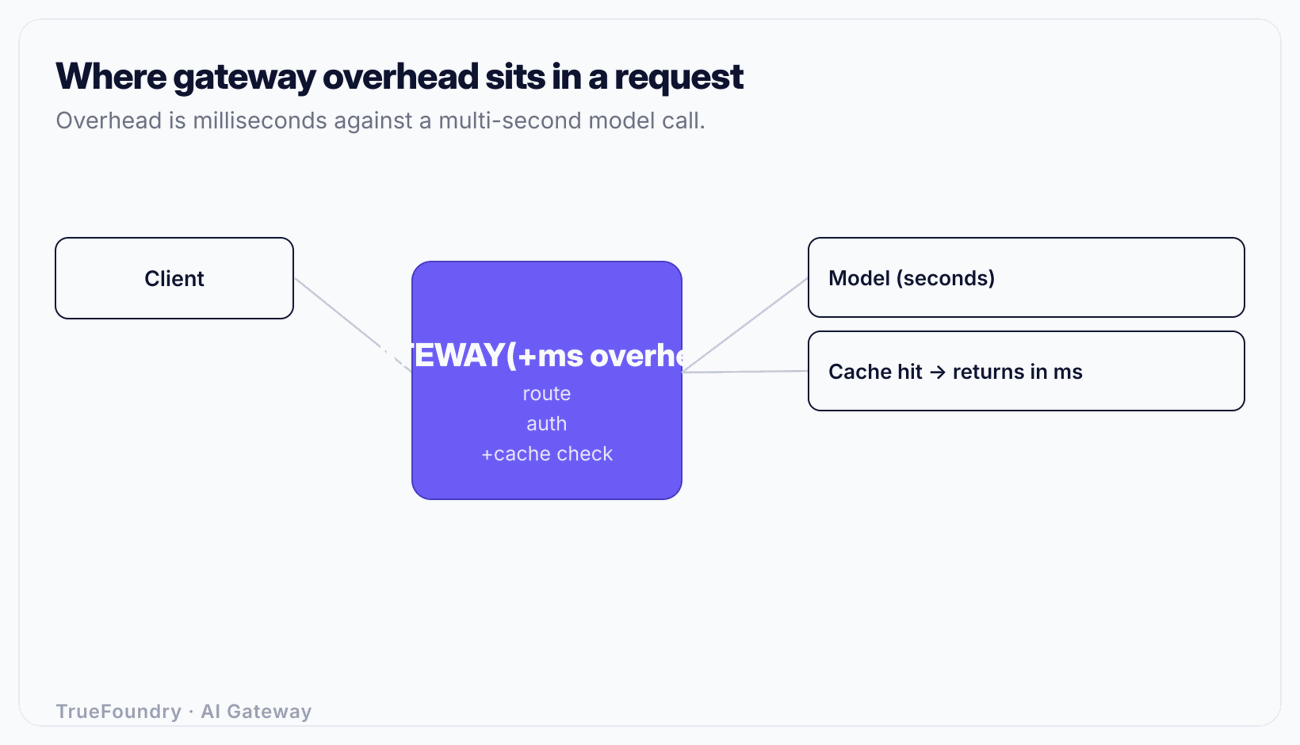
1 つのリクエストの経過時間を 4 つの部分に分解します。
ベンチマークで最も重要なメトリクスは、(1) と (3) から分離された、(2) プラス (4) の追加レイテンシー(Added Latency)です。お使いのツールがエンドツーエンドの時間しか出力しない場合、Gateway ではなくプロバイダーを測定していることになります。
Gateway のパフォーマンスは 6 つの数値で表されます。単一の平均値はベンチマークとは言えないため、6 つすべてを記録してください。
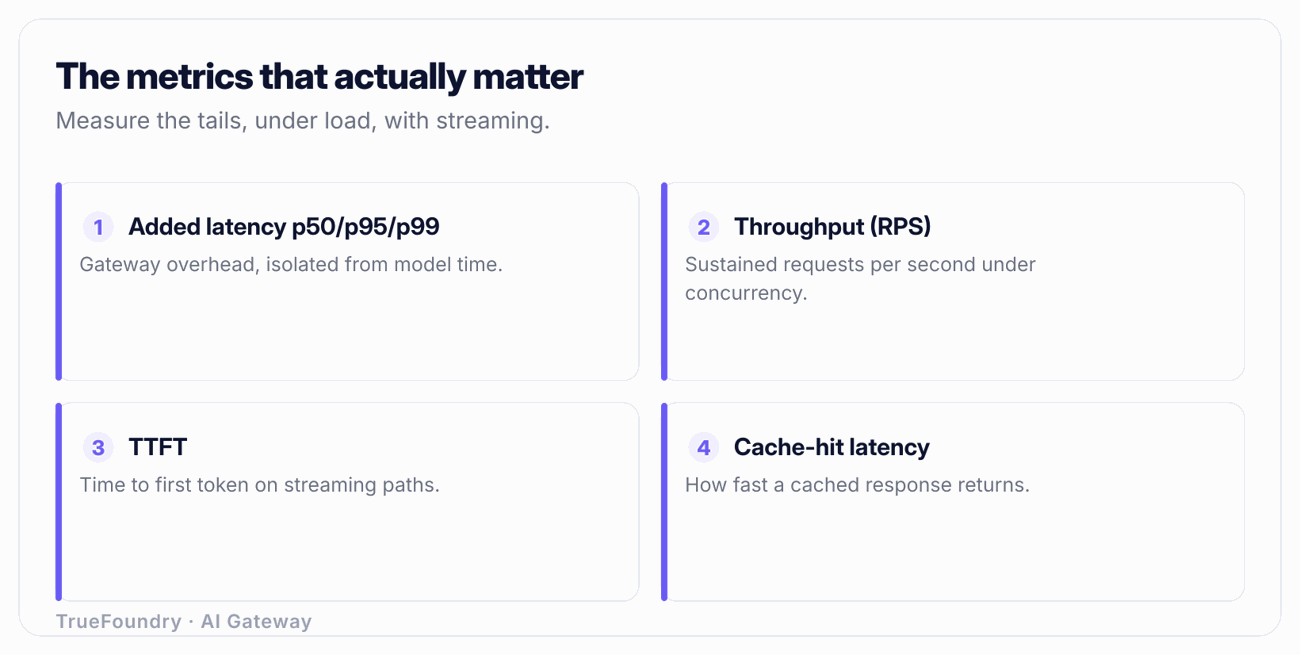
2 つのテールメトリクス(p95/p99)については特に強調しておく必要があります。エージェント型のワークロードでは、ユーザーの単一のアクションが推論ループ全体で 10〜50 回のモデル呼び出しに展開されることがあります。各呼び出しが 1/100 の確率で遅い p99 パスにヒットする場合、30 回の呼び出しループでは、ユーザーのアクション 3〜4 回に 1 回の割合でその遅延パスに遭遇することになります。エージェントの規模において、テールは例外的なケースではなく、日常的なケースなのです。
手法の核となるアプローチは「引き算」ですが、プロバイダーのレイテンシーにはノイズが含まれるため、単純な引き算ではノイズの多いオーバーヘッドしか得られないという落とし穴があります。
オプション A:ペア・リクエスト。 テストの反復ごとに、まったく同じリクエストをプロバイダーへ直接送信する処理と Gateway 経由で送信する処理のペアとし、可能な限り近いタイミング(理想的には交互)で実行します。ペアごとに Direct の時間を Gateway の時間から差し引きます。ペア化することで、テスト中にプロバイダーの負荷が変動しても、ペアの両方がほぼ同じプロバイダー条件に晒されるため、変動をコントロールできます。数千のペアを収集し、その差分のパーセンタイルを算出します。これにより、Gateway のアップストリーム呼び出しを含む真の追加レイテンシーが測定できますが、ペア間におけるプロバイダーの瞬時的なジッターの影響を受けやすくなります。
オプション B:Gateway 内部のロギング時間。 優れた Gateway は、リクエストの受付からアップストリーム呼び出しの送信までの時間と、レスポンス側の処理時間を合わせた、独自のリクエスト処理時間を記録します。TrueFoundry のリクエストごとの可観測性機能では、このように分解されたレイテンシーがユーザー、チーム、モデルごとにタグ付けされて表示されます。これにより、引き算やプロバイダーのノイズなしでオーバーヘッドを直接取得できるため、このデータが利用可能な場合は最も信頼できる数値となります。ペア・リクエストの測定結果と一度照合して検証した上で、運用中の継続的なモニタリングにはこの内部メトリクスを活用してください。
オプション C:プロバイダーのモック化。 Gateway の接続先を、固定された既知の遅延(例: 200 ms)で定型レスポンスを返すローカルのスタブに向けます。これにより、プロバイダーの時間は自ら選択した定数となり、それを超える時間はすべて Gateway のオーバーヘッドとネットワーク遅延になります。これは、実際のプロバイダーに課金されたりレート制限を受けたりすることなく、高 RPS 時に Gateway 自体のコードパスにストレスをかける最もクリーンな方法であり、スループットの屈曲点を見つけるための最適なツールです。ただし、実際のプロバイダーの挙動までは再現できないため、エンドツーエンドの現実的なテストではなく、オーバーヘッドとスループットの測定用として使用してください。
3 つのオプションをすべて活用しましょう。オプション C でスループットの上限を特定し、オプション A で本番環境の追加レイテンシーを検証し、オプション B で本番環境で監視し続ける数値を把握します。Gateway がアプリケーションに対してどこに配置されるか、またその配置がレイテンシーをどのように左右するかについての詳細は、制御プレーンとデータプレーン、および AI Gateway の選び方におけるより広い概念整理を参照してください。
同時実行数 1 で実行されるベンチマークは、最小値(フロア)を示すだけであり、本番環境については何も教えてくれません。本番の Gateway は同時に進行する数千件のリクエストを処理するため、重要なのは同時実行数が増加した際にオーバーヘッドがどのように劣化していくかです。
負荷テストは段階的な増分(ランプアップ)として設計します。低い同時実行数から開始し、一定時間を維持したのち、段階的に引き上げ、p95 の追加レイテンシーが設定した閾値を超えるまでステップアップを続けます。各ステップで、p50、p95、p99 の追加レイテンシーと達成された RPS を記録します。出力結果は単一の「点」ではなく「曲線」になります。一般的なパターンは以下の 3 つです。
負荷生成に関する2つの詳細な設定は、想定以上に測定数値に大きな影響を与えます。第一に、既存のレスポンス完了を待たずにスケジュール通りにリクエストが到達するオープンループ(open-loop)負荷モデルを使用してください。固定ワーカープールが各レスポンスを待つクローズドループモデルは使用しないようにします。クローズドループテストでは、レスポンス遅延によって提示される負荷が抑えられるため、キューの蓄積が隠蔽され、テールレイテンシーの数値が実際よりも良く見えてしまいます。第二に、クライアント自体がボトルネックにならないよう、十分なクライアント接続数から負荷を発生させてください。接続プールの小さな単一のクライアントプロセスでは、「ゲートウェイ」のレイテンシーとして報告されるものの多くが、実際にはクライアント側のキューイングによるものになってしまいます。
チャットやエージェントのワークロードでは、ほとんどのレスポンスがストリーミングされます。ストリーミングによって、重視すべきメトリクスが逆転します。ユーザーが体感するのは「最初のトークンまでの時間(TTFT)」であり、合計時間は体感スピードにはほとんど影響しません。
正しく構築されたゲートウェイは、アップストリームからストリーミングされたチャンクを到着と同時に転送し、チャンクあたりわずかで一定のオーバーヘッドしか加えません。設計の悪いゲートウェイは、アップストリームのレスポンス全体をバッファリングし、レスポンス処理を適用してからクライアントへのストリーミングを開始します。これにより、3秒のストリーミングレスポンスが、3秒間の待機後に一括出力されるレスポンスに変わってしまいます。TTFTベンチマークを行えば、これらをすぐに検知できます。リクエスト送信から最初のコンテンツチャンクの最初のバイトを受信するまでの時間を、ゲートウェイ経由と直接接続の両方で計測します。ゲートウェイによるTTFTオーバーヘッドは、数百ミリ秒ではなく、非ストリーミング時のオーバーヘッドに近い数ミリ秒程度に収まるべきです。
レスポンスのガードレールを導入すると、この評価はさらに複雑になります。完全なレスポンスを検査する必要がある出力ガードレール(特定個人情報(PII)やポリシーチェックなど)を実行する場合、設計上の選択を行わない限り、ストリーミングとテキスト全体の検査を同時に行うことはできません。楽観的にストリーミングして後から撤回するか、バッファリングして遅延させるかのどちらかです。出力ガードレールを使用する場合は両方のモードでベンチマークを実施し、それぞれのTTFTコストを報告してください。ベンダーがガードレールをオフにした状態で測定したストリーミングTTFTの数値を鵜呑みにし、本番環境でガードレールを有効にして運用するようなことは避けてください。
TrueFoundryがどのように追加レイテンシーを一桁ミリ秒に抑えているかをご覧ください。デモを予約する。
実装言語だけでゲートウェイを選択する必要はありませんが、言語やアーキテクチャがスループット曲線にどのような影響を与えるかを理解しておく必要があります。これにより、どこに負荷をかけてテストすべきかが分かるからです。
シングルスレッドのイベントループ上で動作するゲートウェイは、I/Oバウンドな処理(プロバイダーからの応答待ち)において非常に高い並列性を処理しますが、ホットパス上にあるCPUバウンドな処理はシリアライズ(直列化)されます。リクエスト解析、トークンカウント、ガードレールの正規表現検索などがインラインで実行されると、それらの処理が1つのスレッドを奪い合い、高負荷下でp99レイテンシーの上昇として現れます。グローバルインタプリタロック(GIL)を持つランタイムにも同様の制約があります。スレッドプールを使用しても、1つのプロセス内ではCPUバウンドな部分が完全に並列処理されないため、プロセス数を増やすことでスケールさせる必要があります。そのため、ベンチマークではプロセスごとのメモリ消費や接続プールの重複を考慮しなければなりません。コンパイル型のマルチスレッドランタイム(Go、Rust)は、1つのプロセス内で複数のコアにわたってCPU処理を並列化します。これにより、異なる運用プロファイルが必要になるトレードオフはあるものの、通常はインスタンスあたりのスループットの屈曲点(knee)を高レベルに押し上げることができます。
実践的な結論は、「GoがPythonより優れている」ということではありません。重要なのは、ホットパス上で実行される処理を特定し、並列環境下でベンチマークを行うことです。100,000トークンのコンテキストに対するトークンカウント、プロンプトインジェクション分類器の実行、セマンティックキャッシュ用のエンベディング計算などはすべてCPU処理です。これらがインラインで実行されれば、テールレイテンシーのカーブを悪化させます。ホットパスから外れて実行されるか、高速なパスの後ろで実行されれば、影響はありません。コンテキスト長はまさにこれらの処理のCPUコストに直結するため、10トークンのテスト用文字列ではなく、実際の運用を反映したプロンプトサイズでテストしてください。LLMプロキシとしてのゲートウェイの役割は、リクエストごとの処理を小さく予測可能な状態に保つことです。
「ゲートウェイを追加するとレイテンシーが増加する」という従来の懸念が覆る唯一のシナリオが「キャッシング」です。そして、これは多くのチームがベンチマークで検証し忘れるシナリオでもあります。
TrueFoundryは、完全一致キャッシュ(同一のリクエストに対して保存されたレスポンスを返す)と、セマンティックキャッシュ(プロンプトのエンベディングが過去のリクエストとコサイン類似度の閾値内にある場合にレスポンスを返す)の両方をサポートしています。キャッシュにヒットした場合、モデル呼び出しは一切発生しません。リクエストのレイテンシーは、モデルの数百ミリ秒〜数秒という単位から、ゲートウェイ自身の検索時間(セマンティックキャッシュの場合はエンベディング計算+ベクターまたはキーの検索時間)へと短縮され、通常は一桁から二桁台前半のミリ秒に収まります。
これは独立したシナリオとしてベンチマークを行ってください。
以下は概念を示すための試算例です。自社ワークロードでの直接モデル呼び出しのp50が1,200 msだと仮定します。完全一致キャッシュヒットでは6 msで返却され、セマンティックキャッシュヒットでは22 ms(エンベディング処理が支配的)で返却されるとします。ヒット率が40%の場合、加重平均したp50は「0.6 × 1,200 + 0.4 × 15 ≈ 726 ms」となります。これは一般的なレイテンシーの40%削減を意味し、同時にトークン消費量も40%削減されます。これらはどちらもゲートウェイによって実現された成果です。エンドツーエンドの平均値として報告した場合、ゲートウェイ経由の方が直接呼び出すよりも大幅に高速に見えます。これこそが、「ゲートウェイはレイテンシーを追加する」という言い方が誤解を招く理由です。キャッシュされたトラフィックにおいて、ゲートウェイはレイテンシーを削減します。具体的な数値は自社の環境に合わせて当てはめてみてください。この構造自体はどのような環境でも成り立ちます。
自社での検証結果を含め、ゲートウェイのレイテンシーに関する主張を信頼する前に、このリストを実行してください。
以下の表は、実際のテスト結果を記入するためのテンプレートです。記載されている数値は期待される形状や桁数を示すプレースホルダーであり、特定製品の実測値ではありません。すべてのセルを、自社のモデル、リージョン、トラフィックで計測した数値に置き換えて使用してください。
単一の行だけを取り出しても意味はありません。価値があるのは比較です。キャッシュヒットとミスの比較、ストリーミングと非ストリーミングの比較、低負荷時と屈曲点における比較に意味があります。
エンドツーエンドのレイテンシーを報告し、それをゲートウェイのパフォーマンスと呼んでしまう。モデルの処理時間が経過時間の大部分を占めるため、そのような「ベンチマーク」はプロバイダーとネットワークを測定しているに過ぎません。オーバーヘッドを分離しなければ、ゲートウェイについて何も測定したことにはなりません。
平均値でベンチマークを行い、それで本番にリリースしてしまう。p50の数値が素晴らしく見えても、本番環境ではp99によってエージェントのループがタイムアウトしてしまいます。エージェント処理が分岐・拡大する場合、全体の体験を決定づけるのはテールレイテンシーです。必ずp95とp99を報告してください。
並列数1でテストしてしまう。インフライトリクエストが1つの場合のオーバーヘッドは、並列数500における挙動について何も教えてくれません。レイテンシーの悪化曲線と、その屈曲点を把握することこそがテストの本来の目的です。必ず負荷を増やしてテストしてください。
キャッシュのベンチマークを忘れてしまう。キャッシングは、ゲートウェイを直接呼び出しよりも高速にする唯一の機能であり、最もスキップされがちなシナリオです。実際のヒット率におけるヒットレイテンシーと加重平均レイテンシーを測定してください。そうしないと、キャッシングによるメリットを丸ごと見落とし、ゲートウェイの価値を過小評価することになります。
再現実験をせずにベンダーの数値を鵜呑みにする。スライドに掲載されたレイテンシーの数値は、他人のモデル、リージョン、プロンプトサイズ、ガードレール設定で測定されたものです。自社のトラフィックで再現するまでは、単なるマーケティング資料に過ぎません。自らチェックリストを実行してください。
AIゲートウェイが許容できないレイテンシーを追加するという懸念が残っているのは、チームが誤った対象を測定しているからです。エンドツーエンドの経過時間はモデルの処理時間に支配されているため、ゲートウェイ自体についてはほとんど何も分かりません。オーバーヘッドを分離し、テールレイテンシーで評価すれば、状況は一変します。優れたゲートウェイが追加するレイテンシーは、すでに数秒かかっているリクエストに対してわずか数ミリ秒であり、キャッシュされたトラフィックに対しては、トークンコストを削減しながらリクエストを大幅に高速化します。
ぜひご自身でベンチマークを実行してください。チェックリストを活用し、実測値でテンプレートを埋め、並列数を上げて屈曲点を特定し、p99やキャッシュヒットレイテンシーを後回しではなく最優先のメトリクスとして計測してください。この基準をクリアするゲートウェイであれば、ルーティング、フォールバック、キャッシング、予算管理、ガードレール、リクエストごとの可観測性を、モデルの処理時間に比べれば無視できる程度のレイテンシーコストで手に入れることができます。そして、それを証明する唯一の方法は、実際のトラフィックで計測することです。
キャッシュを有効にすることで高速化するゲートウェイのベンチマークを実施しましょう。デモを予約する。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.












