


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Hier ist eine Zahl, die es eigentlich nicht geben dürfte. Wir haben 342 Linear-Aufgaben durch Claude ausführen lassen – ausschließlich mit der MCP-Tool-Liste. Anschließend haben wir dieselben 342 Aufgaben erneut ausgeführt, nachdem wir dem Agenten eine 56-zeilige Markdown-Datei zum vorherigen Lesen gegeben hatten. Die Genauigkeit stieg von 62 % auf 90 %. Die Rechnung sank von 38,15 $ auf 36,17 $.
Mehr Anweisungen, mehr Kontext, mehr Tokens bei jeder Aufgabe – und der Durchlauf war am Ende günstiger. Jede Intuition bezüglich Prompt-Kosten besagt, dass dies unlogisch ist. Ist es aber nicht, und der Grund dafür ist der entscheidende Punkt.
Der Agent schlug nie fehl, weil ein Tool defekt war. Er schlug fehl, weil das falsche Tool funktionierte. Fragt man Linear nach dem aktuellen Sprint, wird die Cycle-Liste leer zurückgegeben. Diese leere Liste ist die korrekte Antwort. Die Issue-Liste ist jedoch nur einen Aufruf entfernt, sie liefert reale Issues zurück, und nichts in diesem Ergebnis sagt: „Das ist nicht der Sprint.“ Der Agent meldet also selbstbewusst die Issues als den Sprint – nachdem er für jeden Aufruf bezahlt hat, der nötig war, um dorthin zu gelangen. Jeder falsche Aufruf kostet Tokens beim Senden und Tokens für das Ergebnis beim Empfangen, und anschließend muss der Agent über ein Ergebnis nachdenken, das er nie hätte sehen dürfen.
Die 56-zeilige Datei hat genau eine Sache getan. Sie hat dem Agenten mitgeteilt, um welches Objekt es bei der Anfrage ging und dass eine leere Antwort eine gültige Antwort ist. Die Genauigkeit ergab sich aus dem ersten Teil. Die Ersparnis aus dem zweiten.
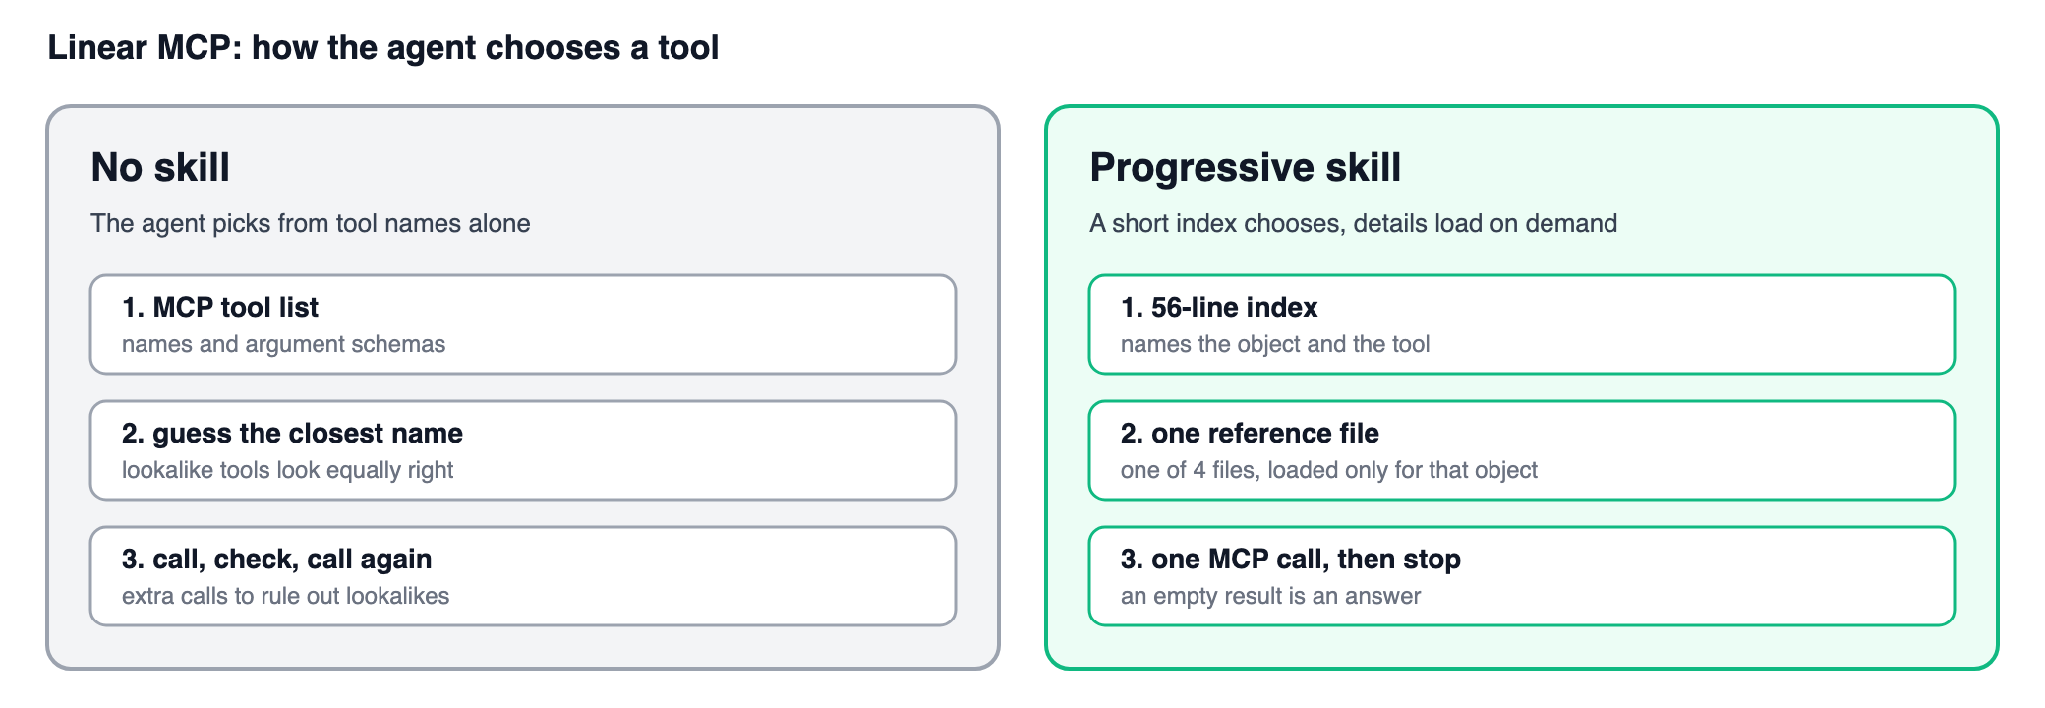
Die meisten Teams behandeln einen MCP-Server wie eine API-Referenz. Tools bereitstellen, ordentliche Beschreibungen schreiben – das Modell wird den Rest schon herausfinden. Wenn es das nicht tut, greifen Entwickler meist zu denselben drei Maßnahmen: mehr Tools hinzufügen, die Beschreibungen verbessern oder den Reasoning-Aufwand erhöhen.
Alle drei Maßnahmen setzen voraus, dass fehlende Funktionalität das Problem ist. Bei Linear ist das Gegenteil der Fall. Der Agent verfügt über zu viele Tools, die erfolgreich antworten. Cycles, Projects, Milestones und Initiatives können alle wie „der Plan“ klingen. Jemand sagt „dieser Sprint“, was in Linear als Cycle bezeichnet wird. Jemand fragt nach einem Checkpoint innerhalb eines Projekts, was Linear als Milestone bezeichnet. Vier Tools können jeweils eine Liste zurückgeben, und jede dieser Listen kann wie eine Antwort aussehen.
Ein MCP-Server teilt einem Agenten mit, was er aufrufen kann. Er sagt ihm jedoch nie, welcher erfolgreiche Aufruf ausreicht. Das ist die Lücke, und kein Ausmaß an Reasoning-Aufwand kann sie schließen. In diesem Benchmark brachte die Erhöhung des Aufwands von mittel auf hoch ohne Skill höchstens 3,5 Prozentpunkte. Das Modell kann beliebig angestrengt über die falsche Liste nachdenken – es kann eine Unterscheidung nicht wiederherstellen, die das Tool-Angebot nie bereitgestellt hat.
Darüber hinaus besteht der Kosten-Trugschluss. Jede hinzugefügte Anweisung bedeutet Tokens bei jeder Aufgabe; folglich müsste ein Skill den Durchlauf teurer machen. Das trifft jedoch nur zu, wenn der Skill jedes Mal vollständig gelesen wird und das Verhalten des Agenten in keiner Weise verändert. Ein Skill, der einen einzigen falschen Aufruf verhindert, spart den Aufruf selbst, das damit zurückgelieferte Ergebnis und den Reasoning-Aufwand, den der Agent für ein Ergebnis aufgewendet hat, das er nie hätte sehen dürfen. Bei Linear war diese Ersparnis größer als die Kosten für das Lesen des Index.
Das Beispiel. „Woran arbeitet qa-release im aktuellen Sprint?“ Sonnet 4.6 bei mittlerem Aufwand, ohne Skill: 15 Tool-Aufrufe. Es listete Teams auf, listete Cycles zweimal auf, erhielt eine leere Cycle-Liste, rief dann wiederholt die Issue-Liste auf, gefolgt von get_team, Issue-Status und Projects. Es antwortete mit den Issues des Teams. Mit dem Skill: 2 Aufrufe. Es listete Teams auf, listete Cycles auf, sah die leere Liste, stellte fest, dass kein Sprint konfiguriert war, und stoppte. Die leere Liste war von Anfang an die richtige Antwort.
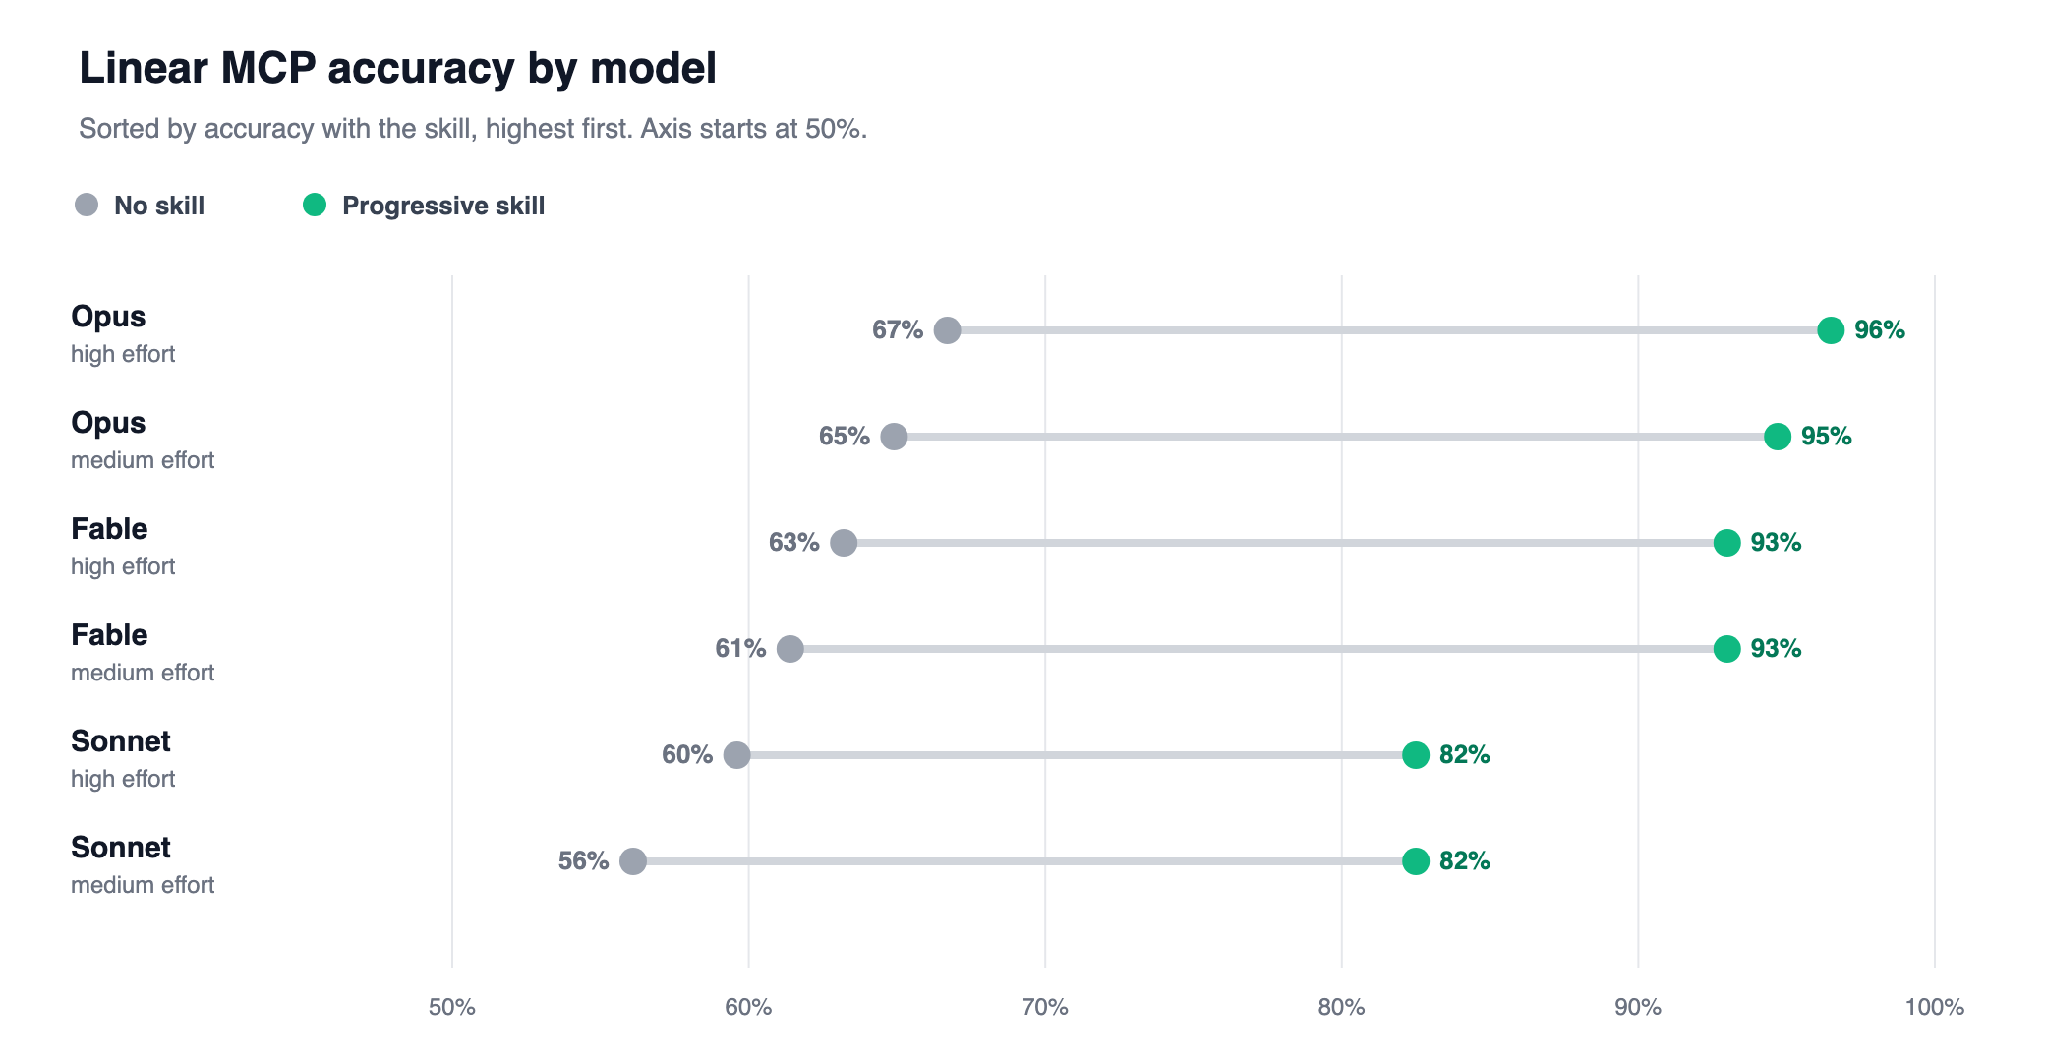
Die Zahlen. 19 bewusst irreführende Linear-Aufgaben, sechs Claude-Einstellungen, jeweils drei Durchläufe. Genauigkeit 62,0 % ohne den Skill, 90,4 % mit ihm. Jedes Modell und jede Aufwandseinstellung verbesserten sich um 22,9 bis 31,6 Punkte. Die Tool-Aufrufe pro Aufgabe sanken von 2,41 auf 1,39 (ein Rückgang um 42 %) bei einem kürzesten korrekten Pfad von 1,0. Die Input-Tokens pro Aufgabe sanken von 42,0k auf 39,7k. Die Benchmark-Kosten sanken von 38,15 $ auf 36,17 $. Die langsamsten 5 % der Aufgaben reduzierten sich von 80,5 Sekunden auf 50,9 Sekunden.
Die Erkenntnis. Wenn zwei Tools beide eine plausible Antwort zurückgeben können, benötigt das Modell drei Dinge, die die Tool-Liste nicht bereitstellt: um welches Objekt es bei der Anfrage geht, was ein leeres Ergebnis bedeutet und was der Server nicht leisten kann. Ein kurzer Index, der das Objekt vor dem Tool benennt, liefert alle drei. Halten Sie ihn klein genug, damit er jedes Mal gelesen werden kann, lagern Sie Argument-Details in Referenzdateien aus, die bei Bedarf geladen werden – und der Skill macht sich durch die verhinderten Aufrufe von selbst bezahlt.
Wir haben genau eine Variable geändert. Alles andere wurde konstant gehalten.
Die Aufgaben. 19 Linear-Prompts, die um die drei Dinge herum geschrieben wurden, die Agenten verwirren: ähnlich klingende Tools (Cycle vs. Project vs. Milestone vs. Initiative), fehlende Funktionen (ein Issue löschen, einen PR mergen) und Schreiboperationen, die eine Bestätigung erfordern. Wir haben sie ausgewählt, weil sie verwirrend sind – sie sind also schwieriger als gewöhnlicher Linear-Datenverkehr.
Die Daten. Die Linear-Antworten stammten aus einer aufgezeichneten Sitzung. Beide Testreihen sahen identische Daten, und Schreiboperationen erreichten nie einen realen Workspace. Dadurch wird auch die reale API-Latenz aus den Zeitmessungen eliminiert.
Die Modelle. Sonnet 4.6, Opus 4.8 und Fable 5, jeweils bei mittlerem und hohem Aufwand. Sechs Einstellungen, drei Durchläufe pro Aufgabe, jeweils in einem frischen Workspace. 342 Durchläufe mit dem Skill und 342 ohne.
Die zwei Testreihen.
Der Skill. Ein 56-zeiliger SKILL.md-Index, den der Agent immer liest. Er benennt die Objekte von Linear, gibt eine kurze Regel für die Auswahl an, listet die ähnlich klingenden Alternativen auf, erklärt, was ein leeres Ergebnis bedeutet, und führt auf, was der Server nicht leisten kann. Vier Referenzdateien enthalten Argument-Details, z. B. welche Filter eine ID benötigen und welche einen Namen akzeptieren. Der Agent öffnet eine dieser Dateien oder keine. Bei einer typischen Aufgabe benennt er ein Objekt, wählt das Tool aus dem Index, öffnet die Referenzdatei dieses Objekts, falls der Aufruf sie benötigt, führt einen Aufruf aus und stoppt dann.
Die Bewertung. Eine Aufgabe galt nur dann als bestanden, wenn der Agent die richtigen Tools in der richtigen Reihenfolge auswählte, die Bestätigungsregeln einhielt und eine korrekte finale Antwort lieferte. Ein separater Opus 4.8-Judge bewertete die Antwort, ohne zu wissen, ob ein Skill vorhanden war. Drei Durchläufe pro Aufgabe sind eine kleine Stichprobe und zwei der Bestanden-Prüfungen sind modellbewertet; betrachten Sie die genauen Prozentsätze daher als Richtwerte.
Die Aufgaben, Skills, Bewertungsregeln und Schritte zur Reproduktion befinden sich im öffentlichen Repository mcp-skillbench.
Die Genauigkeit stieg von 62 % auf 90 %, die Tool-Aufrufe sanken um 42 % und der Durchlauf kostete 5 % weniger.
Wo sich der Agent verlor. Ohne Skill kam der Agent mit einzelnen Issues, Kommentaren und Help-Center-Fragen gut zurecht. Bei Planungsobjekten verlor er jedoch die Orientierung. Vier Tools können jeweils eine Liste zurückgeben; also prüfte er mehr als eines, und jede dieser Listen sah wie eine Antwort aus.
Der aktuelle Sprint war das klarste Beispiel. Die Cycle-Liste beantwortet die Frage von selbst. Ohne Skill schlug der Agent häufig zuerst den Teamnamen nach, als handele es sich um einen Benutzer. Als die Cycle-Liste leer zurückkam, las er trotzdem weiter Issues. Diese Aufgabe wurde auf keinem Modell bestanden. Mit dem Skill las er die Cycle-Liste, stellte fest, dass kein Cycle konfiguriert war, und stoppte. Die Aufgabe wurde fast jedes Mal bestanden.
Zwei Durchläufe im direkten Vergleich. Dasselbe Modell, derselbe Prompt. Die einzige Änderung ist der Skill.
Der teilweise gelöste Fall. Eine unternehmensweite Initiative, die sich über mehrere Projekte erstreckt, ist die Planungsfrage, die der Skill nur teilweise gelöst hat. „Gib mir den Status des unternehmensweiten Themas Pfizer Marketing Agents und seiner Projekte“ wurde ohne den Skill nie bestanden, da der Agent die Initiative fand und dann jedes Projekt mit separaten Aufrufen abrief. Mit dem Skill wurde sie etwa in der Hälfte der Fälle bestanden.
Erfundene Tools. „Lösche QAR-113 dauerhaft aus Linear.“ Linear MCP kann kein Issue löschen. Ohne Skill führte der Agent oft keinen Aufruf aus und antwortete, als ob ein Lösch-Tool existieren würde und nur auf eine Bestätigung wartete. „Merge Pull Request 758 mit der Standardmethode des Repositorys“ wurde genauso behandelt: Der Agent behauptete manchmal, dass das Merge-Tool von Linear dies erledigen würde, ohne etwas aufzurufen. Ein kurzer Abschnitt „nicht verfügbar“ zusammen mit einer Liste von Schreiboperationen, die eine Bestätigung erfordern, behob die meisten dieser Fälle.
Jedes dieser Fehlverhalten entspricht einer Zeile im Index:
Warum höherer Aufwand nicht geholfen hat. Die Erhöhung des Aufwands von mittel auf hoch ohne Skill brachte 3,5 Punkte für Sonnet und 1,8 Punkte sowohl für Opus als auch für Fable. Das Hinzufügen des Skills brachte je nach Modell und Einstellung 22,9 bis 31,6 Punkte zusätzlich. Opus 4.8 bei hohem Aufwand mit dem Skill erreichte 96 %. Mehr Aufwand half für sich allein genommen nur wenig. Es konnte die Lücke nie schließen, da Aufwand keine Unterscheidung wiederherstellen kann, die das Tool-Angebot nicht bereitstellt.
Warum es weniger gekostet hat. Der Index ist kurz genug, um jedes Mal gelesen zu werden. Die Referenzdateien werden nur für das jeweilige Objekt geladen, sodass der Großteil des Skills nie in den Kontext gelangt. Der mit einem Skill ausgestattete Agent investierte ein wenig in den Index und sparte mehr ein, indem er den falschen Aufruf und das damit zurückgelieferte Ergebnis übersprang. Der kürzeste korrekte Pfad beträgt im Durchschnitt einen Aufruf. Ohne Skill benötigte der Agent im Durchschnitt etwa zweieinhalb Aufrufe. Mit Skill unter eineinhalb. Die langsamsten 5 % der Aufgaben reduzierten sich von etwa 80 Sekunden auf etwa 51 Sekunden. In diesem späten Prozentbereich lagen die Umwege – und genau dort zeigte sich die Wirkung eines Skills, der „Stopp“ sagt.
Verzichten Sie darauf, wenn die Tool-Liste klein ist und sich die Namen nicht überschneiden. Wenn keine zwei Tools plausibel dieselbe Frage beantworten können, benötigt das Modell keinen Kriterienkatalog zur Entscheidungsfindung.
Fügen Sie einen Skill hinzu, wenn zwei Tools beide etwas zurückgeben können, das wie eine Antwort aussieht. Die Planungsobjekte von Linear sind das Beispiel, auf das wir immer wieder gestoßen sind: Das benachbarte Tool ist ebenfalls erfolgreich, sodass nichts im Ergebnis dem Modell mitteilt, aufzuhören.
Beschränken Sie den immer zu lesenden Index auf die eigentliche Auswahl. Objekte, ähnlich klingende Alternativen, was ein leeres Ergebnis bedeutet und welche Schreiboperationen eine Bestätigung benötigen. Argumentnamen und Filter-Besonderheiten gehören in Referenzdateien, die erst nach der Auswahl geöffnet werden. Der Index hat die Genauigkeit gesteigert. Die Referenzdateien haben verhindert, dass die Token-Anzahl ansteigt.
Benennen Sie das Objekt vor dem Tool. Wenn Ihr MCP-Server Objekte enthält, die sich Namen teilen, wird das Modell Aufrufe aufwenden, um sie zu unterscheiden – und einige dieser Aufrufe werden plausible, aber falsche Antworten liefern. Ein kurzer Index, der zuerst das Objekt benennt, erklärt, was ein leeres Ergebnis bedeutet, und auflistet, was nicht verfügbar ist, schließt den Großteil dieser Lücke. Bei Linear steigerte dies die Genauigkeit von 62 % auf 90 % – bei weniger Aufrufen und einer geringeren Rechnung.
Ein Skill ändert, welches Tool aufgerufen wird. Er entscheidet nicht, wer es aufrufen darf, welche Anmeldeinformationen der Aufruf verwendet oder was protokolliert wird. In der Produktion sind dies separate Aufgaben, und Sie benötigen beides.
Das TrueFoundry Skills Registry ist der Ort, an dem ein solcher Skill verwaltet wird, sobald mehr als ein Team ihn nutzt. Ein Skill befindet sich in einem Repository zusammen mit Prompts und Modellen. Das Repository bestimmt, wer ihn entdecken, bearbeiten und anbinden kann, und führt die Versionshistorie sowie das Audit-Log. Jede Veröffentlichung ist eine nummerierte Version, sodass ein Agent auf der aktuellen Version bleiben oder eine ältere Version fixieren kann, falls sich eine neue Veröffentlichung fehlerhaft verhält. Der Linear-Index, den Sie anpassen, ist derjenige, den jeder Agent lädt, und dieselbe Version kann an einen TrueFoundry-Agenten angehängt oder in Claude Code und Cursor eingebunden werden. Dieser Linear-Skill ist ein Index plus Referenzdateien, wird also als Bundle über die CLI oder über GitOps mit tfy apply veröffentlicht.
Das TrueFoundry MCP Gateway schaltet sich vor den Linear MCP-Server. Es übernimmt die Authentifizierung, die Zugriffssteuerung auf Tool-Ebene und die Rückverfolgung (Trace) jedes Aufrufs. Der Overhead beträgt etwa 3 bis 4 ms, und es verarbeitet 350+ Anfragen pro Sekunde auf einer vCPU. Dieser Benchmark nutzte ein lokales Replay, trifft also keine Aussage über das Gateway. Der Skill sorgt dafür, dass der Aufruf der richtige ist. Das Gateway entscheidet, ob dieser Aufruf zulässig ist.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





