


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Das Model Context Protocol hat sich 2026 schneller entwickelt, als die meisten Teams verfolgen konnten. Die Spezifikation vom 28.07.2026 — die erste große Überarbeitung nach dem Release im November 2025 — hat nicht nur ein Feature hinzugefügt; sie hat das Protokoll grundlegend umgestaltet. Autorisierung, Transport, Routing und Interaktion haben sich geändert, und mehrere weit verbreitete Bausteine wurden mit einer festen Deaktivierungsfrist als veraltet markiert.
Wenn Sie eine Handvoll MCP-Server direkt mit einem Agent verkabelt haben, können Sie das Changelog lesen und in Ihrem eigenen Tempo migrieren. Wenn Sie MCP über viele Teams, viele Server und viele Agents hinweg betreiben, sind diese Änderungen kein bloßer Changelog-Eintrag — sie sind ein Migrationsprojekt, und diejenigen, die Transport und Routing betreffen, werden jeden von Ihnen betriebenen Client erreichen. Dieser Beitrag führt durch die tatsächlichen Änderungen, warum jede Änderung vorgenommen wurde und was sie für jeden bedeutet, der MCP im großen Maßstab betreibt. Für die grundlegenden Konzepte ist unser Leitfaden dazu, was ein MCP Gateway ist, der richtige Ausgangspunkt; dieser Artikel setzt voraus, dass Sie die Struktur des Protokolls bereits kennen, und konzentriert sich darauf, was die neue Überarbeitung ändert und behebt.
Möchten Sie den neuen MCP-Transport, die Authentifizierung und das Routing an einem einzigen Kontrollpunkt verwalten lassen, anstatt auf jedem einzelnen Client? Buchen Sie eine Demo.
Fünf Änderungen tragen fast das gesamte betriebliche Gewicht. Alles andere in diesem Release ist diesen nachgelagert.
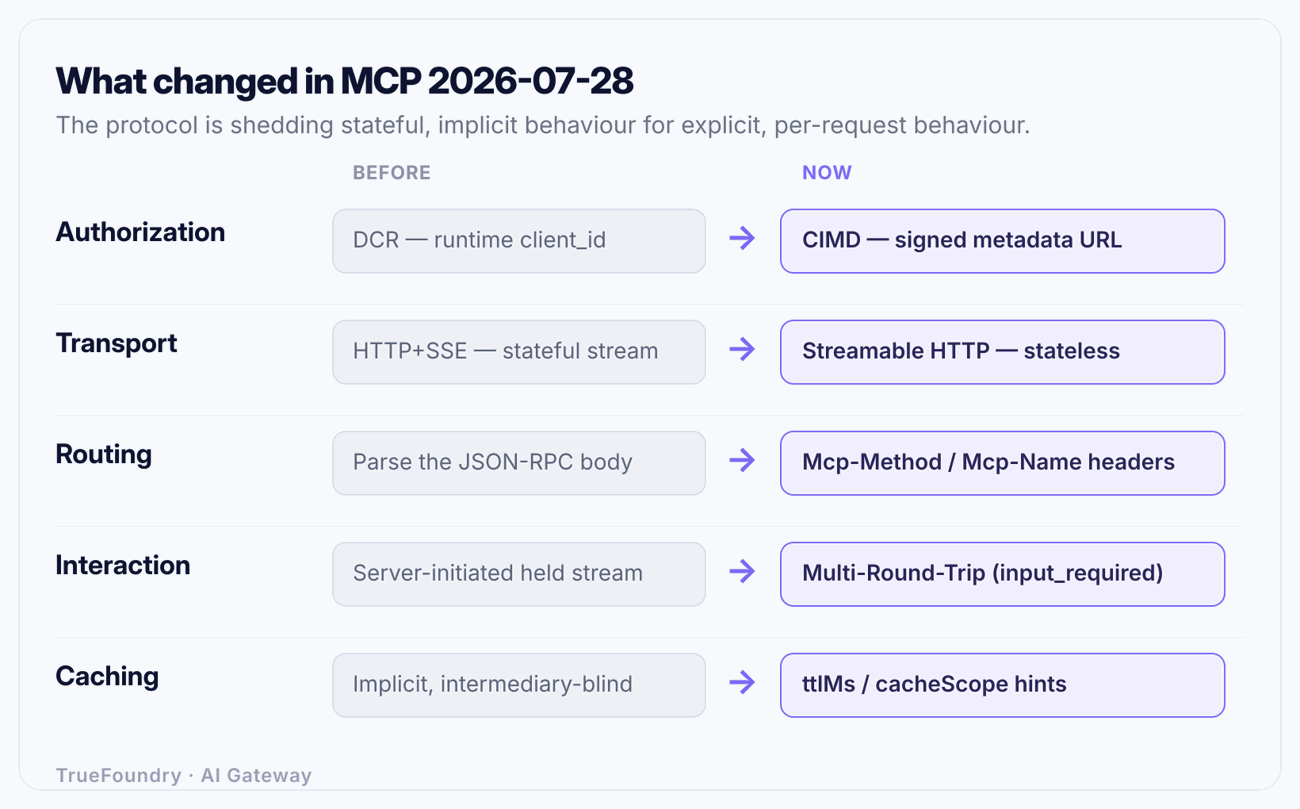
Das Muster ist konsistent: Das Protokoll legt zustandsbehaftetes, verbindungsorientiertes und implizites Verhalten ab und ersetzt es durch explizites, anfragespezifisches und im Header sichtbares Verhalten. Dieser Wandel macht die neue Überarbeitung freundlicher für Gateways, Proxies und Rate Limiter — und anspruchsvoller für Clients, die von einer langlebigen Session ausgegangen sind.
Dynamic Client Registration ermöglichte es einem Client, sich zur Laufzeit selbst bei einem Autorisierungsserver zu registrieren und eine client_id zu generieren. Das war bequem, aber problematisch: Jeder Client, der auftauchte, erhielt eine Registrierung, was zu einer unbegrenzten, schwer zu steuernden Population von Identitäten führte — und zu einem Registrierungsendpunkt, der ein dauerhaftes Angriffsziel darstellte.
Die Überarbeitung vom 28.07.2026 stuft DCR zugunsten von Client ID Metadata Documents (CIMD) als veraltet ein. Anstatt sich zu registrieren, um eine Kennung zu erhalten, wird ein Client durch eine URL identifiziert, die zu einem signierten Metadaten-Dokument führt, das ihn beschreibt. Der Autorisierungsserver ruft dieses Dokument ab und validiert es, anstatt eine Registrierung zu speichern. Die Identität des Clients ist nun etwas, das der Server bei Bedarf über eine vom Client kontrollierte Quelle überprüfen kann, anstatt einer Zeile, die der Server bereitstellen und verwalten muss.
Drei zusammenhängende Härtungsmaßnahmen werden zusammen damit ausgeliefert:
iss zurück, und Clients müssen diesen validieren, bevor sie einen Autorisierungscode einlösen. Dies schließt eine langjährige Lücke bei Verwechslungen von Autorisierungsserver-Endpunkten.application_type, damit Server das Ablehnen von localhost Redirects für legitime Desktop- und CLI-Tools einstellen.Hier gibt es eine wichtige Besonderheit: Das serverseitige Abrufen einer vom Client kontrollierten URL ist per Definition eine serverseitige Anfrage an eine vom Angreifer beeinflussbare Adresse. CIMD tauscht einen Registrierungsendpunkt gegen eine SSRF-Schwachstelle ein. Jeder, der dies implementiert, muss diesen Metadaten-Abruf mit der gleichen Sorgfalt behandeln wie jede andere ausgehende Anfrage aus dem Inneren der Vertrauensgrenze. Unsere eingehendere Betrachtung dieser Fehlermodi finden Sie unter MCP-Sicherheitsrisiken und Best Practices, und die Mechanik der Agent-to-Server-Auth wird in MCP-Authentifizierung erklärt behandelt.
Die praktische Erkenntnis: Bauen Sie keine neuen Integrationen auf DCR auf. Es ist veraltet, wird entfernt werden, und die Nachfolgelösung lässt sich besser steuern. Wenn Sie sich bereits darauf verlassen, haben Sie mindestens bis Juli 2027 Zeit — aber die Migration ist eine Frage des Wann, nicht des Ob.
Der alte HTTP+SSE-Transport ist offiziell veraltet mit einem einjährigen Migrationsfenster. Sein Ersatz, Streamable HTTP, ist von Grund auf zustandslos konzipiert, und dieses eine Wort hat große Konsequenzen.
Unter dem neuen Transport gibt es keinen initialize / initialized Handshake und keine Mcp-Session-Id. Jede Anfrage beschreibt sich selbst: Die Protokollversion, die Identität des Clients und seine Capabilities werden in einem _meta Block pro Anfrage übertragen, und ein optionaler server/discover Aufruf ermöglicht es einem Server, seine Capabilities vorab anzukündigen. Da jede Anfrage für sich allein steht, kann jede Server-Instanz jede Anfrage bedienen. So stehen Server hinter einem gewöhnlichen Round-Robin Load Balancer und skalieren horizontal ohne Sticky Sessions.
Der Preis der Zustandslosigkeit ist, dass verlorene in-flight Anfragen nicht wiederaufgenommen werden. Es gibt keinen Stream, zu dem man die Verbindung wiederherstellen könnte. Ein Client, der eine Anfrage verliert, muss sie mit einer neuen ID erneut senden. Das bedeutet, dass langlaufende Tools idempotent sein müssen oder ein dauerhaftes Handle zurückgeben müssen, das der Client abfragen kann. Übergreifender Zustand verschwindet nicht — er muss nur explizit gemacht werden, typischerweise als vom Server ausgestelltes Handle, das als Tool-Argument übergeben und durch gemeinsamen Speicher mit Ablaufdatum abgesichert wird. Das Aufgeben von Sessions auf Protokollebene macht Ihre Anwendung nicht zustandslos; es verlagert die Verantwortung für den Zustand vom Transport auf Sie.
Dies ist die Änderung, die am ehesten jeden von Ihnen betriebenen Client erreichen wird, da sie das Protokoll selbst betrifft. Wenn Ihre Agents jeweils eigene MCP-Verbindungen öffnen, benötigt jeder einzelne von ihnen den neuen Transport. Wenn sie über ein Gateway laufen, terminiert das Gateway den Transport einmal, und Ihre Agents sprechen weiterhin mit einem einzigen stabilen Endpunkt — was das Hauptargument dafür ist, Agents nicht direkt auf Server zugreifen zu lassen, wie in unserem Artikel über das Hosting von Remote-MCP-Servern beschrieben.
Die Änderung mit dem größten Hebel für jeden Infrastrukturbetreiber ist die unaufgeregteste im Changelog. Streamable HTTP erfordert nun Mcp-Methodbei jeder Anfrage sowie Mcp-Namebeitools/call,resources/readundprompts/get. Ein Tool-Parameter kann zusätzlich mit x-mcp-header markiert werden, und konforme Clients spiegeln dieses Argument in einem Mcp-Param-{Name} Header wider — das klassische Beispiel ist ein region Parameter, der zu einem Routing-Header aufgewertet wird.
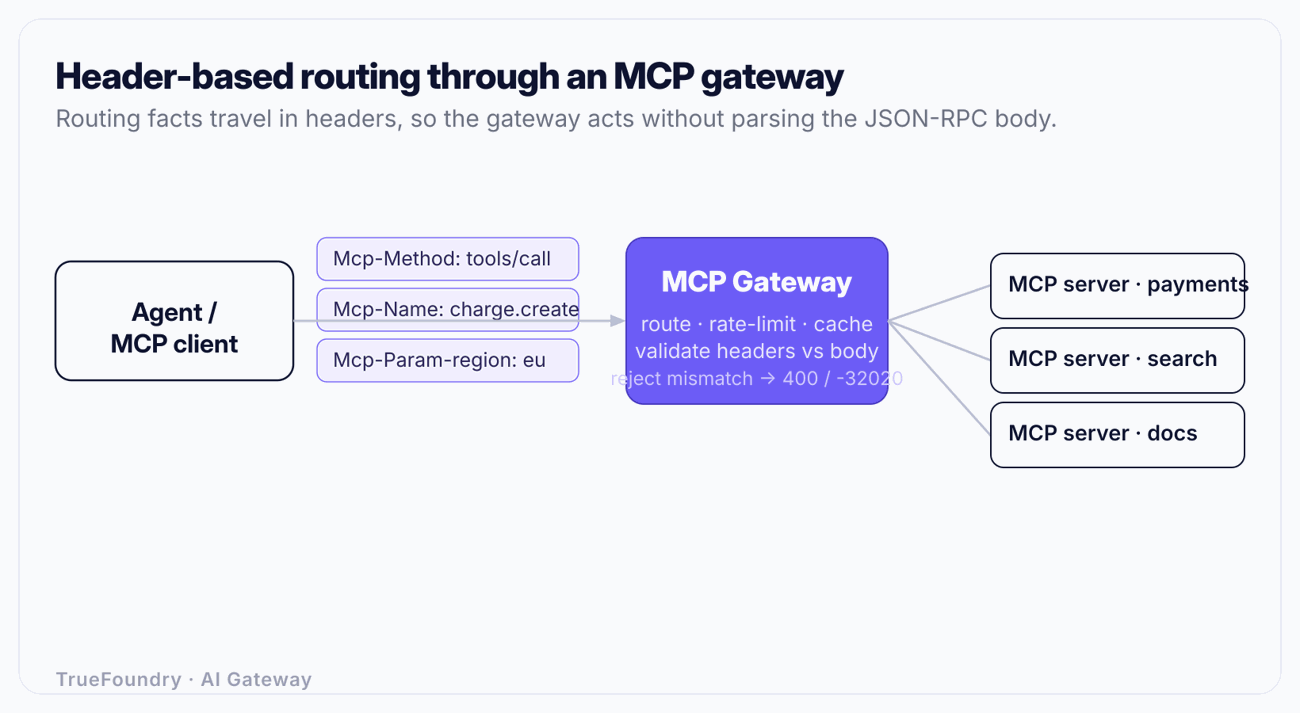
Zuvor musste eine Zwischeninstanz, die nach Tools routen oder Rate-Limiting anwenden wollte, den JSON-RPC-Body jeder Anfrage öffnen und parsen. Jetzt befinden sich die routingrelevanten Fakten in den Headern, wo ein Gateway, ein Load Balancer oder eine WAF sie kostengünstig lesen und verarbeiten kann, ohne den Payload zu verstehen. Sie können tools/call für ein rechenintensives Tool an einen dedizierten Pool senden, ein bestimmtes Tool namentlich drosseln oder den Traffic eines Mandanten über einen region Header routen — alles direkt an der Edge.
Es gibt eine Regel, die nicht übersprungen werden darf: Header und Body müssen übereinstimmen. Ein Server, der den Body verarbeitet, muss verifizieren, dass die Header damit übereinstimmen, und Abweichungen mit einem 400 und dem Fehlercode -32020 ablehnen. Jede Zwischeninstanz, die einen Body umschreibt, muss auch die Header umschreiben (oder beides unterlassen) — und ein Gateway sollte einem Header erst vertrauen, nachdem es ihn gegen den Body validiert hat. Header-basiertes Routing ist genau deshalb so mächtig, weil ihm früh im Anfragepfad vertraut wird, weshalb es genau dort validiert werden muss.
Erfahren Sie, wie das TrueFoundry MCP Gateway Spezifikationsänderungen abfängt, damit Ihre Agents dies nicht tun müssen. Buchen Sie eine Demo.
Bisher führte ein Server, der während eines Aufrufs Eingaben benötigte — eine Elicitation, eine Sampling-Anfrage, ein Aufflisten von Roots —, dies über einen offen gehaltenen Stream aus. In einer zustandslosen Welt gibt es keinen offen gehaltenen Stream mehr. Daher ersetzt die Überarbeitung vom 28.07.2026 diese vom Server initiierten Aufrufe durch Multi-Round-Trip Requests (MRTR). Der Server gibt ein Ergebnis vom Typ input_required zurück, das beschreibt, was er benötigt; der Client antwortet, indem er den ursprünglichen Aufruf erneut versucht — mit den Antworten in inputResponses und einem requestState Blob, der es dem Server ermöglicht, fortzufahren.
Da der erneute Versuch auf einer anderen Server-Instanz landen kann, muss der Wiederaufnahme-Pfad auf diese Weise getestet werden. Alle Nebenwirkungen, die vor dem Einholen der Eingabe ausgeführt wurden, erfordern eine Abstimmung — MCP bietet keine Exactly-Once-Garantie. Davon getrennt sind Roots, Sampling und Logging als veraltet markiert (funktional für mindestens zwölf Monate, Entfernung nicht vor Juli 2027), Tasks wurden in eine Erweiterung verschoben mit einem Poll-basierten Modell, und List/Read-Antworten tragen nunttlMsundcacheScopeHinweise, damit Zwischeninstanzen sicher cachen können. Dieser Caching-Hinweis birgt jedoch eine Falle, die weiter unten behandelt wird.
Das Release formalisiert auch ein Extensions-Framework, und dasjenige, das für Produktteams am ehesten von Bedeutung ist, ist MCP Apps (io.modelcontextprotocol/ui) — interaktive UI-Oberflächen, die von fähigen Hosts gerendert werden. Bisher lieferte ein MCP-Server Text und strukturierte Daten zurück; mit MCP Apps kann er eine interaktive Oberfläche zurückgeben, die ein unterstützender Host inline rendert, wodurch ein Tool-Aufruf zu etwas wird, das einer eingebetteten Mini-Anwendung ähnelt.
Das ist eine wirklich neue Funktion und eine völlig neue Governance-Fläche. Ein Server, der UIs liefern kann, kann Benutzeroberflächen bereitstellen, die nach Anmeldeinformationen fragen, eine Bestätigung irreführend darstellen oder Inhalte rendern, die der Host nicht erwartet hat — daher muss dieselbe Prüfschärfe, die Sie auf die Tools eines Servers anwenden, nun auch auf alles angewendet werden, was er rendern kann. MCP Apps ist eine Erweiterung, deren Reifegrad getrennt von der Kernspezifikation verfolgt wird, und die Host-Unterstützung ist uneinheitlich; behandeln Sie sie daher als im Entstehen begriffen und noch nicht als gefestigt. Der Punkt für ein Plattform-Team ist einfacher: Die Angriffs- und Richtlinienfläche eines „MCP-Servers“ ist gerade gewachsen, und welche Überprüfungen und Positivlisten Sie auch immer auf Tools anwenden, sie sollten bereit sein, auch auf Apps angewendet zu werden.
Zusammengenommen weisen die Änderungen vom 28.07.2026 in eine Richtung: Das Protokoll wird zu etwas, das eine Zwischeninstanz sauber steuern kann. Zustandslose Anfragen, im Header sichtbare Routing-Fakten, explizite Cache-Hinweise und verifizierbare Client-Identitäten lassen sich an einem Kontrollpunkt alle einfacher durchsetzen als noch vor einem Jahr. Das ist das Argument dafür, ein Gateway zwischen Ihre Agents und Ihre MCP-Server zu schalten, anstatt sie direkt miteinander zu verkabeln.
Ein Gateway ist der Ort, an dem der neue Transport einmalig terminiert wird, an dem die CIMD-basierte Authentifizierung einmalig validiert wird, an dem Mcp-Name Routing und Rate Limits pro Tool durchgesetzt werden und an dem das Register darüber, welche Server existieren und wer sie erreichen darf, tatsächlich angesiedelt ist. Wenn die Spezifikation erneut überarbeitet wird — und das wird sie —, ändern sich die auf das Gateway ausgerichteten Clients nicht; das Gateway ändert sich. Das MCP Gateway von TrueFoundry ist genau um diesen Kontrollpunkt herum aufgebaut, und das Governance-Modell ist in Enterprise MCP Governance sowie in der Produktdokumentation detailliert beschrieben.

Wenn Sie ein zentrales MCP Gateway gegen die Verwaltung eigener Server durch jedes einzelne Team abwägen, werden die Vor- und Nachteile in unserem Vergleich der besten MCP Gateways dargestellt. Die Frage Protokoll vs. Protokoll, wo MCP aufhört und das Messaging von Agent zu Agent beginnt, wird in MCP vs A2A behandelt.
Sie übernehmen veraltete Primitiven in neuen Code. DCR, Roots, Sampling und Logging funktionieren alle noch, daher wirken sie sicher für die Entwicklung. Sie unterliegen jedoch einer Deaktivierungsfrist. Neue Integrationen sollten sie als unzulässig behandeln.
Sie vertrauen Headern, die sie nie validiert haben. Header-basiertes Routing funktioniert nur, weil Header vor dem Body gelesen werden. Ein Gateway, das nach Mcp-Name routet, ohne es gegen den Body zu prüfen — und Abweichungen nicht mit 400 / -32020 ablehnt —, hat einen Routing-Bypass gebaut, keine Routing-Schicht.
Sie markieren Mandantendaten fälschlicherweise als cachebar mitpublic. Der neue Hinweis cacheScope ist nützlich und gefährlich zugleich. Ein prinzipal- oder mandantenspezifisches Ergebnis, das als public markiert ist, kann von einer Zwischeninstanz an den falschen Autorisierungskontext geliefert werden. Mandantenbezogene Antworten dürfen niemals public sein.
Sie nehmen an, zustandslos bedeute keinen Zustand. Die Zustandslosigkeit hat sich im Stack nach oben verlagert, sie ist nicht verschwunden. Wenn ein Tool über einen aufrufübergreifenden Zustand verfügte, benötigt dieser Zustand nun ein explizites Handle und dauerhaften Speicher — andernfalls schlägt er stillschweigend fehl, wenn ein erneuter Versuch auf einer anderen Instanz landet.
Sie migrieren pro Client statt an der Edge. Den neuen Transport manuell für jeden Agent, jedes SDK und jedes Skript auszurollen, ist der langsame, fehleranfällige Weg. Ihn einmalig an einem Gateway zu terminieren, ist der schnelle.
Die Reihenfolge, die Ausfälle minimiert, lautet ungefähr: Veraltete Funktionen stoppen, die Transportschicht umstellen und anschließend das neue Routing nutzen.
Die Spezifikation vom 28.07.2026 ist kein einfaches Feature-Update; sie ist eine grundlegende Überarbeitung. DCR weicht CIMD, HTTP+SSE weicht einem zustandslosen Streamable HTTP, das Routing verlagert sich in Header, Elicitation wird zu Multi-Round-Trip und Server erhalten die Möglichkeit, UIs auszuliefern. Jede Änderung für sich ist sinnvoll, und zusammen bewegen sie MCP hin zu etwas, das eine Zwischeninstanz sauber steuern kann — vorausgesetzt, jemand betreibt diese Zwischeninstanz.
Das ist die stille Erkenntnis des gesamten Releases. Die Spezifikation steuert auf eine Welt zu, in der ein Kontrollpunkt vor Ihren MCP-Servern kein optionaler Luxus ist, sondern der natürliche Ort für Transport-, Auth-, Routing- und Caching-Richtlinien. Richten Sie diesen Kontrollpunkt einmal ein, und die nächste Überarbeitung ist eine Konfigurationsänderung statt einer flottenweiten Migration.
Schalten Sie einen Kontrollpunkt vor Ihre MCP-Server, bevor die nächste Spezifikationsüberarbeitung erscheint. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





