


November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: November 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die Frage „Welches Modell ist das beste?“ ist die falsche Frage – und sie kostet Teams schleichend viel Geld. Die ehrliche Antwort lautet: Ein Frontier-Modell ist ein Werkzeug mit einem Preisschild, und das richtige Werkzeug hängt davon ab, was Sie damit tun möchten. Eine Aufgabe zur Klassifizierung von Produktbewertungen an ein Top-Tier-Reasoning-Modell zu senden, ist so, als würde man einen Kran mieten, um einen Bilderrahmen aufzuhängen. Es funktioniert. Es kostet aber auch 40-mal mehr als nötig und ist langsamer.
Bis Ende 2026 hat sich das Feld der Frontier-Modelle in verschiedene Leistungsklassen (Tiers) aufgefächert. Jeder große Anbieter bietet mindestens drei Modelle an: ein auf komplexes Reasoning ausgerichtetes Flaggschiff, ein auf Preis und Durchsatz optimiertes Mid-Tier-Arbeitspferd und ein kleines Modell, das auf hohe Geschwindigkeit und minimale Kosten ausgelegt ist. Die interessanten Entscheidungen lauten nicht mehr „OpenAI oder Anthropic“, sondern „Welches Tier für welche Anfrage, zu welchen Kosten und mit welchem Fallback?“. Das ist ein Routing-Problem, und Routing-Probleme werden durch Richtlinien gelöst, nicht durch Markentreue.
Dieser Beitrag verfolgt zwei Ziele: Erstens bietet er einen Überblick nach Anbietern, geordnet nach den tatsächlichen Stärken der jeweiligen Modelle. Zweitens stellt er einen Entscheidungsrahmen vor, der Ihre Aufgabentypen einem Modell-Tier sowie einer Kostenstruktur zuordnet und zeigt, wie Sie diesen Rahmen mit einem AI Gateway umsetzen können, ohne Ihre App bei jedem neuen Release eines Anbieters umschreiben zu müssen.
Möchten Sie jede Anfrage nach Aufgabe und Kosten an das richtige Modell routen? Buchen Sie eine Demo.
Benchmarks messen ein Modell anhand eines festen Tests. Ihr Produktions-Traffic ist jedoch kein fester Test, sondern ein Mix: eine Flut günstiger, repetitiver Aufrufe (Rechnungsnummer extrahieren, Ticket klassifizieren, entscheiden, welcher nachgelagerte Prompt ausgeführt wird) und ein kleiner Strom von wirklich komplexen Anfragen (Debugging einer Race Condition über fünf Dateien hinweg, Reasoning über einen 200-seitigen Vertrag). Ein einzelnes „bestes“ Modell muss preislich und kapazitätsmäßig für die komplexen Anfragen dimensioniert werden – wodurch Sie bei der Masse an einfachen Anfragen deutlich zu viel bezahlen.
Drei Faktoren machen ein Denken in einzelnen Modellen teuer:
Der Ausweg besteht darin, die Modellauswahl als Konfiguration zu behandeln. Definieren Sie die Richtlinie einmal („Extraktion geht an das günstige Tier, Coding an das Mid-Tier, komplexes Reasoning wird an ein Flaggschiff eskaliert und bei Fehlern greift ein Fallback auf einen zweiten Anbieter“), bilden Sie diese an einem Gateway ab und ändern Sie sie, ohne Code bereitzustellen. Details zur Funktionsweise finden Sie unter Was ist ein LLM Router? und Kosten- und qualitätsbewusste Modellauswahl.
Die einzigen nachfolgenden Zahlen, die direkt vom Hersteller bestätigt wurden, sind die von Claude. Alle anderen Angaben stammen aus Drittanbieter-Berichten mit Stand November 2026 und sollten auf den jeweiligen Preis- und Modellseiten der Anbieter überprüft werden, bevor Sie sich darauf verlassen. Modellspezifikationen ändern sich häufig.
Claudes Aufstellung Ende 2026 basiert auf einem Kontextfenster von 1 Mio. Token mit 128K Output und einem Trainings-Cutoff von Juni 2026. Die Leistungsklassen sind klar strukturiert:
Das nützliche Muster hierbei ist die Dreiteilung: ein nahezu kostenloses kleines Modell, ein ausgewogenes Arbeitspferd und ein Premium-Modell für agentische Aufgaben. Auf diesen drei Rollen lässt sich nahezu jede Routing-Richtlinie aufbauen.
Die GPT-6-Generation von OpenAI folgt Berichten zufolge derselben Aufteilung. GPT-6 Astra wird mit 10 $ / 50 $ angegeben und ist für High-End-Reasoning positioniert. GPT-6.1 Sol wird mit 2 $ / 10 $ angegeben und als leistungsfähigstes Coding- und Forschungsmodell der Familie beschrieben, mit einem berichteten Coding Index von etwa 54. GPT-6.1 Terra, angegeben mit 1 $ / 5 $ und veröffentlicht um den 26. Oktober 2026, wird mit etwa 1,05 Mio. Kontext und einem Coding Index nahe 48 beschrieben. Damit bietet es zu etwa dem halben Preis von Sol einen Großteil von dessen Coding-Fähigkeiten. GPT-6 Luna, angegeben mit 0,10 $ / 0,50 $, ist das Modell für hochvolumige Klassifizierungs- und Routing-Aufgaben mit einem berichteten Coding Index von etwa 31.
Betrachten Sie diese Coding-Index-Werte als Richtwerte und nicht als präzise Messgrößen. Sie stammen aus Aggregationen von Drittanbietern und können variieren.
Googles Portfolio lässt sich am schwersten exakt bestimmen, da die Berichte unterschiedlich ausfallen. Gemini 3.1 Pro wird mit 2 $ / 12 $ angegeben und zielt auf anspruchsvollstes Reasoning ab. Gemini 3.6 Flash wird mit 1,50 $ / 7,50 $ angegeben (Veröffentlichung um Juli 2026) und bietet ein 1M-Kontextfenster, einen berichteten Intelligence Index nahe 50, SWE-Bench Pro bei etwa 58,7 % sowie einen Durchsatz von ca. 280 Token pro Sekunde. Damit positioniert es sich als leistungsfähiges, aber günstiges Coding-Arbeitspferd. Gemini 3.1 Flash-Lite wird mit etwa 0,25 $ / 1,50 $ für das unterste Tier angegeben. Falls 3.6 Flash in Ihrem Account nicht verfügbar ist, stellt das allgemein zugängliche Gemini 3.5 Flash den sicheren Fallback dar.
Die Versionierung von Grok ist dynamisch. Grok 4.3 mit etwa 1,25 $ / 2,50 $ ist die am häufigsten genannte Konfiguration; bemerkenswert ist hierbei der niedrige Output-Preis. Neuere Versionen wie Grok 4.6 und Grok 5 werden zwar erwähnt, sind jedoch noch nicht gefestigt. Betrachten Sie den Versionsstand als vorläufig und überprüfen Sie die Angaben direkt bei xAI, bevor Sie Produktions-Traffic darauf routen.
Für Teams, die Modelle selbst hosten oder Kosten minimieren möchten: Meta Llama 4 Maverick wird mit etwa 0,20 $ / 0,60 $ und Scout mit etwa 0,11 $ / 0,34 $ angegeben – beide sind Open-Weight und self-hostbar. DeepSeek V4 wird im Bereich von etwa 0,22 $ bis 0,66 $ angesiedelt und ist auf kosteneffizientes Reasoning und Coding ausgelegt. Mistral Large 3 wird bei etwa 0,50 $ / 1,50 $ eingeordnet. Diese Optionen sind besonders relevant, wenn Datenresidenz oder rein wirtschaftliche Stückkosten die Entscheidung bestimmen.
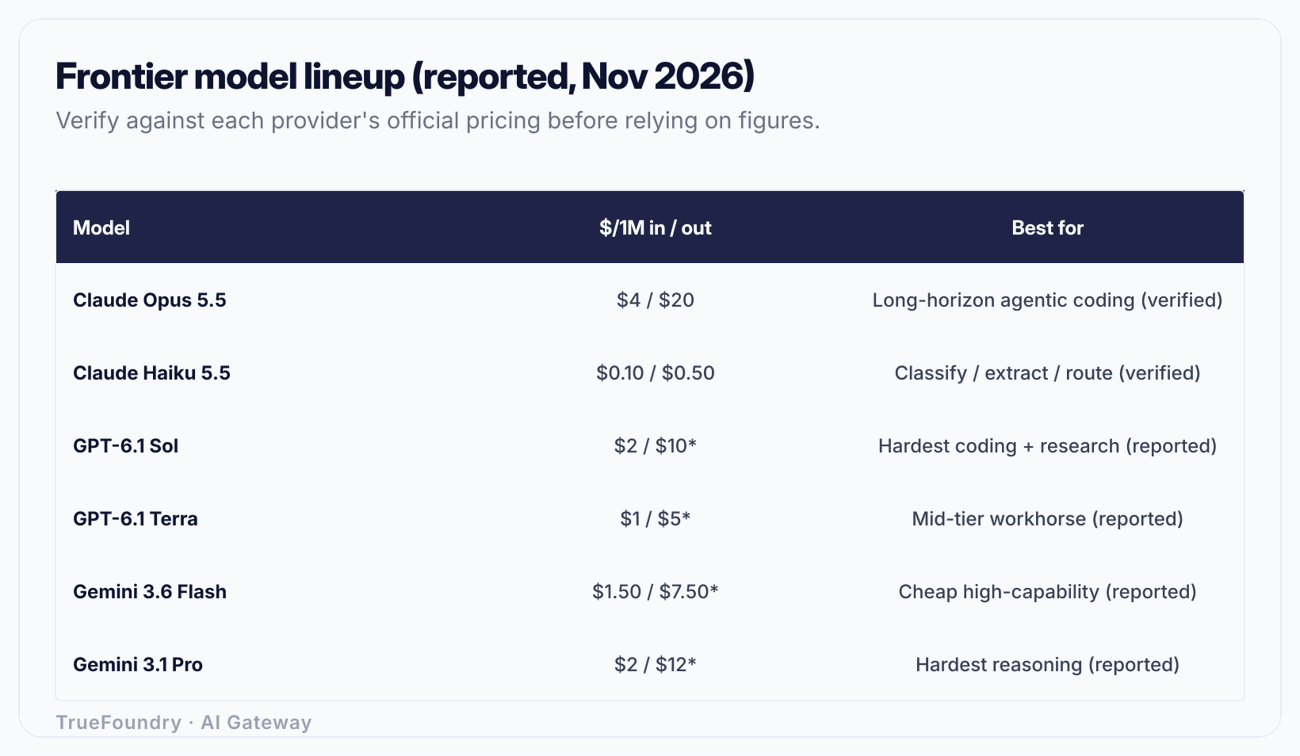
Preise/Benchmarks wie im November 2026 berichtet; vor einer Verwendung bitte auf den offiziellen Preisseiten der jeweiligen Anbieter überprüfen — Modellspezifikationen ändern sich häufig.
Hören Sie auf, sich auf ein einzelnes Modell festzulegen. Klassifizieren Sie stattdessen Ihren Datenverkehr und ordnen Sie jede Klasse einem Tier sowie einer Kostenstruktur zu. Vier Kategorien decken fast alle Anwendungsfälle ab.
Dies sind hochvolumige Aufgaben mit geringer Komplexität: ein Ticket kategorisieren, ein Datum aus einem Dokument extrahieren, entscheiden, welcher Prompt-Zweig ausgeführt werden soll. Hierfür wird kein Flaggschiff benötigt. Ein kleines Modell (Haiku 5.5, GPT-6 Luna, Gemini 3.1 Flash-Lite) für etwa 0,10 $ bis 0,25 $ pro Million Input-Token erledigt dies problemlos – und da der Output kurz ist, bleiben die Kosten pro Anfrage minimal. Kostenstruktur: Minimieren. Hier zahlt sich das Routing auf das günstige Tier direkt aus.
Nutzerzentrierter Chat erfordert eine gute Qualität und geringe Latenz, aber selten tiefgehendes Reasoning. Ein Mid-Tier-Modell (Sonnet 5.5, GPT-6.1 Terra, Gemini 3.6 Flash) bildet hier den optimalen Mittelweg. Kostenstruktur: Ausbalancieren. Achten Sie besonders auf den Output-Preis, da bei Chat-Anwendungen viele Token generiert werden.
Mehrstufiges Coding, bei dem das Modell plant, Werkzeuge aufruft, Dateien liest und ein Ziel über mehrere Interaktionen hinweg verfolgt, bringt Leistungsunterschiede deutlich zum Vorschein. Für die anspruchsvollsten agentischen Aufgaben ist Opus 5.5 der bestätigte Standard; GPT-6.1 Sol gilt laut Berichten als ebenbürtige Alternative. Für alltägliches Coding ohne lange Zeithorizonte reicht ein Mid-Tier-Modell (Terra, Gemini 3.6 Flash, Sonnet 5.5) meist aus – bei 90 % der Leistung zu einem Bruchteil der Kosten. Kostenstruktur: Nach Schwierigkeit abstufen. Routen Sie Routine-Edits an das Mid-Tier und eskalieren Sie komplexe agentische Läufe.
Juristische Analysen, Synthese von Forschungsarbeiten, Reasoning über umfangreiche Dokumente. Dies ist der Anwendungsfall, bei dem sich der Einsatz eines Flaggschiffs (Astra, Gemini 3.1 Pro, Opus 5.5 oder Fable 5.1 für die schwersten Aufgaben) auszahlt. Kostenstruktur: Für Qualität zahlen, aber den Zugang steuern. Nur ein kleiner Teil des Datenverkehrs sollte dieses Tier erreichen; die Zugangssteuerung erfolgt über die Routing-Regel.
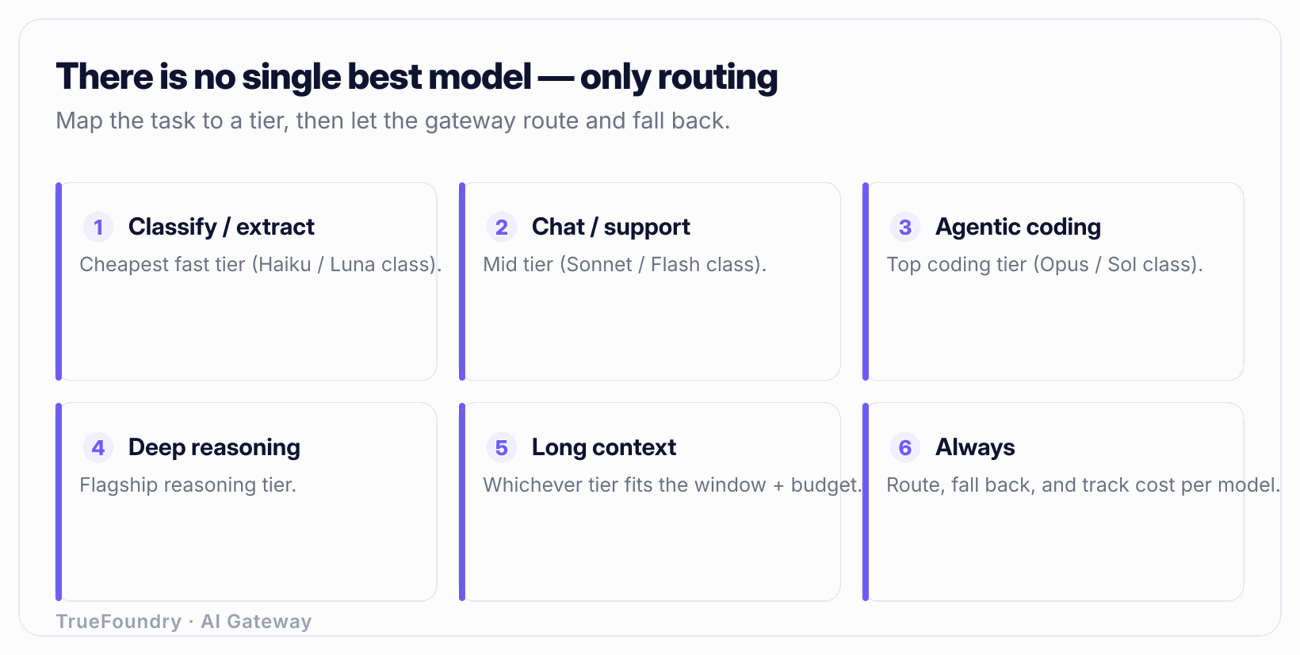
Preise/Benchmarks wie im November 2026 berichtet; vor einer Verwendung bitte auf den offiziellen Preisseiten der jeweiligen Anbieter überprüfen — Modellspezifikationen ändern sich häufig.
Erfahren Sie, wie TrueFoundry Anfragen routet, Fallbacks verwaltet und Kosten über alle Modelle hinweg nachverfolgt. Buchen Sie eine Demo.
Angenommen, ein Produkt generiert 10 Millionen Modell-Anfragen pro Monat. Gehen wir von einer 80/15/5-Verteilung aus: 80 % einfache Aufgaben (Klassifizierung, Extraktion, Routing), 15 % Chat und alltägliches Coding, 5 % komplexes Reasoning und agentisches Coding. Nehmen wir durchschnittlich 500 Input- und 200 Output-Token pro Anfrage für die einfachen und Chat-Tiers an, sowie höhere Werte für das anspruchsvolle Tier.
Wenn Sie alles an ein einzelnes Flaggschiff für 4 $ / 20 $ routen, zahlen Sie die Flaggschiff-Rate für alle 10 Mio. Anfragen – einschließlich der 8 Mio. Anfragen, die ein 0,10-$-Modell identisch gelöst hätte. Routen Sie stattdessen nach Aufgabenstellung:
Das kleine Tier, das das Hauptvolumen ausmacht, kostet pro Input-Token nun etwa 1/40 des Flaggschiffs. Bei den meisten realen Workloads senkt dies die Gesamtrechnung um mehr als die Hälfte, während komplexe Anfragen genau das Modell erhalten, das sie benötigen. Die genaue Ersparnis hängt von Ihrem Token-Mix ab – und genau das ist der Punkt: Sie messen die Kosten pro Tier, was Transparenz über die Modellkosten voraussetzt. Lesen Sie LLM-Kostenzuweisung und Team-Budgets, um zu erfahren, wie Sie diese Transparenz im Team etablieren.
Der obige Rahmen nützt nur dann etwas, wenn Sie ihn ohne ständige Software-Deployments umsetzen können. Genau dafür ist ein AI Gateway gedacht. Ein Gateway stellt Ihrer Anwendung eine einheitliche, OpenAI-kompatible API zur Verfügung. Hinter diesem einzelnen Endpunkt konfigurieren Sie, an welches reale Modell jede Anfrage weitergeleitet wird. Die Anwendung sendet stets dieselbe Anfragestruktur; das Gateway entscheidet über das Ziel.
Diese Entkopplung bietet vier Vorteile, die direkt dem Entscheidungsrahmen entsprechen:
Der Ansatz einer einzelnen API ist wichtiger, als es zunächst scheint. Wenn ein neues Modell erscheint (Terra kam Ende Oktober auf den Markt; im Dezember wird ein weiteres folgen), fügen Sie es als Ziel hinzu und verlagern den Traffic per Konfigurationsänderung. Die Anwendung selbst bekommt davon nichts mit. Details zur zugrunde liegenden Architektur finden Sie unter Was ist ein LLM Proxy? und So wählen Sie das richtige AI Gateway aus.
Das Feld der Frontier-Modelle Ende 2026 ist kein einzelner Gipfel mit einem eindeutigen Gewinner. Es ist ein System aus verschiedenen Leistungsklassen. Die Teams, die ihr Budget effizient einsetzen, ordnen jeden Teil ihres Datenverkehrs der passenden Leistungsklasse zu, anstatt Flaggschiff-Preise für einfache Klassifizierungen zu zahlen. Anbieternamen, Preise und Bestenlisten werden sich weiter verändern. Der Entscheidungsrahmen bleibt jedoch bestehen: Klassifizieren Sie Ihren Datenverkehr, ordnen Sie jede Klasse einem Tier sowie einer Kostenstruktur zu und steuern Sie den Zugang zum teuren Tier so, dass nur komplexe Anfragen dort ankommen.
Wenn Sie diesen Rahmen als Routing-Richtlinie an einem Gateway umsetzen, wird die Modellwahl von einer Dauerdiskussion zu einer Konfigurationszeile, die in Minuten angepasst ist. Sie routen nach Aufgabe und Kosten, fangen Provider-Ausfälle ab, cachen Wiederholungen und sehen exakt, was jedes Modell pro Anfrage kostet. So nutzen Sie stets die neuesten Modelle an der Spitze der Entwicklung, ohne sich an einen einzelnen Punkt festzuketten.
Lösen Sie sich vom Vendor-Lock-in — routen Sie dynamisch zwischen Modellen. Buchen Sie eine Demo.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet





